
Diffusers documentation
FreeU
FreeU
FreeUは、UNetデコーダーがバックボーン特徴とスキップ接続特徴をそれぞれどの程度参照するかというバランスを再調整することで、画像の詳細度を向上させます。スキップ接続がバックボーンのセマンティック特徴を埋没させてしまうと、出力に不自然な詳細が生じます。FreeUは学習を必要とせず、テキストから画像やテキストから動画へのパイプラインにおいて、推論時にオン/オフを切り替えることができます。
FreeU は、Stable Diffusion、SDXL、AnimateDiff などの UNet ベースのパイプラインでのみ動作します。Flux や Qwen-Image などの transformer ベースのパイプラインではサポートされていません。
パイプラインの enable_freeu() メソッドを使用し、スケーリング係数を設定します。b1 と b2 はバックボーンの特徴量を増幅し、s1 と s2 はスキップ特徴量を減衰します。1 と 2 は、UNet デコーダーの最初の 2 つのアップサンプリング段階を指します。異なるモデル向けの参考となるハイパーパラメータについては、FreeU リポジトリを参照してください。
モデルのリポジトリ値から開始します。他のモデルにチューニングする場合は、s1=0.9 と s2=0.2 を維持し、まず b1 と b2 を調整してください。4つの係数をすべて 1.0 に設定すると、FreeU を無効化したのと同じになります。b の値を大きくすると効果が強まりますが、細かいテクスチャが過剰に平滑化される可能性があります。s1 と s2 を下げることにより、これを相殺できます。
import torch
from diffusers import DiffusionPipeline

pipeline = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.enable_freeu(s1=0.9, s2=0.2, b1=1.3, b2=1.4)
generator = torch.Generator(device="cpu").manual_seed(13)
prompt = "A squirrel eating a burger"
image = pipeline(prompt, generator=generator).images[0]
image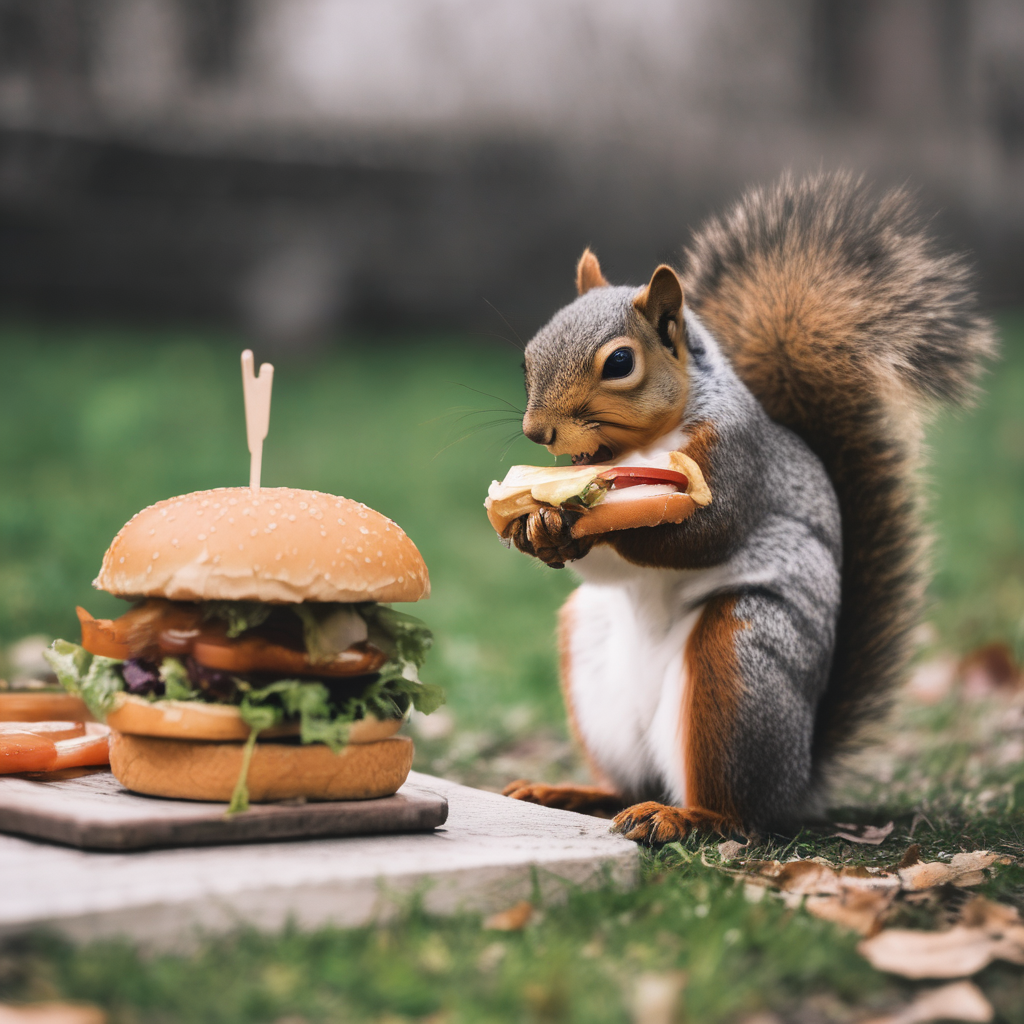

FreeUを無効にするには、disable_freeu()メソッドを呼び出します。
pipeline.disable_freeu()
次のステップ
- enable_freeu()のAPIリファレンスに、パラメータの詳細な説明が記載されています。
- AnimateDiffでFreeUを動画に試してください。