
Diffusers documentation
Stable Video Diffusion
Stable Video Diffusion
Stable Video Diffusion은 Andreas Blattmann, Tim Dockhorn, Sumith Kulal, Daniel Mendelevitch, Maciej Kilian, Dominik Lorenz, Yam Levi, Zion English, Vikram Voleti, Adam Letts, Varun Jampani, Robin Rombach가 Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets에서 제안했습니다.
해당 논문의 초록은 다음과 같습니다:
Stable Video Diffusion을 소개합니다. 이는 고해상도의 최첨단 텍스트-투-비디오 및 이미지-투-비디오 생성을 위한 잠재 공간 비디오 확산 모델입니다. 최근 2D 이미지 합성을 위해 학습된 잠재 공간 확산 모델은 시간적 레이어를 삽입하고 소규모의 고품질 비디오 데이터셋으로 파인튜닝하여 생성형 비디오 모델로 전환되었습니다. 그러나 문헌에 제시된 학습 방법은 다양하며, 비디오 데이터 큐레이션에 대한 통합된 전략에 대해 해당 분야가 아직 합의에 도달하지 못했습니다. 본 논문에서는 비디오 LDM의 성공적인 학습을 위한 세 가지 다른 단계를 식별하고 평가합니다: 텍스트-투-이미지 사전학습, 비디오 사전학습, 고품질 비디오 파인튜닝. 또한 고품질 비디오 생성을 위해 잘 큐레이션된 사전학습 데이터셋의 필요성을 입증하고, 캡셔닝 및 필터링 전략을 포함하여 강력한 베이스 모델을 학습하기 위한 체계적인 큐레이션 프로세스를 제시합니다. 이후 고품질 데이터로 베이스 모델을 파인튜닝하는 영향을 탐구하며, 폐쇄형 비디오 생성과 경쟁할 수 있는 텍스트-투-비디오 모델을 학습합니다. 또한 우리의 베이스 모델이 이미지-투-비디오 생성과 카메라 모션 특화 LoRA 모듈에 대한 적응성 등 하위 작업에 대해 강력한 모션 표현을 제공함을 보여줍니다. 마지막으로, 우리의 모델이 강력한 멀티뷰 3D-프라이오를 제공하며, 피드포워드 방식으로 객체의 여러 뷰를 동시에 생성하는 멀티뷰 확산 모델을 파인튜닝하기 위한 베이스로 사용될 수 있음을 입증합니다. 이 모델은 이미지 기반 방법보다 훨씬 적은 컴퓨트 예산으로 더 나은 성능을 발휘합니다. 코드와 모델 가중치는 이 https URL에서 공개합니다.
Stability AI Hub 조직에서 base 및 extended frame 체크포인트를 확인해 보세요!
다음 라이브러리가 설치되어 있는지 확인하세요.
# Uncomment to install the necessary libraries in Colab
!pip install -q -U diffusers transformers accelerate
이 모델에는 SVD와 SVD-XT 두 가지 변형이 있습니다. SVD 체크포인트는 14프레임을 생성하도록 학습되며, SVD-XT 체크포인트는 25프레임을 생성하도록 추가로 파인튜닝됩니다.
이 가이드에서는 SVD-XT 체크포인트를 사용합니다.
import torch

from diffusers import StableVideoDiffusionPipeline
from diffusers.utils import load_image, export_to_video

pipe = StableVideoDiffusionPipeline.from_pretrained(
    "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16"
)
pipe.enable_model_cpu_offload()

# Load the conditioning image
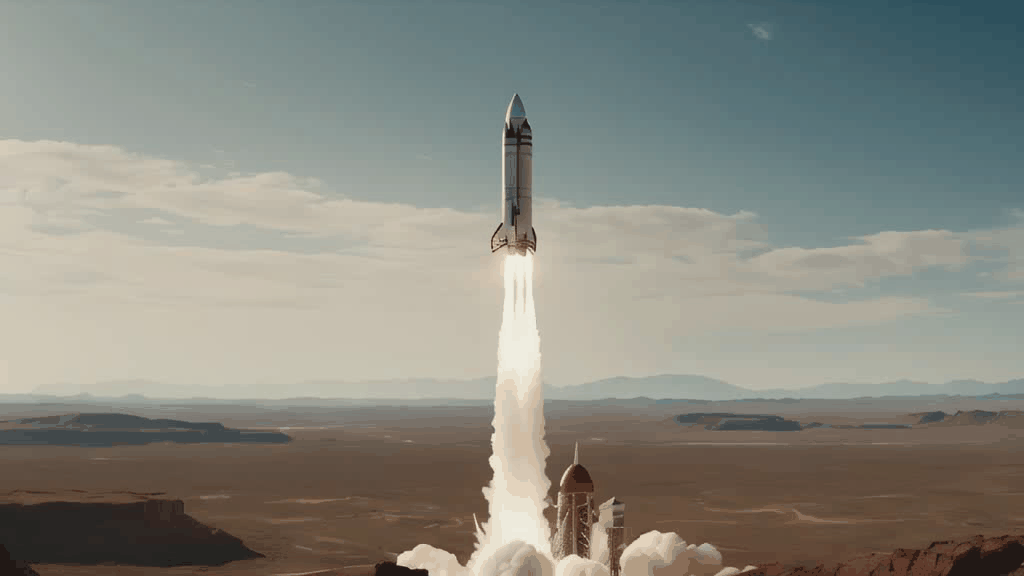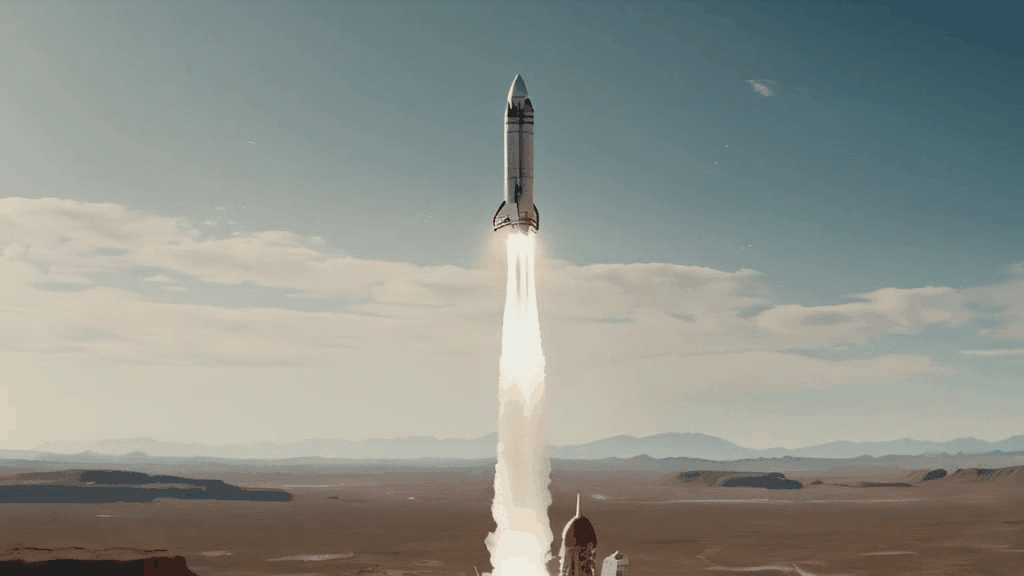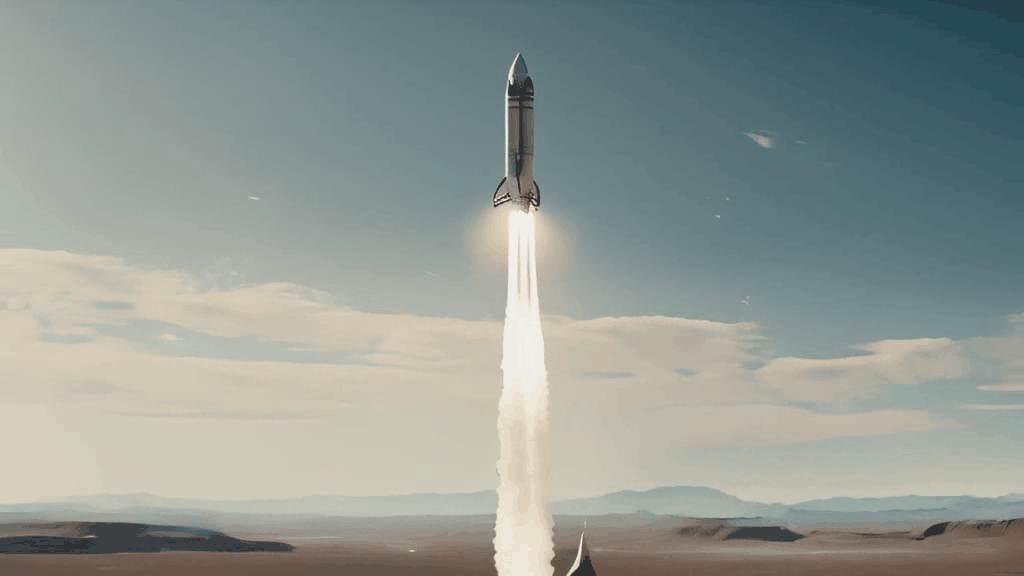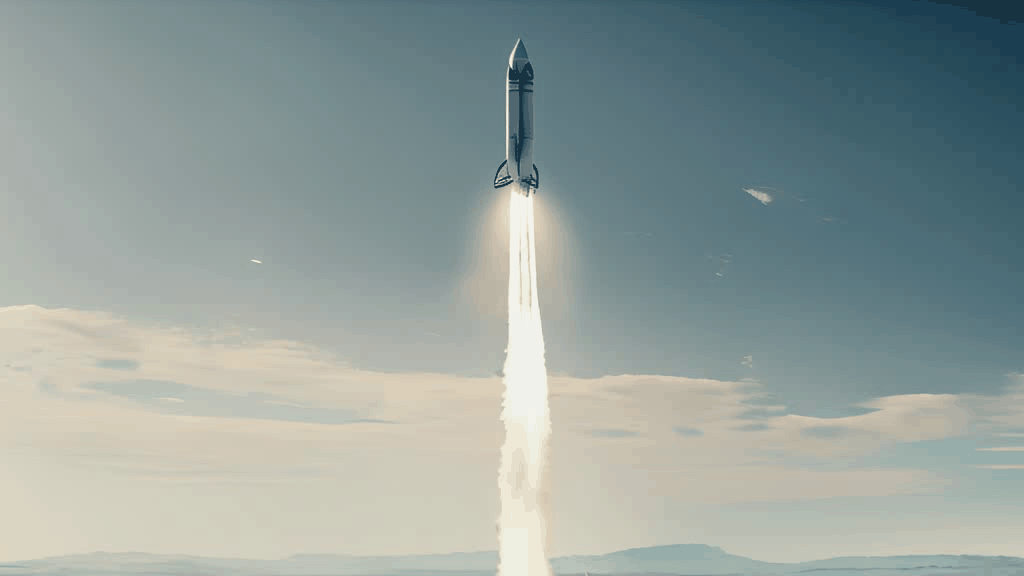
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png")
image = image.resize((1024, 576))

generator = torch.manual_seed(42)
frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0]

export_to_video(frames, "generated.mp4", fps=7)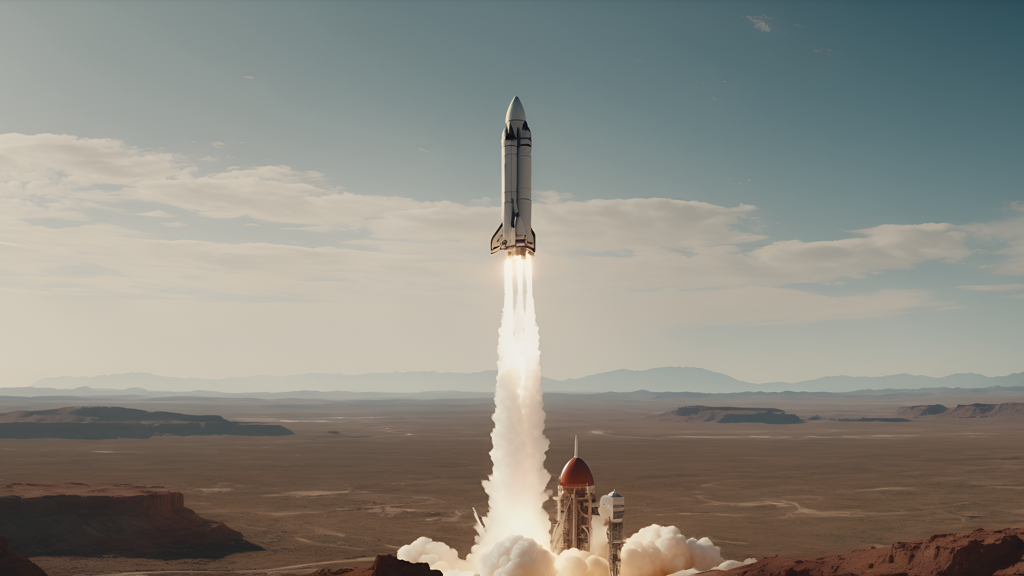
torch.compile
UNet을 컴파일하면 메모리가 약간 증가하는 대신 20~25%의 속도 향상을 얻을 수 있습니다.
- pipe.enable_model_cpu_offload()
+ pipe.to("cuda")  # or "mps", "xpu", "cpu"
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
메모리 사용량 줄이기
num_frames를 한 번에 생성하기 때문에 텍스트-이미지 생성에서 높은 배치 크기를 사용하는 것과 유사하게, 비디오 생성은 메모리 사용량이 매우 높습니다. 메모리 요구량을 줄이기 위해 추론 속도를 희생하여 메모리 요구량을 낮추는 여러 옵션이 있습니다:
- 모델 오프로딩 활성화: 파이프라인의 각 구성 요소는 더 이상 필요하지 않을 때 CPU로 오프로드됩니다.
- 피드포워드 청킹 활성화: 피드포워드 레이어가 거대한 배치 크기로 단일 피드포워드를 실행하는 대신 루프를 통해 실행됩니다.
decode_chunk_size감소: VAE는 모든 프레임을 한 번에 디코딩하는 대신 청크 단위로 프레임을 디코딩합니다.decode_chunk_size=1로 설정하면 프레임 하나씩 순차적으로 디코딩하여 가장 적은 메모리를 사용하며(GPU 메모리에 따라 이 값을 조정하는 것을 권장합니다) 비디오에 일부 깜빡임이 발생할 수 있습니다.
- pipe.enable_model_cpu_offload()
- frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0]
+ pipe.enable_model_cpu_offload()
+ pipe.unet.enable_forward_chunking()
+ frames = pipe(image, decode_chunk_size=2, generator=generator, num_frames=25).frames[0]
이 모든 트릭을 함께 사용하면 VRAM 요구량이 8GB 미만으로 낮아집니다.
마이크로 조건화
Stable Diffusion Video는 조건 이미지 외에도 micro-conditioning을 받아들이며, 이를 통해 생성된 비디오에 대한 더 세밀한 제어가 가능합니다:
fps: 생성된 비디오의 초당 프레임 수.motion_bucket_id: 생성된 비디오에 사용할 motion bucket id입니다. 생성된 비디오의 모션을 제어하는 데 사용할 수 있습니다. motion bucket id를 높이면 생성된 비디오의 모션이 증가합니다.noise_aug_strength: 조건부 이미지에 추가되는 노이즈의 양입니다. 값이 높을수록 생성된 비디오가 조건부 이미지와 유사도가 낮아집니다. 이 값을 높이면 생성된 비디오의 움직임도 증가합니다.
예를 들어, 움직임이 더 많은 비디오를 생성하려면 motion_bucket_id 및 noise_aug_strength 마이크로 조건화 매개변수를 사용하세요:
import torch

from diffusers import StableVideoDiffusionPipeline
from diffusers.utils import load_image, export_to_video

pipe = StableVideoDiffusionPipeline.from_pretrained(
  "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16"
)
pipe.enable_model_cpu_offload()

# Load the conditioning image
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png")
image = image.resize((1024, 576))

generator = torch.manual_seed(42)
frames = pipe(image, decode_chunk_size=8, generator=generator, motion_bucket_id=180, noise_aug_strength=0.1).frames[0]
export_to_video(frames, "generated.mp4", fps=7)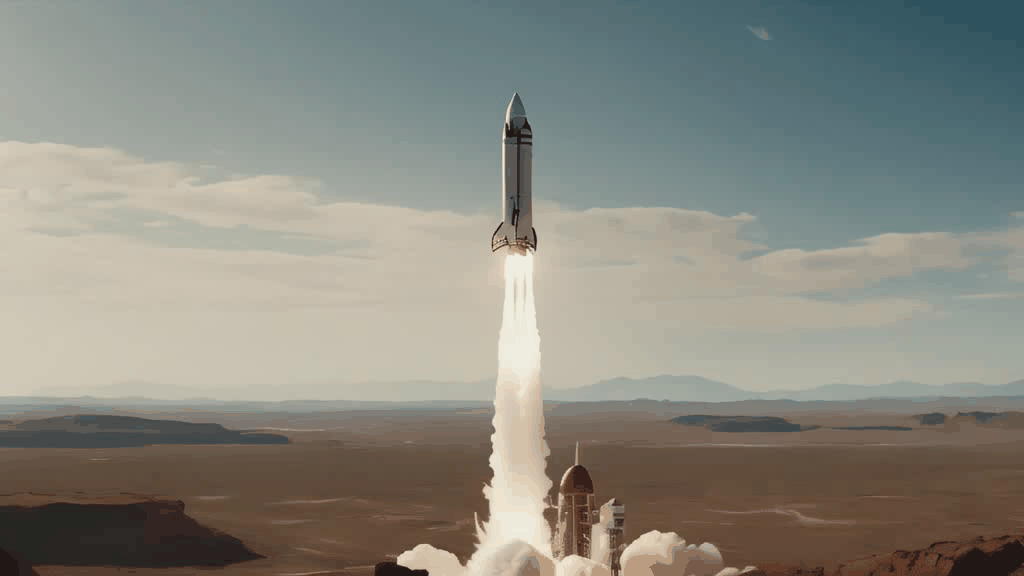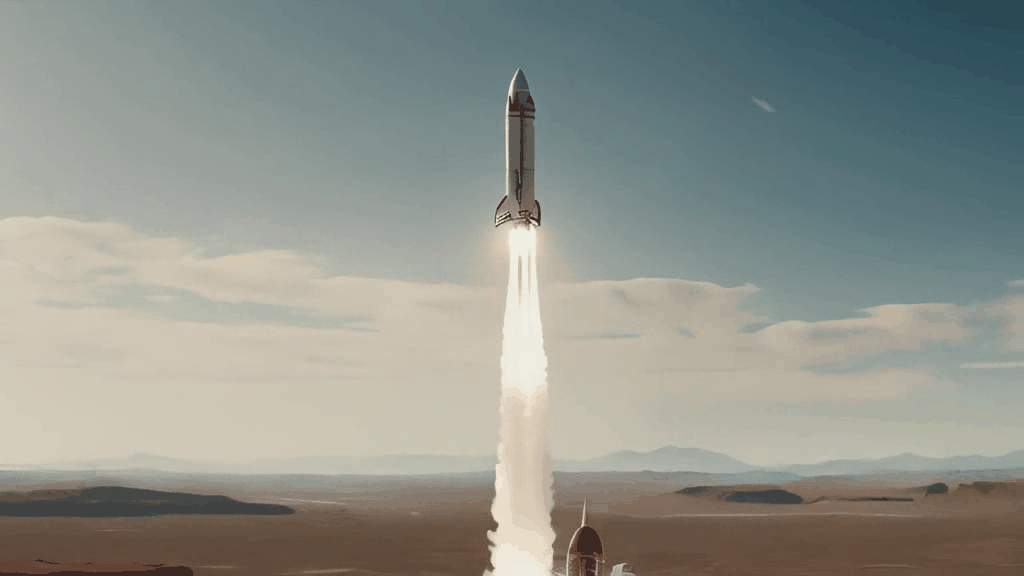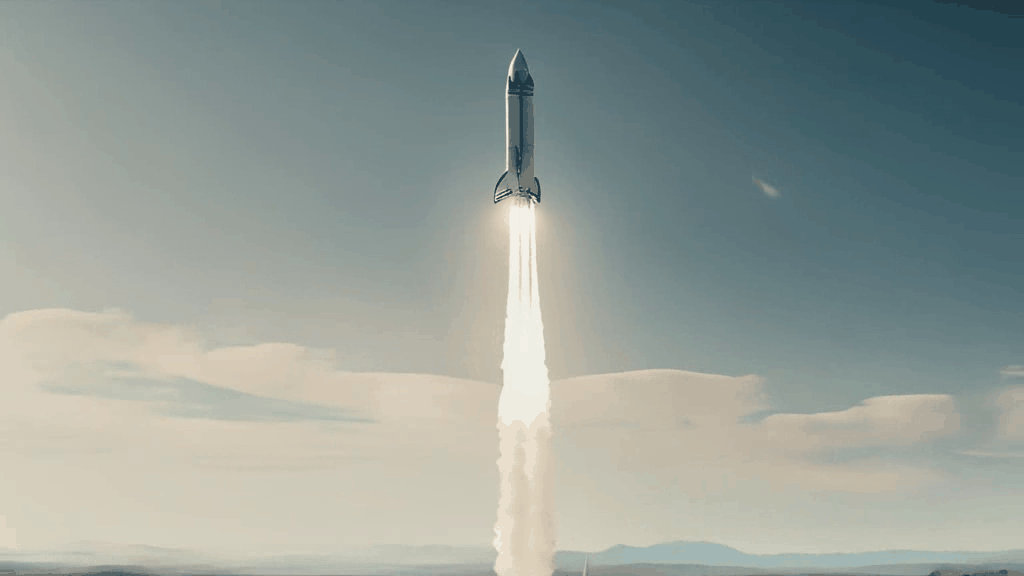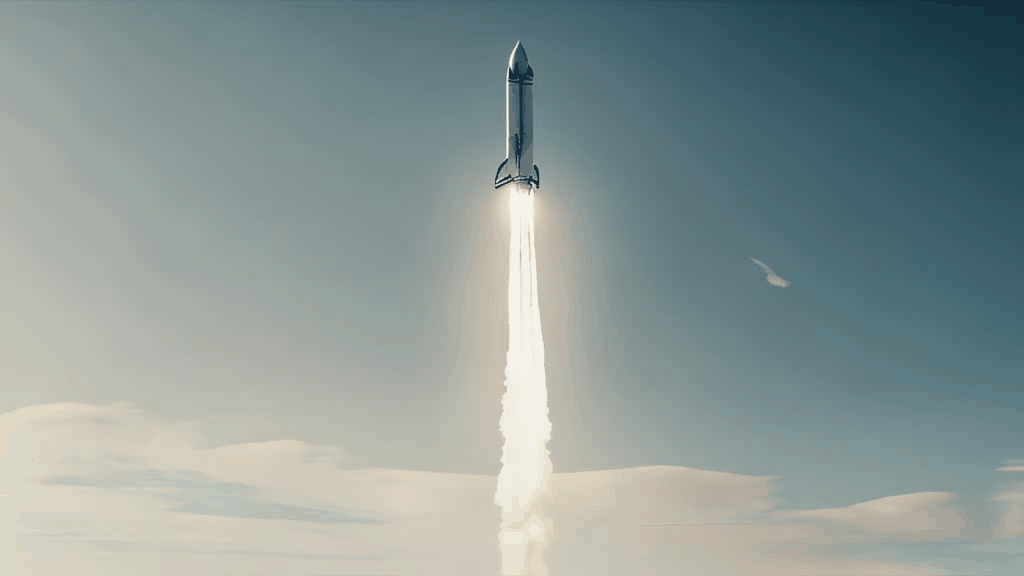
StableVideoDiffusionPipeline
클래스 diffusers.StableVideoDiffusionPipeline
< source >( vae: AutoencoderKLTemporalDecoderimage_encoder: CLIPVisionModelWithProjectionunet: UNetSpatioTemporalConditionModelscheduler: EulerDiscreteSchedulerfeature_extractor: CLIPImageProcessorPil )
매개변수
- vae (
AutoencoderKLTemporalDecoder) — 잠재 표현으로 이미지를 인코딩하고 디코딩하는 Variational Auto-Encoder (VAE) 모델. - image_encoder (CLIPVisionModelWithProjection) — 동결된 CLIP 이미지 인코더 (laion/CLIP-ViT-H-14-laion2B-s32B-b79K).
- unet (
UNetSpatioTemporalConditionModel) — 인코딩된 이미지 레이턴트를 디노이즈하기 위한UNetSpatioTemporalConditionModel입니다. - scheduler (EulerDiscreteScheduler) —
인코딩된 이미지 latents의 노이즈를 제거하기 위해
unet와 함께 사용되는 스케줄러입니다. - feature_extractor (CLIPImageProcessor) —
생성된 이미지에서 특징을 추출하기 위한
CLIPImageProcessor입니다.
Stable Video Diffusion을 사용하여 입력 이미지에서 비디오를 생성하는 Pipeline입니다.
이 모델은 DiffusionPipeline에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
StableVideoDiffusionPipelineOutput
클래스 diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput
< source >( frames: typing.Union[list[list[PIL.Image.Image]], numpy.ndarray, torch.Tensor] )
Stable Video Diffusion 파이프라인의 출력 클래스입니다.