
Diffusers documentation
FreeU
FreeU
FreeU melhora o detalhe da imagem ao reequilibrar a quantidade de recursos que o decodificador do UNet extrai dos recursos do backbone em comparação com os recursos das conexões de atalho. As conexões de atalho podem abafar os recursos semânticos do backbone, o que gera detalhes não naturais na saída. O FreeU não requer treinamento e pode ser ativado ou desativado no momento da inferência para pipelines de texto para imagem e texto para vídeo.
FreeU funciona apenas com pipelines baseados em UNet, como Stable Diffusion, SDXL e AnimateDiff. Não é suportado por pipelines baseados em transformers, como Flux ou Qwen-Image.
Use o método enable_freeu() no seu pipeline e configure os fatores de escala. b1 e b2 amplificam os recursos do backbone, e s1 e s2 atenuam os recursos de skip. Os 1 e 2 referem-se às duas primeiras etapas de upsampling do decodificador da UNet. Consulte o repositório FreeU para hiperparâmetros de referência para diferentes modelos.
Comece com os valores do repositório para um modelo. Para ajustar para outros modelos, mantenha s1=0.9 e s2=0.2 e ajuste primeiro b1 e b2. Definir os quatro fatores como 1.0 é o mesmo que desativar o FreeU. Valores maiores de b fortalecem o efeito, mas podem suavizar demais a textura fina, e reduzir s1 e s2 contrabalança isso.
import torch
from diffusers import DiffusionPipeline

pipeline = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.enable_freeu(s1=0.9, s2=0.2, b1=1.3, b2=1.4)
generator = torch.Generator(device="cpu").manual_seed(13)
prompt = "A squirrel eating a burger"
image = pipeline(prompt, generator=generator).images[0]
image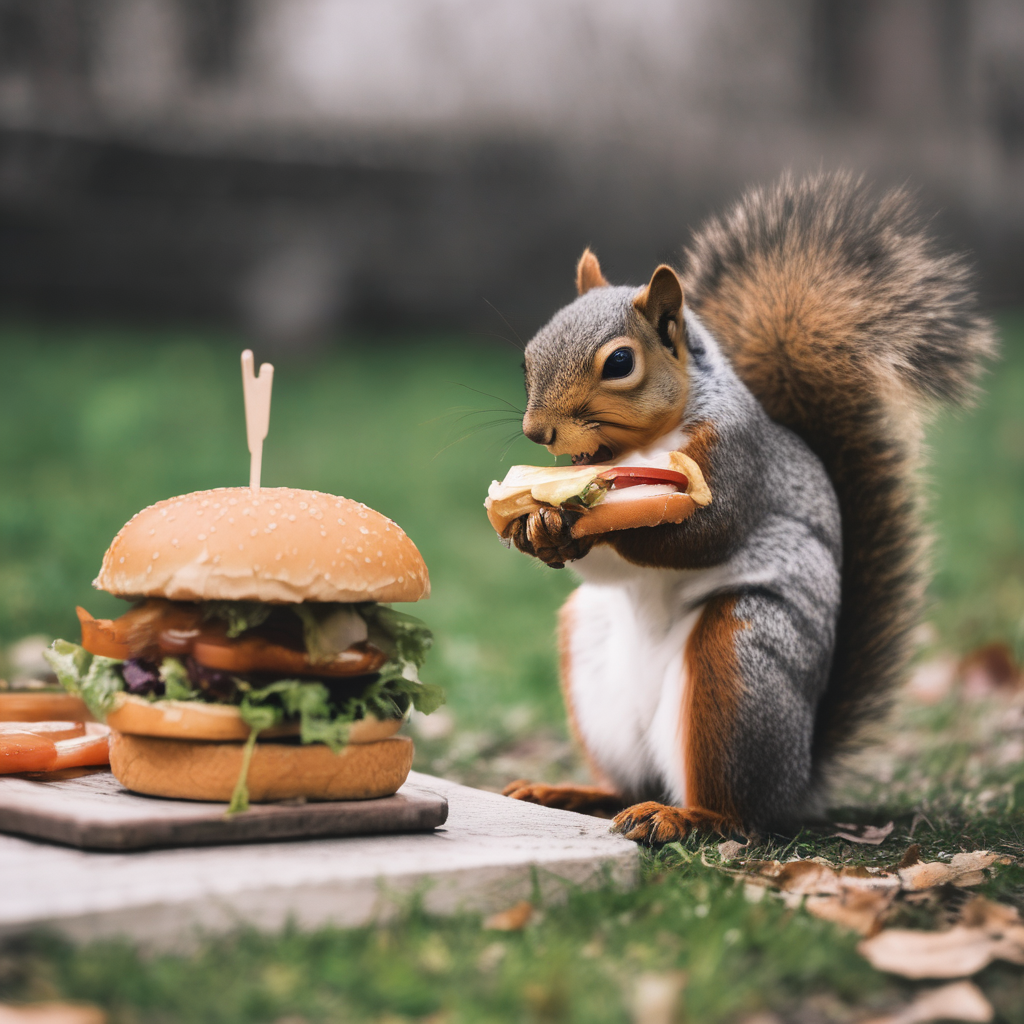

Chame o método disable_freeu() para desativar o FreeU.
pipeline.disable_freeu()
Próximas etapas
- Consulte a referência da API enable_freeu() para as descrições completas dos parâmetros.
- Experimente o FreeU em vídeo com AnimateDiff.