
Diffusers documentation
Bir difüzyon modeli eğitin
Bir difüzyon modeli eğitin
Koşulsuz görüntü üretimi, eğitim için kullanılan veri setindeki görüntülere benzeyen görüntüler üreten difüzyon modellerinin popüler bir uygulamasıdır. Genellikle en iyi sonuçlar, önceden eğitilmiş bir modelin belirli bir veri setinde ince ayar (finetuning) yapılmasıyla elde edilir. Bu kontrol noktalarından (checkpoint) birçok örnek Hub'da bulabilirsiniz, ancak beğendiğinizi bulamazsanız her zaman kendi modelinizi eğitebilirsiniz!
Bu eğitimde, Smithsonian Butterflies veri setinin bir alt kümesi üzerinde sıfırdan bir UNet2DModel eğiterek kendi 🦋 kelebeklerinizi 🦋 nasıl üretebileceğinizi öğreneceksiniz.
💡 Bu eğitim öğreticisi, 🧨 Diffusers ile Eğitim defterine dayanmaktadır. Difüzyon modellerinin nasıl çalıştığı gibi ek ayrıntılar ve bağlam için defteri inceleyin!
Başlamadan önce, görüntü veri setlerini yüklemek ve ön işlemek için 🤗 Datasets'in, herhangi bir sayıda GPU üzerinde eğitimi basitleştirmek için de 🤗 Accelerate'in yüklü olduğundan emin olun. Aşağıdaki komut, eğitim metriklerini görselleştirmek için TensorBoard'ı da yükleyecektir (eğitiminizi izlemek için Weights & Biases'ı da kullanabilirsiniz).
# uncomment to install the necessary libraries in Colab
#!pip install diffusers[training]
Modelinizi toplulukla paylaşmanızı öneririz. Bunu yapmak için Hugging Face hesabınıza giriş yapmanız gerekir (henüz bir hesabınız yoksa buradan oluşturabilirsiniz!). Defterden (notebook) giriş yapabilir ve istendiğinde token'ınızı girebilirsiniz. Token'ınızın yazma (write) rolüne sahip olduğundan emin olun.
>>> from huggingface_hub import notebook_login

>>> notebook_login()
Veya terminalden oturum açın:
hf auth login
Model kontrol noktaları oldukça büyük olduğundan, bu büyük dosyaların sürümünü almak için Git-LFS kurun:
!sudo apt -qq install git-lfs
!git config --global credential.helper store
Eğitim yapılandırması
Kolaylık olması için, eğitim hiperparametrelerini içeren bir TrainingConfig sınıfı oluşturun (değiştirmekte serbestsiniz):
>>> from dataclasses import dataclass

>>> @dataclass
... class TrainingConfig:
...     image_size = 128  # the generated image resolution
...     train_batch_size = 16
...     eval_batch_size = 16  # how many images to sample during evaluation
...     num_epochs = 50
...     gradient_accumulation_steps = 1
...     learning_rate = 1e-4
...     lr_warmup_steps = 500
...     save_image_epochs = 10
...     save_model_epochs = 30
...     mixed_precision = "fp16"  # `no` for float32, `fp16` for automatic mixed precision
...     output_dir = "ddpm-butterflies-128"  # the model name locally and on the HF Hub

...     push_to_hub = True  # whether to upload the saved model to the HF Hub
...     hub_model_id = "<your-username>/<my-awesome-model>"  # the name of the repository to create on the HF Hub
...     hub_private_repo = None
...     overwrite_output_dir = True  # overwrite the old model when re-running the notebook
...     seed = 0


>>> config = TrainingConfig()
Veri setini yükle
Smithsonian Butterflies veri setini 🤗 Datasets kütüphanesiyle kolayca yükleyebilirsiniz:
>>> from datasets import load_dataset

>>> config.dataset_name = "huggan/smithsonian_butterflies_subset"
>>> dataset = load_dataset(config.dataset_name, split="train")
💡 HugGan Community Event etkinliğinden ek veri setleri bulabilir veya yerel bir
ImageFolderoluşturarak kendi veri setinizi kullanabilirsiniz. Veri seti HugGan Community Event'ten geliyorsaconfig.dataset_namedeğerini veri setinin depo kimliği olarak, kendi görüntülerinizi kullanıyorsanızimagefolderolarak ayarlayın.
🤗 Datasets, Image özelliğini kullanarak görüntü verilerini otomatik olarak çözer ve PIL.Image olarak yükler; bunu görselleştirebiliriz:
>>> import matplotlib.pyplot as plt

>>> fig, axs = plt.subplots(1, 4, figsize=(16, 4))
>>> for i, image in enumerate(dataset[:4]["image"]):
...     axs[i].imshow(image)
...     axs[i].set_axis_off()
>>> fig.show()
Ancak görsellerin hepsi farklı boyutlarda olduğundan, önce bunları ön işlemeye tabi tutmanız gerekir:
Resize, görüntü boyutunuconfig.image_sizeiçinde tanımlanan boyuta değiştirir.RandomHorizontalFlip, görüntüleri rastgele aynalayarak veri setini artırır.Normalize, modelin beklediği [-1, 1] aralığına piksel değerlerini yeniden ölçeklendirmek için önemlidir.
>>> from torchvision import transforms

>>> preprocess = transforms.Compose(
...     [
...         transforms.Resize((config.image_size, config.image_size)),
...         transforms.RandomHorizontalFlip(),
...         transforms.ToTensor(),
...         transforms.Normalize([0.5], [0.5]),
...     ]
... )
🤗 Datasets'in set_transform yöntemini kullanarak preprocess fonksiyonunu eğitim sırasında anlık olarak uygulayın:
>>> def transform(examples):
...     images = [preprocess(image.convert("RGB")) for image in examples["image"]]
...     return {"images": images}


>>> dataset.set_transform(transform)
Görsellerin yeniden boyutlandırıldığını doğrulamak için istediğiniz zaman görselleri tekrar görselleştirebilirsiniz. Şimdi eğitim için veri setini DataLoader ile sarmalamaya hazırsınız!
>>> import torch

>>> train_dataloader = torch.utils.data.DataLoader(dataset, batch_size=config.train_batch_size, shuffle=True)
UNet2DModel oluşturun
🧨 Diffusers'taki önceden eğitilmiş modeller, istediğiniz parametrelerle model sınıflarından kolayca oluşturulur. Örneğin, bir UNet2DModel oluşturmak için:
>>> from diffusers import UNet2DModel

>>> model = UNet2DModel(
...     sample_size=config.image_size,  # the target image resolution
...     in_channels=3,  # the number of input channels, 3 for RGB images
...     out_channels=3,  # the number of output channels
...     layers_per_block=2,  # how many ResNet layers to use per UNet block
...     block_out_channels=(128, 128, 256, 256, 512, 512),  # the number of output channels for each UNet block
...     down_block_types=(
...         "DownBlock2D",  # a regular ResNet downsampling block
...         "DownBlock2D",
...         "DownBlock2D",
...         "DownBlock2D",
...         "AttnDownBlock2D",  # a ResNet downsampling block with spatial self-attention
...         "DownBlock2D",
...     ),
...     up_block_types=(
...         "UpBlock2D",  # a regular ResNet upsampling block
...         "AttnUpBlock2D",  # a ResNet upsampling block with spatial self-attention
...         "UpBlock2D",
...         "UpBlock2D",
...         "UpBlock2D",
...         "UpBlock2D",
...     ),
... )
Örnek görüntü şeklinin model çıktısı şekliyle eşleştiğini hızlıca kontrol etmek genellikle iyi bir fikirdir:
>>> sample_image = dataset[0]["images"].unsqueeze(0)
>>> print("Input shape:", sample_image.shape)
Input shape: torch.Size([1, 3, 128, 128])

>>> print("Output shape:", model(sample_image, timestep=0).sample.shape)
Output shape: torch.Size([1, 3, 128, 128])
Harika! Sıradaki adım, görüntüye gürültü eklemek için bir zamanlayıcı (scheduler) kullanmaktır.
Bir zamanlayıcı oluşturun
Zamanlayıcı, modeli eğitim için mi yoksa çıkarım için mi kullandığınıza göre farklı davranır. Çıkarım sırasında zamanlayıcı, gürültüden görüntü üretir. Eğitim sırasında zamanlayıcı, difüzyon sürecindeki belirli bir noktadan model çıktısını - veya bir örneği - alır ve görüntüye bir gürültü zamanlamasına ve bir güncelleme kuralına göre gürültü uygular.
DDPMScheduler sınıfına bir bakalım ve add_noise yöntemini kullanarak daha önceki sample_image örneğine rastgele gürültü ekleyelim:
>>> import torch
>>> from PIL import Image
>>> from diffusers import DDPMScheduler

>>> noise_scheduler = DDPMScheduler(num_train_timesteps=1000)
>>> noise = torch.randn(sample_image.shape)
>>> timesteps = torch.LongTensor([50])
>>> noisy_image = noise_scheduler.add_noise(sample_image, noise, timesteps)

>>> Image.fromarray(((noisy_image.permute(0, 2, 3, 1) + 1.0) * 127.5).type(torch.uint8).numpy()[0])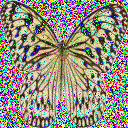
Modelin eğitim hedefi, görüntüye eklenen gürültüyü tahmin etmektir. Bu adımdaki kayıp şu şekilde hesaplanabilir:
>>> import torch.nn.functional as F

>>> noise_pred = model(noisy_image, timesteps).sample
>>> loss = F.mse_loss(noise_pred, noise)
Modeli eğitin
Bu noktada, modeli eğitmeye başlamak için gereken parçaların çoğuna sahipsiniz ve geriye her şeyi bir araya getirmek kalıyor.
Öncelikle bir optimizör ve bir öğrenme hızı zamanlayıcısına (learning rate scheduler) ihtiyacınız olacak:
>>> from diffusers.optimization import get_cosine_schedule_with_warmup

>>> optimizer = torch.optim.AdamW(model.parameters(), lr=config.learning_rate)
>>> lr_scheduler = get_cosine_schedule_with_warmup(
...     optimizer=optimizer,
...     num_warmup_steps=config.lr_warmup_steps,
...     num_training_steps=(len(train_dataloader) * config.num_epochs),
... )
Ardından, modeli değerlendirmek için bir yönteme ihtiyacınız olacak. Değerlendirme için, örnek bir görsel grubu oluşturup bunu bir ızgara olarak kaydetmek üzere DDPMPipeline kullanabilirsiniz:
>>> from diffusers import DDPMPipeline
>>> from diffusers.utils import make_image_grid
>>> import os

>>> def evaluate(config, epoch, pipeline):
...     # Sample some images from random noise (this is the backward diffusion process).
...     # The default pipeline output type is `List[PIL.Image]`
...     images = pipeline(
...         batch_size=config.eval_batch_size,
...         generator=torch.Generator(device='cpu').manual_seed(config.seed), # Use a separate torch generator to avoid rewinding the random state of the main training loop
...     ).images

...     # Make a grid out of the images
...     image_grid = make_image_grid(images, rows=4, cols=4)

...     # Save the images
...     test_dir = os.path.join(config.output_dir, "samples")
...     os.makedirs(test_dir, exist_ok=True)
...     image_grid.save(f"{test_dir}/{epoch:04d}.png")
Şimdi tüm bu bileşenleri, TensorBoard günlükleme, gradyan biriktirme ve karma hassasiyetli eğitim için kolaylık sağlayan 🤗 Accelerate ile bir eğitim döngüsünde bir araya getirebilirsiniz. Modeli Hub'a yüklemek için, depo adınızı ve bilgilerini almak için bir fonksiyon yazın ve ardından Hub'a gönderin.
💡 Aşağıdaki eğitim döngüsü göz korkutucu ve uzun görünebilir, ancak eğitiminizi tek bir satır kodla başlattığınızda bunun değerini göreceksiniz! Sabırsızlanıyorsanız ve hemen görüntü üretmeye başlamak istiyorsanız, aşağıdaki kodu kopyalayıp çalıştırabilirsiniz. Modelinizin eğitimini tamamlamasını beklerken gibi durumlarda, eğitim döngüsünü daha yakından incelemek için her zaman geri dönebilirsiniz. 🤗
>>> from accelerate import Accelerator
>>> from huggingface_hub import create_repo, upload_folder
>>> from tqdm.auto import tqdm
>>> from pathlib import Path
>>> import os

>>> def train_loop(config, model, noise_scheduler, optimizer, train_dataloader, lr_scheduler):
...     # Initialize accelerator and tensorboard logging
...     accelerator = Accelerator(
...         mixed_precision=config.mixed_precision,
...         gradient_accumulation_steps=config.gradient_accumulation_steps,
...         log_with="tensorboard",
...         project_dir=os.path.join(config.output_dir, "logs"),
...     )
...     if accelerator.is_main_process:
...         if config.output_dir is not None:
...             os.makedirs(config.output_dir, exist_ok=True)
...         if config.push_to_hub:
...             repo_id = create_repo(
...                 repo_id=config.hub_model_id or Path(config.output_dir).name, exist_ok=True
...             ).repo_id
...         accelerator.init_trackers("train_example")

...     # Prepare everything
...     # There is no specific order to remember, you just need to unpack the
...     # objects in the same order you gave them to the prepare method.
...     model, optimizer, train_dataloader, lr_scheduler = accelerator.prepare(
...         model, optimizer, train_dataloader, lr_scheduler
...     )

...     global_step = 0

...     # Now you train the model
...     for epoch in range(config.num_epochs):
...         progress_bar = tqdm(total=len(train_dataloader), disable=not accelerator.is_local_main_process)
...         progress_bar.set_description(f"Epoch {epoch}")

...         for step, batch in enumerate(train_dataloader):
...             clean_images = batch["images"]
...             # Sample noise to add to the images
...             noise = torch.randn(clean_images.shape, device=clean_images.device)
...             bs = clean_images.shape[0]

...             # Sample a random timestep for each image
...             timesteps = torch.randint(
...                 0, noise_scheduler.config.num_train_timesteps, (bs,), device=clean_images.device,
...                 dtype=torch.int64
...             )

...             # Add noise to the clean images according to the noise magnitude at each timestep
...             # (this is the forward diffusion process)
...             noisy_images = noise_scheduler.add_noise(clean_images, noise, timesteps)

...             with accelerator.accumulate(model):
...                 # Predict the noise residual
...                 noise_pred = model(noisy_images, timesteps, return_dict=False)[0]
...                 loss = F.mse_loss(noise_pred, noise)
...                 accelerator.backward(loss)

...                 if accelerator.sync_gradients:
...                     accelerator.clip_grad_norm_(model.parameters(), 1.0)
...                 optimizer.step()
...                 lr_scheduler.step()
...                 optimizer.zero_grad()

...             progress_bar.update(1)
...             logs = {"loss": loss.detach().item(), "lr": lr_scheduler.get_last_lr()[0], "step": global_step}
...             progress_bar.set_postfix(**logs)
...             accelerator.log(logs, step=global_step)
...             global_step += 1

...         # After each epoch you optionally sample some demo images with evaluate() and save the model
...         if accelerator.is_main_process:
...             pipeline = DDPMPipeline(unet=accelerator.unwrap_model(model), scheduler=noise_scheduler)

...             if (epoch + 1) % config.save_image_epochs == 0 or epoch == config.num_epochs - 1:
...                 evaluate(config, epoch, pipeline)

...             if (epoch + 1) % config.save_model_epochs == 0 or epoch == config.num_epochs - 1:
...                 if config.push_to_hub:
...                     upload_folder(
...                         repo_id=repo_id,
...                         folder_path=config.output_dir,
...                         commit_message=f"Epoch {epoch}",
...                         ignore_patterns=["step_*", "epoch_*"],
...                     )
...                 else:
...                     pipeline.save_pretrained(config.output_dir)
Fena değil, epey kod yazdık! Ama sonunda 🤗 Accelerate'in notebook_launcher fonksiyonuyla eğitimi başlatmaya hazırsınız. Eğitimi başlatmak için fonksiyona eğitim döngüsünü, tüm eğitim argümanlarını ve kullanılacak işlem sayısını (bu değeri, size mevcut GPU sayısına göre değiştirebilirsiniz) iletin:
>>> from accelerate import notebook_launcher

>>> args = (config, model, noise_scheduler, optimizer, train_dataloader, lr_scheduler)

>>> notebook_launcher(train_loop, args, num_processes=1)
Eğitim tamamlandığında, difüzyon modelinizin ürettiği son 🦋 görüntülere 🦋 bir göz atın!
>>> import glob

>>> sample_images = sorted(glob.glob(f"{config.output_dir}/samples/*.png"))
>>> Image.open(sample_images[-1])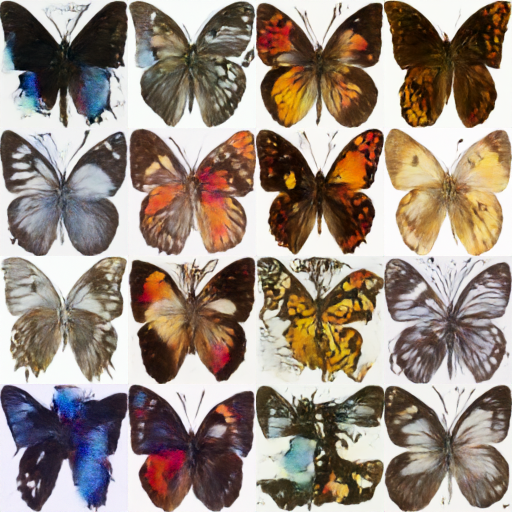
Sonraki adımlar
Koşulsuz görüntü üretimi, eğitilebilecek görevlerden bir örnektir. Diğer görevleri ve eğitim tekniklerini keşfetmek için 🧨 Diffusers Eğitim Örnekleri sayfasını ziyaret edebilirsiniz. Öğrenebileceğiniz bazı örnekler şunlardır:
- Textual Inversion, belirli bir görsel kavramı modele öğreten ve onu üretilen görselin içine entegre eden bir algoritma.
- DreamBooth, bir konunun birkaç giriş görseli verildiğinde kişiselleştirilmiş görsellerini üretmek için kullanılan bir tekniktir.
- Kendi veri setinizde bir Stable Diffusion modelini ince ayar yapma kılavuzu.
- Gerçekten büyük modelleri daha hızlı ince ayar yapmak için kullanılan, bellek verimli bir teknik olan LoRA'yı kullanma kılavuzu.