
Diffusers documentation
SDXL Turbo
SDXL Turbo
Stable Diffusion XL (SDXL) Turbo được đề xuất trong Adversarial Diffusion Distillation bởi Axel Sauer, Dominik Lorenz, Andreas Blattmann và Robin Rombach.
Tóm tắt từ bài báo là:
Chúng tôi giới thiệu Adversarial Diffusion Distillation (ADD), một phương pháp huấn luyện mới cho phép lấy mẫu hiệu quả các mô hình khuếch tán ảnh nền tảng quy mô lớn chỉ trong 1–4 bước trong khi vẫn duy trì chất lượng ảnh cao. Chúng tôi sử dụng score distillation để tận dụng các mô hình khuếch tán ảnh có sẵn quy mô lớn làm tín hiệu giáo viên, kết hợp với tổn thất đối kháng để đảm bảo độ trung thực của ảnh ngay cả trong chế độ ít bước, chỉ với một hoặc hai bước lấy mẫu. Các phân tích của chúng tôi cho thấy mô hình của chúng tôi vượt trội rõ rệt so với các phương pháp ít bước hiện có (GAN, Latent Consistency Models) trong một bước duy nhất và đạt hiệu năng ngang bằng với các mô hình khuếch tán tiên tiến nhất (SDXL) chỉ trong bốn bước. ADD là phương pháp đầu tiên mở ra khả năng tổng hợp ảnh thời gian thực, một bước duy nhất bằng các mô hình nền tảng.
Mẹo
- SDXL Turbo sử dụng kiến trúc hoàn toàn giống với SDXL, điều này có nghĩa là nó cũng có cùng API. Vui lòng tham khảo tài liệu tham khảo API của SDXL để biết thêm chi tiết.
- SDXL Turbo nên tắt guidance scale bằng cách đặt
guidance_scale=0.0. - SDXL Turbo nên sử dụng
timestep_spacing='trailing'cho scheduler và sử dụng từ 1 đến 4 bước. - SDXL Turbo được huấn luyện để tạo ra các hình ảnh có kích thước 512x512.
- SDXL Turbo là open-access nhưng không phải open-source, điều này có nghĩa là bạn có thể phải mua giấy phép mô hình để sử dụng nó cho các ứng dụng thương mại. Hãy chắc chắn đọc model card chính thức để tìm hiểu thêm.
Hãy xem tổ chức Stability AI trên Hub để biết các checkpoint mô hình base và refiner chính thức!
Hãy đảm bảo bạn đã cài đặt các thư viện sau.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Tải các điểm kiểm tra của mô hình
Trọng số mô hình có thể được lưu trong các thư mục con riêng biệt trên Hub hoặc cục bộ, trong trường hợp đó, bạn nên sử dụng phương thức from_pretrained():
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
Bạn cũng có thể sử dụng phương thức from_single_file() để tải checkpoint mô hình được lưu trữ ở định dạng tệp đơn (.ckpt hoặc .safetensors) từ Hub hoặc cục bộ. Đối với phương pháp tải này, bạn cần đặt timestep_spacing="trailing" (hãy thoải mái thử nghiệm với các giá trị cấu hình scheduler khác để đạt kết quả tốt hơn):
from diffusers import StableDiffusionXLPipeline, EulerAncestralDiscreteScheduler
import torch

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/sdxl-turbo/blob/main/sd_xl_turbo_1.0_fp16.safetensors",
    dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
pipeline.scheduler = EulerAncestralDiscreteScheduler.from_config(pipeline.scheduler.config, timestep_spacing="trailing")
Văn bản sang hình ảnh
Đối với text-to-image, hãy truyền một text prompt. Mặc định, SDXL Turbo tạo ra ảnh 512x512, và độ phân giải này cho kết quả tốt nhất. Bạn có thể thử đặt tham số height và width thành 768x768 hoặc 1024x1024, nhưng hãy chuẩn bị cho việc chất lượng giảm đi khi làm như vậy.
Hãy đảm bảo đặt guidance_scale thành 0.0 để tắt, vì mô hình được huấn luyện mà không có nó. Một bước suy luận duy nhất là đủ để tạo ra các hình ảnh chất lượng cao.
Tăng số bước lên 2, 3 hoặc 4 nên cải thiện chất lượng hình ảnh.
from diffusers import AutoPipelineForText2Image
import torch

pipeline_text2image = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline_text2image = pipeline_text2image.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "A cinematic shot of a baby racoon wearing an intricate italian priest robe."

image = pipeline_text2image(prompt=prompt, guidance_scale=0.0, num_inference_steps=1).images[0]
image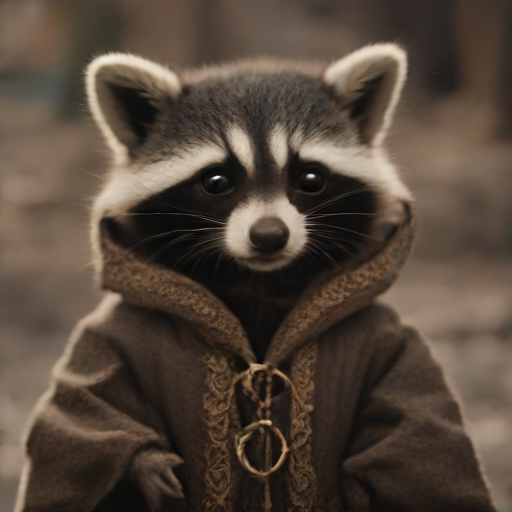
Ảnh sang ảnh
Đối với tạo ảnh từ ảnh, hãy đảm bảo rằng num_inference_steps * strength lớn hơn hoặc bằng 1.
Pipeline tạo ảnh từ ảnh sẽ chạy trong int(num_inference_steps * strength) bước, ví dụ 0.5 * 2.0 = 1 bước trong
ví dụ bên dưới.
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image, make_image_grid

# use from_pipe to avoid consuming additional memory when loading a checkpoint
pipeline_image2image = AutoPipelineForImage2Image.from_pipe(pipeline_text2image).to("cuda")  # or "mps", "xpu", "cpu"

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/cat.png")
init_image = init_image.resize((512, 512))

prompt = "cat wizard, gandalf, lord of the rings, detailed, fantasy, cute, adorable, Pixar, Disney, 8k"

image = pipeline_image2image(prompt, image=init_image, strength=0.5, guidance_scale=0.0, num_inference_steps=2).images[0]
make_image_grid([init_image, image], rows=1, cols=2)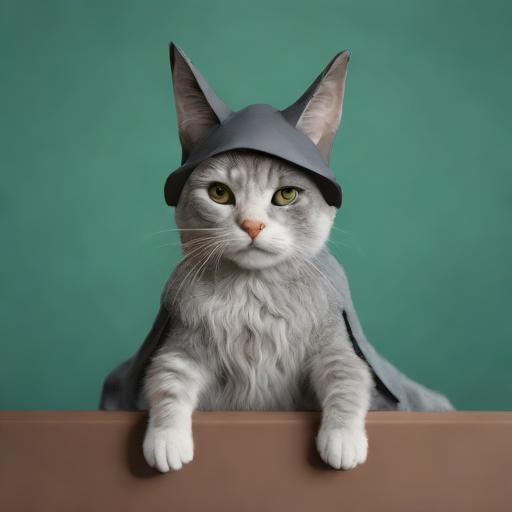
Tăng tốc SDXL Turbo hơn nữa
- Biên dịch UNet nếu bạn đang sử dụng phiên bản PyTorch 2.0 trở lên. Lần chạy suy luận đầu tiên sẽ rất chậm, nhưng các lần chạy sau đó sẽ nhanh hơn nhiều.
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)- Khi sử dụng VAE mặc định, hãy giữ nó ở
float32để tránh các chuyển đổidtypetốn kém trước và sau mỗi lần sinh. Bạn chỉ cần thực hiện điều này một lần trước lần sinh đầu tiên:
pipe.upcast_vae()
Một lựa chọn thay thế là bạn cũng có thể sử dụng VAE 16-bit do thành viên cộng đồng @madebyollin tạo ra, không cần phải upcast lên float32.