
Diffusers documentation
Pipelines de Stable Diffusion
Pipelines de Stable Diffusion

Stable Diffusion es un modelo de difusión latente de texto a imagen creado por los investigadores e ingenieros de CompVis, Stability AI y LAION. La difusión latente aplica el proceso de difusión sobre un espacio latente de menor dimensión para reducir la complejidad de memoria y de cómputo. Este tipo específico de modelo de difusión fue propuesto en High-Resolution Image Synthesis with Latent Diffusion Models por Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, Björn Ommer.
Stable Diffusion se entrena con imágenes de 512x512 de un subconjunto del conjunto de datos LAION-5B. Este modelo utiliza un codificador de texto CLIP ViT-L/14 congelado para condicionar el modelo con indicaciones de texto. Con su UNet de 860M y su codificador de texto de 123M, el modelo es relativamente ligero y puede ejecutarse en GPUs de consumo.
Para más detalles sobre cómo funciona Stable Diffusion y en qué se diferencia del modelo de difusión latente base, consulte el anuncio de Stability AI y nuestro propio post de blog para obtener más detalles técnicos.
Puedes encontrar el código original de Stable Diffusion v1.0 en CompVis/stable-diffusion y el de Stable Diffusion v2.0 en Stability-AI/stablediffusion, junto con sus scripts originales para diversas tareas. Los puntos de control oficiales adicionales para las diferentes versiones y tareas de Stable Diffusion se encuentran en las organizaciones de Hub CompVis y Stability AI. Explora estas organizaciones para encontrar el punto de control más adecuado para tu caso de uso.
La tabla siguiente resume los pipelines de Stable Diffusion disponibles, las tareas que admiten y una demo interactiva:
| Pipeline | Tareas admitidas | 🤗 Espacio |
|---|---|---|
| StableDiffusion | texto a imagen |  |
| StableDiffusionImg2Img | image-to-image | |
| StableDiffusionInpaint | inpainting | |
| StableDiffusionDepth2Img | depth-to-image | |
| StableDiffusionImageVariation | variación de imagen | |
| StableDiffusionPipelineSafe (obsoleto; sin página de documentación) | texto a imagen filtrado | |
| StableDiffusion2 | texto a imagen, inpainting, profundidad a imagen, super-resolución | |
| StableDiffusionXL | texto a imagen, imagen a imagen | |
| StableDiffusionLatentUpscale | super-resolución | |
| StableDiffusionUpscale | super-resolución | |
| StableDiffusionLDM3D | texto-a-rgb, texto-a-profundidad, texto-a-pano | |
| StableDiffusionUpscaleLDM3D | super-resolución de ldm3d |
Consejos
Para que aproveches al máximo los pipelines de Stable Diffusion, aquí tienes algunos consejos para mejorar el rendimiento y la usabilidad. Estos consejos son aplicables a todos los pipelines de Stable Diffusion.
Explorar el equilibrio entre velocidad y calidad
StableDiffusionPipeline utiliza PNDMScheduler de forma predeterminada, pero 🤗 Diffusers ofrece muchos otros schedulers (algunos de los cuales son más rápidos o producen una mejor calidad) que son compatibles. Por ejemplo, si desea usar EulerDiscreteScheduler en lugar del predeterminado:
from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler

pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config)

# or
euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler)
Reutilizar componentes de pipeline para ahorrar memoria
Para ahorrar memoria y usar los mismos componentes en varios pipelines, use el método .components para evitar cargar los pesos en la RAM más de una vez.
from diffusers import (
    StableDiffusionPipeline,
    StableDiffusionImg2ImgPipeline,
    StableDiffusionInpaintPipeline,
)

text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
img2img = StableDiffusionImg2ImgPipeline(**text2img.components)
inpaint = StableDiffusionInpaintPipeline(**text2img.components)

# now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline
Crear demostraciones web con gradio
Los pipelines de Stable Diffusion se admiten automáticamente en Gradio, una biblioteca que facilita la creación de aplicaciones de aprendizaje automático atractivas y fáciles de usar en la web. Primero, asegúrate de tener Gradio instalado:
pip install -U gradio
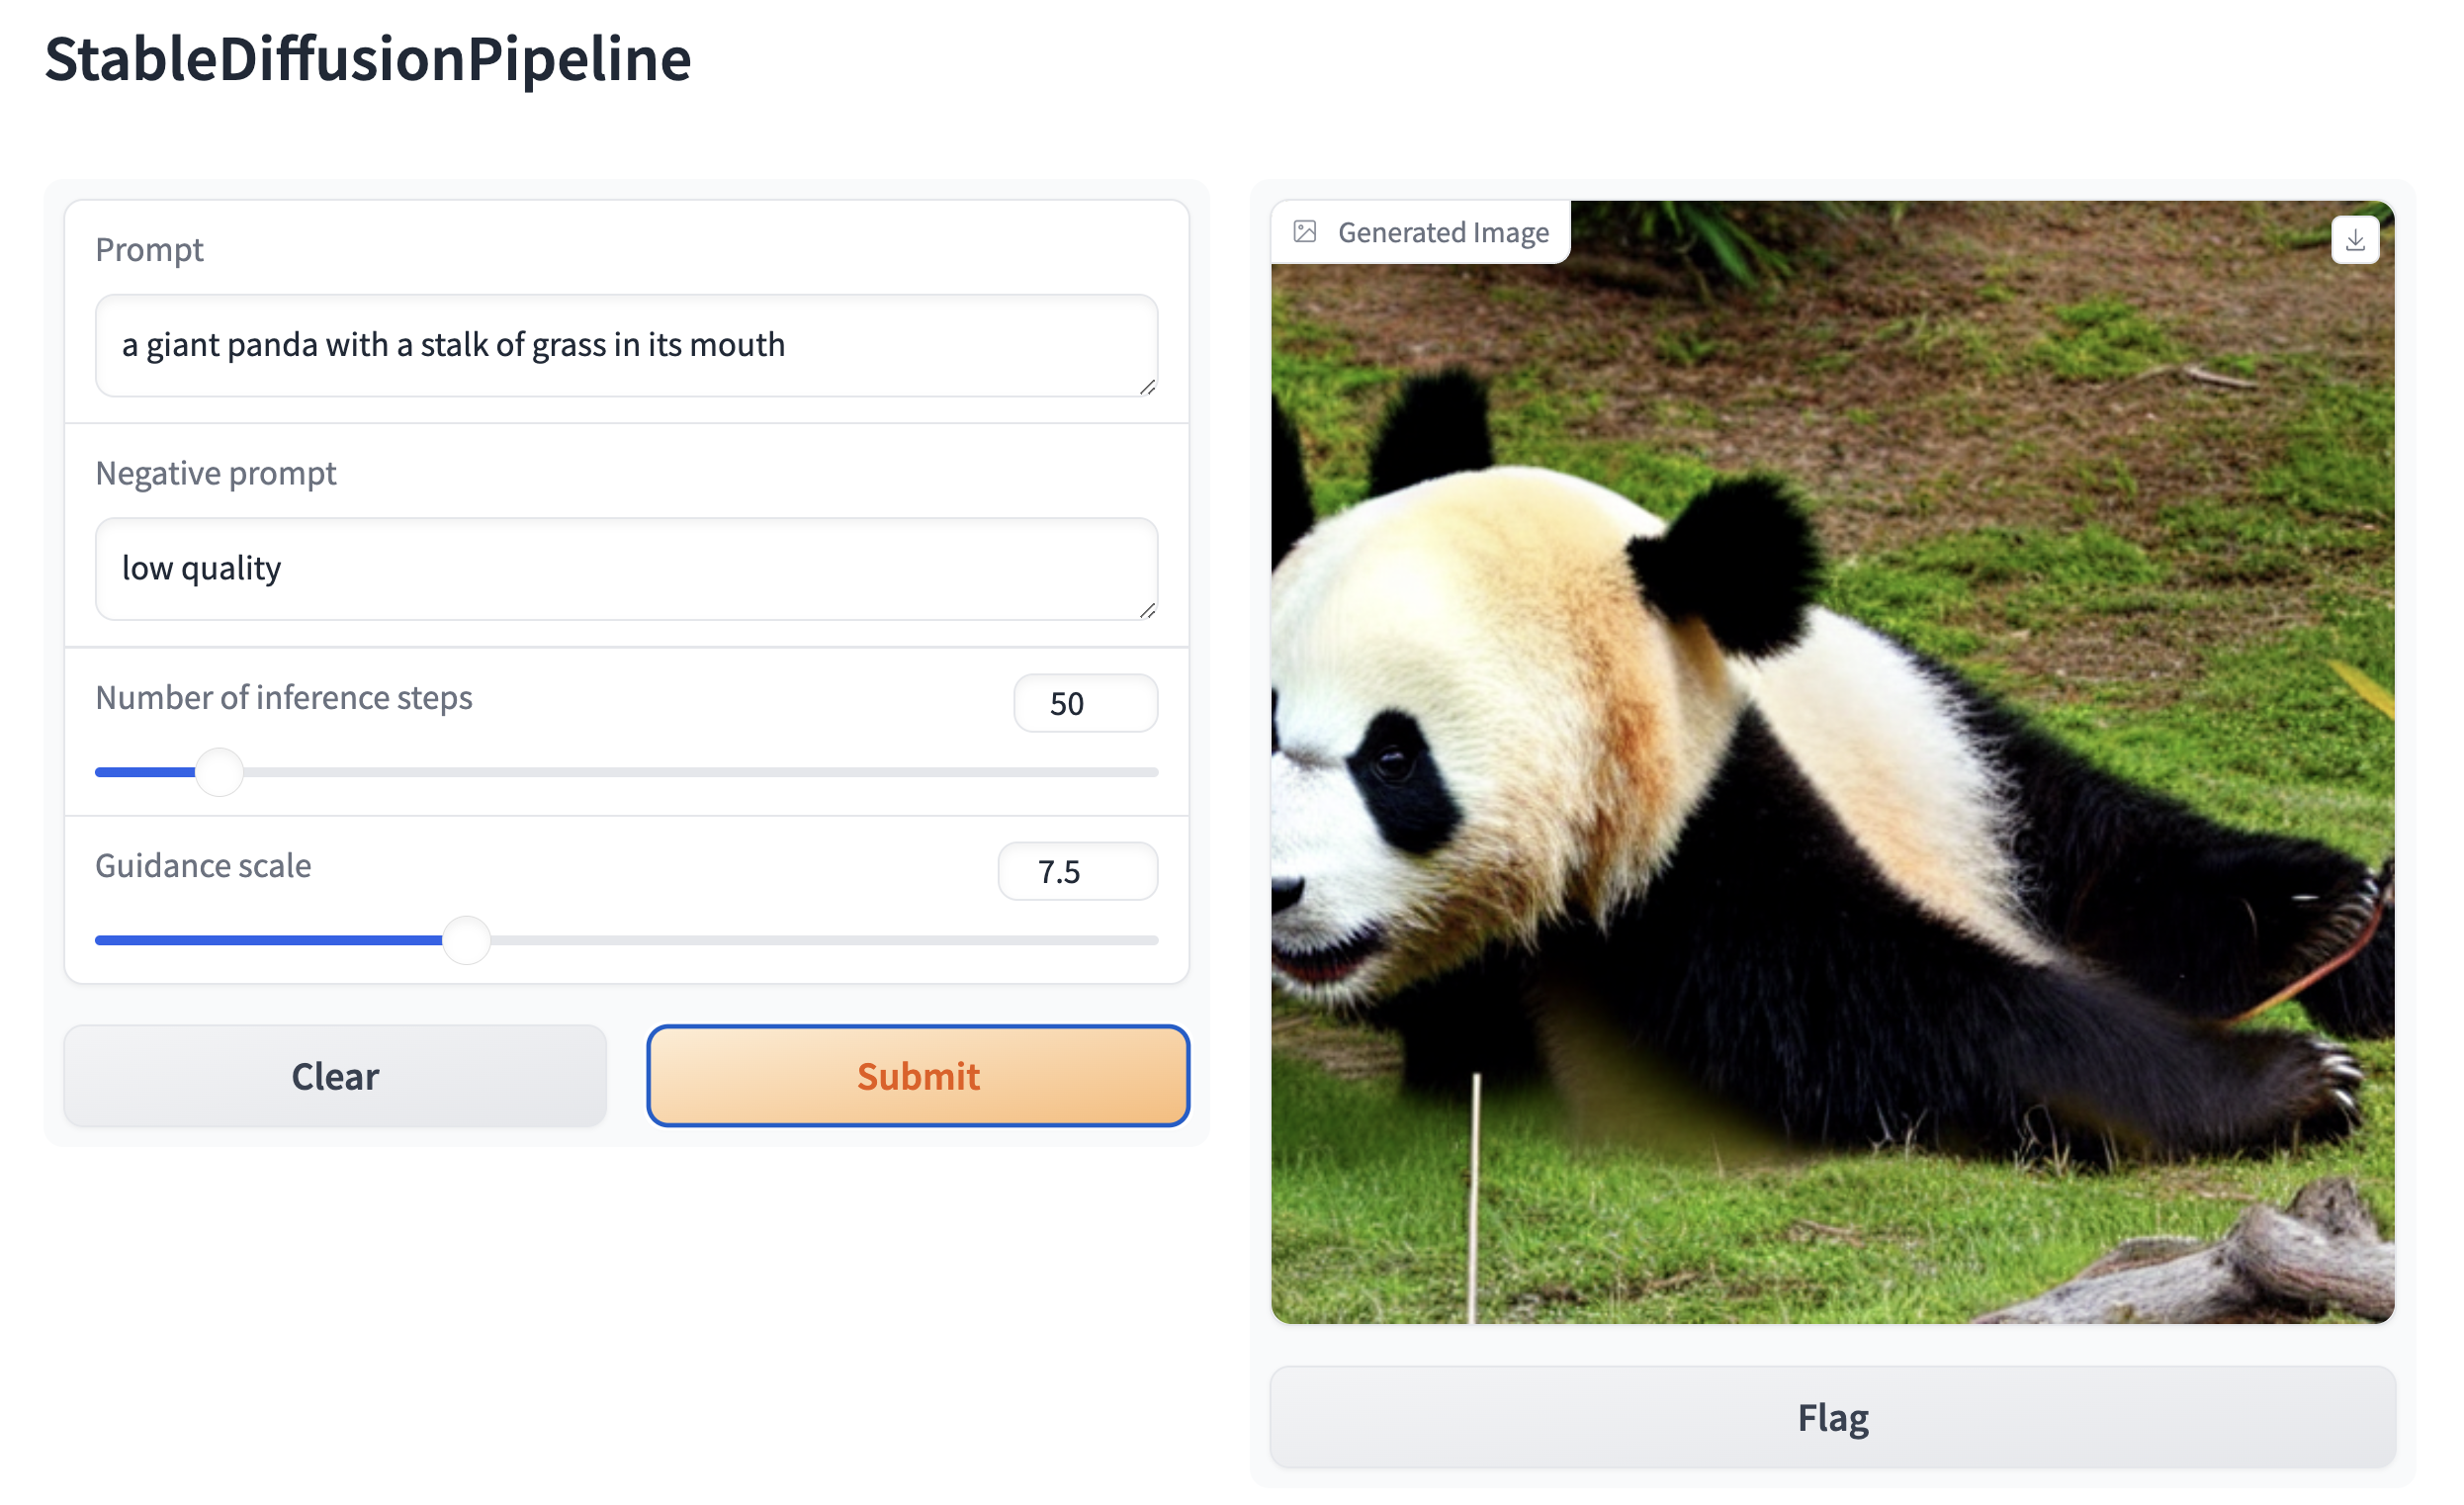
Luego, crea una demo web alrededor de cualquier pipeline basado en Stable Diffusion. Por ejemplo, puedes crear un pipeline de generación de imágenes en una sola línea de código con la función Interface.from_pipeline de Gradio:
from diffusers import StableDiffusionPipeline
import gradio as gr

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")

gr.Interface.from_pipeline(pipe).launch()
que abre una interfaz intuitiva de arrastrar y soltar en tu navegador:
De manera similar, podrías crear una demostración para un pipeline de imagen a imagen con:
from diffusers import StableDiffusionImg2ImgPipeline
import gradio as gr


pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5")

gr.Interface.from_pipeline(pipe).launch()
Por defecto, la demo web se ejecuta en un servidor local. Si deseas compartirla con otras personas, puedes generar un enlace público temporal estableciendo share=True en launch(). O bien, puedes alojar tu demo en Hugging Face Spaceshttps://huggingface.co/spaces para obtener un enlace permanente.