
Diffusers documentation
SDXL Turbo
SDXL Turbo
Stable Diffusion XL (SDXL) Turbo был предложен в работе Adversarial Diffusion Distillation авторами Axel Sauer, Dominik Lorenz, Andreas Blattmann и Robin Rombach.
Аннотация из статьи:
Мы представляем Adversarial Diffusion Distillation (ADD) — новый подход к обучению, который позволяет эффективно генерировать изображения с помощью крупных базовых диффузионных моделей всего за 1–4 шага, сохраняя при этом высокое качество изображений. Мы используем дистилляцию скоростей (score distillation), чтобы задействовать готовые крупномасштабные диффузионные модели изображений в качестве учителя, в сочетании с противоречивой потерей (adversarial loss) для обеспечения высокой точности изображений даже в режиме малого числа шагов — одного или двух. Наши анализы показывают, что наша модель явно превосходит существующие методы с малым числом шагов (GAN, Latent Consistency Models) за один шаг и достигает уровня передовых диффузионных моделей (SDXL) всего за четыре шага. ADD — первый метод, открывающий возможность одношагового синтеза изображений в реальном времени с использованием базовых моделей.
Советы
- SDXL Turbo использует точно такую же архитектуру, что и SDXL, что означает наличие у него того же API. Дополнительные сведения см. в справочнике по API SDXL.
- SDXL Turbo следует отключать масштаб руководства, установив
guidance_scale=0.0. - SDXL Turbo следует использовать
timestep_spacing='trailing'для планировщика и выполнять от 1 до 4 шагов. - SDXL Turbo обучен для генерации изображений размером 512x512.
- SDXL Turbo является моделью с открытым доступом, но не с открытым исходным кодом, что означает, что для её использования в коммерческих целях может потребоваться приобретение лицензии на модель. Обязательно ознакомьтесь с официальной карточкой модели, чтобы узнать больше.
Ознакомьтесь с организацией Stability AI на Hugging Face Hub, чтобы найти официальные контрольные точки базовой и уточняющей моделей!
Убедитесь, что у вас установлены следующие библиотеки.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Загрузка контрольных точек модели
Веса модели могут храниться в отдельных подпапках на Hub или локально, в этом случае следует использовать метод from_pretrained():
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
Вы также можете использовать метод from_single_file() для загрузки контрольной точки модели, сохраненной в формате одного файла (.ckpt или .safetensors), из Hub или локально. Для этого способа загрузки необходимо установить timestep_spacing="trailing" (вы можете экспериментировать с другими значениями конфигурации планировщика, чтобы получить лучшие результаты):
from diffusers import StableDiffusionXLPipeline, EulerAncestralDiscreteScheduler
import torch

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/sdxl-turbo/blob/main/sd_xl_turbo_1.0_fp16.safetensors",
    dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
pipeline.scheduler = EulerAncestralDiscreteScheduler.from_config(pipeline.scheduler.config, timestep_spacing="trailing")
Текст в изображение
Для генерации изображений по тексту передайте текстовый запрос. По умолчанию SDXL Turbo создаёт изображение размером 512x512, и именно это разрешение обеспечивает наилучшие результаты. Вы можете попробовать установить параметры height и width в 768x768 или 1024x1024, но в этом случае следует ожидать ухудшения качества.
Убедитесь, что параметр guidance_scale установлен в 0.0 для отключения, так как модель обучалась без него. Одного шага инференса достаточно для генерации изображений высокого качества.
Увеличение числа шагов до 2, 3 или 4 должно улучшить качество изображений.
from diffusers import AutoPipelineForText2Image
import torch

pipeline_text2image = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline_text2image = pipeline_text2image.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "A cinematic shot of a baby racoon wearing an intricate italian priest robe."

image = pipeline_text2image(prompt=prompt, guidance_scale=0.0, num_inference_steps=1).images[0]
image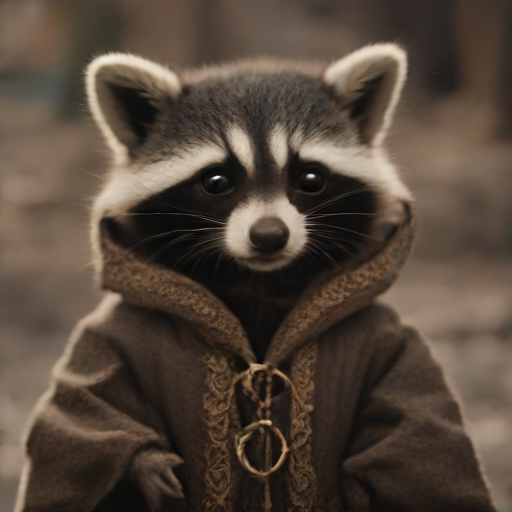
Изображение в изображение
Для генерации изображений по изображению убедитесь, что num_inference_steps * strength больше или равно 1.
Пайплайн image-to-image будет выполняться в течение int(num_inference_steps * strength) шагов, например, 0.5 * 2.0 = 1 шаг в
нашем примере ниже.
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image, make_image_grid

# use from_pipe to avoid consuming additional memory when loading a checkpoint
pipeline_image2image = AutoPipelineForImage2Image.from_pipe(pipeline_text2image).to("cuda")  # or "mps", "xpu", "cpu"

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/cat.png")
init_image = init_image.resize((512, 512))

prompt = "cat wizard, gandalf, lord of the rings, detailed, fantasy, cute, adorable, Pixar, Disney, 8k"

image = pipeline_image2image(prompt, image=init_image, strength=0.5, guidance_scale=0.0, num_inference_steps=2).images[0]
make_image_grid([init_image, image], rows=1, cols=2)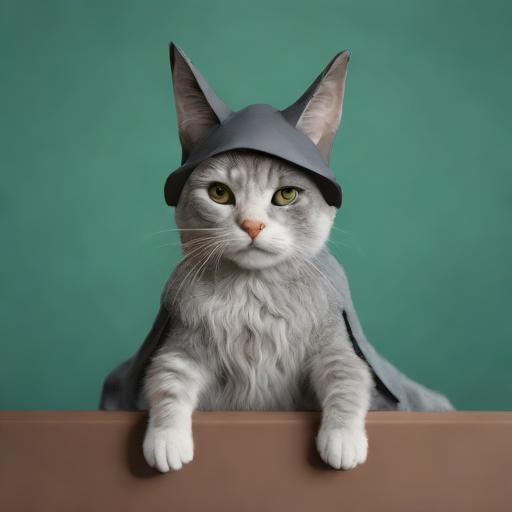
Ускорение SDXL Turbo ещё больше
- Скомпилируйте UNet, если вы используете версию PyTorch 2.0 или выше. Первый запуск инференса будет очень медленным, но последующие — значительно быстрее.
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)- При использовании VAE по умолчанию сохраняйте его в
float32, чтобы избежать дорогостоящих преобразованийdtypeперед и после каждой генерации. Это нужно сделать один раз, перед первой генерацией:
pipe.upcast_vae()
В качестве альтернативы можно также использовать 16-битный VAE, созданный участником сообщества @madebyollin, который не требует приведения к float32.