
Transformers documentation
البدء السريع
البدء السريع
صُمم Transformers ليكون سريعًا وسهل الاستخدام، بحيث يستطيع الجميع البدء في التعلم أو بناء نماذج التحويل (transformer models).
يقتصر عدد التجريدات الموجهة للمستخدمين على ثلاث فئات فقط لإنشاء نموذج، وواجهتي برمجة للتطبيق أو التدريب. يقدّم هذا الدليل السريع لمحة عن الميزات الأساسية في Transformers ويوضح لك كيفية:
الإعداد
للبداية، ننصح بإنشاء حساب على Hugging Face. يتيح لك الحساب استضافة النماذج ومجموعات البيانات وSpaces وإدارتها مع التحكم في الإصدارات، والوصول إليها عبر Hub على Hugging Face، وهي منصة تعاونية للاكتشاف والبناء.
أنشئ رمز وصول المستخدم وسجّل الدخول إلى حسابك.
الصق رمز الوصول للمستخدم الخاص بك في notebook_login عند طلب تسجيل الدخول.
from huggingface_hub import notebook_login

notebook_login()
تأكد من تثبيت حزمة huggingface_hub[cli] ثم نفّذ الأمر أدناه. عند الطلب، الصق رمز الوصول للمستخدم (User Access Token) لتسجيل الدخول.
hf auth login
قم بتثبيت PyTorch.
# remove ! if installing from the CLI
!pip install torch
ثم ثبّت أحدث إصدار من Transformers وبعض المكتبات الإضافية من منظومة Hugging Face للوصول إلى مجموعات البيانات ونماذج الرؤية، وتقييم التدريب، وتحسين التدريب للنماذج الكبيرة.
# remove ! if installing from the CLI
!pip install -U transformers datasets evaluate accelerate timm
مهارات الوكيل
تعلّم Hugging Face Skills وكيل البرمجة لديك كيفية العمل مع Transformers. بدلاً من كتابة سكربت تدريب بنفسك، اطلب من وكيلك ضبط نموذج رؤية دقيقاً ودع المهارة تقوده في ذلك.
/plugin marketplace add huggingface/skills
/plugin install hf-cli@huggingface/skills
codex plugin marketplace add huggingface/skills
ثم شغّل /plugins في Codex وقم بتثبيت مهارة من مستودع huggingface/skills.
راجع دليل التثبيت لمعرفة المزيد من المنصات المدعومة مثل Cursor وGemini.
بمجرد تثبيت المهارة، قم بتضمينها في تعليماتك لوكيل البرمجة.
Use the HF Trainer skill to fine-tune RT-DETRv2 on [Lekim89/sportsmot](https://huggingface.co/datasets/Lekim89/sportsmot) for basketball player tracking.النماذج المُسبقة التدريب
يرث كل نموذج مُدرَّب مسبقًا من ثلاث فئات أساسية.
| فئة | الوصف |
|---|---|
| PreTrainedConfig | ملف يحدد سمات النموذج، مثل عدد رؤوس الانتباه أو حجم المفردات. |
| PreTrainedModel | نموذج (أو بنية) يُعرَّف بواسطة سمات النموذج من ملف الإعداد. النموذج المُدرَّب مسبقًا يعيد حالات الإخفاء الخام فقط. لمهمة محددة، استخدم رأس النموذج المناسب لتحويل حالات الإخفاء الخام إلى نتيجة ذات معنى (على سبيل المثال، LlamaModel مقابل LlamaForCausalLM). |
| المعالج المسبق | فئة لتحويل المدخلات الخام (نص، صور، صوت، متعدد الوسائط) إلى مدخلات رقمية للنموذج. على سبيل المثال، يحول PreTrainedTokenizer النص إلى متجهات (tensors)، ويحول ImageProcessingMixin البكسلات إلى متجهات. |
نوصي باستخدام واجهة AutoClass لتحميل النماذج ومعالجات ما قبل المعالجة، لأنها تستنتج تلقائيًا البنية المناسبة لكل مهمة وإطار تعليل الآلة بناءً على اسم أو مسار أوزان ما قبل التدريب وملف الإعداد.
استخدم from_pretrained() لتحميل الأوزان وملف الإعدادات من Hub إلى فئة النموذج ومعالج ما قبل المعالجة.
عند تحميل نموذج، قم بإعداد المعلمات التالية لضمان تحميل النموذج بشكل مثالي.
device_map="auto"يوزّع أوزان النموذج تلقائيًا على أسرع جهاز لديك أولًا.dtype="auto"يهيّئ أوزان النموذج مباشرةً في نوع البيانات المخزَّن بها، مما قد يساعد على تجنّب تحميل الأوزان مرتين (حيث يقوم PyTorch بتحميل الأوزان بنوعtorch.float32افتراضيًا).
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf", dtype="auto", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
قم بتجزئة النص وإرجاع متجهات PyTorch باستخدام مُجزّئ الرموز. انقل المدخلات المجزأة إلى نفس الجهاز الذي يعمل عليه النموذج قبل تنفيذ الاستدلال حتى يتمكن النموذج من معالجتها.
model_inputs = tokenizer(["The secret to baking a good cake is "], return_tensors="pt").to(model.device)أصبح النموذج الآن جاهزاً للاستدلال أو التدريب.
لأغراض الاستدلال، مرّر المدخلات المُرمّزة إلى generate() لتوليد النص. ثم فكّ ترميز معرّفات الرموز (token ids) مرة أخرى إلى نص باستخدام batch_decode().
generated_ids = model.generate(**model_inputs, max_length=30)
tokenizer.batch_decode(generated_ids)[0]
'<s> The secret to baking a good cake is 100% in the preparation. There are so many recipes out there,'
تخطَّ إلى قسم Trainer لمعرفة كيفية ضبط نموذج.
خط أنابيب
تُعد فئة Pipeline الطريقة الأكثر ملاءمةً لتشغيل الاستدلال باستخدام نموذج مُدرَّب مسبقًا. وهي تدعم العديد من المهام مثل توليد النص، وتجزئة الصور، والتعرف التلقائي على الكلام، والإجابة على الأسئلة من المستندات، وغيرها.
راجع مرجع واجهة Pipeline البرمجية للحصول على قائمة كاملة بالمهام المتاحة.
أنشئ كائن Pipeline واختر مهمة. افتراضياً، يقوم Pipeline بتنزيل نموذج مُدرَّب مسبقاً افتراضياً للمهمة المحددة وتخزينه مؤقتاً. مرر اسم النموذج إلى معامل model لاختيار نموذج محدد.
استخدم Accelerator للكشف تلقائيًا عن معالج متاح للاستدلال.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipe = pipeline("text-generation", model="meta-llama/Llama-2-7b-hf", device=device)
أمر Pipeline مع بعض النص الأولي لتوليد المزيد من النص.
pipe("The secret to baking a good cake is ", max_length=50)
[{'generated_text': 'The secret to baking a good cake is 100% in the batter. The secret to a great cake is the icing.\nThis is why we’ve created the best buttercream frosting reci'}]
استخدم Accelerator للكشف تلقائيًا عن معالج متاح للاستدلال.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("image-segmentation", model="facebook/detr-resnet-50-panoptic", device=device)
مرّر صورة - عنوان URL أو مسار محلي للصورة - إلى Pipeline.
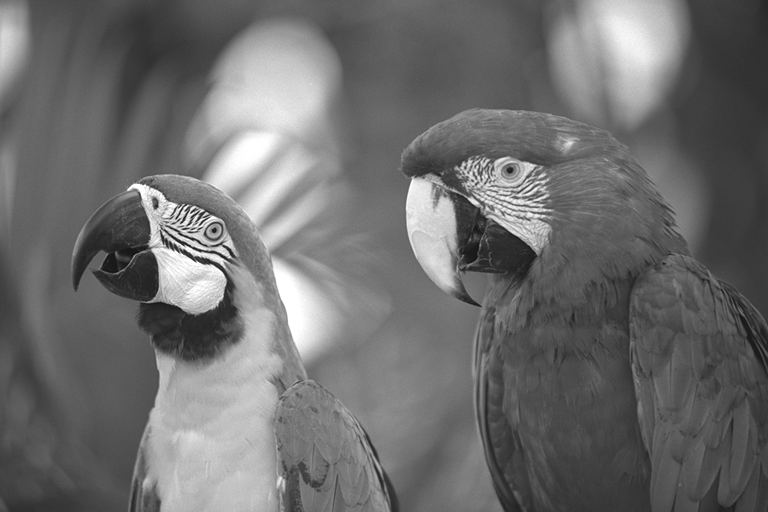
segments = pipeline("https://huggingface.co/datasets/Narsil/image_dummy/raw/main/parrots.png")
segments[0]["label"]
'bird'
segments[1]["label"]
'bird'
استخدم Accelerator للكشف تلقائيًا عن معالج متاح للاستدلال.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("automatic-speech-recognition", model="openai/whisper-large-v3", device=device)
مرّر ملفًا صوتيًا إلى Pipeline.
pipeline("https://huggingface.co/datasets/Narsil/asr_dummy/resolve/main/1.flac")
{'text': ' He hoped there would be stew for dinner, turnips and carrots and bruised potatoes and fat mutton pieces to be ladled out in thick, peppered flour-fatten sauce.'}
Trainer
Trainer هو حلقة تدريب وتقييم كاملة لنماذج PyTorch. إنه يُخفي الكثير من الشيفرة التمهيدية المعتادة عند كتابة حلقة تدريب يدويًا، مما يتيح لك البدء في التدريب بشكل أسرع والتركيز على خيارات تصميم التدريب. كل ما تحتاجه هو نموذج، ومجموعة بيانات، ومعالج مسبق، ومُجمِّع بيانات لإنشاء دفعات من البيانات من مجموعة البيانات.
استخدم فئة TrainingArguments لتخصيص عملية التدريب. فهي توفر العديد من الخيارات للتدريب والتقييم والمزيد. جرّب ضبط المعاملات الفائقة للتدريب والميزات مثل حجم الدفعة (batch size) ومعدل التعلم (learning rate) والدقة المختلطة (mixed precision) وtorch.compile وغيرها لتلبية احتياجات التدريب الخاصة بك. كما يمكنك استخدام معاملات التدريب الافتراضية لإنتاج خط أساس بسرعة.
حمّل نموذجًا ومُقسِّمًا ومجموعة بيانات للتدريب.
from transformers import AutoModelForSequenceClassification, AutoTokenizer
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained("distilbert/distilbert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased")
dataset = load_dataset("cornell-movie-review-data/rotten_tomatoes")
أنشئ دالة لتجزئة النص وتحويله إلى تينسورات PyTorch. طبّق هذه الدالة على مجموعة البيانات بأكملها باستخدام طريقة map.
def tokenize_dataset(dataset):
    return tokenizer(dataset["text"])
dataset = dataset.map(tokenize_dataset, batched=True)
حمّل مُجمِّع بيانات (data collator) لإنشاء دفعات من البيانات، وقم بتمرير مُرمِّز الرموز (tokenizer) إليه.
from transformers import DataCollatorWithPadding

data_collator = DataCollatorWithPadding(tokenizer=tokenizer)
بعد ذلك، اضبط TrainingArguments باستخدام ميزات التدريب ومعاملات الضبط.
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="distilbert-rotten-tomatoes",
    learning_rate=2e-5,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=2,
    push_to_hub=True,
)
أخيراً، مرّر جميع هذه المكونات المنفصلة إلى Trainer واستدعِ train() للبدء.
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["test"],
    processing_class=tokenizer,
    data_collator=data_collator,
)

trainer.train()
شارك نموذجك ومُجزّئ الرموز على Hub باستخدام push_to_hub().
trainer.push_to_hub()
تهانينا، لقد درّبت للتو أول نموذج لك باستخدام Transformers!
الخطوات التالية
الآن، وبما أنك اكتسبت فهماً أعمق لمكتبة Transformers وما تقدمه، فقد حان الوقت للمتابعة في الاستكشاف والتعلم فيما يثير اهتمامك أكثر من غيره.
- الفئات الأساسية: تعرّف على المزيد حول فئات الإعداد والنموذج والمعالج. سيساعدك هذا على فهم كيفية إنشاء النماذج وتخصيصها، ومعالجة المدخلات المختلفة (الصوت، الصور، متعددة الوسائط) مسبقاً، وكيفية مشاركة نموذجك.
- الاستدلال: استكشف Pipeline بشكل أعمق، والاستدلال والدردشة مع نماذج اللغة الكبيرة (LLMs) والوكلاء، وكيفية تحسين الاستدلال باستخدام إطار عمل تعلم الآلة والأجهزة لديك.
- التدريب: ادرس Trainer بتفصيل أكبر، بالإضافة إلى التدريب الموزّع وتحسين التدريب على أجهزة محددة.
- التكميم: قلّل متطلبات الذاكرة والتخزين من خلال التكميم، وسرّع الاستدلال عبر تمثيل الأوزان بعدد أقل من البتات.
- الموارد: هل تبحث عن وصفات شاملة من البداية إلى النهاية حول كيفية تدريب النموذج والاستدلال به لمهمة محددة؟ اطّلع على وصفات المهام!