
Transformers documentation
FastSpeech2Conformer
このモデルは2020年10月26日にHF papersで公開され、2024年1月3日にHugging Face Transformersに貢献されました。
FastSpeech2Conformer
概要
FastSpeech2Conformerモデルは、Pengcheng Guo、Florian Boyer、Xuankai Chang、Tomoki Hayashi、Yosuke Higuchi、Hirofumi Inaguma、Naoyuki Kamo、Chenda Li、Daniel Garcia-Romero、Jiatong Shi、Jing Shi、Shinji Watanabe、Kun Wei、Wangyou Zhang、Yuekai Zhang による論文 Recent Developments On Espnet Toolkit Boosted By Conformer で提案されました。
FastSpeech2の元論文の要旨は以下の通りです。
FastSpeech(Ren et al., 2019)のような非自己回帰型テキスト読み上げ(TTS)モデルは、従来の自己回帰型モデルと同等の品質を保ちながら、はるかに高速に音声合成を行うことができます。FastSpeechモデルの学習には、長さ予測(より多くの情報を入力として提供するため)と知識蒸留(出力のデータ分布を単純化するため)のために自己回帰型教師モデルが用いられますが、これによりTTSにおける1対多のマッピング問題(つまり、同じテキストに対応する複数の音声バリエーション)を緩和できます。しかし、FastSpeechにはいくつかの欠点があります。1)教師-生徒の蒸留パイプラインが複雑で時間がかかること、2)教師モデルから抽出される長さが十分に正確でなく、また教師モデルから蒸留されるターゲットのメルスペクトログラムはデータ単純化による情報損失を被るため、どちらも音声品質を制限することです。本論文では、FastSpeech 2を提案します。FastSpeech 2は、1)教師からの単純化された出力ではなく、正解データ(ground-truth)のターゲットでモデルを直接学習させること、2)音声をより多様にする情報(ピッチ、エネルギー、より正確な長さなど)を条件付き入力として導入することで、FastSpeechの問題に対処し、TTSにおける1対多のマッピング問題をよりよく解決します。具体的には、音声波形から長さ、ピッチ、エネルギーを抽出し、それらを学習時の条件付き入力として直接使用し、推論時には予測値を使用します。さらに、FastSpeech 2sを設計しました。これはテキストから並列に直接音声波形を生成する初の試みであり、完全にエンドツーエンドの推論の利点を享受します。実験結果から、1)FastSpeech 2はFastSpeechに対して3倍の学習速度向上を実現し、FastSpeech 2sはさらに高速な推論速度を享受すること、2)FastSpeech 2および2sは音声品質においてFastSpeechを上回り、FastSpeech 2は自己回帰型モデルすら上回ることが示されました。音声サンプルはhttps://speechresearch.github.io/fastspeech2/で入手できます。
このモデルは Connor Henderson によって提供されました。元のコードは こちら で確認できます。
🤗 モデルアーキテクチャ
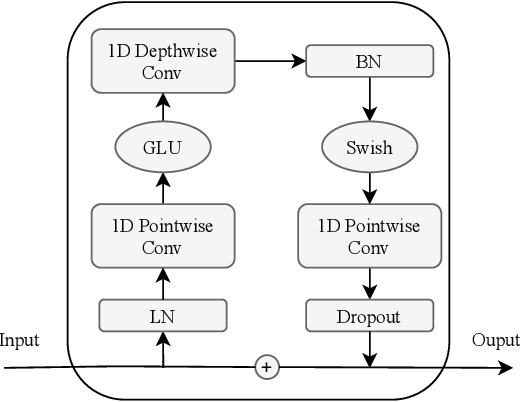
FastSpeech2の一般的な構造とMelスペクトログラムデコーダーを実装し、ESPnetライブラリと同様に、従来のtransformerブロックをconformerブロックに置き換えました。
FastSpeech2 モデルアーキテクチャ

Conformer ブロック

畳み込みモジュール
🤗 Transformers の使用方法
FastSpeech2Conformer は、🤗 Transformers ライブラリを使用してローカルで実行できます。
- まず、🤗 Transformers ライブラリと g2p-en をインストールします:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- モデルとhifiganをそれぞれ個別に使用して、Transformersのモデリングコードで推論を実行します
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Transformers のモデリングコードで推論を実行し、モデルと hifigan を組み合わせて使用します
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- パイプラインで推論を実行し、使用するボコーダーを指定します
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
クラス transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
パラメータ
- is_encoder_decoder (
bool、任意、デフォルトはTrue) — モデルがエンコーダー/デコーダーとして使用されるかどうかを示します。 - hidden_size (
int、任意、デフォルトは384) — 隠れ表現の次元数。 - vocab_size (
int、任意、デフォルトは78) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - num_mel_bins (
int, 任意、デフォルトは80) — 入力フレームごとに使用される mel 特徴の数を指定します。AutoFeatureExtractorクラスで使用された値と一致させる必要があります。 - encoder_num_attention_heads (
int、任意、デフォルトは 2) — エンコーダーの注意ヘッド数です。 - encoder_layers (
int、任意、デフォルトは4) — Transformer エンコーダーの隠れ層の数です。設定されていない場合、num_layersと同じ値が使用されます。 - encoder_linear_units (
int、任意、デフォルトは 1536) — エンコーダーの線形層のユニット数です。 - decoder_layers (
int、任意、デフォルトは4) — Transformer デコーダーの隠れ層の数です。設定されていない場合、num_layersと同じ値が使用されます。 - decoder_num_attention_heads (
int、任意、デフォルトは2) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - decoder_linear_units (
int、任意、デフォルトは 1536) — デコーダーの線形層のユニット数です。 - speech_decoder_postnet_layers (
int、任意、デフォルトは 5) — 音声デコーダーのポストネットの層数です。 - speech_decoder_postnet_units (
int、任意、デフォルト値は 256) — 音声デコーダーのポストネット層のユニット数です。 - speech_decoder_postnet_kernel (
int、任意、デフォルト値は 5) — 音声デコーダーの post-net におけるカーネルサイズです。 - positionwise_conv_kernel_size (
int, 任意、デフォルトは 3) — ポジションワイズ層で使用する畳み込みカーネルのサイズです。 - encoder_normalize_before (
bool、任意、デフォルトはFalse) — エンコーダー層の前に正規化を行うかどうかを指定します。 - decoder_normalize_before (
bool、省略可、デフォルトはFalse) — デコーダー層の前に正規化を行うかどうかを指定します。 - encoder_concat_after (
bool、省略可、デフォルトはFalse) — エンコーダ層の後に連結を行うかどうかを指定します。 - decoder_concat_after (
bool、省略可、デフォルトはFalse) — デコーダー層の後に連結を行うかどうかを指定します。 - reduction_factor (
int、任意、デフォルトは 1) — 音声フレームレートを削減する倍率です。 - speaking_speed (
float、任意、デフォルト値は 1.0)— 生成される音声の速度です。 - use_macaron_style_in_conformer (
bool、省略可能、デフォルトはTrue) — conformer で macaron style を使用するかどうかを指定します。 - use_cnn_in_conformer (
bool、任意、デフォルトはTrue) — conformer で畳み込みニューラルネットワークを使用するかどうかを指定します。 - encoder_kernel_size (
int、任意、デフォルトは 7) — エンコーダーで使用するカーネルサイズ。 - decoder_kernel_size (
int、任意、デフォルトは 31) — デコーダーで使用するカーネルサイズです。 - duration_predictor_layers (
int、任意、デフォルト値は 2)— duration predictor の層数です。 - duration_predictor_channels (
int、任意、デフォルトは 256) — duration predictor のチャネル数です。 - duration_predictor_kernel_size (
int, 任意、デフォルトは 3) — duration predictor で使用されるカーネルサイズです。 - energy_predictor_layers (
int、任意、デフォルトは 2) — エネルギー予測器の層数です。 - energy_predictor_channels (
int、任意、デフォルトは 256) — エネルギー予測器のチャネル数です。 - energy_predictor_kernel_size (
int、省略可、デフォルトは 3) — エネルギー予測器で使用するカーネルサイズ。 - energy_predictor_dropout (
float、任意、デフォルト値は 0.5) — エネルギー予測器における dropout レートです。 - energy_embed_kernel_size (
int、任意、デフォルトは 1) — energy embed レイヤーで使用するカーネルサイズです。 - energy_embed_dropout (
float、省略可、デフォルト値は 0.0) — energy embed レイヤーにおける dropout レートです。 - stop_gradient_from_energy_predictor (
bool、任意、デフォルトはFalse) — エネルギー予測器からの勾配を停止するかどうかを指定します。 - pitch_predictor_layers (
int、任意、デフォルト値は 5)— ピッチ予測器の層数です。 - pitch_predictor_channels (
int、任意、デフォルトは 256) — ピッチ予測器のチャネル数です。 - pitch_predictor_kernel_size (
int、任意、デフォルト値は 5)— ピッチ予測器で使用するカーネルサイズです。 - pitch_predictor_dropout (
float、任意、デフォルト値は 0.5)— ピッチ予測器における dropout レートです。 - pitch_embed_kernel_size (
int、任意、デフォルトは 1) — ピッチ埋め込み層で使用するカーネルサイズ。 - pitch_embed_dropout (
float、任意、デフォルト値は 0.0) — ピッチ埋め込み層における dropout 率です。 - stop_gradient_from_pitch_predictor (
bool、任意、デフォルトはTrue) — ピッチ予測器からの勾配を停止するかどうかを指定します。 - encoder_dropout_rate (
float、任意、デフォルト値は 0.2) — エンコーダーにおける dropout レートです。 - encoder_positional_dropout_rate (
float、任意、デフォルト値は 0.2) — エンコーダーにおける位置ドロップアウト率です。 - encoder_attention_dropout_rate (
float、任意、デフォルト値は 0.2) — エンコーダーにおけるアテンションのドロップアウト率です。 - decoder_dropout_rate (
float、任意、デフォルト値は 0.2) — デコーダーにおける dropout 率です。 - decoder_positional_dropout_rate (
float、任意、デフォルト値は 0.2) — デコーダーにおける位置ドロップアウト率です。 - decoder_attention_dropout_rate (
float、任意、デフォルト値は 0.2) — デコーダーにおけるアテンションのドロップアウト率です。 - duration_predictor_dropout_rate (
float、任意、デフォルト値は 0.2) — duration predictor における dropout rate です。 - speech_decoder_postnet_dropout (
float、任意、デフォルト値は 0.5) — 音声デコーダーのポストネットにおけるドロップアウト率です。 - max_source_positions (
int、任意、デフォルト値は 5000)—"relative"の位置埋め込みを使用する場合、ソース入力の最大位置を定義します。 - use_masking (
bool、任意、デフォルトはTrue) — モデルでマスキングを使用するかどうかを指定します。 - use_weighted_masking (
bool、任意、デフォルトはFalse) — モデルで重み付きマスキングを使用するかどうかを指定します。 - num_speakers (
int, 任意) — 話者の数です。1 より大きい値に設定した場合、話者 ID が入力として提供されると仮定し、話者 ID 埋め込み層を使用します。 - num_languages (
int, 任意) — 言語の数。1 より大きい値に設定した場合、言語 ID が入力として提供されると仮定し、言語 ID 埋め込み層を使用します。 - speaker_embed_dim (
int, 任意) — スピーカー埋め込みの次元数。0 より大きい値に設定した場合、speaker_embedding が入力として提供されるものと仮定します。 - convolution_bias (
bool、任意、デフォルトはTrue) — Conformer の convolution モジュールでバイアスを使用するかどうかを指定します。
これは、FastSpeech2ConformerModel の設定を保存するための設定クラスです。指定された引数に基づいて Fastspeech2 Conformer モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、espnet/fastspeech2_conformer と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
クラス transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
パラメータ
- model_in_dim (
int、任意、デフォルト値は 80) — 入力ログメルスペクトログラムの周波数ビンの数です。 - upsample_initial_channel (
int、任意、デフォルトは 512) — アップサンプリングネットワークへの入力チャネル数です。 - upsample_rates (
tuple[int]またはlist[int]、省略可能、デフォルトは[8, 8, 2, 2]) — アップサンプリングネットワーク内の各1次元畳み込み層のストライドを定義する整数のタプルです。upsample_rates の長さが畳み込み層の数を定義し、upsample_kernel_sizes の長さと一致する必要があります。 - upsample_kernel_sizes (
tuple[int]またはlist[int]、省略可能、デフォルトは[16, 16, 4, 4]) — アップサンプリングネットワーク内の各1次元畳み込み層のカーネルサイズを定義する整数のタプルです。upsample_kernel_sizes の長さが畳み込み層の数を定義し、upsample_rates の長さと一致する必要があります。 - resblock_kernel_sizes (
tuple[int]またはlist[int]、任意、デフォルトは[3, 7, 11]) — マルチレセプティブフィールドフュージョン(MRF)モジュール内の1次元畳み込み層のカーネルサイズを定義する整数のタプル。 - resblock_dilation_sizes (
tuple[tuple[int]]またはlist[list[int]]、任意、デフォルトは[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — multi-receptive field fusion (MRF) モジュール内の、拡張された1次元畳み込み層のdilation rateを定義する整数のネストされたタプルです。 - initializer_range (
float、任意、デフォルトは0.01) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - leaky_relu_slope (
float、任意、デフォルト値は 0.1) — Leaky ReLU 活性化関数で使用する負の傾きの角度です。 - normalize_before (
bool、任意、デフォルトはTrue) — ボコーダーの学習済み平均と分散を用いて、ボコーディング前にスペクトログラムを正規化するか否かを指定します。
これは、FastSpeech2ConformerModel の設定を保存するための設定クラスです。指定された引数に基づいて Fastspeech2 Conformer モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、espnet/fastspeech2_conformer_with_hifigan と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
クラス transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
これは、FastSpeech2ConformerModel の設定を保存するための設定クラスです。指定された引数に基づいて Fastspeech2 Conformer モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、espnet/fastspeech2_conformer_with_hifigan と同様の設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
クラス transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
パラメータ
- vocab_file (
str) — 語彙ファイルへのパス。 - bos_token (
str、任意、デフォルトは"<sos/eos>") — シーケンスの開始トークンです。FastSpeech2 では、eos_tokenと同じです。 - eos_token (
str、任意、デフォルトは"<sos/eos>") — シーケンスの終了トークンです。FastSpeech2 では、bos_tokenと同じです。 - pad_token (
str、任意、デフォルトは"<blank>") — パディングに使用されるトークンです。例えば、長さが異なるシーケンスをバッチ処理する際に使用します。 - unk_token (
str、任意、デフォルトは"<unk>") — 不明トークンです。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。 - should_strip_spaces (
bool、省略可、デフォルトはFalse) — トークンのリストからスペースを除去するかどうかを指定します。
FastSpeech2Conformerのトークナイザーを構築します。
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
パラメータ
- text (
str、list[str]、list[list[str]]、任意) — エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは、文字列または文字列のリスト(事前トークン化済み文字列)であることができます。シーケンスが文字列のリスト(事前トークン化済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - text_pair (
str、list[str]、list[list[str]]、任意) — エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは、文字列または文字列のリスト(事前トークン化された文字列)であることができます。シーケンスが文字列のリスト(事前トークン化済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - text_target (
str、list[str]、list[list[str]]、任意) — ターゲットテキストとしてエンコードされるシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(プレトークナイズ済み文字列)であることができます。シーケンスが文字列のリスト(プレトークナイズ済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - text_pair_target (
str、list[str]、list[list[str]]、任意) — ターゲットテキストとしてエンコードされるシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(プレトークナイズ済み文字列)であることができます。シーケンスが文字列のリスト(プレトークナイズ済み)として提供される場合、is_split_into_words=Trueを設定する必要があります(シーケンスのバッチとの曖昧さを解消するため)。 - tokenizer_kwargs (
dict[str, Any]、省略可) — トークナイザーに渡す追加の kwargs です。これらは明示的なパラメータおよびその他の kwargs とマージされますが、明示的なパラメータが優先されます。 - add_special_tokens (
bool、省略可、デフォルトはTrue) — シーケンスをエンコードする際に特殊トークンを追加するかどうかを指定します。これは、入力 ID に自動的に追加されるトークンを定義する基盤となるPretrainedTokenizerBase.build_inputs_with_special_tokens関数を使用します。bosやeosトークンを自動的に追加したい場合に便利です。 - padding (
bool,strまたは PaddingStrategy, 省略可, デフォルトはFalse) — パディングの有効化と制御を行います。以下の値を受け入れます:Trueまたは'longest': バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。'max_length': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。Falseまたは'do_not_pad'(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
- truncation (
bool,strまたは TruncationStrategy, 省略可能, デフォルトはFalse) — 切り詰めを有効にし、制御します。以下の値を受け取ります:Trueまたは'longest_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。この場合、トークン単位で切り詰めが行われ、ペアのシーケンス(またはペアのバッチ)が提供されている場合は、ペアの中で最も長いシーケンスから1トークンずつ削除します。'only_first': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れることのできる最大入力長まで切り詰めます。この設定では、ペアのシーケンス(またはペアのバッチ)が提供された場合のみ、ペアの最初のシーケンスだけが切り詰められます。'only_second': 引数max_lengthで指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長まで切り詰めます。このモードでは、シーケンスのペア(またはペアのバッチ)が提供された場合のみ、ペアの2番目のシーケンスが切り詰められます。Falseまたは'do_not_truncate'(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
- max_length (
int, 省略可能) — truncation/padding パラメータのいずれかによって使用される最大長を制御します。未設定のまま、または
Noneに設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。 - stride (
int、省略可能、デフォルトは 0) —max_lengthとともに数値が設定されている場合、return_overflowing_tokens=Trueで返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複を確保します。この引数の値は、重複するトークンの数を定義します。 - is_split_into_words (
bool、任意、デフォルトはFalse) — 入力がすでに事前トークン化済み(例:単語に分割済み)かどうかを指定します。Trueに設定すると、トークナイザーは入力がすでに単語に分割済み(たとえば空白で分割済み)であると仮定し、それをトークン化します。これは NER やトークン分類に有用です。 - pad_to_multiple_of (
int, 任意) — 設定すると、指定された値の倍数にシーケンスをパディングします。paddingが有効になっている必要があります。 これは、計算能力が>= 7.5(Volta) の NVIDIA ハードウェア上で Tensor Cores を使用可能にするために特に有用です。 - padding_side (
str, 省略可) — モデルにパディングを適用する側です。[‘right’, ‘left’] のいずれかを選択してください。 デフォルト値は、同名のクラス属性から取得されます。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': Numpy のnp.ndarrayオブジェクトを返します。
- return_token_type_ids (
bool, 省略可能) — トークンタイプIDを返すかどうか。デフォルトのままにすると、特定のトークナイザーのデフォルトに従ってトークンタイプIDを返します。これはreturn_outputs属性で定義されます。 - return_attention_mask (
bool, 省略可能) — attention mask を返すかどうか。デフォルトのままにすると、return_outputs属性によって定義される、特定の tokenizer のデフォルトに従って attention mask を返します。 - return_overflowing_tokens (
bool、任意、デフォルトはFalse) — 溢れ出したトークンシーケンスを返すかどうかを指定します。入力 ID のシーケンスのペア(またはペアのバッチ)がtruncation_strategy = longest_firstまたはTrueとともに提供された場合、溢れ出したトークンを返す代わりにエラーが発生します。 - return_special_tokens_mask (
bool、省略可能、デフォルトはFalse) — 特殊トークンのマスク情報を返すかどうかを指定します。 - return_offsets_mapping (
bool, 省略可能, デフォルトはFalse) — 各トークンについて(char_start, char_end)を返すかどうか。この機能は、PreTrainedTokenizerFast を継承する高速トークナイザーでのみ利用可能です。Python のトークナイザーを使用している場合、このメソッドは
NotImplementedErrorを送出します。 - return_length (
bool、任意、デフォルトはFalse) — エンコードされた入力の長さを返すかどうかを指定します。 - verbose (
bool、任意、デフォルトはTrue) — より多くの情報や警告を表示するかどうかを指定します。 - **kwargs —
self.tokenize()メソッドに渡されます
戻り値
以下のフィールドを持つBatchEncoding:
-
input_ids — モデルに与えるトークン ID のリスト。
-
token_type_ids — モデルに渡すトークンタイプIDのリスト(
return_token_type_ids=Trueの場合、またはself.model_input_namesに“token_type_ids”が含まれている場合)。 -
attention_mask — モデルがどのトークンに注意を向けるべきかを指定するインデックスのリスト(
return_attention_mask=Trueの場合、またはself.model_input_namesに “attention_mask” が含まれている場合)。 -
overflowing_tokens — 溢れ出したトークンシーケンスのリスト(
max_lengthが指定され、return_overflowing_tokens=Trueの場合)。 -
num_truncated_tokens — トークンが切り詰められた数(
max_lengthが指定され、return_overflowing_tokens=Trueの場合)。 -
special_tokens_mask — 0 と 1 のリスト。1 は追加された特殊トークンを、0 は通常のシーケンストークンを示します(
add_special_tokens=Trueかつreturn_special_tokens_mask=Trueの場合)。 -
length — 入力データの長さ(
return_length=Trueの場合)
1 つ以上のシーケンス、または 1 つ以上のシーケンスのペアをトークナイズし、モデル用に準備するためのメインメソッドです。
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
語彙ファイルと特殊トークンファイルを実行ディレクトリに保存します。
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
パラメータ
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — トークン化された入力 ID のリスト。__call__メソッドを使用して取得できます。 - skip_special_tokens (
bool、省略可、デフォルトはFalse) — デコーディング時に特殊トークンを除去するかどうかを指定します。 - clean_up_tokenization_spaces (
bool、任意) — トークン化のスペースを整理するかどうか。Noneの場合、self.clean_up_tokenization_spacesがデフォルトとして使用されます。 - kwargs (追加のキーワード引数、任意) — 基盤となるモデル固有のデコードメソッドに渡されます。
戻り値
list[str]
デコードされた文のリスト。
decode を呼び出して、トークン ID のリストのリストを文字列のリストに変換します。
このメソッドは後方互換性のために提供されています。decodeメソッドは現在、バッチ入力をネイティブで処理するため、batch_decodeの代わりにdecodeを直接使用できます。
FastSpeech2ConformerModel
クラス transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
パラメータ
- config (FastSpeech2ConformerConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
FastSpeech2Conformer モデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.FloatTensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.FloatTensor] = Noneenergy_labels: typing.Optional[torch.FloatTensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.FloatTensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensor、形状(batch_size, sequence_length)) — テキストベクトルの入力シーケンス。 - attention_mask (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- spectrogram_labels (
torch.FloatTensor、shape(batch_size, max_spectrogram_length, num_mel_bins)、任意、デフォルトはNone) — パディング済みのターゲット特徴のバッチ。 - duration_labels (
torch.LongTensor、shape(batch_size, sequence_length + 1)、任意、デフォルトはNone) — パディング済みの duration のバッチ。 - pitch_labels (
torch.FloatTensor、shape(batch_size, sequence_length + 1, 1)、任意、デフォルトはNone) — パディング済みのトークン平均ピッチのバッチ。 - energy_labels (
torch.FloatTensor、shape(batch_size, sequence_length + 1, 1)、任意、デフォルトはNone) — パディング済みのトークン平均エネルギーのバッチ。 - speaker_ids (
torch.LongTensor、shape(batch_size, 1)、任意、デフォルトはNone) — モデルが音声出力の特徴を条件付けするために使用する話者 ID。 - lang_ids (
torch.LongTensor、shape(batch_size, 1)、任意、デフォルトはNone) — モデルによって音声出力の特徴を条件付けするために使用される言語 ID。 - speaker_embedding (
torch.FloatTensor、shape(batch_size, embedding_dim)、任意、デフォルトはNone) — 音声の特徴に対する条件付けシグナルを含む埋め込み。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。
戻り値
FastSpeech2ConformerModelOutput または tuple(torch.FloatTensor)
FastSpeech2ConformerModelOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(FastSpeech2ConformerConfig)や入力に応じて、さまざまな要素で構成されます。
FastSpeech2ConformerModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — スペクトログラム生成の損失。spectrogram (
torch.FloatTensor、shape(batch_size, sequence_length, num_bins)、optional) — 予測されたスペクトログラム。encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのエンコーダーの最終層の出力における、隠れ状態のシーケンス。encoder_hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力におけるエンコーダーの隠れ状態。
encoder_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmaxを適用した後のエンコーダーのアテンション重み。自己アテンションヘッドにおける加重平均の計算に使用されます。
decoder_hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力における、デコーダーの隠れ状態。
decoder_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
duration_outputs(
torch.LongTensor、shape(batch_size, max_text_length + 1)、optional)— duration predictor の出力。pitch_outputs (
torch.FloatTensor、shape(batch_size, max_text_length + 1, 1)、optional) — ピッチ予測器の出力。energy_outputs(
torch.FloatTensor、形状(batch_size, max_text_length + 1, 1)、任意)— エネルギー予測器の出力。
例:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
クラス transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
パラメータ
- config (FastSpeech2ConformerHifiGanConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
HiFi-GANボコーダー。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( spectrogram: FloatTensor**kwargs ) → torch.FloatTensor
パラメータ
- spectrogram (
torch.FloatTensor) — log-mel スペクトログラムを含むテンソル。バッチ化された形状(batch_size, sequence_length, config.model_in_dim)、またはバッチ化されていない形状(sequence_length, config.model_in_dim)をとります。
戻り値
torch.FloatTensor
音声波形を含むテンソル。入力スペクトログラムがバッチ化されている場合、形状は(batch_size, num_frames,)になります。バッチ化されていない場合、形状は(num_frames,)になります。
log-melスペクトログラムを音声波形に変換します。log-melスペクトログラムのバッチを渡すと、音声波形のバッチが返されます。単一のバッチ化されていないlog-melスペクトログラムを渡すと、単一のバッチ化されていない音声波形が返されます。
FastSpeech2ConformerWithHifiGan
クラス transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
パラメータ
- config (FastSpeech2ConformerWithHifiGanConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
FastSpeech2ConformerHifiGan vocoderヘッドを備えたFastSpeech2ConformerModelは、テキストから音声(波形)への変換を実行します。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.FloatTensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.FloatTensor] = Noneenergy_labels: typing.Optional[torch.FloatTensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.FloatTensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.FloatTensor)
パラメータ
- input_ids (
torch.LongTensor、形状(batch_size, sequence_length)) — テキストベクトルの入力シーケンス。 - attention_mask (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- spectrogram_labels (
torch.FloatTensor、shape(batch_size, max_spectrogram_length, num_mel_bins)、任意、デフォルトはNone) — パディング済みのターゲット特徴のバッチ。 - duration_labels (
torch.LongTensor、shape(batch_size, sequence_length + 1)、任意、デフォルトはNone) — パディング済みの duration のバッチ。 - pitch_labels (
torch.FloatTensor、shape(batch_size, sequence_length + 1, 1)、任意、デフォルトはNone) — パディング済みのトークン平均ピッチのバッチ。 - energy_labels (
torch.FloatTensor、shape(batch_size, sequence_length + 1, 1)、任意、デフォルトはNone) — パディング済みのトークン平均エネルギーのバッチ。 - speaker_ids (
torch.LongTensor、shape(batch_size, 1)、任意、デフォルトはNone) — モデルが音声出力の特徴を条件付けするために使用する話者 ID。 - lang_ids (
torch.LongTensor、shape(batch_size, 1)、任意、デフォルトはNone) — モデルによって音声出力の特徴を条件付けするために使用される言語 ID。 - speaker_embedding (
torch.FloatTensor、shape(batch_size, embedding_dim)、任意、デフォルトはNone) — 音声の特徴に対する条件付けシグナルを含む埋め込み。 - return_dict (
bool, 任意) — プレーンなタプルではなく ModelOutput を返すかどうか。 - output_attentions (
bool, 省略可) — すべてのアテンション層のアテンションテンソルを返すかどうかを指定します。詳細は、返されるテンソルのattentionsを参照してください。 - output_hidden_states (
bool, 省略可) — すべての層の hidden states を返すかどうかを指定します。詳細は、返されるテンソルのhidden_statesを参照してください。
戻り値
FastSpeech2ConformerModelOutput または tuple(torch.FloatTensor)
FastSpeech2ConformerModelOutput、またはtorch.FloatTensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(FastSpeech2ConformerConfig)や入力に応じて、さまざまな要素で構成されます。
FastSpeech2ConformerWithHifiGanのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
loss (
torch.FloatTensor、shape(1,)、optional、labelsが指定された場合に返されます) — スペクトログラム生成の損失。spectrogram (
torch.FloatTensor、shape(batch_size, sequence_length, num_bins)、optional) — 予測されたスペクトログラム。encoder_last_hidden_state (
torch.FloatTensor、shape(batch_size, sequence_length, hidden_size)、optional) — モデルのエンコーダーの最終層の出力における、隠れ状態のシーケンス。encoder_hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力におけるエンコーダーの隠れ状態。
encoder_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmaxを適用した後のエンコーダーのアテンション重み。自己アテンションヘッドにおける加重平均の計算に使用されます。
decoder_hidden_states (
tuple[torch.FloatTensor]、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます)—torch.FloatTensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力および初期埋め込み出力における、デコーダーの隠れ状態。
decoder_attentions (
tuple[torch.FloatTensor]、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます)—torch.FloatTensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。自己アテンションヘッドにおける加重平均を計算するために使用される、アテンションのsoftmax後のデコーダーのアテンション重み。
duration_outputs(
torch.LongTensor、shape(batch_size, max_text_length + 1)、optional)— duration predictor の出力。pitch_outputs (
torch.FloatTensor、shape(batch_size, max_text_length + 1, 1)、optional) — ピッチ予測器の出力。energy_outputs(
torch.FloatTensor、形状(batch_size, max_text_length + 1, 1)、任意)— エネルギー予測器の出力。
例:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])