
Transformers documentation
Início rápido
Início rápido
O Transformers foi projetado para ser rápido e fácil de usar, permitindo que todos comecem a aprender ou a construir com modelos de transformer.
O número de abstrações voltadas ao usuário é limitado a apenas três classes para instanciar um modelo e duas APIs para inferência ou treinamento. Esta introdução rápida apresenta os recursos principais do Transformers e mostra como:
- carregar um modelo pré-treinado
- executar inferência com Pipeline
- fazer o fine-tuning de um modelo com Trainer
Configuração
Para começar, recomendamos criar uma conta no Hugging Face. Uma conta permite hospedar e acessar modelos, conjuntos de dados e Spaces com controle de versão no Hub do Hugging Face, uma plataforma colaborativa para descoberta e construção.
Crie um User Access Token e faça login na sua conta.
Cole seu User Access Token em notebook_login quando solicitado para fazer login.
from huggingface_hub import notebook_login

notebook_login()
Verifique se o pacote huggingface_hub[cli] está instalado e execute o comando abaixo. Cole seu User Access Token quando solicitado para fazer login.
hf auth login
Instale o PyTorch.
# remove ! if installing from the CLI
!pip install torch
Em seguida, instale uma versão atualizada do Transformers e algumas bibliotecas adicionais do ecossistema Hugging Face para acessar conjuntos de dados e modelos de visão, avaliar o treinamento e otimizar o treinamento para modelos grandes.
# remove ! if installing from the CLI
!pip install -U transformers datasets evaluate accelerate timm
Habilidades do agente
Hugging Face Skills ensinam seu agente de código a trabalhar com Transformers. Em vez de escrever um script de treinamento por conta própria, peça ao seu agente para fazer o fine-tuning de um modelo de visão e deixe que a skill o guie.
/plugin marketplace add huggingface/skills
/plugin install hf-cli@huggingface/skills
codex plugin marketplace add huggingface/skills
Em seguida, execute /plugins no Codex e instale uma skill do repositório huggingface/skills.
Consulte o guia de Instalação para mais plataformas suportadas, como Cursor e Gemini.
Depois que uma habilidade for instalada, inclua-a nas instruções para o seu agente de codificação.
Use the HF Trainer skill to fine-tune RT-DETRv2 on [Lekim89/sportsmot](https://huggingface.co/datasets/Lekim89/sportsmot) for basketball player tracking.Modelos pré-treinados
Cada modelo pré-treinado herda de três classes base.
| Classe | Descrição |
|---|---|
| PreTrainedConfig | Um arquivo que especifica os atributos de um modelo, como o número de cabeças de atenção ou o tamanho do vocabulário. |
| PreTrainedModel | Um modelo (ou arquitetura) definido pelos atributos do modelo no arquivo de configuração. Um modelo pré-treinado retorna apenas os estados ocultos brutos. Para uma tarefa específica, use a cabeça de modelo apropriada para converter os estados ocultos brutos em um resultado significativo (por exemplo, LlamaModel versus LlamaForCausalLM). |
| Pré-processador | Uma classe para converter entradas brutas (texto, imagens, áudio, multimodal) em entradas numéricas para o modelo. Por exemplo, PreTrainedTokenizer converte texto em tensores e ImageProcessingMixin converte pixels em tensores. |
Recomendamos usar a API AutoClass para carregar modelos e preprocessors, pois ela infere automaticamente a arquitetura adequada para cada tarefa e framework de machine learning com base no nome ou no caminho para os pesos pré-treinados e o arquivo de configuração.
Use from_pretrained() para carregar os pesos e o arquivo de configuração do Hub para a classe de modelo e pré-processador.
Ao carregar um modelo, configure os seguintes parâmetros para garantir que o modelo seja carregado de forma otimizada.
device_map="auto"aloca automaticamente os pesos do modelo primeiro no seu dispositivo mais rápido.dtype="auto"inicializa diretamente os pesos do modelo no tipo de dados em que são armazenados, o que pode ajudar a evitar o carregamento dos pesos duas vezes (o PyTorch carrega os pesos emtorch.float32por padrão).
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf", dtype="auto", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
Tokenize o texto e retorne tensores do PyTorch com o tokenizer. Mova as entradas tokenizadas para o mesmo dispositivo do modelo antes de executar a inferência para que o modelo possa processá-las.
model_inputs = tokenizer(["The secret to baking a good cake is "], return_tensors="pt").to(model.device)O modelo agora está pronto para inferência ou treinamento.
Para inferência, passe as entradas tokenizadas para generate() para gerar texto. Decodifique os ids de tokens de volta para texto com batch_decode().
generated_ids = model.generate(**model_inputs, max_length=30)
tokenizer.batch_decode(generated_ids)[0]
'<s> The secret to baking a good cake is 100% in the preparation. There are so many recipes out there,'
Pule para a seção Trainer para aprender como fazer o ajuste fino de um modelo.
Pipeline
A classe Pipeline é a maneira mais conveniente de executar inferência com um modelo pré-treinado. Ela suporta muitas tarefas, como geração de texto, segmentação de imagem, reconhecimento automático de fala, resposta a perguntas em documentos e muito mais.
Consulte a referência da API Pipeline para obter a lista completa de tarefas disponíveis.
Crie um objeto Pipeline e selecione uma tarefa. Por padrão, o Pipeline baixa e faz o cache de um modelo pré-treinado padrão para uma tarefa específica. Passe o nome do modelo para o parâmetro model para escolher um modelo específico.
Use Accelerator para detectar automaticamente um acelerador disponível para inferência.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipe = pipeline("text-generation", model="meta-llama/Llama-2-7b-hf", device=device)
Prompt Pipeline com algum texto inicial para gerar mais texto.
pipe("The secret to baking a good cake is ", max_length=50)
[{'generated_text': 'The secret to baking a good cake is 100% in the batter. The secret to a great cake is the icing.\nThis is why we’ve created the best buttercream frosting reci'}]
Use Accelerator para detectar automaticamente um acelerador disponível para inferência.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("image-segmentation", model="facebook/detr-resnet-50-panoptic", device=device)
Passe uma imagem — uma URL ou um caminho local para a imagem — para Pipeline.
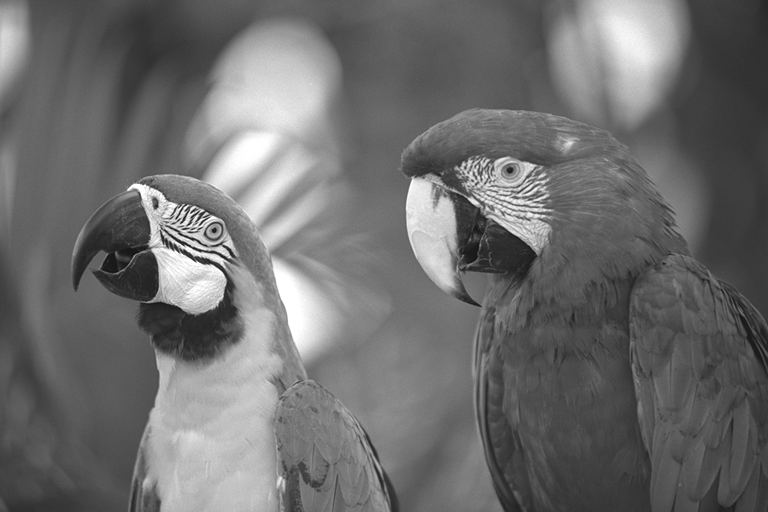
segments = pipeline("https://huggingface.co/datasets/Narsil/image_dummy/raw/main/parrots.png")
segments[0]["label"]
'bird'
segments[1]["label"]
'bird'
Use Accelerator para detectar automaticamente um acelerador disponível para inferência.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("automatic-speech-recognition", model="openai/whisper-large-v3", device=device)
Passe um arquivo de áudio para Pipeline.
pipeline("https://huggingface.co/datasets/Narsil/asr_dummy/resolve/main/1.flac")
{'text': ' He hoped there would be stew for dinner, turnips and carrots and bruised potatoes and fat mutton pieces to be ladled out in thick, peppered flour-fatten sauce.'}
Trainer
Trainer é um loop completo de treinamento e avaliação para modelos PyTorch. Ele abstrai grande parte do código repetitivo normalmente envolvido na escrita manual de um loop de treinamento, permitindo que você comece a treinar mais rápido e se concentre nas escolhas de design do treinamento. Você só precisa de um modelo, um conjunto de dados, um pré-processador e um data collator para construir lotes de dados a partir do conjunto de dados.
Use a classe TrainingArguments para personalizar o processo de treinamento. Ela oferece muitas opções para treinamento, avaliação e mais. Experimente hiperparâmetros e recursos de treinamento, como tamanho do lote, taxa de aprendizado, precisão mista, torch.compile e outros, para atender às suas necessidades de treinamento. Você também pode usar os parâmetros de treinamento padrão para gerar rapidamente uma linha de base.
Carregue um modelo, um tokenizador e um conjunto de dados para o treinamento.
from transformers import AutoModelForSequenceClassification, AutoTokenizer
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained("distilbert/distilbert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased")
dataset = load_dataset("cornell-movie-review-data/rotten_tomatoes")
Crie uma função para tokenizar o texto e convertê-lo em tensores do PyTorch. Aplique essa função a todo o conjunto de dados com o método map.
def tokenize_dataset(dataset):
    return tokenizer(dataset["text"])
dataset = dataset.map(tokenize_dataset, batched=True)
Carregue um data collator para criar lotes de dados e passe o tokenizer para ele.
from transformers import DataCollatorWithPadding

data_collator = DataCollatorWithPadding(tokenizer=tokenizer)
Em seguida, configure o TrainingArguments com os recursos de treinamento e os hiperparâmetros.
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="distilbert-rotten-tomatoes",
    learning_rate=2e-5,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=2,
    push_to_hub=True,
)
Por fim, passe todos esses componentes separados para Trainer e chame train() para iniciar.
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["test"],
    processing_class=tokenizer,
    data_collator=data_collator,
)

trainer.train()
Compartilhe seu modelo e tokenizer no Hub com push_to_hub().
trainer.push_to_hub()
Parabéns, você acabou de treinar seu primeiro modelo com Transformers!
Próximas etapas
Agora que você tem uma melhor compreensão do Transformers e do que ele oferece, é hora de continuar explorando e aprendendo sobre o que mais te interessa.
- Classes base: Saiba mais sobre as classes de configuração, modelo e processador. Isso ajudará você a entender como criar e personalizar modelos, pré-processar diferentes tipos de entradas (áudio, imagens, multimodal) e como compartilhar seu modelo.
- Inferência: Explore o Pipeline a fundo, inferência e conversas com LLMs, agentes e como otimizar a inferência com seu framework de machine learning e hardware.
- Treinamento: Estude o Trainer em mais detalhes, bem como o treinamento distribuído e a otimização do treinamento em hardware específico.
- Quantização: Reduza os requisitos de memória e armazenamento por meio da quantização e acelere a inferência representando os pesos com menos bits.
- Recursos: Procurando receitas de ponta a ponta sobre como treinar e fazer inferência com um modelo para uma tarefa específica? Confira as receitas de tarefas!