
Model and data for ReflectiVA: Augmenting Multimodal LLMs with Self-Reflective Tokens for Knowledge-based Visual Question Answering [CVPR 2025]

Federico Cocchi
fede97
AI & ML interests
Multimodal LLM - Computer Vision
Recent Activity
new activity about 24 hours ago
aimagelab/RAID:Add PGD / APGD / CWA adversarial splits (eps 8/16/32) new activity about 24 hours ago
aimagelab/RAID_ckpt:Add Effort, AIDE, D3, OmniAID, DDA checkpoints updated a model 9 months ago
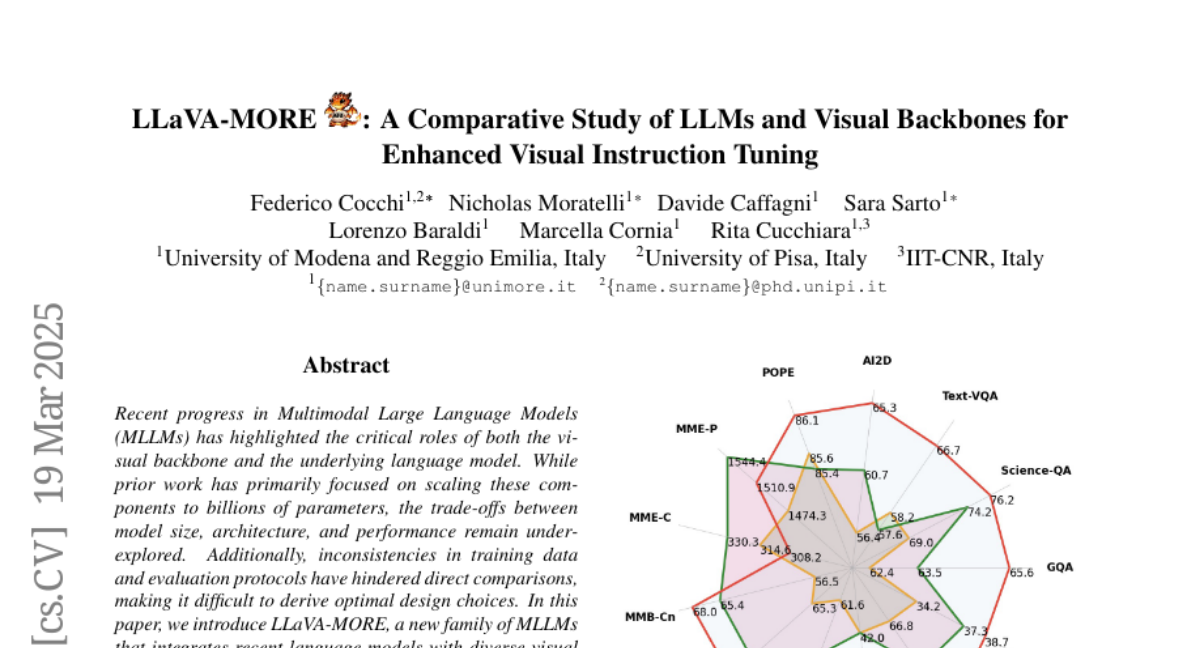
aimagelab/LLaVA_MORE-gemma_2_2b-finetuningOrganizations