
Diffusers documentation
SDXL Turbo
SDXL Turbo
Stable Diffusion XL (SDXL) Turbo は、Axel Sauer、Dominik Lorenz、Andreas Blattmann、Robin Rombach による Adversarial Diffusion Distillation で提案されました。
論文の抄録は以下の通りです:
Adversarial Diffusion Distillation (ADD) を紹介します。これは、大規模な基盤となる画像拡散モデルをわずか 1〜4 ステップで効率的にサンプリングしつつ、高い画像品質を維持する、新しい学習手法です。スコア蒸留を用いて、大規模な市販の画像拡散モデルを教師シグナルとして活用するとともに、敵対的損失を組み合わせることで、1 ステップまたは 2 ステップという低ステップ領域においても高い画像忠実性を確保します。分析の結果、当社のモデルは、1 ステップにおいて既存の少ステップ手法(GAN、Latent Consistency Models)を明確に上回り、わずか 4 ステップで最先端の拡散モデル(SDXL)の性能に達することが示されました。ADD は、基盤モデルによる 1 ステップ、リアルタイムの画像合成を実現した最初の手法です。
ヒント
- SDXL Turbo は SDXL と完全に同じアーキテクチャを使用しているため、API も同じです。詳細については、SDXL の API リファレンスを参照してください。
- SDXL Turbo は、
guidance_scale=0.0を設定して guidance scale を無効にする必要があります。 - SDXL Turbo は、スケジューラに
timestep_spacing='trailing'を使用し、ステップ数は 1 から 4 の範囲で設定してください。 - SDXL Turbo は、512x512 サイズの画像を生成するように学習されています。
- SDXL Turbo はオープンアクセスですが、オープンソースではありません。そのため、商用アプリケーションでの利用にはモデルライセンスの購入が必要になる場合があります。詳細については、公式モデルカードをお読みください。
公式のベースモデルとリファイナーモデルのチェックポイントについては、Stability AIのHub組織をご覧ください!
以下のライブラリがインストールされていることを確認してください。
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
モデルのチェックポイントを読み込む
モデルの重みが Hub またはローカル上で個別のサブフォルダに保存されている場合、from_pretrained() メソッドを使用する必要があります。
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
from_single_file() メソッドを使用して、単一ファイル形式(.ckpt または .safetensors)で保存されたモデルチェックポイントを、Hub からまたはローカルから読み込むこともできます。この読み込み方法では、timestep_spacing="trailing" を設定する必要があります(より良い結果を得るために、他のスケジューラー設定値の実験も自由に試してください):
from diffusers import StableDiffusionXLPipeline, EulerAncestralDiscreteScheduler
import torch

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/sdxl-turbo/blob/main/sd_xl_turbo_1.0_fp16.safetensors",
    dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
pipeline.scheduler = EulerAncestralDiscreteScheduler.from_config(pipeline.scheduler.config, timestep_spacing="trailing")
テキストから画像へ
テキストから画像を生成する場合、テキストプロンプトを渡します。デフォルトでは、SDXL Turbo は 512x512 の画像を生成し、この解像度が最も良い結果をもたらします。height と width パラメータを 768x768 または 1024x1024 に設定することもできますが、そうすると品質が低下する可能性があります。
モデルはguidanceなしで学習されているため、無効にするにはguidance_scaleを0.0に設定してください。1回の推論ステップで高品質な画像を生成できます。
ステップ数を2、3、4に増加させると、画像の品質が向上するはずです。
from diffusers import AutoPipelineForText2Image
import torch

pipeline_text2image = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline_text2image = pipeline_text2image.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "A cinematic shot of a baby racoon wearing an intricate italian priest robe."

image = pipeline_text2image(prompt=prompt, guidance_scale=0.0, num_inference_steps=1).images[0]
image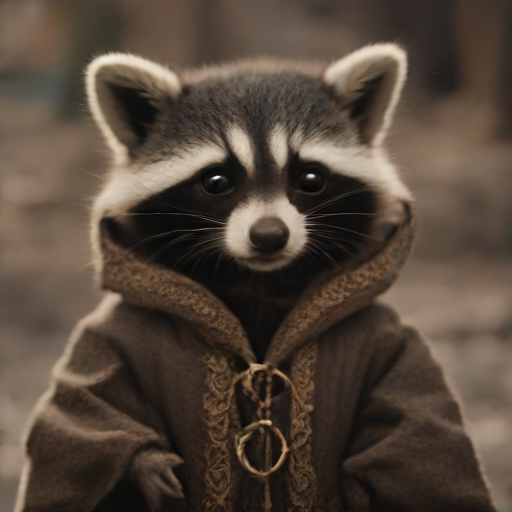
画像から画像へ
画像から画像への生成を行う場合、num_inference_steps * strength が 1 以上であることを確認してください。
画像から画像へのパイプラインは int(num_inference_steps * strength) ステップで実行されます。例えば、以下の例では 0.5 * 2.0 = 1 ステップです。
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image, make_image_grid

# use from_pipe to avoid consuming additional memory when loading a checkpoint
pipeline_image2image = AutoPipelineForImage2Image.from_pipe(pipeline_text2image).to("cuda")  # or "mps", "xpu", "cpu"

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/cat.png")
init_image = init_image.resize((512, 512))

prompt = "cat wizard, gandalf, lord of the rings, detailed, fantasy, cute, adorable, Pixar, Disney, 8k"

image = pipeline_image2image(prompt, image=init_image, strength=0.5, guidance_scale=0.0, num_inference_steps=2).images[0]
make_image_grid([init_image, image], rows=1, cols=2)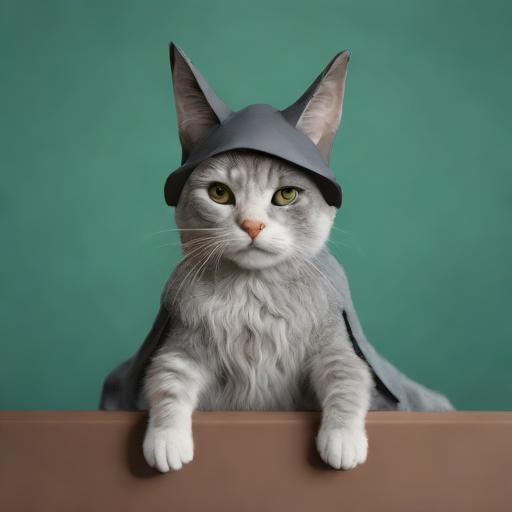
SDXL Turboをさらに高速化
- PyTorch バージョン 2.0 以上を使用している場合は、UNet をコンパイルしてください。最初の推論実行は非常に遅くなりますが、その後の実行は大幅に高速化されます。
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)- デフォルトのVAEを使用する場合は、各生成の前後でコストのかかる
dtype変換を避けるために、float32のままにしてください。これは最初の生成の前に一度だけ行えば十分です。
pipe.upcast_vae()
代替案として、コミュニティメンバー @madebyollin が作成した 16ビット VAE を使用することもできます。これは float32 へのアップキャストを必要としません。