
Diffusers documentation
FreeU
FreeU
FreeU는 UNet 디코더가 백본 특징과 스킵 연결 특징을 각각 얼마나 활용하는지를 재조정하여 이미지 디테일을 개선합니다. 스킵 연결은 백본의 의미론적 특징을 가려버릴 수 있으며, 이로 인해 출력에 부자연스러운 디테일이 발생할 수 있습니다. FreeU는 학습이 필요하지 않으며, 텍스트-이미지 및 텍스트-비디오 파이프라인에서 추론 시점에 활성화하거나 비활성화할 수 있습니다.
FreeU는 Stable Diffusion, SDXL, AnimateDiff와 같은 UNet 기반 파이프라인에서만 작동합니다. Flux나 Qwen-Image와 같은 transformer 기반 파이프라인에서는 지원되지 않습니다.
파이프라인에서 enable_freeu() 메서드를 사용하고 스케일링 계수를 설정합니다. b1과 b2는 백본 특징을 증폭하고, s1과 s2는 스킵 특징을 감쇠시킵니다. 1과 2는 UNet 디코더의 첫 번째와 두 번째 업샘플링 단계를 나타냅니다. 다양한 모델에 대한 참조 하이퍼파라미터는 FreeU 저장소를 참고하세요.
모델의 저장소 값으로 시작합니다. 다른 모델에 맞게 조정하려면 s1=0.9과 s2=0.2를 유지하고 b1과 b2를 먼저 조정합니다. 네 가지 요인 모두를 1.0으로 설정하는 것은 FreeU를 비활성화하는 것과 동일합니다. b 값이 클수록 효과가 강화되지만 세부 텍스처가 과도하게 흐려질 수 있으며, s1과 s2를 낮추면 이를 상쇄할 수 있습니다.
import torch
from diffusers import DiffusionPipeline

pipeline = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.enable_freeu(s1=0.9, s2=0.2, b1=1.3, b2=1.4)
generator = torch.Generator(device="cpu").manual_seed(13)
prompt = "A squirrel eating a burger"
image = pipeline(prompt, generator=generator).images[0]
image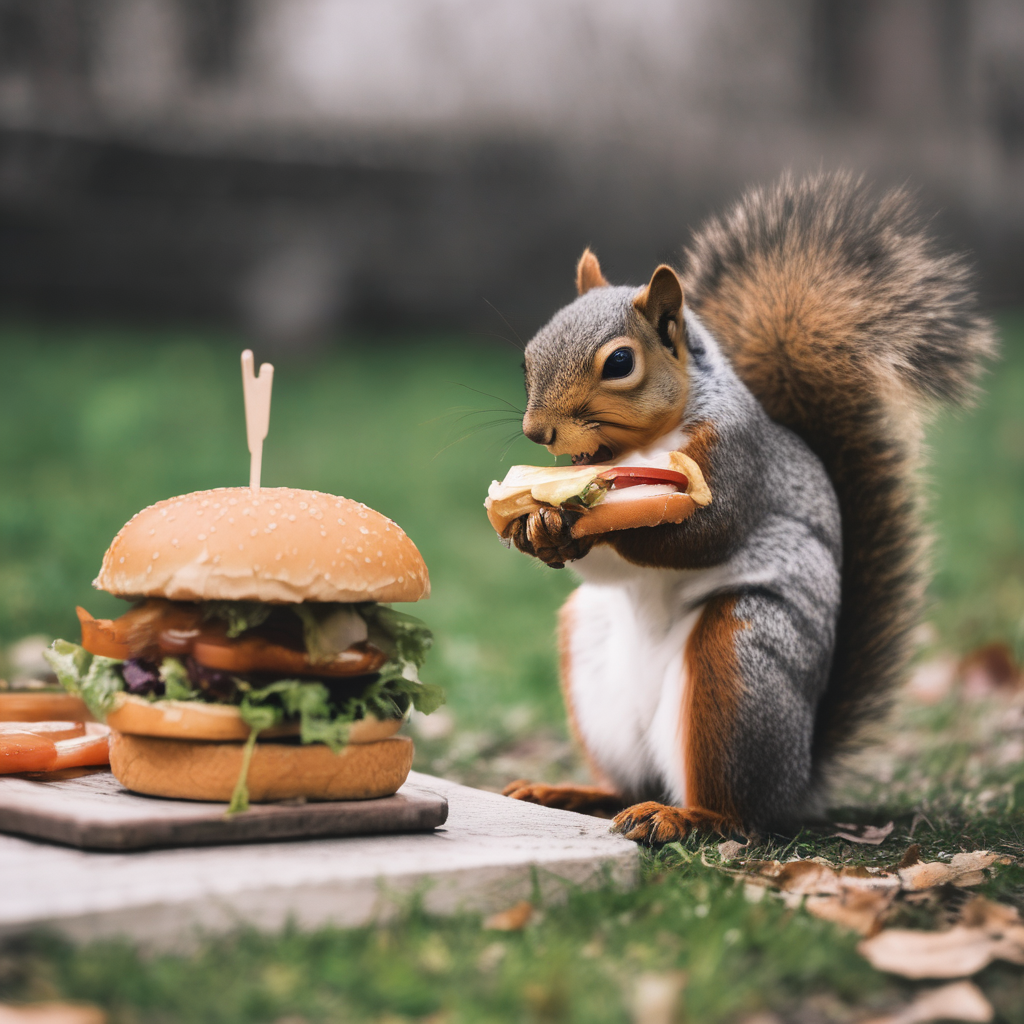

FreeU를 비활성화하려면 disable_freeu() 메서드를 호출합니다.
pipeline.disable_freeu()
다음 단계
- 전체 매개변수 설명은 enable_freeu() API 참조를 확인하세요.
- AnimateDiff로 비디오에서 FreeU를 사용해 보세요.