
Diffusers documentation
Latent Tutarlılık Modelleri
Latent Tutarlılık Modelleri

Latent Consistency Models (LCM), Simian Luo, Yiqin Tan, Longbo Huang, Jian Li ve Hang Zhao tarafından Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference makalesinde önerilmiştir.
Makalenin özeti aşağıdaki gibidir:
Latent Diffusion modelleri (LDM'ler), yüksek çözünürlüklü görüntü sentezinde olağanüstü sonuçlar elde etmiştir. Ancak, yinelemeli örneklem süreci hesaplama açısından yoğun olup yavaş üretime yol açar. Consistency Models (song et al.)'den ilham alarak, Latent Consistency Models (LCM'ler) öneriyoruz; bu modeller, Stable Diffusion (rombach et al) dahil olmak üzere herhangi bir önceden eğitilmiş LDM üzerinde az sayıda adımla hızlı çıkarım yapmayı mümkün kılar. Kılavuzlu ters yönlü difüzyon sürecini, artırılmış bir olasılık akış ODE'sini (PF-ODE) çözmek olarak ele alarak, LCM'ler bu ODE'nin çözümünü latent uzayda doğrudan tahmin edecek şekilde tasarlanmıştır; bu sayede çok sayıda yinelemeye duyulan ihtiyaç azaltılır ve hızlı, yüksek sadakatli örneklem sağlanır. Önceden eğitilmiş sınıflandırıcı-özgür kılavuzlu difüzyon modellerinden verimli bir şekilde damıtılarak elde edilen, yüksek kaliteli 768 x 768 2~4 adımlık bir LCM, eğitim için yalnızca 32 A100 GPU saati gerektirir. Ayrıca, LCM'lerin özel görüntü veri kümeleri üzerinde ince ayarlanmasına yönelik tasarlanmış yeni bir yöntem olan Latent Consistency Fine-tuning (LCF)'i tanıtıyoruz. LAION-5B-Aesthetics veri kümesi üzerindeki değerlendirme, LCM'lerin az adımlı çıkarımla metinden görüntüye üretimde en iyi performansı (state-of-the-art) elde ettiğini göstermektedir. Proje Sayfası: this https URL.
SimianLuo/LCM_Dreamshaper_v7 kontrol noktası için bir demo burada bulunabilir.
Hatlara luosiallen, nagolinc ve dg845 tarafından katkıda bulunulmuştur.
LCM ve LCM-LoRA'lar Stable Diffusion v1.5, Stable Diffusion XL ve SSD-1B modeli için kullanılabilir. Kontrol noktalarını Latent Consistency Koleksiyonlarında bulabilirsiniz.
Metinden görüntüye
LCM'leri kullanmak için, desteklenen modelinizin LCM kontrol noktasını UNet2DConditionModel içine yüklemeniz ve zamanlayıcıyı LCMScheduler ile değiştirmeniz gerekir. Ardından, boru hattını (pipeline) normal şekilde kullanabilir ve yalnızca 4 adımda bir görüntü üretmek için bir metin istemci (prompt) iletebilirsiniz.
LCM'leri kullanırken aklınızda tutmanız gereken birkaç not:
- Genellikle, sınıflandırıcı-ücretsiz yönlendirme (classifier-free guidance) için parti boyutu (batch size) boru hattı içinde ikiye katlanır. Ancak LCM, yönlendirme gömme (guidance embeddings) ile yönlendirme uygular ve parti boyutunu ikiye katlamaya gerek duymaz; bu da daha hızlı çıkarım (inference) sağlar. Dezavantajı ise, negatif istemlerin (negative prompts) LCM ile çalışmamasıdır, çünkü bunların gürültüden arındırma (denoising) süreci üzerinde hiçbir etkisi yoktur.
guidance_scaleiçin ideal aralık [3., 13.]'tür çünkü UNet bu aralıkla eğitilmiştir. Ancak çoğu durumdaguidance_scale'i 1.0 değeriyle devre dışı bırakmak da etkilidir.
from diffusers import StableDiffusionXLPipeline, UNet2DConditionModel, LCMScheduler
import torch

unet = UNet2DConditionModel.from_pretrained(
    "latent-consistency/lcm-sdxl",
    dtype=torch.float16,
    variant="fp16",
)
pipe = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", unet=unet, dtype=torch.float16, variant="fp16",
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

prompt = "Self-portrait oil painting, a beautiful cyborg with golden hair, 8k"
generator = torch.manual_seed(0)
image = pipe(
    prompt=prompt, num_inference_steps=4, generator=generator, guidance_scale=8.0
).images[0]
image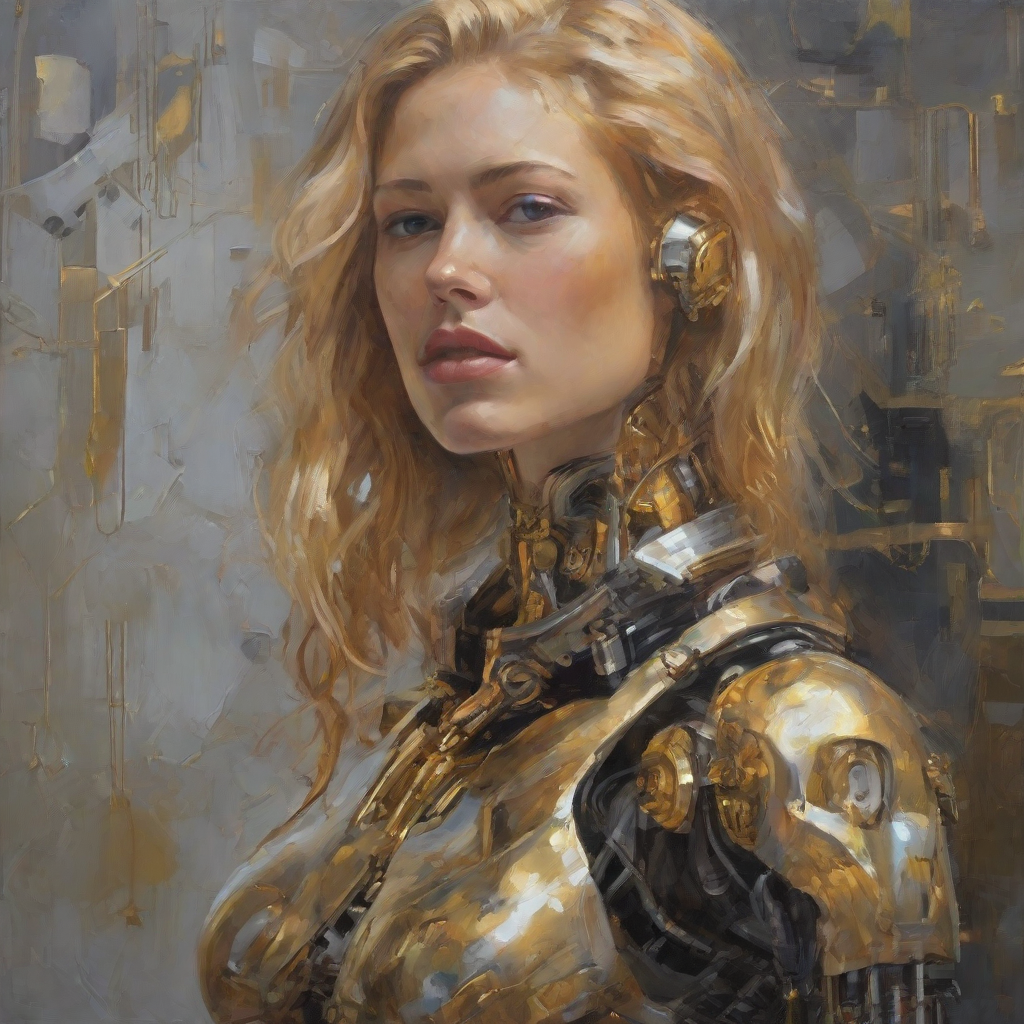
LCM-LoRAları kullanmak için zamanlayıcıyı LCMScheduler ile değiştirmeniz ve LCM-LoRA ağırlıklarını load_lora_weights() yöntemiyle yüklemeniz gerekir. Ardından hattı (pipeline) normal şekilde kullanabilir ve yalnızca 4 adımda bir görüntü üretmek için bir metin istemci (prompt) iletebilirsiniz.
LCM-LoRAları kullanırken aklınızda tutmanız gereken birkaç not:
- Genellikle, sınıflandırıcı-ücretsiz yönlendirme (classifier-free guidance) için parti boyutu (batch size) boru hattı içinde ikiye katlanır. Ancak LCM, yönlendirme gömme (guidance embeddings) ile yönlendirme uygular ve parti boyutunu ikiye katlamaya gerek duymaz; bu da daha hızlı çıkarım (inference) sağlar. Dezavantajı ise, negatif istemlerin (negative prompts) LCM ile çalışmamasıdır, çünkü bunların gürültüden arındırma (denoising) süreci üzerinde hiçbir etkisi yoktur.
- LCM-LoRAlarla rehberlik kullanabilirsiniz, ancak yüksek
guidance_scaledeğerlerine karşı çok hassastır ve üretilen görüntüde artefaktlara yol açabilir. Bulduğumuz en iyi değerler [1.0, 2.0] aralığındadır. - stabilityai/stable-diffusion-xl-base-1.0 yerine herhangi bir ince ayarlanmış model kullanın. Örneğin, SDXL ile anime görselleri oluşturmak için animagine-xl kontrol noktasını deneyin.
import torch
from diffusers import DiffusionPipeline, LCMScheduler

pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    variant="fp16",
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)
pipe.load_lora_weights("latent-consistency/lcm-lora-sdxl")

prompt = "Self-portrait oil painting, a beautiful cyborg with golden hair, 8k"
generator = torch.manual_seed(42)
image = pipe(
    prompt=prompt, num_inference_steps=4, generator=generator, guidance_scale=1.0
).images[0]
image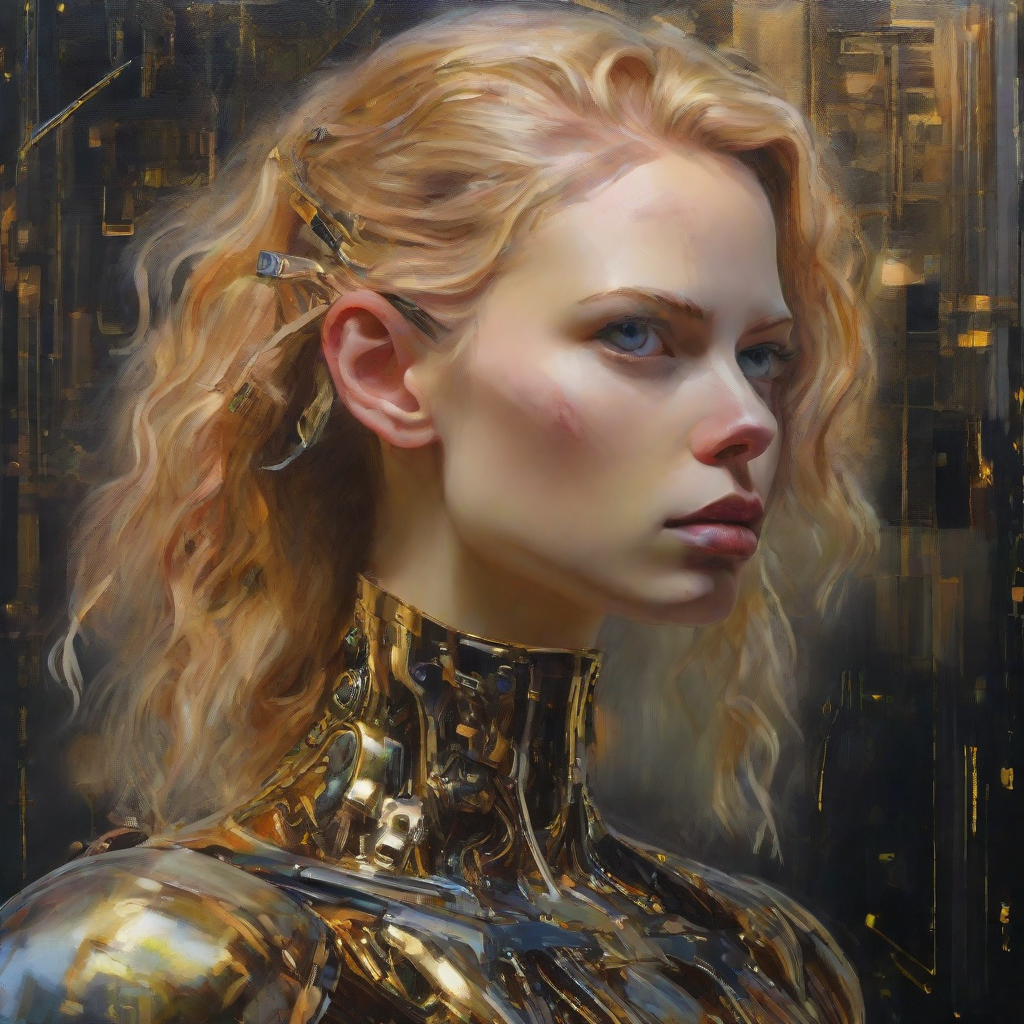
Görselden görseli
Görselden görsel dönüşümünde LCM'leri kullanmak için, desteklenen modelinizin LCM kontrol noktasını UNet2DConditionModel içine yüklemeniz ve zamanlayıcıyı LCMScheduler ile değiştirmeniz gerekir. Ardından, boru hattını normal şekilde kullanabilir ve yalnızca 4 adımda bir görsel üretmek için bir metin istemi ile başlangıç görselini iletebilirsiniz.
En iyi sonuçları almak için
num_inference_steps,strengthveguidance_scaleparametrelerinde farklı değerlerle deneyler yapın.
import torch
from diffusers import AutoPipelineForImage2Image, UNet2DConditionModel, LCMScheduler
from diffusers.utils import load_image

unet = UNet2DConditionModel.from_pretrained(
    "SimianLuo/LCM_Dreamshaper_v7",
    subfolder="unet",
    dtype=torch.float16,
)

pipe = AutoPipelineForImage2Image.from_pretrained(
    "Lykon/dreamshaper-7",
    unet=unet,
    dtype=torch.float16,
    variant="fp16",
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/img2img-init.png")
prompt = "Astronauts in a jungle, cold color palette, muted colors, detailed, 8k"
generator = torch.manual_seed(0)
image = pipe(
    prompt,
    image=init_image,
    num_inference_steps=4,
    guidance_scale=7.5,
    strength=0.5,
    generator=generator
).images[0]
image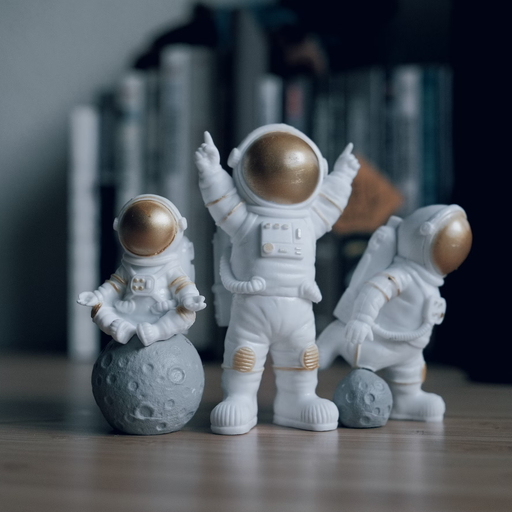

Görselden görsel dönüşümde LCM-LoRAları kullanmak için zamanlayıcıyı LCMScheduler ile değiştirmeniz ve LCM-LoRA ağırlıklarını load_lora_weights() yöntemiyle yüklemeniz gerekir. Ardından hattı (pipeline) normal şekilde kullanabilir, bir metin komutu ve başlangıç görseli geçirerek yalnızca 4 adımda bir görsel üretebilirsiniz.
En iyi sonuçları almak için
num_inference_steps,strengthveguidance_scaleparametrelerinde farklı değerlerle deneyler yapın.
import torch
from diffusers import AutoPipelineForImage2Image, LCMScheduler
from diffusers.utils import make_image_grid, load_image

pipe = AutoPipelineForImage2Image.from_pretrained(
    "Lykon/dreamshaper-7",
    dtype=torch.float16,
    variant="fp16",
).to("cuda")  # or "mps", "xpu", "cpu"

pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

pipe.load_lora_weights("latent-consistency/lcm-lora-sdv1-5")

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/img2img-init.png")
prompt = "Astronauts in a jungle, cold color palette, muted colors, detailed, 8k"

generator = torch.manual_seed(0)
image = pipe(
    prompt,
    image=init_image,
    num_inference_steps=4,
    guidance_scale=1,
    strength=0.6,
    generator=generator
).images[0]
image 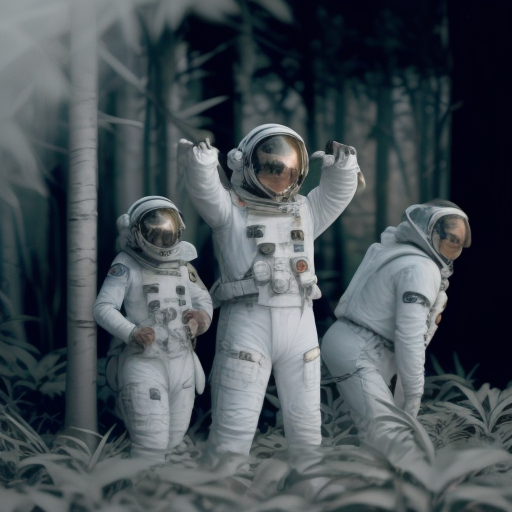
Inpainting
Inpainting için LCM-LoRAları kullanmak için zamanlayıcıyı LCMScheduler ile değiştirmeniz ve LCM-LoRA ağırlıklarını load_lora_weights() yöntemiyle yüklemeniz gerekir. Ardından pipeline'ı normal şekilde kullanabilir ve yalnızca 4 adımda bir görüntü üretmek için bir metin istemi, başlangıç görüntüsü ve maske görüntüsü iletebilirsiniz.
import torch
from diffusers import AutoPipelineForInpainting, LCMScheduler
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-inpainting",
    dtype=torch.float16,
    variant="fp16",
).to("cuda")  # or "mps", "xpu", "cpu"

pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

pipe.load_lora_weights("latent-consistency/lcm-lora-sdv1-5")

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/inpaint.png")
mask_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/inpaint_mask.png")

prompt = "concept art digital painting of an elven castle, inspired by lord of the rings, highly detailed, 8k"
generator = torch.manual_seed(0)
image = pipe(
    prompt=prompt,
    image=init_image,
    mask_image=mask_image,
    generator=generator,
    num_inference_steps=4,
    guidance_scale=4,
).images[0]
image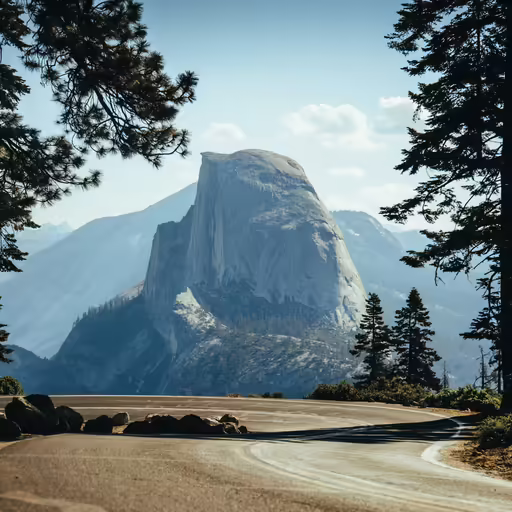

Adaptörler
LCM'ler, LoRA, ControlNet, T2I-Adapter ve AnimateDiff gibi adaptörlerle uyumludur. LCM'lerin hızını bu adaptörlere taşıyarak belirli bir stilde görseller üretebilir veya modeli canny görseli gibi başka bir girdiye göre koşullandırabilirsiniz.
LoRA
LoRA adaptörleri, yalnızca birkaç görselden yeni bir stil öğrenmek için hızla ince ayarlanabilir ve bu stilde görseller üretmek için önceden eğitilmiş bir modele eklenebilir.
Desteklenen modeliniz için LCM kontrol noktasını UNet2DConditionModel içine yükleyin ve zamanlayıcıyı LCMScheduler ile değiştirin. Ardından load_lora_weights() yöntemini kullanarak LoRA ağırlıklarını LCM'ye yükleyebilir ve birkaç adımda stilize bir görsel üretebilirsiniz.
from diffusers import StableDiffusionXLPipeline, UNet2DConditionModel, LCMScheduler
import torch

unet = UNet2DConditionModel.from_pretrained(
    "latent-consistency/lcm-sdxl",
    dtype=torch.float16,
    variant="fp16",
)
pipe = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", unet=unet, dtype=torch.float16, variant="fp16",
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)
pipe.load_lora_weights("TheLastBen/Papercut_SDXL", weight_name="papercut.safetensors", adapter_name="papercut")

prompt = "papercut, a cute fox"
generator = torch.manual_seed(0)
image = pipe(
    prompt=prompt, num_inference_steps=4, generator=generator, guidance_scale=8.0
).images[0]
image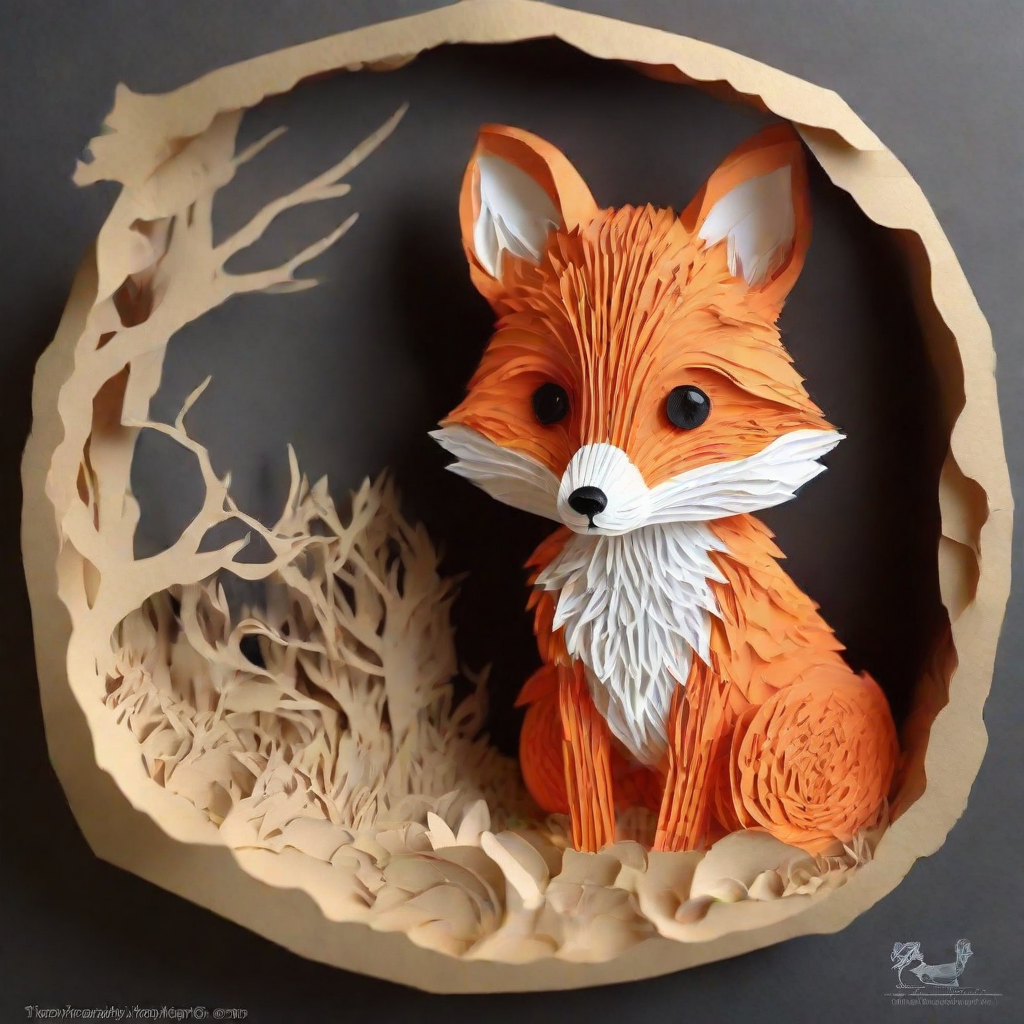
Zamanlayıcıyı LCMScheduler ile değiştirin. Ardından, kullanmak istediğiniz LCM-LoRA ağırlıklarını ve stil LoRA'sını yüklemek için load_lora_weights() yöntemini kullanabilirsiniz. Her iki LoRA adaptörünü de ~loaders.UNet2DConditionLoadersMixin.set_adapters yöntemiyle birleştirin ve birkaç adımda stillendirilmiş bir görüntü oluşturun.
import torch
from diffusers import DiffusionPipeline, LCMScheduler

pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    variant="fp16",
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

pipe.load_lora_weights("latent-consistency/lcm-lora-sdxl", adapter_name="lcm")
pipe.load_lora_weights("TheLastBen/Papercut_SDXL", weight_name="papercut.safetensors", adapter_name="papercut")

pipe.set_adapters(["lcm", "papercut"], adapter_weights=[1.0, 0.8])

prompt = "papercut, a cute fox"
generator = torch.manual_seed(0)
image = pipe(prompt, num_inference_steps=4, guidance_scale=1, generator=generator).images[0]
image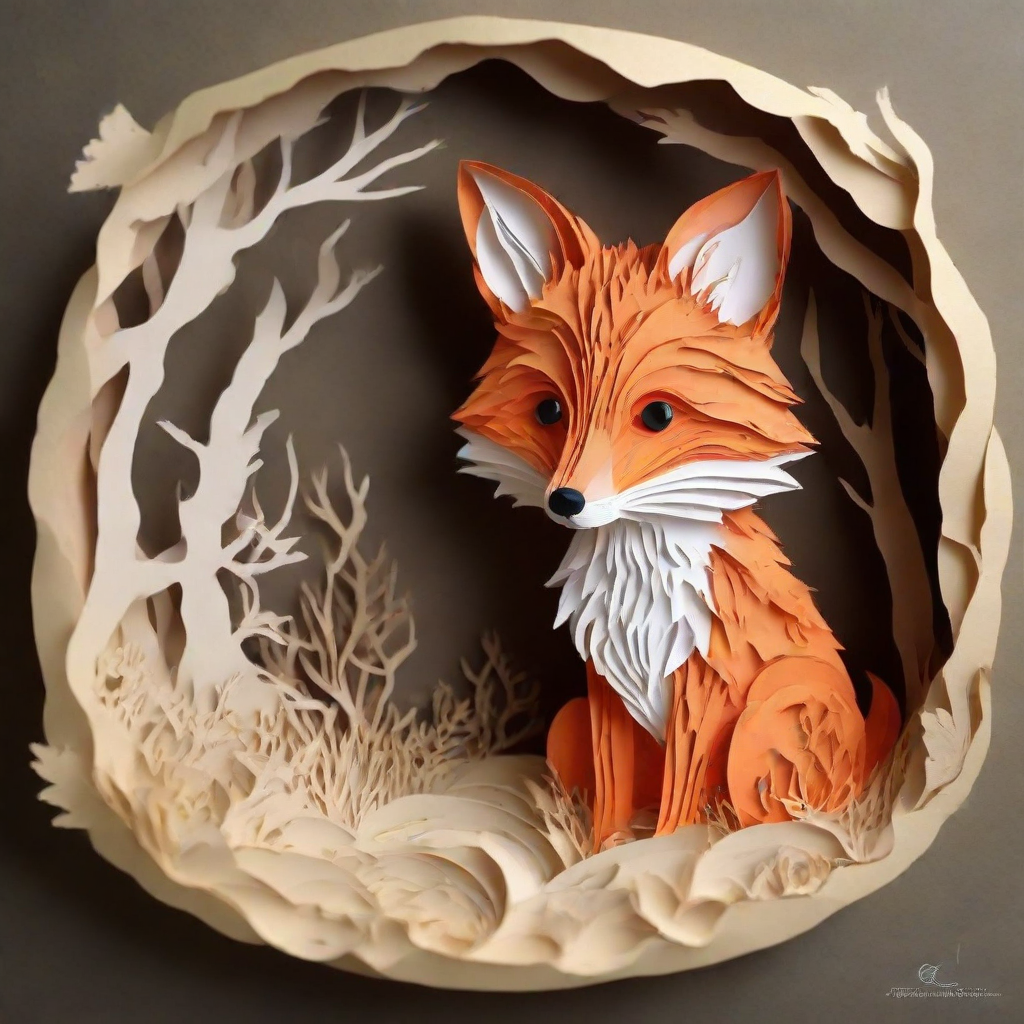
ControlNet
ControlNet, canny kenar, poz tahmini veya derinlik gibi çeşitli girdiler üzerinde eğitilebilen adaptörlerdir. ControlNet, daha doğru üretim için modele ek koşullandırma ve kontrol sağlamak üzere iş akışına eklenebilir.
Diğer girdiler üzerinde eğitilmiş ek ControlNet modellerini lllyasviel’in deposunda bulabilirsiniz.
Canny görüntülerinde eğitilmiş bir ControlNet modelini yükleyin ve ControlNetModel sınıfına iletin. Ardından bir LCM modelini StableDiffusionControlNetPipeline içine yükleyebilir ve zamanlayıcıyı LCMScheduler ile değiştirebilirsiniz. Şimdi canny görüntüsünü pipeline'a iletin ve bir görüntü oluşturun.
En iyi sonuçları almak için
num_inference_steps,controlnet_conditioning_scale,cross_attention_kwargsveguidance_scaleparametreleri için farklı değerlerle deneyler yapın.
import torch
import cv2
import numpy as np
from PIL import Image

from diffusers import StableDiffusionControlNetPipeline, ControlNetModel, LCMScheduler
from diffusers.utils import load_image, make_image_grid

image = load_image(
    "https://hf.co/datasets/huggingface/documentation-images/resolve/main/diffusers/input_image_vermeer.png"
).resize((512, 512))

image = np.array(image)

low_threshold = 100
high_threshold = 200

image = cv2.Canny(image, low_threshold, high_threshold)
image = image[:, :, None]
image = np.concatenate([image, image, image], axis=2)
canny_image = Image.fromarray(image)

controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-canny", dtype=torch.float16)
pipe = StableDiffusionControlNetPipeline.from_pretrained(
    "SimianLuo/LCM_Dreamshaper_v7",
    controlnet=controlnet,
    dtype=torch.float16,
    safety_checker=None,
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

generator = torch.manual_seed(0)
image = pipe(
    "the mona lisa",
    image=canny_image,
    num_inference_steps=4,
    generator=generator,
).images[0]
make_image_grid([canny_image, image], rows=1, cols=2)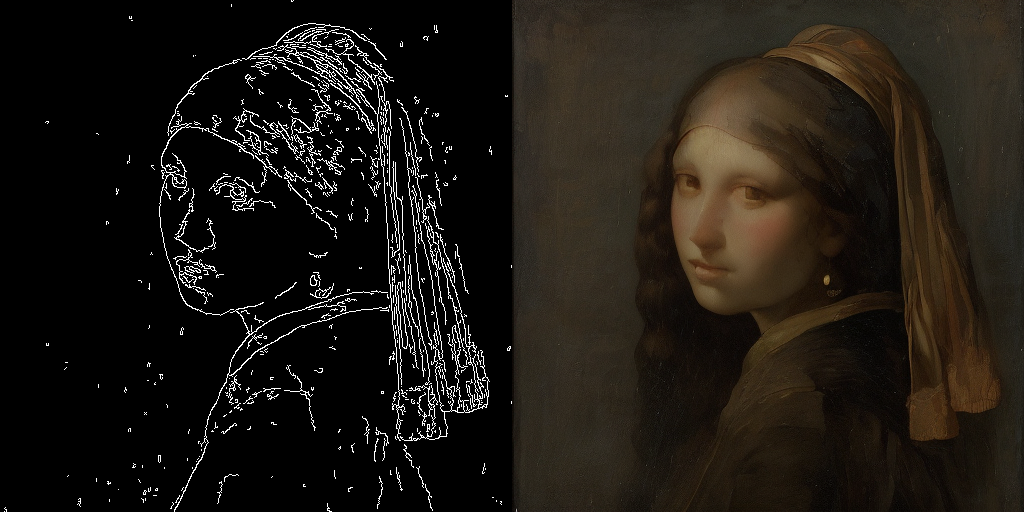
Canny görüntülerinde eğitilmiş bir ControlNet modelini yükleyin ve ControlNetModel sınıfına iletin. Ardından bir Stable Diffusion v1.5 modelini StableDiffusionControlNetPipeline içine yükleyebilir ve zamanlayıcıyı LCMScheduler ile değiştirebilirsiniz. LCM-LoRA ağırlıklarını yüklemek için load_lora_weights() yöntemini kullanın, canny görüntüsünü pipeline'a iletin ve bir görüntü oluşturun.
En iyi sonuçları almak için
num_inference_steps,controlnet_conditioning_scale,cross_attention_kwargsveguidance_scaleparametreleri için farklı değerlerle deneyler yapın.
import torch
import cv2
import numpy as np
from PIL import Image

from diffusers import StableDiffusionControlNetPipeline, ControlNetModel, LCMScheduler
from diffusers.utils import load_image

image = load_image(
    "https://hf.co/datasets/huggingface/documentation-images/resolve/main/diffusers/input_image_vermeer.png"
).resize((512, 512))

image = np.array(image)

low_threshold = 100
high_threshold = 200

image = cv2.Canny(image, low_threshold, high_threshold)
image = image[:, :, None]
image = np.concatenate([image, image, image], axis=2)
canny_image = Image.fromarray(image)

controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-canny", dtype=torch.float16)
pipe = StableDiffusionControlNetPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    controlnet=controlnet,
    dtype=torch.float16,
    safety_checker=None,
    variant="fp16"
).to("cuda")  # or "mps", "xpu", "cpu"

pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

pipe.load_lora_weights("latent-consistency/lcm-lora-sdv1-5")

generator = torch.manual_seed(0)
image = pipe(
    "the mona lisa",
    image=canny_image,
    num_inference_steps=4,
    guidance_scale=1.5,
    controlnet_conditioning_scale=0.8,
    cross_attention_kwargs={"scale": 1},
    generator=generator,
).images[0]
image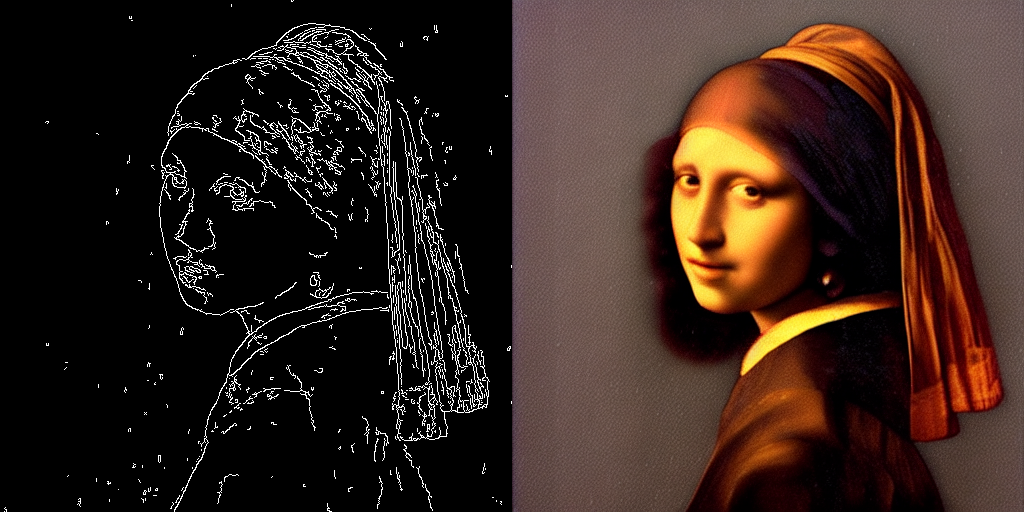
T2I-Adapter
T2I-Adapter, ControlNet'ten daha hafif bir adaptördür ve önceden eğitilmiş bir modele ek bir giriş sağlayarak koşullandırma imkânı sunar. ControlNet'ten daha hızlıdır ancak sonuçlar biraz daha düşük kalitede olabilir.
Diğer girdiler üzerinde eğitilmiş ek T2I-Adapter kontrol noktalarını TencentArc’in deposunda bulabilirsiniz.
Canny görüntülerinde eğitilmiş bir T2IAdapter yükleyin ve StableDiffusionXLAdapterPipeline nesnesine iletin. Ardından bir LCM checkpoint dosyasını UNet2DConditionModel içine yükleyin ve zamanlayıcıyı LCMScheduler ile değiştirin. Şimdi canny görüntüsünü pipeline'a iletin ve bir görüntü oluşturun.
import torch
import cv2
import numpy as np
from PIL import Image

from diffusers import StableDiffusionXLAdapterPipeline, UNet2DConditionModel, T2IAdapter, LCMScheduler
from diffusers.utils import load_image, make_image_grid

# detect the canny map in low resolution to avoid high-frequency details
image = load_image(
    "https://hf.co/datasets/huggingface/documentation-images/resolve/main/diffusers/input_image_vermeer.png"
).resize((384, 384))

image = np.array(image)

low_threshold = 100
high_threshold = 200

image = cv2.Canny(image, low_threshold, high_threshold)
image = image[:, :, None]
image = np.concatenate([image, image, image], axis=2)
canny_image = Image.fromarray(image).resize((1024, 1216))

adapter = T2IAdapter.from_pretrained("TencentARC/t2i-adapter-canny-sdxl-1.0", dtype=torch.float16, variant="fp16").to("cuda")  # or "mps", "xpu", "cpu"

unet = UNet2DConditionModel.from_pretrained(
    "latent-consistency/lcm-sdxl",
    dtype=torch.float16,
    variant="fp16",
)
pipe = StableDiffusionXLAdapterPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    unet=unet,
    adapter=adapter,
    dtype=torch.float16,
    variant="fp16",
).to("cuda")

pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

prompt = "the mona lisa, 4k picture, high quality"
negative_prompt = "extra digit, fewer digits, cropped, worst quality, low quality, glitch, deformed, mutated, ugly, disfigured"

generator = torch.manual_seed(0)
image = pipe(
    prompt=prompt,
    negative_prompt=negative_prompt,
    image=canny_image,
    num_inference_steps=4,
    guidance_scale=5,
    adapter_conditioning_scale=0.8,
    adapter_conditioning_factor=1,
    generator=generator,
).images[0]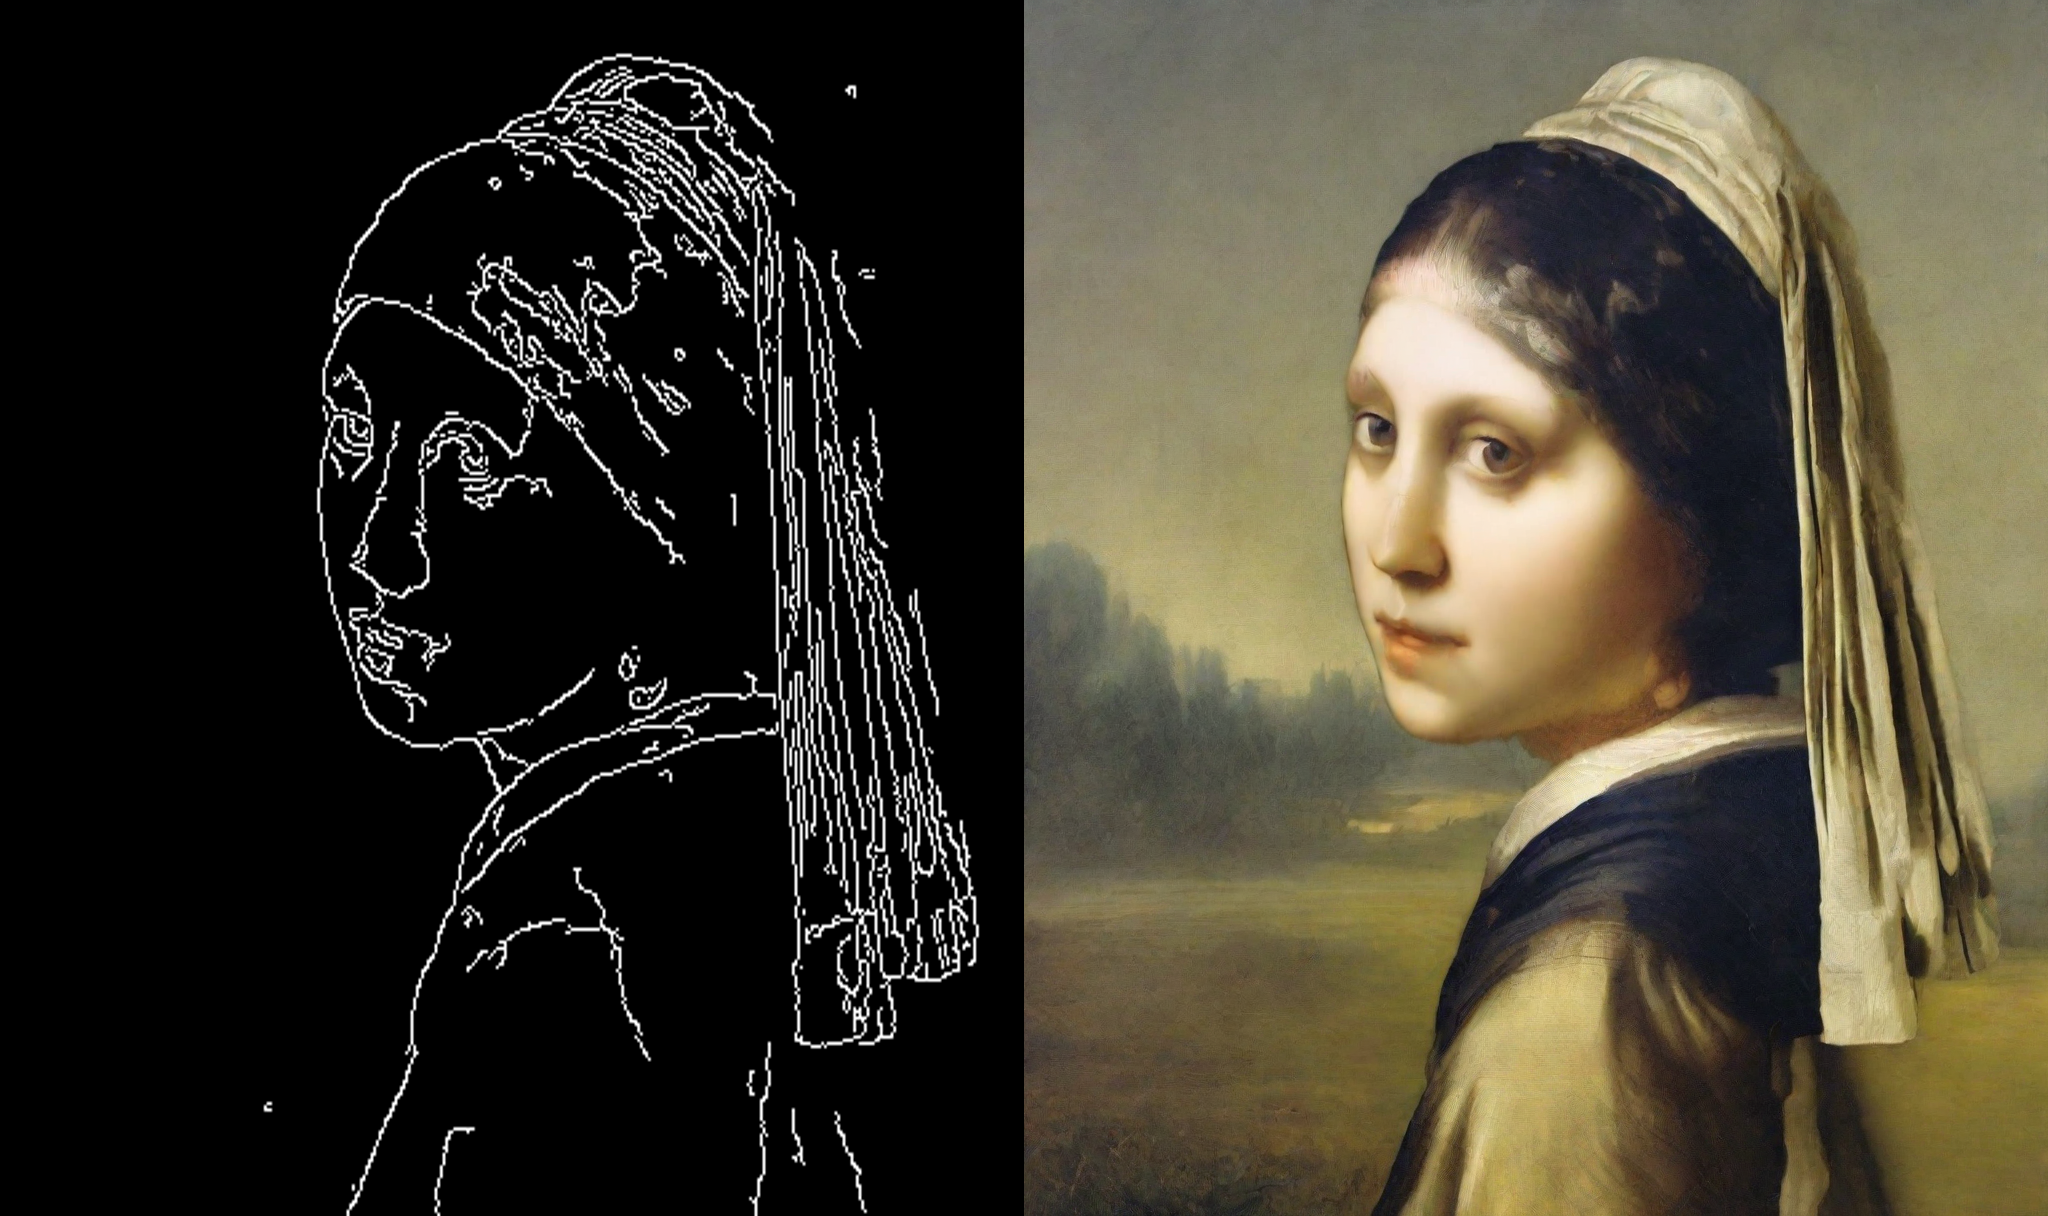
Canny görüntülerinde eğitilmiş bir T2IAdapter yükleyin ve StableDiffusionXLAdapterPipeline nesnesine iletin. Zamanlayıcıyı LCMScheduler ile değiştirin ve LCM-LoRA ağırlıklarını yüklemek için load_lora_weights() yöntemini kullanın. Canny görüntüsünü pipeline'a iletin ve bir görüntü oluşturun.
import torch
import cv2
import numpy as np
from PIL import Image

from diffusers import StableDiffusionXLAdapterPipeline, UNet2DConditionModel, T2IAdapter, LCMScheduler
from diffusers.utils import load_image, make_image_grid

# detect the canny map in low resolution to avoid high-frequency details
image = load_image(
    "https://hf.co/datasets/huggingface/documentation-images/resolve/main/diffusers/input_image_vermeer.png"
).resize((384, 384))

image = np.array(image)

low_threshold = 100
high_threshold = 200

image = cv2.Canny(image, low_threshold, high_threshold)
image = image[:, :, None]
image = np.concatenate([image, image, image], axis=2)
canny_image = Image.fromarray(image).resize((1024, 1024))

adapter = T2IAdapter.from_pretrained("TencentARC/t2i-adapter-canny-sdxl-1.0", dtype=torch.float16, variant="fp16").to("cuda")  # or "mps", "xpu", "cpu"

pipe = StableDiffusionXLAdapterPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    adapter=adapter,
    dtype=torch.float16,
    variant="fp16",
).to("cuda")

pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

pipe.load_lora_weights("latent-consistency/lcm-lora-sdxl")

prompt = "the mona lisa, 4k picture, high quality"
negative_prompt = "extra digit, fewer digits, cropped, worst quality, low quality, glitch, deformed, mutated, ugly, disfigured"

generator = torch.manual_seed(0)
image = pipe(
    prompt=prompt,
    negative_prompt=negative_prompt,
    image=canny_image,
    num_inference_steps=4,
    guidance_scale=1.5,
    adapter_conditioning_scale=0.8,
    adapter_conditioning_factor=1,
    generator=generator,
).images[0]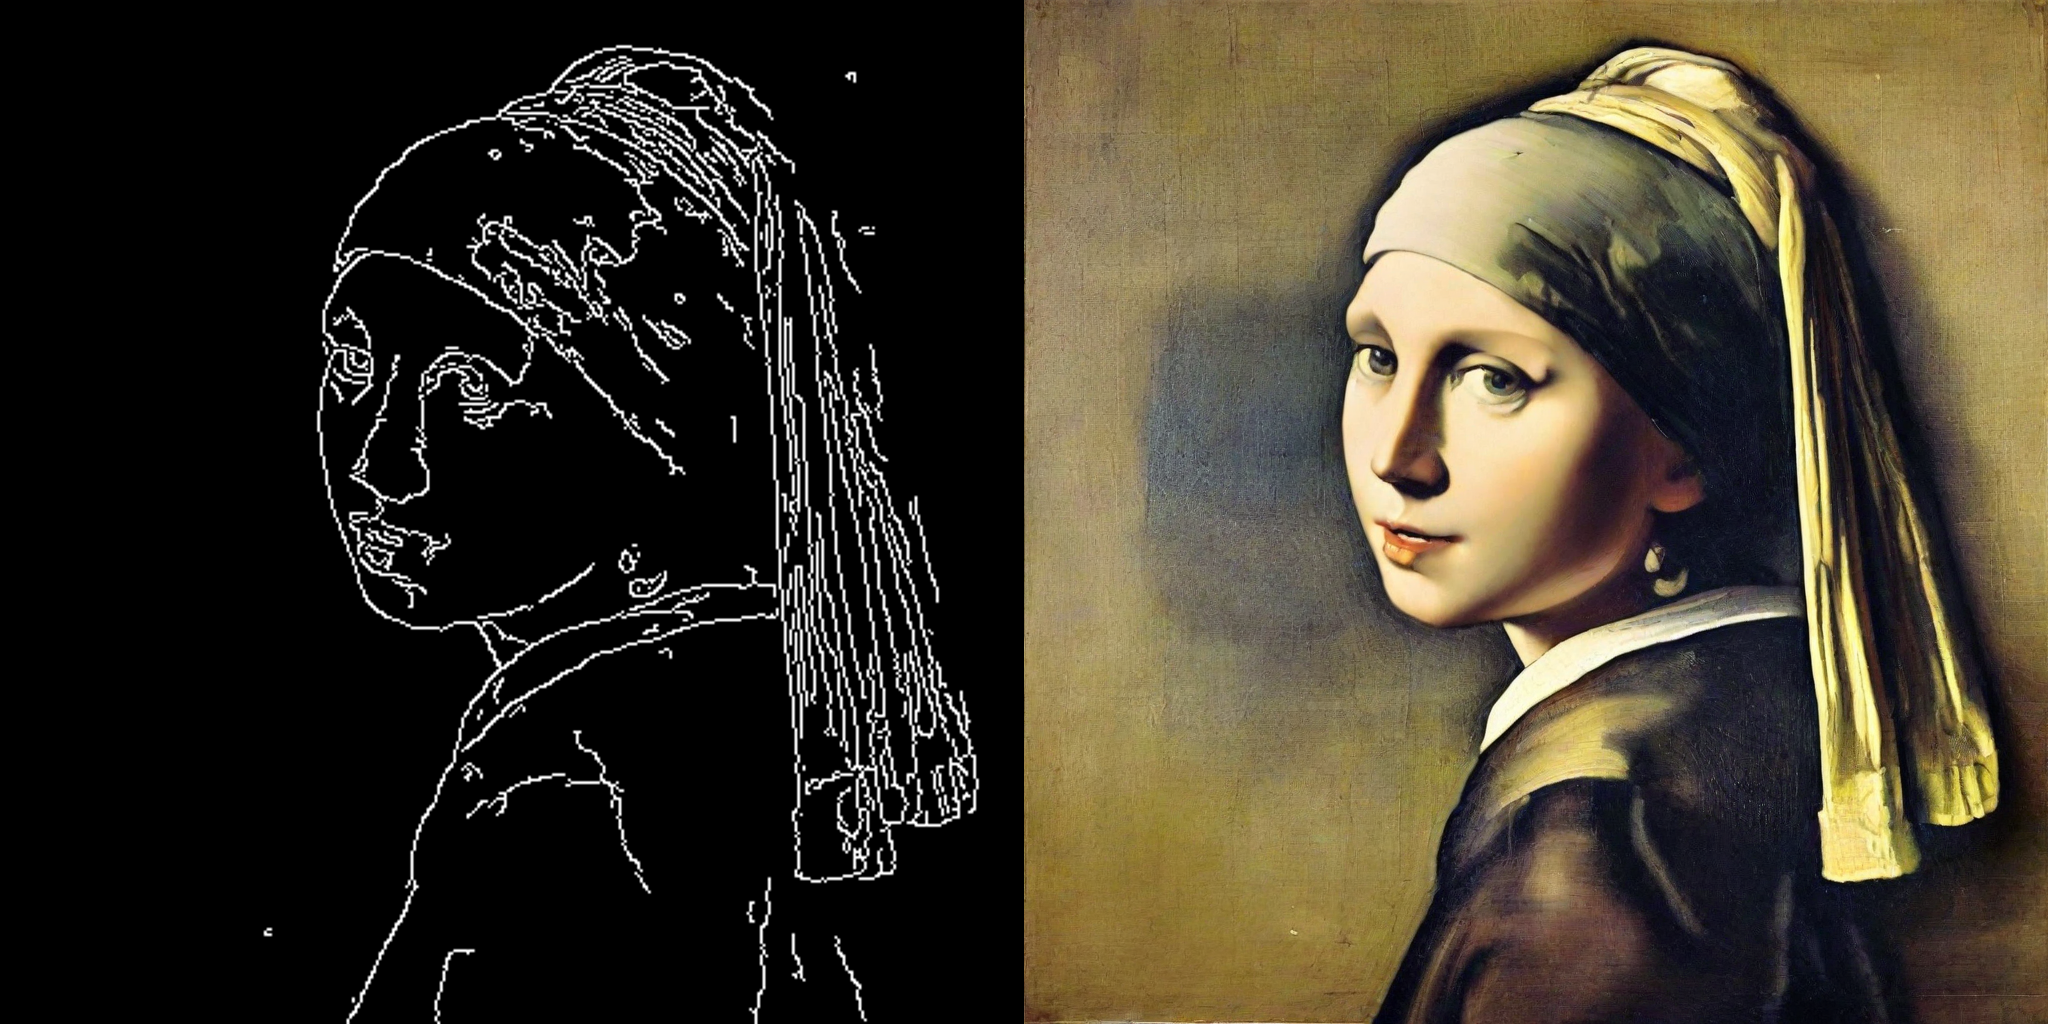
AnimateDiff
AnimateDiff, bir görseli hareketlendiren bir adaptördür. Çoğu Stable Diffusion modeliyle kullanılabilir ve bu modelleri fiilen “video üretimi” modellerine dönüştürür. Bir video modeliyle iyi sonuçlar elde etmek genellikle birden fazla kare (16-24) üretmeyi gerektirir ve bu işlem, standart bir Stable Diffusion modeliyle oldukça yavaş olabilir. LCM-LoRA, her kare için yalnızca 4-8 adım alarak bu süreci hızlandırabilir.
AnimateDiffPipeline yükleyin ve ona bir MotionAdapter iletin. Ardından zamanlayıcıyı LCMScheduler ile değiştirin ve her iki LoRA adaptörünü de ~loaders.UNet2DConditionLoadersMixin.set_adapters yöntemiyle birleştirin. Artık pipeline'a bir istem (prompt) iletebilir ve animasyonlu bir görsel üretebilirsiniz.
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler, LCMScheduler
from diffusers.utils import export_to_gif

adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5")
pipe = AnimateDiffPipeline.from_pretrained(
    "frankjoshua/toonyou_beta6",
    motion_adapter=adapter,
).to("cuda")  # or "mps", "xpu", "cpu"

# set scheduler
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

# load LCM-LoRA
pipe.load_lora_weights("latent-consistency/lcm-lora-sdv1-5", adapter_name="lcm")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-zoom-in", weight_name="diffusion_pytorch_model.safetensors", adapter_name="motion-lora")

pipe.set_adapters(["lcm", "motion-lora"], adapter_weights=[0.55, 1.2])

prompt = "best quality, masterpiece, 1girl, looking at viewer, blurry background, upper body, contemporary, dress"
generator = torch.manual_seed(0)
frames = pipe(
    prompt=prompt,
    num_inference_steps=5,
    guidance_scale=1.25,
    cross_attention_kwargs={"scale": 1},
    num_frames=24,
    generator=generator
).frames[0]
export_to_gif(frames, "animation.gif")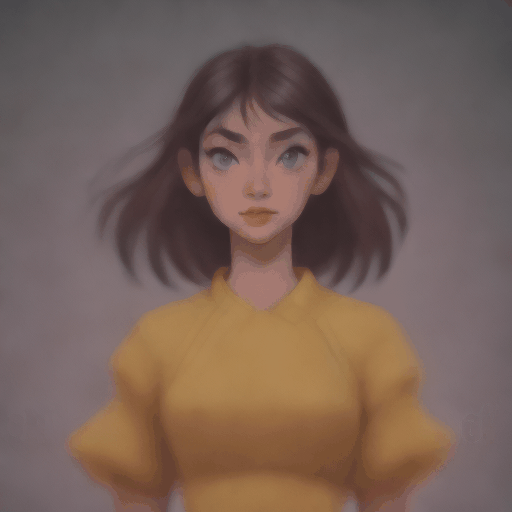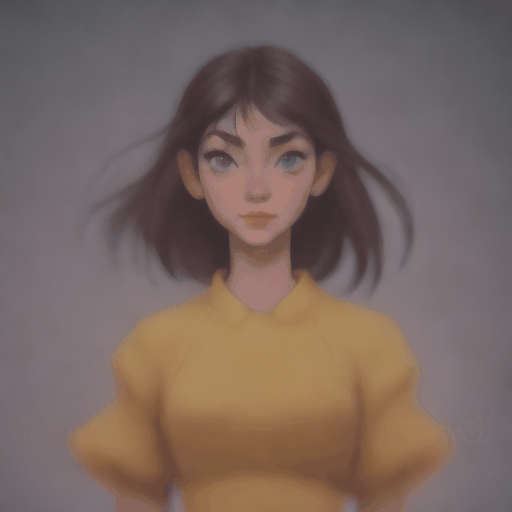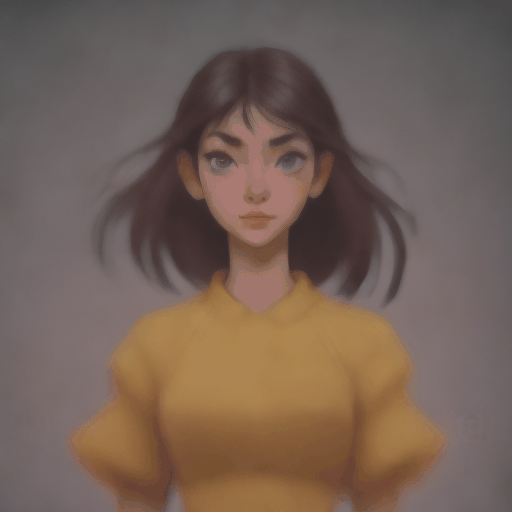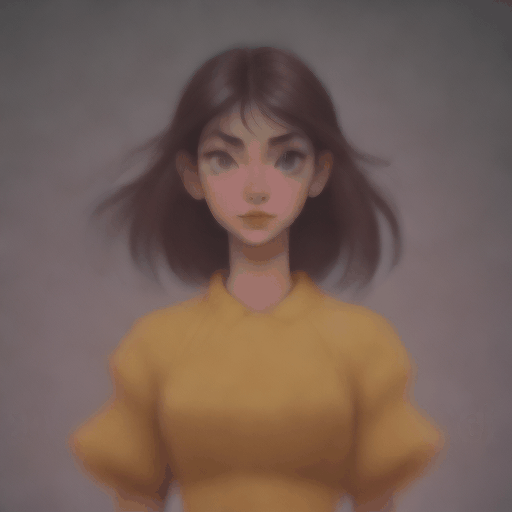
LatentConsistencyModelPipeline
sınıf diffusers.LatentConsistencyModelPipeline
< source >( vae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizerunet: UNet2DConditionModelscheduler: LCMSchedulersafety_checker: StableDiffusionSafetyCheckerfeature_extractor: CLIPImageProcessorPilimage_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = Nonerequires_safety_checker: bool = True )
Parametreler
- vae (AutoencoderKL) — Görselleri latent temsillere kodlamak ve bu temsillerden çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) modeli.
- text_encoder (CLIPTextModel) — Donmuş metin kodlayıcı (clip-vit-large-patch14).
- tokenizer (CLIPTokenizer) —
Metni tokenleştirmek için bir
CLIPTokenizer. - unet (UNet2DConditionModel) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için kullanılan bir
UNet2DConditionModel. - scheduler (SchedulerMixin) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için
unetile birlikte kullanılacak bir zamanlayıcı. Şu anda yalnızca LCMScheduler desteklenmektedir. - safety_checker (
StableDiffusionSafetyChecker) — Üretilen görsellerin saldırgan veya zararlı olarak değerlendirilip değerlendirilemeyeceğini tahmin eden sınıflandırma modülü. Bir modelin potansiyel zararlarına ilişkin daha fazla ayrıntı için model kartına bakın. - feature_extractor (CLIPImageProcessor) —
Üretilen görüntülerden özellik çıkarmak için kullanılan
CLIPImageProcessor;safety_checkergirdileri olarak kullanılır. - requires_safety_checker (
bool, isteğe bağlı, varsayılanTrue) — Hattın bir güvenlik denetleyicisi bileşeni gerektirip gerektirmediğini belirtir.
Latent tutarlılık modeli kullanılarak metinden görüntüye üretim için pipeline.
Bu model DiffusionPipeline sınıfından devralır. Tüm pipeline'lar için uygulanan genel yöntemlerin (indirme, kaydetme, belirli bir cihazda çalıştırma vb.) belgelerini üst sınıfın dokümantasyonunda bulabilirsiniz.
Pipeline ayrıca aşağıdaki yükleme yöntemlerini devralır:
- Metinsel tersine çevirme gömme yüklemek için load_textual_inversion()
- LoRA ağırlıklarını yüklemek için load_lora_weights()
- LoRA ağırlıklarını kaydetmek için save_lora_weights()
.ckptdosyalarını yüklemek için from_single_file()- IP Adapter'ları yüklemek için load_ip_adapter()
__call__
< source >( prompt: str | list[str] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 4original_inference_steps: int = Nonetimesteps: list = Noneguidance_scale: float = 8.5num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecross_attention_kwargs: dict[str, typing.Any] | None = Noneclip_skip: int | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']**kwargs ) → StableDiffusionPipelineOutput or tuple
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimi yönlendirmek için istem veya istemler. Tanımlanmadıysaprompt_embedsparametresini iletmeniz gerekir. - height (
int, isteğe bağlı, varsayılanself.unet.config.sample_size * self.vae_scale_factor) — Oluşturulan görüntünün piksel cinsinden yüksekliği. - width (
int, isteğe bağlı, varsayılanself.unet.config.sample_size * self.vae_scale_factor) — Oluşturulan görüntünün piksel cinsinden genişliği. - num_inference_steps (
int, isteğe bağlı, varsayılan 50) — Gürültü azaltma adım sayısı. Daha fazla gürültü azaltma adımı genellikle daha yavaş çıkarım pahasına daha yüksek kaliteli bir görüntüye yol açar. - original_inference_steps (
int, isteğe bağlı) — Doğrusal aralıklı bir timestep planı oluşturmak için kullanılan orijinal inference adım sayısı; makaledeki Skipping-Step yöntemine (Bölüm 4.3'e bakınız) uygun olarak, bu plandannum_inference_stepseşit aralıklı timestep değerini son timestep planımız olarak seçeriz. Ayarlanmazsa, scheduler'ınoriginal_inference_stepsözniteliği varsayılan olarak kullanılır. - timesteps (
list[int], isteğe bağlı) — Gürültüden arındırma süreci için kullanılacak özel zaman adımları. Tanımlanmamışsa, orijinal LCM eğitim/distilasyon zaman adımı zaman çizelgesinde eşit aralıklınum_inference_stepszaman adımı kullanılır. Azalan sırada olmalıdır. - guidance_scale (
float, isteğe bağlı, varsayılan 7.5) — Daha yüksek bir guidance scale değeri, modelinpromptile yakından ilişkili görseller üretmesini teşvik eder; bunun bedeli ise daha düşük görsel kalitedir. Guidance scale,guidance_scale > 1olduğunda etkinleşir. Orijinal latent consistency models makalesinin, guidance scale değerlerinin 1 azaltıldığı farklı bir CFG formülasyonu kullandığını unutmayın (yani makaledeki formülasyona göre CFG,guidance_scale > 0olduğunda etkinleşir). - num_images_per_prompt (
int, isteğe bağlı, varsayılan 1) — Her istem için oluşturulacak görsel sayısı. - generator (
torch.Generatorveyalist[torch.Generator], isteğe bağlı) — Üretimi deterministik hale getirmek için kullanılan birtorch.Generator. - latents (
torch.Tensor, isteğe bağlı) — Gaussian dağılımdan örneklenen, gürültülü ve önceden oluşturulmuş latents; görüntü üretimi için girdi olarak kullanılabilir. Farklı istemlerle aynı üretimi ayarlamak için kullanılabilir. Sağlanmazsa, sağlanan rastgelegeneratorkullanılarak örneklemeye dayalı bir latents tensörü oluşturulur. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak (istifade ağırlıklandırma) için kullanılabilir. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından üretilir. - ip_adapter_image — (
PipelineImageInput, isteğe bağlı): IP Adapters ile çalışmak için isteğe bağlı görüntü girdisi. - ip_adapter_image_embeds (
list[torch.Tensor], isteğe bağlı) — IP-Adapter için önceden oluşturulmuş gömme (embedding) değerleri. IP-adapter sayısı ile aynı uzunlukta bir liste olmalıdır. Her öğe,(batch_size, num_images, emb_dim)biçiminde bir tensör olmalıdır.do_classifier_free_guidanceTrueolarak ayarlandıysa, negatif gömme değerini içermelidir. Sağlanmazsa, gömme değerleriip_adapter_imagegirdi argümanından hesaplanır. - output_type (
str, isteğe bağlı, varsayılan"pil") — Oluşturulan görüntünün çıktı biçimi.PIL.Imageveyanp.arrayarasında seçim yapın. - return_dict (
bool, isteğe bağlı, varsayılanTrue) — Düz bir tuple yerine StableDiffusionPipelineOutput döndürülüp döndürülmemesi. - cross_attention_kwargs (
dict, isteğe bağlı) — Belirtilirse,self.processoriçinde tanımlananAttentionProcessor'ye iletilen bir kwargs sözlüğü. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir. - callback_on_step_end (
Callable, isteğe bağlı) — Çıkarım sırasında her gürültü azaltma adımının sonunda çağrılan bir işlev. İşlev aşağıdaki argümanlarla çağrılır:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargs,callback_on_step_end_tensor_inputstarafından belirtilen tüm tensörlerin listesini içerir. - callback_on_step_end_tensor_inputs (
list, isteğe bağlı) —callback_on_step_endişlevi için girdi tensörlerinin listesi. Listede belirtilen tensörler,callback_kwargsargümanı olarak geçirilir. Yalnızca pipeline sınıfınızın._callback_tensor_inputsözniteliğinde listelenen değişkenleri dahil edebilirsiniz.
Dönüş değeri
StableDiffusionPipelineOutput veya tuple
return_dict True ise StableDiffusionPipelineOutput döndürülür,
aksi halde bir tuple döndürülür; bu tuple'ın ilk öğesi üretilen görsellerin listesini, ikinci öğesi ise
üretile görselin “not-safe-for-work” (nsfw) içerip içermediğini gösteren bool değerlerinin listesini içerir.
Üretim için pipeline'ın çağrı fonksiyonu.
Örnekler:
>>> from diffusers import DiffusionPipeline
>>> import torch

>>> pipe = DiffusionPipeline.from_pretrained("SimianLuo/LCM_Dreamshaper_v7")
>>> # To save GPU memory, torch.float16 can be used, but it may compromise image quality.
>>> pipe.to(torch_device="cuda", torch_dtype=torch.float32)

>>> prompt = "Self-portrait oil painting, a beautiful cyborg with golden hair, 8k"

>>> # Can be set to 1~50 steps. LCM support fast inference even <= 4 steps. Recommend: 1~8 steps.
>>> num_inference_steps = 4
>>> images = pipe(prompt=prompt, num_inference_steps=num_inference_steps, guidance_scale=8.0).images
>>> images[0].save("image.png")
enable_freeu
< source >( s1: floats2: floatb1: floatb2: float )
Parametreler
- s1 (
float) — 1. aşama için, atlanan özelliklerin katkılarını azaltmak üzere kullanılan ölçekleme faktörü. Bu, geliştirilmiş gürültü azaltma sürecindeki “aşırı yumuşatma etkisini” (oversmoothing effect) hafifletmek için yapılır. - s2 (
float) — 2. aşama için, atlanan özelliklerin katkılarını azaltmak üzere kullanılan ölçekleme faktörü. Bu, iyileştirilmiş gürültü azaltma sürecindeki “aşırı yumuşatma etkisini” (oversmoothing effect) hafifletmek için yapılır. - b1 (
float) — Omurga özelliklerinin katkılarını artırmak için 1. aşamanın ölçekleme çarpanı. - b2 (
float) — Omurga özelliklerinin katkılarını artırmak için 2. aşamanın ölçekleme çarpanı.
https://huggingface.co/papers/2309.11497 makalesinde olduğu gibi FreeU mekanizmasını etkinleştirir.
Ölçekleme katsayılarının sonundaki ekler, bu katsayıların uygulandığı aşamaları temsil eder.
Stable Diffusion v1, v2 ve Stable Diffusion XL gibi farklı pipeline'lar için iyi çalıştığı bilinen değer kombinasyonları için resmi depoya bakın.
Etkinse, FreeU mekanizmasını devre dışı bırakır.
encode_prompt
< source >( promptdevicenum_images_per_promptdo_classifier_free_guidancenegative_prompt = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonelora_scale: float | None = Noneclip_skip: int | None = None )
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — kodlanacak prompt - device — (
torch.device): torch cihazı - num_images_per_prompt (
int) — her prompt için oluşturulacak görsel sayısı - do_classifier_free_guidance (
bool) — classifier free guidance kullanılacak mı - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - lora_scale (
float, isteğe bağlı) — LoRA katmanları yüklendiyse, metin kodlayıcısının tüm LoRA katmanlarına uygulanacak LoRA ölçeği. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir.
İsteği metin kodlayıcı gizli durumlarına kodlar.
get_guidance_scale_embedding
< source >( w: Tensorembedding_dim: int = 512dtype: dtype = torch.float32 ) → torch.Tensor
Parametreler
- w (
torch.Tensor) — Belirtilen bir yönlendirme ölçeğiyle gömme vektörleri üretin ve ardından zaman adımları gömmelerini zenginleştirmek için kullanın. - embedding_dim (
int, isteğe bağlı, varsayılan 512) — Oluşturulacak gömme boyutu. - dtype (
torch.dtype, isteğe bağlı, varsayılantorch.float32) — Oluşturulan gömme vektörlerinin veri türü.
Dönüş değeri
torch.Tensor
(len(w), embedding_dim) biçiminde gömme vektörleri.
LatentConsistencyModelImg2ImgPipeline
sınıf diffusers.LatentConsistencyModelImg2ImgPipeline
< source >( vae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizerunet: UNet2DConditionModelscheduler: LCMSchedulersafety_checker: StableDiffusionSafetyCheckerfeature_extractor: CLIPImageProcessorPilimage_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = Nonerequires_safety_checker: bool = True )
Parametreler
- vae (AutoencoderKL) — Görselleri latent temsillere kodlamak ve bu temsillerden çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) modeli.
- text_encoder (CLIPTextModel) — Donmuş metin kodlayıcı (clip-vit-large-patch14).
- tokenizer (CLIPTokenizer) —
Metni tokenleştirmek için bir
CLIPTokenizer. - unet (UNet2DConditionModel) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için kullanılan bir
UNet2DConditionModel. - scheduler (SchedulerMixin) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için
unetile birlikte kullanılacak bir zamanlayıcı. Şu anda yalnızca LCMScheduler desteklenmektedir. - safety_checker (
StableDiffusionSafetyChecker) — Üretilen görsellerin saldırgan veya zararlı olarak değerlendirilip değerlendirilemeyeceğini tahmin eden sınıflandırma modülü. Bir modelin potansiyel zararlarına ilişkin daha fazla ayrıntı için model kartına bakın. - feature_extractor (CLIPImageProcessor) —
Üretilen görüntülerden özellik çıkarmak için kullanılan
CLIPImageProcessor;safety_checkergirdileri olarak kullanılır. - requires_safety_checker (
bool, isteğe bağlı, varsayılanTrue) — Hattın bir güvenlik denetleyicisi bileşeni gerektirip gerektirmediğini belirtir.
Latent tutarlılık modeli kullanılarak görüntüden görüntüye üretim için pipeline.
Bu model DiffusionPipeline sınıfından devralır. Tüm pipeline'lar için uygulanan genel yöntemlerin (indirme, kaydetme, belirli bir cihazda çalıştırma vb.) belgelerini üst sınıfın dokümantasyonunda bulabilirsiniz.
Pipeline ayrıca aşağıdaki yükleme yöntemlerini devralır:
- Metinsel tersine çevirme gömme yüklemek için load_textual_inversion()
- LoRA ağırlıklarını yüklemek için load_lora_weights()
- LoRA ağırlıklarını kaydetmek için save_lora_weights()
.ckptdosyalarını yüklemek için from_single_file()- IP Adapter'ları yüklemek için load_ip_adapter()
__call__
< source >( prompt: str | list[str] = Noneimage: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonenum_inference_steps: int = 4strength: float = 0.8original_inference_steps: int = Nonetimesteps: list = Noneguidance_scale: float = 8.5num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecross_attention_kwargs: dict[str, typing.Any] | None = Noneclip_skip: int | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']**kwargs ) → StableDiffusionPipelineOutput or tuple
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimi yönlendirmek için istem veya istemler. Tanımlanmadıysaprompt_embedsparametresini iletmeniz gerekir. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]veyalist[np.ndarray]) — Başlangıç noktası olarak kullanılacak bir görüntü veya görüntü partisini temsil edenImageveya tensör.imageolarak görüntü latentlerini de kabul edebilir, ancak latentler doğrudan geçirilirse yeniden kodlanmaz. - num_inference_steps (
int, isteğe bağlı, varsayılan 50) — Gürültü azaltma adım sayısı. Daha fazla gürültü azaltma adımı genellikle daha yavaş çıkarım pahasına daha yüksek kaliteli bir görüntüye yol açar. - strength (
float, isteğe bağlı, varsayılan 0.8) — Referansimage'in ne ölçüde dönüştürüleceğini belirtir. 0 ile 1 arasında olmalıdır.imagebir başlangıç noktası olarak kullanılır vestrengthdeğeri arttıkça daha fazla gürültü eklenir. Gürültü azaltma adım sayısı, başlangıçta eklenen gürültü miktarına bağlıdır.strength1 olduğunda eklenen gürültü maksimumdur ve gürültü azaltma süreci,num_inference_stepsiçinde belirtilen tam yineleme sayısı kadar çalışır. 1 değeri,image'i temelde yok sayar. - original_inference_steps (
int, isteğe bağlı) — Doğrusal aralıklı bir timestep planı oluşturmak için kullanılan orijinal inference adım sayısı; makaledeki Skipping-Step yöntemine (Bölüm 4.3'e bakınız) uygun olarak, bu plandannum_inference_stepseşit aralıklı timestep değerini son timestep planımız olarak seçeriz. Ayarlanmazsa, scheduler'ınoriginal_inference_stepsözniteliği varsayılan olarak kullanılır. - timesteps (
list[int], isteğe bağlı) — Gürültüden arındırma süreci için kullanılacak özel zaman adımları. Tanımlanmamışsa, orijinal LCM eğitim/distilasyon zaman adımı zaman çizelgesinde eşit aralıklınum_inference_stepszaman adımı kullanılır. Azalan sırada olmalıdır. - guidance_scale (
float, isteğe bağlı, varsayılan 7.5) — Daha yüksek bir guidance scale değeri, modelinpromptile yakından ilişkili görseller üretmesini teşvik eder; bunun bedeli ise daha düşük görsel kalitedir. Guidance scale,guidance_scale > 1olduğunda etkinleşir. Orijinal latent consistency models makalesinin, guidance scale değerlerinin 1 azaltıldığı farklı bir CFG formülasyonu kullandığını unutmayın (yani makaledeki formülasyona göre CFG,guidance_scale > 0olduğunda etkinleşir). - num_images_per_prompt (
int, isteğe bağlı, varsayılan 1) — Her istem için oluşturulacak görsel sayısı. - generator (
torch.Generatorveyalist[torch.Generator], isteğe bağlı) — Üretimi deterministik hale getirmek için kullanılan birtorch.Generator. - latents (
torch.Tensor, isteğe bağlı) — Gaussian dağılımdan örneklenen, gürültülü ve önceden oluşturulmuş latents; görüntü üretimi için girdi olarak kullanılabilir. Farklı istemlerle aynı üretimi ayarlamak için kullanılabilir. Sağlanmazsa, sağlanan rastgelegeneratorkullanılarak örneklemeye dayalı bir latents tensörü oluşturulur. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak (istifade ağırlıklandırma) için kullanılabilir. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından üretilir. - ip_adapter_image — (
PipelineImageInput, isteğe bağlı): IP Adapters ile çalışmak için isteğe bağlı görüntü girdisi. - ip_adapter_image_embeds (
list[torch.Tensor], isteğe bağlı) — IP-Adapter için önceden oluşturulmuş gömme (embedding) değerleri. IP-adapter sayısı ile aynı uzunlukta bir liste olmalıdır. Her öğe,(batch_size, num_images, emb_dim)biçiminde bir tensör olmalıdır.do_classifier_free_guidanceTrueolarak ayarlandıysa, negatif gömme değerini içermelidir. Sağlanmazsa, gömme değerleriip_adapter_imagegirdi argümanından hesaplanır. - output_type (
str, isteğe bağlı, varsayılan"pil") — Oluşturulan görüntünün çıktı biçimi.PIL.Imageveyanp.arrayarasında seçim yapın. - return_dict (
bool, isteğe bağlı, varsayılanTrue) — Düz bir tuple yerine StableDiffusionPipelineOutput döndürülüp döndürülmemesi. - cross_attention_kwargs (
dict, isteğe bağlı) — Belirtilirse,self.processoriçinde tanımlananAttentionProcessor'ye iletilen bir kwargs sözlüğü. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir. - callback_on_step_end (
Callable, isteğe bağlı) — Çıkarım sırasında her gürültü azaltma adımının sonunda çağrılan bir işlev. İşlev aşağıdaki argümanlarla çağrılır:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargs,callback_on_step_end_tensor_inputstarafından belirtilen tüm tensörlerin listesini içerir. - callback_on_step_end_tensor_inputs (
list, isteğe bağlı) —callback_on_step_endişlevi için girdi tensörlerinin listesi. Listede belirtilen tensörler,callback_kwargsargümanı olarak geçirilir. Yalnızca pipeline sınıfınızın._callback_tensor_inputsözniteliğinde listelenen değişkenleri dahil edebilirsiniz.
Dönüş değeri
StableDiffusionPipelineOutput veya tuple
return_dict True ise StableDiffusionPipelineOutput döndürülür,
aksi halde bir tuple döndürülür; bu tuple'ın ilk öğesi üretilen görsellerin listesini, ikinci öğesi ise
üretile görselin “not-safe-for-work” (nsfw) içerip içermediğini gösteren bool değerlerinin listesini içerir.
Üretim için pipeline'ın çağrı fonksiyonu.
Örnekler:
>>> from diffusers import AutoPipelineForImage2Image
>>> import torch
>>> import PIL

>>> pipe = AutoPipelineForImage2Image.from_pretrained("SimianLuo/LCM_Dreamshaper_v7")
>>> # To save GPU memory, torch.float16 can be used, but it may compromise image quality.
>>> pipe.to(torch_device="cuda", torch_dtype=torch.float32)

>>> prompt = "High altitude snowy mountains"
>>> image = PIL.Image.open("./snowy_mountains.png")

>>> # Can be set to 1~50 steps. LCM support fast inference even <= 4 steps. Recommend: 1~8 steps.
>>> num_inference_steps = 4
>>> images = pipe(
...     prompt=prompt, image=image, num_inference_steps=num_inference_steps, guidance_scale=8.0
... ).images

>>> images[0].save("image.png")
enable_freeu
< source >( s1: floats2: floatb1: floatb2: float )
Parametreler
- s1 (
float) — 1. aşama için, atlanan özelliklerin katkılarını azaltmak üzere kullanılan ölçekleme faktörü. Bu, geliştirilmiş gürültü azaltma sürecindeki “aşırı yumuşatma etkisini” (oversmoothing effect) hafifletmek için yapılır. - s2 (
float) — 2. aşama için, atlanan özelliklerin katkılarını azaltmak üzere kullanılan ölçekleme faktörü. Bu, iyileştirilmiş gürültü azaltma sürecindeki “aşırı yumuşatma etkisini” (oversmoothing effect) hafifletmek için yapılır. - b1 (
float) — Omurga özelliklerinin katkılarını artırmak için 1. aşamanın ölçekleme çarpanı. - b2 (
float) — Omurga özelliklerinin katkılarını artırmak için 2. aşamanın ölçekleme çarpanı.
https://huggingface.co/papers/2309.11497 makalesinde olduğu gibi FreeU mekanizmasını etkinleştirir.
Ölçekleme katsayılarının sonundaki ekler, bu katsayıların uygulandığı aşamaları temsil eder.
Stable Diffusion v1, v2 ve Stable Diffusion XL gibi farklı pipeline'lar için iyi çalıştığı bilinen değer kombinasyonları için resmi depoya bakın.
Etkinse, FreeU mekanizmasını devre dışı bırakır.
encode_prompt
< source >( promptdevicenum_images_per_promptdo_classifier_free_guidancenegative_prompt = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonelora_scale: float | None = Noneclip_skip: int | None = None )
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — kodlanacak prompt - device — (
torch.device): torch cihazı - num_images_per_prompt (
int) — her prompt için oluşturulacak görsel sayısı - do_classifier_free_guidance (
bool) — classifier free guidance kullanılacak mı - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - lora_scale (
float, isteğe bağlı) — LoRA katmanları yüklendiyse, metin kodlayıcısının tüm LoRA katmanlarına uygulanacak LoRA ölçeği. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir.
İsteği metin kodlayıcı gizli durumlarına kodlar.
get_guidance_scale_embedding
< source >( w: Tensorembedding_dim: int = 512dtype: dtype = torch.float32 ) → torch.Tensor
Parametreler
- w (
torch.Tensor) — Belirtilen bir yönlendirme ölçeğiyle gömme vektörleri üretin ve ardından zaman adımları gömmelerini zenginleştirmek için kullanın. - embedding_dim (
int, isteğe bağlı, varsayılan 512) — Oluşturulacak gömme boyutu. - dtype (
torch.dtype, isteğe bağlı, varsayılantorch.float32) — Oluşturulan gömme vektörlerinin veri türü.
Dönüş değeri
torch.Tensor
(len(w), embedding_dim) biçiminde gömme vektörleri.
StableDiffusionPipelineOutput
sınıf diffusers.pipelines.stable_diffusion.StableDiffusionPipelineOutput
< source >( images: list[PIL.Image.Image] | numpy.ndarraynsfw_content_detected: list[bool] | None )
Parametreler
- images (
list[PIL.Image.Image]veyanp.ndarray) —batch_sizeuzunluğunda gürültüsü azaltılmış PIL görüntülerinin listesi veya(batch_size, height, width, num_channels)biçiminde NumPy dizisi. - nsfw_content_detected (
list[bool]) — İlgili üretilen görüntünün “iş yerinde uygun olmayan” (nsfw) içerik içerip içermediğini gösteren liste veya güvenlik kontrolünün yapılamadığı durumlardaNone.
Stable Diffusion hatları için çıktı sınıfı.