
Transformers documentation
التحسين
التحسين
يوفر وحدة .optimization:
- مُحسِّن بانهيار وزن ثابت يمكن استخدامه لضبط النماذج، و
- عدة جداول على شكل كائنات جدول ترث من
_LRSchedule: - فئة لتجميع التدرجات من أجل تجميع تدرجات عدة دفعات
AdaFactor
فئة transformers.Adafactor
< source >( paramslr = Noneeps = (1e-30, 0.001)clip_threshold = 1.0decay_rate = -0.8beta1 = Noneweight_decay = 0.0scale_parameter = Truerelative_step = Truewarmup_init = False )
المعاملات
- params (
Iterable[nn.parameter.Parameter]) — قابلة للتكرار (Iterable) للمعاملات المراد تحسينها أو قواميس (dictionaries) تعرّف مجموعات المعاملات. - lr (
float, اختياري) — معدل التعلم الخارجي. - eps (
tuple[float, float]، اختياري، القيمة الافتراضية(1e-30, 0.001)) — ثوابت التنظيم للتدرج المربع ومقياس المعامل على التوالي - clip_threshold (
float, اختياري، القيمة الافتراضية 1.0) — حدّ الجذر التربيعي للمتوسط للتحديث النهائي للتدرّج - decay_rate (
float، اختياري، القيمة الافتراضية -0.8) — المعامل المستخدم لحساب المتوسطات المتحركة للمربعات - beta1 (
float, اختياري) — المعامل المستخدم لحساب المتوسطات المتحركة للتدرج - weight_decay (
float، اختياري، القيمة الافتراضية 0.0) — تلاشي الأوزان (عقوبة L2) - scale_parameter (
bool، اختياري، القيمة الافتراضيةTrue) — إذا كانت القيمة True، يتم توسيع معدل التعلم بواسطة الجذر التربيعي للمتوسط - relative_step (
bool، اختياري، القيمة الافتراضيةTrue) — إذا كانت القيمة True، يتم حساب معدل التعلم المعتمد على الوقت بدلاً من معدل التعلم الخارجي - warmup_init (
bool، اختياري، القيمة الافتراضيةFalse) — يعتمد حساب معدل التعلم المعتمد على الزمن على ما إذا كان يتم استخدام تهيئة الإحماء
يمكن استخدام التنفيذ الخاص بـ AdaFactor في PyTorch كبديل جاهز للاستخدام مباشرةً عن كود fairseq الأصلي الخاص بـ Adam: https://github.com/pytorch/fairseq/blob/master/fairseq/optim/adafactor.py
الورقة: Adafactor: Adaptive Learning Rates with Sublinear Memory Cost https://huggingface.co/papers/1804.04235 لاحظ أن هذا المُحسِّن يضبط معدل التعلم داخلياً بناءً على خيارات scale_parameter وrelative_step وwarmup_init. لاستخدام جدول معدل تعلم يدوي (خارجي)، يجب عليك تعيين scale_parameter=False وrelative_step=False.
تعتمد هذه النسخة على التعامل مع قيم الدقة المنخفضة (FP16، bfloat)، لكننا لم نجرِ اختبارات شاملة لها.
إعدادات الضبط الدقيق الموصى بها لـ T5 (https://discuss.huggingface.co/t/t5-finetuning-tips/684/3):
لا يُوصى بالتدريب دون استخدام LR warmup أو clip_threshold.
- استخدام التسخين المجدول لمعدل التعلم للانتقال إلى معدل تعلم ثابت
- استخدم clip_threshold=1.0 (https://huggingface.co/papers/1804.04235)
تعطيل التحديثات النسبية
استخدم scale_parameter=False
يجب عدم استخدام عمليات المُحسِّن الإضافية مثل قص التدرّجات بالتزامن مع Adafactor
مثال:
Adafactor(model.parameters(), scale_parameter=False, relative_step=False, warmup_init=False, lr=1e-3)أفاد آخرون بأنّ التوليف التالي يعمل بشكل جيد:
Adafactor(model.parameters(), scale_parameter=True, relative_step=True, warmup_init=True, lr=None)عند استخدام lr=None مع Trainer، ستحتاج على الأرجح إلى استخدام AdafactorSchedule
المجدول على النحو التالي:
from transformers.optimization import Adafactor, AdafactorSchedule

optimizer = Adafactor(model.parameters(), scale_parameter=True, relative_step=True, warmup_init=True, lr=None)
lr_scheduler = AdafactorSchedule(optimizer)
trainer = Trainer(..., optimizers=(optimizer, lr_scheduler))
طريقة الاستخدام:
# replace AdamW with Adafactor
optimizer = Adafactor(
    model.parameters(),
    lr=1e-3,
    eps=(1e-30, 1e-3),
    clip_threshold=1.0,
    decay_rate=-0.8,
    beta1=None,
    weight_decay=0.0,
    relative_step=False,
    scale_parameter=False,
    warmup_init=False,
)
خطوة
< source >( closure = None )
يُنفّذ خطوة تحسين واحدة
الجدول
SchedulerType
فئة transformers.SchedulerType
< source >( valuenames = Nonemodule = Nonequalname = Nonetype = Nonestart = 1boundary = None )
أسماء المجدولات (Schedulers) للمعامل lr_scheduler_type في TrainingArguments.
افتراضياً، يتم استخدام "linear". داخلياً، يسترجع هذا المجدول get_linear_schedule_with_warmup من Trainer.
أنواع المجدولات:
- “linear” = get_linear_schedule_with_warmup()
- “cosine” = get_cosine_schedule_with_warmup()
- “cosine_with_restarts” = get_cosine_with_hard_restarts_schedule_with_warmup()
- “polynomial” = get_polynomial_decay_schedule_with_warmup()
- “constant” = get_constant_schedule()
- “constant_with_warmup” = get_constant_schedule_with_warmup()
- “inverse_sqrt” = get_inverse_sqrt_schedule()
- “reduce_lr_on_plateau” = get_reduce_on_plateau_schedule()
- “cosine_with_min_lr” = get_cosine_with_min_lr_schedule_with_warmup()
- “cosine_warmup_with_min_lr” = get_cosine_with_min_lr_schedule_with_warmup_lr_rate()
- “warmup_stable_decay” = get_wsd_schedule()
- “greedy” = get_greedy_schedule()
get_scheduler
transformers.get_scheduler
< source >( name: str | SchedulerTypeoptimizer: Optimizernum_warmup_steps: int | None = Nonenum_training_steps: int | None = Nonescheduler_specific_kwargs: dict | None = None )
المعاملات
- name (
strأوSchedulerType) — اسم المجدول (scheduler) المراد استخدامه. - optimizer (
torch.optim.Optimizer) — المُحسِّن الذي سيُستخدم أثناء التدريب. - num_warmup_steps (
int, اختياري) — عدد خطوات الإحماء التي يجب تنفيذها. لا تتطلب جميع مجدولات التعلم هذا المعامل (ولهذا السبب يكون الاختياري)، وسيُطلق الدالة خطأً إذا لم يُضبط وكان نوع المجدول يتطلبه. - num_training_steps (`int“, اختياري) — عدد خطوات التدريب المطلوب تنفيذها. لا تتطلب جميع مجدوليات التعلم هذا المعامل (ولهذا السبب يكون اختياريًا)، وسيُطلق الدالة خطأً إذا لم يُضبط وكان نوع المجدول يتطلبه.
- scheduler_specific_kwargs (
dict، اختياري) — معاملات إضافية لمجدولات مثل cosine with restarts. إذا لم تتطابق أنواع المجدول مع معاملات المجدول، فسيؤدي ذلك إلى رفع استثناء TypeError من دالة المجدول.
واجهة موحدة للحصول على أي مجدول من اسمه.
get_constant_schedule
transformers.get_constant_schedule
< source >( optimizer: Optimizerlast_epoch: int = -1 )
أنشئ جدولاً بمعدل تعلّم ثابت، باستخدام معدل التعلّم المُعيَّن في المُحسِّن.
get_constant_schedule_with_warmup
transformers.get_constant_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intlast_epoch: int = -1 )
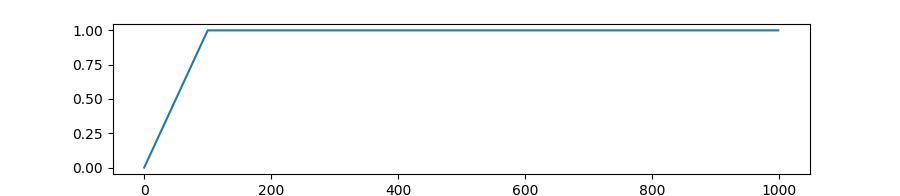
أنشئ جدولاً بمعدل تعلّم ثابت يسبقه فترة إحماء يتزايد فيها معدل التعلّم خطياً بين 0 ومعدل التعلّم الأولي المُعيّن في المُحسِّن.
get_cosine_schedule_with_warmup
transformers.get_cosine_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1 )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - num_warmup_steps (
int) — عدد الخطوات في مرحلة الإحماء. - num_training_steps (
int) — إجمالي عدد خطوات التدريب. - num_cycles (
float، اختياري، القيمة الافتراضية 0.5) — عدد الموجات في الجدول الجيبية (القيمة الافتراضية هي الانخفاض من القيمة القصوى إلى 0 وفقاً لنصف جيب). - last_epoch (
int، اختياري، القيمة الافتراضية -1) — مؤشر آخر حقبة عند استئناف التدريب.
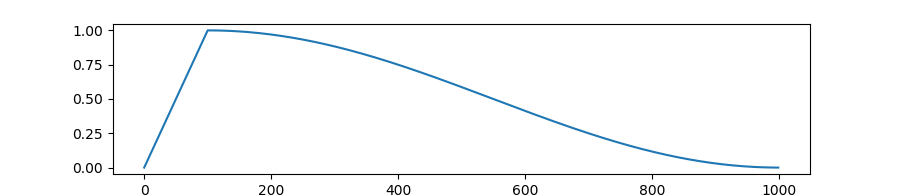
أنشئ جدولاً بمعدل تعلّم يتناقص وفق قيم دالة جيب التمام (cosine) بين قيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن (optimizer) وقيمة 0، وذلك بعد فترة إحماء (warmup) يتزايد فيها المعدل خطياً بين 0 وقيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن.
get_cosine_with_hard_restarts_schedule_with_warmup
transformers.get_cosine_with_hard_restarts_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: int = 1last_epoch: int = -1 )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - num_warmup_steps (
int) — عدد الخطوات في مرحلة الإحماء. - num_training_steps (
int) — إجمالي عدد خطوات التدريب. - num_cycles (
int، اختياري، القيمة الافتراضية 1) — عدد مرات إعادة التشغيل الصارمة المستخدمة. - last_epoch (
int، اختياري، القيمة الافتراضية -1) — مؤشر آخر حقبة عند استئناف التدريب.
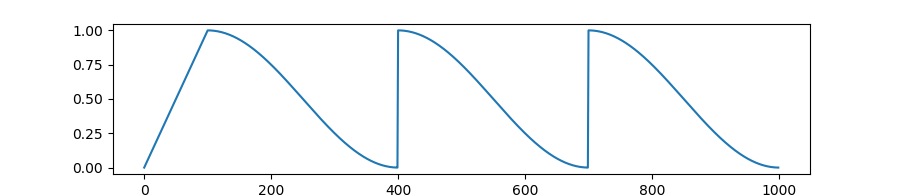
أنشئ جدولاً بمعدل تعلّم يتناقص وفق قيم دالة جيب التمام (cosine) بين قيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن (optimizer) وقيمة 0، مع عدة إعادة تشغيلات قسرية (hard restarts)، وذلك بعد فترة إحماء (warmup) يتزايد فيها المعدل خطياً بين 0 وقيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن.
get_cosine_with_min_lr_schedule_with_warmup
transformers.get_cosine_with_min_lr_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1min_lr: float | None = Nonemin_lr_rate: float | None = None )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - num_warmup_steps (
int) — عدد الخطوات في مرحلة الإحماء. - num_training_steps (
int) — إجمالي عدد خطوات التدريب. - num_cycles (
float، اختياري، القيمة الافتراضية 0.5) — عدد الموجات في الجدول الجيبية (القيمة الافتراضية هي الانخفاض من القيمة القصوى إلى 0 وفقاً لنصف جيب). - last_epoch (
int، اختياري، القيمة الافتراضية -1) — مؤشر آخر حقبة عند استئناف التدريب. - min_lr (
float، اختياري) — أدنى معدل تعلّم يجب الوصول إليه بعد جدول جيب التمام. - min_lr_rate (
float, اختياري) — معدل التعلم الأدنى كنسبة من معدل التعلم الأولي. إذا تم ضبطه، فلا ينبغي ضبطmin_lr.
أنشئ جدولاً بمعدل تعلّم يتناقص وفقاً لقيم دالة جيب التمام (cosine) بين قيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن (optimizer) وقيمة min_lr، وذلك بعد فترة إحماء (warmup) يتزايد فيها المعدل خطياً بين 0 وقيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن.
get_cosine_with_min_lr_schedule_with_warmup_lr_rate
transformers.get_cosine_with_min_lr_schedule_with_warmup_lr_rate
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1min_lr: float | None = Nonemin_lr_rate: float | None = Nonewarmup_lr_rate: float | None = None )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - num_warmup_steps (
int) — عدد الخطوات في مرحلة الإحماء. - num_training_steps (
int) — إجمالي عدد خطوات التدريب. - num_cycles (
float، اختياري، القيمة الافتراضية 0.5) — عدد الموجات في الجدول الجيبية (القيمة الافتراضية هي الانخفاض من القيمة القصوى إلى 0 وفقاً لنصف جيب). - last_epoch (
int، اختياري، القيمة الافتراضية -1) — مؤشر آخر حقبة عند استئناف التدريب. - min_lr (
float، اختياري) — أدنى معدل تعلّم يجب الوصول إليه بعد جدول جيب التمام. - min_lr_rate (
float, اختياري) — معدل التعلم الأدنى كنسبة من معدل التعلم الأولي. إذا تم ضبطه، فلا ينبغي ضبطmin_lr. - warmup_lr_rate (
float, اختياري) — أدنى معدل تعلّم كنسبة من معدل التعلّم الابتدائي. إذا لم يُضبط، يُعاملwarmup_lr_rateعلى أنه float(1/num_warmup_steps).
أنشئ جدولاً بمعدل تعلّم يتناقص وفقاً لقيم دالة جيب التمام (cosine) بين قيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن (optimizer) وقيمة min_lr، وذلك بعد فترة إحماء (warmup) يتزايد فيها المعدل خطياً بين 0 وقيمة معدل التعلّم الابتدائي المُعيّنة في المُحسِّن.
GreedyLR
فئة transformers.GreedyLR
< source >( optimizer: Optimizermode: str = 'min'factor: float = 0.95patience: int = 10threshold: float = 1e-06threshold_mode: str = 'abs'cooldown: int = 0warmup: int = 0min_lr: float | list[float] = 0.001max_lr: float | list[float] = 1.0eps: float = 1e-08verbose: bool = Falsesmooth: bool = Falsewindow_size: int = 50reset_start: int = 500 )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - mode (
str، اختياري، القيمة الافتراضية"min") — إما ‘min’ أو ‘max’. في وضع ‘min’، يتم تقليل معدل التعلم عندما يتوقف المقياس عن الانخفاض؛ وفي وضع ‘max’ عندما يتوقف عن الارتفاع. - factor (
float, اختياري، القيمة الافتراضية 0.95) — المعامل الذي تُضبط به نسبة التعلم. تُضرب نسبة التعلم في المعامل عند الوصول إلى حالة الركود، وتُقسم على المعامل عند حدوث تحسن. يجب أن يكون أقل من 1.0. - patience (
int، اختياري، القيمة الافتراضية 10) — عدد الفترات التدريبية (epochs) التي لا يحدث فيها أي تحسن، وبعد انقضائها يتم تعديل معدل التعلم. - threshold (
float، اختياري، القيمة الافتراضية 1e-06) — العتبة المستخدمة لقياس القيمة المثلى الجديدة. - threshold_mode (
str، اختياري، القيمة الافتراضية"abs") — إما ‘rel’ أو ‘abs’. - cooldown (
int، اختياري، القيمة الافتراضية 0) — عدد الفترات الزمنية (epochs) التي يجب الانتظار قبل استئناف العمل الطبيعي بعد خفض معدل التعلم. - warmup (
int، اختياري، القيمة الافتراضية 0) — عدد الفترات الزمنية (epochs) التي يجب انتظارها قبل استئناف العمل الطبيعي بعد زيادة معدل التعلم. - min_lr (
floatأوlist[float]، اختياري، القيمة الافتراضية 0.001) — حد أدنى لمعدل التعلم. - max_lr (
floatأوlist[float]، اختياري، القيمة الافتراضية 1.0) — حد أعلى لمعدل التعلم. - eps (
float، اختياري، القيمة الافتراضية 1e-08) — أدنى مقدار للتلاشي يُطبَّق على lr. - verbose (
bool، اختياري، القيمة الافتراضيةFalse) — إذا كانت القيمة True، يتم طباعة رسالة إلى stdout عند كل تحديث. - smooth (
bool، اختياري، القيمة الافتراضيةFalse) — إذا كانت القيمة True، يتم تطبيق تنعيم متوسط التدفق على المقاييس. - window_size (
int، اختياري، القيمة الافتراضية 50) — حجم النافذة للمتوسط المتدفق عندما تكون smooth=True. - reset_start (
int، اختياري، القيمة الافتراضية 500) — عدد الخطوات التي يجب انتظارها عند min_lr قبل إعادة التعيين إلى الحالة الأولية.
جدول معدل تعلّم تكيفي يستجيب لمقاييس التدريب.
يُعدّل GreedyLR معدل التعلم ديناميكيًا بناءً على أداء التدريب:
- يزيد معدل التعلم عندما تتحسن المقاييس بشكل متسق (يقسم على عامل)
- يُقلّل معدل التعلم عندما تستقر المقاييس (يُضرب في عامل)
يختلف هذا عن مجدولات تقليدية مثل التبريد الجيبية (cosine annealing) من خلال الاستجابة لديناميكيات التدريب الفعلية بدلاً من اتباع جدول مسبق التحديد.
مرجع: GreedyLR: A Novel Adaptive Learning Rate Scheduler <https://arxiv.org/abs/2512.14527>_
مثال:
>>> optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
>>> scheduler = GreedyLR(optimizer, mode="min", patience=10)
>>> for epoch in range(100):
...     train(...)
...     val_loss = validate(...)
... scheduler.step(val_loss)إرجاع معدل التعلم المحسوب أخيرًا بواسطة المجدول الحالي.
تحميل الحالة من قاموس.
إرجاع حالة المجدول على شكل قاموس.
خطوة
< source >( metrics: floatepoch: int | None = None )
أداء خطوة المجدول بناءً على المقاييس المعطاة.
get_greedy_schedule
transformers.get_greedy_schedule
< source >( optimizer: Optimizer**kwargs )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - kwargs (
dict، اختياري) — معاملات إضافية تُمرَّر إلى المجدول. راجع GreedyLR لمعرفة المعاملات الممكنة.
أنشئ جدولة معدل تعلّم تكيفية تُعدّل LR بناءً على مقاييس التدريب.
get_linear_schedule_with_warmup
transformers.get_linear_schedule_with_warmup
< source >( optimizernum_warmup_stepsnum_training_stepslast_epoch = -1 )
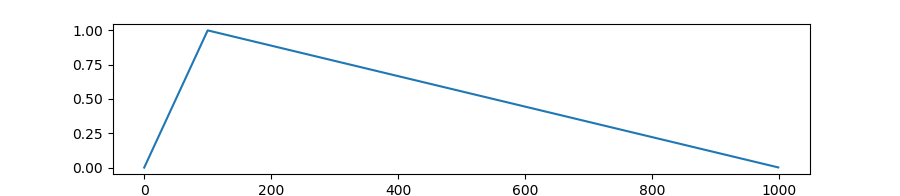
أنشئ جدولاً بمعدل تعلّم ينخفض خطياً من قيمة lr الأولية المُعيّنة في المُحسِّن إلى 0، بعد فترة إحماء تزداد فيها القيمة خطياً من 0 إلى قيمة lr الأولية المُعيّنة في المُحسِّن.
get_polynomial_decay_schedule_with_warmup
transformers.get_polynomial_decay_schedule_with_warmup
< source >( optimizernum_warmup_stepsnum_training_stepslr_end = 1e-07power = 1.0last_epoch = -1 )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - num_warmup_steps (
int) — عدد الخطوات في مرحلة الإحماء. - num_training_steps (
int) — إجمالي عدد خطوات التدريب. - lr_end (
float، اختياري، القيمة الافتراضية 1e-7) — معدل التعلم النهائي. - power (
float، اختياري، القيمة الافتراضية 1.0) — معامل القوة. - last_epoch (
int، اختياري، القيمة الافتراضية -1) — مؤشر آخر حقبة عند استئناف التدريب.
أنشئ جدولاً بمعدل تعلّم يتناقص بتلاشي متعدد الحدود من معدل التعلّم الابتدائي المُعيَّن في المُحسِّن إلى معدل التعلّم النهائي المُعرَّف بواسطة lr_end، بعد فترة إحماء يتزايد فيها خطياً من 0 إلى معدل التعلّم الابتدائي المُعيَّن في المُحسِّن.
ملاحظة: القيمة الافتراضية لـ power هي 1.0 كما في تطبيق fairseq، والذي يعتمد بدوره على تطبيق BERT الأصلي الموجود في https://github.com/google-research/bert/blob/f39e881b169b9d53bea03d2d341b31707a6c052b/optimization.py#L37
get_inverse_sqrt_schedule
transformers.get_inverse_sqrt_schedule
< source >( optimizer: Optimizernum_warmup_steps: inttimescale: int | None = Nonelast_epoch: int = -1 )
المعاملات
أنشئ جدولاً بمعدل تعلّم يتناسب عكسياً مع الجذر التربيعي، بدءاً من معدل التعلّم الأولي المُعيَّن في المُحسِّن، بعد فترة إحماء تزيد معدل التعلّم خطياً من 0 إلى معدل التعلّم الأولي المُعيَّن في المُحسِّن.
get_reduce_on_plateau_schedule
transformers.get_reduce_on_plateau_schedule
< source >( optimizer: Optimizer**kwargs )
أنشئ جدولاً بمعدل تعلّم ثابت ينخفض عندما يتوقف أحد المقاييس عن التحسّن.
get_wsd_schedule
transformers.get_wsd_schedule
< source >( optimizer: Optimizernum_warmup_steps: intnum_decay_steps: intnum_training_steps: int | None = Nonenum_stable_steps: int | None = Nonewarmup_type: str = 'linear'decay_type: str = 'cosine'min_lr_ratio: float = 0num_cycles: float = 0.5last_epoch: int = -1 )
المعاملات
- optimizer (
~torch.optim.Optimizer) — المُحسِّن الذي سيتم جدولة معدل التعلم له. - num_warmup_steps (
int) — عدد الخطوات في مرحلة الإحماء. - num_decay_steps (
int) — عدد الخطوات في مرحلة الاضمحلال. - num_training_steps (
int, اختياري) — إجمالي عدد خطوات التدريب. وهو مجموع خطوات الإحماء والاستقرار والتلاشي. إذا لم يُقدَّمnum_stable_steps، فستكون مرحلة الاستقرارnum_training_steps - num_warmup_steps - num_decay_steps. - num_stable_steps (
int, اختياري) — عدد الخطوات في المرحلة المستقرة. يرجى التأكد من أنnum_warmup_steps + num_stable_steps + num_decay_stepsيساويnum_training_steps، وإلا فإن الخطوات الأخرى ستعتمد معدل التعلم الأدنى افتراضيًا. - warmup_type (
str، اختياري، الافتراضي “linear”) — نوع الإحماء المستخدم. يمكن أن يكون ‘linear’ أو ‘cosine’ أو ‘1-sqrt’. - decay_type (
str، اختياري، القيمة الافتراضية “cosine”) — نوع التلاشي المستخدم. يمكن أن يكون ‘linear’ أو ‘cosine’ أو ‘1-sqrt’. - min_lr_ratio (
float، اختياري، القيمة الافتراضية 0) — نسبة معدل التعلم الأدنى إلى معدل التعلم الأولي. - num_cycles (
float، اختياري، القيمة الافتراضية 0.5) — عدد الموجات في الجدول الجيبية (القيمة الافتراضية هي الانخفاض من القيمة القصوى إلى 0 وفقاً لنصف جيب). - last_epoch (
int، اختياري، القيمة الافتراضية -1) — مؤشر آخر حقبة عند استئناف التدريب.
أنشئ جدولاً بمعدل تعلّم يتكوّن من ثلاث مراحل:
- warmup: زيادة من min_lr_ratio مضروباً في معدل التعلم الأولي إلى معدل التعلم الأولي وفقاً لـ warmup_type.
- stable: معدل تعلّم ثابت.
- decay: انخفاض من معدل التعلم الأولي إلى min_lr_ratio من معدل التعلم الأولي وفقاً لنوع الاضمحلال decay_type.