Transformers documentation
طرق التوازي
طرق التوازي
تُعدّ التكوينات متعددة وحدات معالجة الرسوميات (GPU) فعّالة لتسريع التدريب وإدخال النماذج الكبيرة في الذاكرة، والتي لا يمكن استيعابها على وحدة معالجة رسوميات واحدة. وتعتمد هذه التكوينات على موازاة الحمل العملي عبر وحدات معالجة الرسوميات. وهناك عدة أنواع من الموازاة، مثل موازاة البيانات، وموازاة الموترات، وموازاة خط الأنابيب، وموازاة النموذج. ويقسم كل نوع من أنواع الموازاة الحمل العملي بطريقة مختلفة، سواء أكان ذلك على مستوى البيانات أم على مستوى النموذج.
ستتناول هذه الدليل طرق التوازي المختلفة، وكيفية دمجها، واختيار الاستراتيجية المناسبة لإعدادك. لمزيد من التفاصيل حول التدريب الموزّع، راجع وثائق Accelerate.
للاطلاع على دليل شامل حول توسيع نماذج اللغة الكبيرة، راجع Ultrascale Playbook، الذي يوفر استراتيجيات وممارسات مفصّلة وأفضل الأساليب للتدريب على نطاق واسع.
استراتيجية القابلية للتوسع
استخدم حاسبة ذاكرة النموذج لحساب مقدار الذاكرة التي يتطلبها النموذج. ثم ارجع إلى الجدول أدناه لاختيار استراتيجية بناءً على إعدادك.
| الإعداد | السيناريو | استراتيجية |
|---|---|---|
| عقدة واحدة/أكثر من وحدة معالجة رسومية | يتسع على وحدة معالجة رسومية واحدة | DistributedDataParallel أو ZeRO |
| لا يتسع على وحدة معالجة رسومية واحدة | PipelineParallel أو ZeRO أو TensorParallel | |
| لا يتسع أكبر طبقة في النموذج | TensorParallel أو ZeRO | |
| عقدة متعددة/وحدة معالجة رسومية متعددة | اتصال سريع بين العقد (NVLink أو NVSwitch) | ZeRO أو التوازي ثلاثي الأبعاد (PipelineParallel، TensorParallel، DataParallel) |
| بطء الاتصال بين العقد | ZeRO أو التوازي ثلاثي الأبعاد (PipelineParallel، TensorParallel، DataParallel) |
التوازي في البيانات
يوزّع توازّي البيانات البيانات بالتساوي على وحدات معالجة رسومية متعددة. تحتفظ كل وحدة معالجة رسومية بنسخة من النموذج وتعالج حصتها من البيانات بشكل متزامن. وفي النهاية، يتم مزامنة النتائج من كل وحدة معالجة رسومية ودمجها.
يُقلّل توازٍ البيانات بشكل كبير من زمن التدريب من خلال معالجة البيانات بالتوازي، وهو قابل للتوسع حسب عدد وحدات معالجة الرسوميات المتاحة. ومع ذلك، قد يؤدي مزامنة النتائج من كل وحدة معالجة رسوميات إلى إضافة عبء إضافي.
هناك نوعان من توازي البيانات: DataParallel (DP) وDistributedDataParallel (DDP).
DataParallel
يدعم DataParallel التدريب الموزّع على جهاز واحد مزوّد بعدة وحدات معالجة رسومية (GPU).
- تقرأ وحدة المعالجة الرسومية الافتراضية،
GPU 0، دفعة من البيانات وتُرسل جزءاً صغيراً منها إلى وحدات المعالجة الرسومية الأخرى. - يتم تكرار نموذج محدّث من
GPU 0إلى وحدات المعالجة الرسومية الأخرى. - يتم تنفيذ تمرير
forwardعلى كل وحدة معالجة رسومية، ثم تُرسل مخرجاتها إلىGPU 0لحساب الخسارة. - توزَّع الدالة الخاسرة من
GPU 0إلى وحدات المعالجة الرسومية الأخرى لمرحلةbackward. - تُرسل التدرجات من كل وحدة معالجة رسومية إلى
GPU 0ثم تُحسب قيمتها المتوسطة.
DistributedDataParallel
يدعم DistributedDataParallel التدريب الموزّع عبر أجهزة متعددة مزوّدة بعدة وحدات معالجة رسومية.
- ينسخ العملية الرئيسية النموذج من وحدة المعالجة الرسومية الافتراضية،
GPU 0، إلى كل وحدة معالجة رسومية. - تعالج كل وحدة معالجة رسومية (GPU) دفعة مصغّرة من البيانات مباشرةً.
- تُمتَّص التدرجات المحلية عبر جميع وحدات معالجة الرسوميات (GPU) أثناء عملية
backward.
يُوصى بـ DDP لأنه يقلل من عبء الاتصال بين وحدات معالجة الرسوميات، ويستخدم كل وحدة معالجة رسوميات بكفاءة، ويتوسع ليشمل أكثر من جهاز واحد.
توازي البيانات في ZeRO
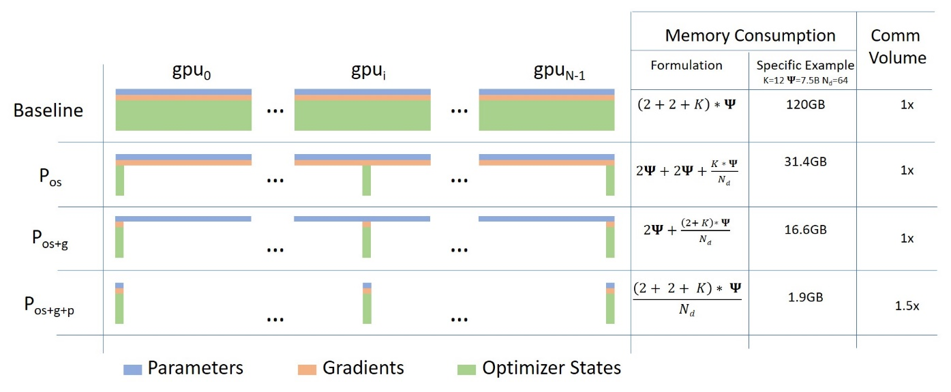
Zero Redundancy Optimizer هو نوع أكثر كفاءة في استخدام الذاكرة من توازٍ البيانات. فهو يحسّن كفاءة استخدام الذاكرة بشكل كبير من خلال تقسيم المعاملات والتدرجات وحالات المُحسّن عبر عمليات توازٍ البيانات لتقليل استهلاك الذاكرة. هناك ثلاث مراحل من ZeRO:
- يقوم المرحلة 1 بتقسيم حالات المُحسِّن
- يقسم Stage 2 حالة المُحسِّن والتدرّجات
- يقوم المرحلة 3 بتقسيم المُحسِّن والتدرّجات والمعاملات
توازي النموذج
يوزّع توازّي النموذج نموذجًا على وحدات معالجة رسومية متعددة. هناك عدة طرق لتقسيم النموذج، لكن الطريقة النموذجية توزّع طبقات النموذج على وحدات المعالجة الرسومية. في مسار forward، تعالج وحدة المعالجة الرسومية الأولى دفعة من البيانات ثم تمررها إلى مجموعة الطبقات التالية على وحدة المعالجة الرسومية التالية. أما في مسار backward، فتُرسل البيانات عكسيًا من الطبقة الأخيرة إلى الطبقة الأولى.
يُعدّ توازي النماذج استراتيجية مفيدة لتدريب نماذج كبيرة الحجم لا تتسع في ذاكرة وحدة معالجة رسومية واحدة. ومع ذلك، فإن استغلال وحدات المعالجة الرسومية غير متوازن، إذ تكون وحدة واحدة فقط نشطة في كل مرة. كما أن نقل النتائج بين وحدات المعالجة الرسومية يضيف عبئاً على الاتصالات، وقد يصبح عنقاً زجالياً.
توازي خط الأنابيب
يُشبه توازي خط الأنابيب (Pipeline parallelism) من حيث المفهوم توازي النموذج (Model parallelism) إلى حد كبير، لكنه أكثر كفاءة لأنه يقلل من وقت خمول وحدات معالجة الرسوميات (GPU). فبدلاً من الانتظار حتى تنتهي كل وحدة معالجة رسومات من معالجة دفعة (batch) من البيانات، يقوم توازي خط الأنابيب بإنشاء دفعات مصغّرة (micro-batches) من البيانات. وبمجرد اكتمال معالجة دفعة مصغّرة واحدة، تُمرَّر إلى وحدة معالجة الرسومات التالية. وبهذه الطريقة، يمكن لكل وحدة معالجة رسومات أن تعالج جزءاً من البيانات بشكل متوازٍ دون انتظار اكتمال معالجة وحدة الرسومات الأخرى لدفعة مصغّرة من البيانات بالكامل.
تشارك موازاة خط الأنابيب (Pipeline parallelism) المزايا ذاتها التي تتمتع بها موازاة النموذج (Model parallelism)، لكنها تحسّن من استغلال وحدات معالجة الرسوميات (GPU) وتقلّل من أوقات الخمول. ومع ذلك، قد تكون موازاة خط الأنابيب أكثر تعقيداً، إذ قد يتعيّن إعادة كتابة النماذج على شكل تسلسل من وحدات nn.Sequential، كما أنه لا يمكن القضاء تماماً على أوقات الخمول، لأن مرور forward الأخير يجب أن ينتهي أيضاً إلى أن يكتمل مرور backward.
توازي الموتر
يوزّع توازّي الموترات (Tensor parallelism) عمليات الحساب على الموترات الكبيرة عبر وحدات معالجة رسومية متعددة. تُقسَّم الموترات أفقيًا أو رأسيًا، وتُعالَج كل شريحة بواسطة وحدة معالجة رسومية مستقلة. تقوم كل وحدة معالجة رسومية بتنفيذ عمليات الحساب على شريحتها من الموتر، ثم تُزامَن النتائج في النهاية لإعادة بناء النتيجة النهائية.
يُعدّ توازي الموترات (Tensor parallelism) فعّالاً لتدريب النماذج الكبيرة التي لا تتسع في ذاكرة وحدة معالجة رسومية واحدة. كما أنه أسرع وأكثر كفاءة، إذ يمكن لكل وحدة معالجة رسومية معالجة شريحة الموترات الخاصة بها بالتوازي، ويمكن دمجه مع طرق توازي أخرى. ومع ذلك، مثل بقية طرق التوازي، يضيف توازي الموترات عبئاً إضافياً على التواصل بين وحدات المعالجة الرسومية.
راجع دليل التوازي على مستوى الموترات لمعرفة كيفية استخدامه للاستدلال.
التوازي الهجين
يمكن دمج طرق التوازي لتحقيق توفير أكبر في الذاكرة وتدريب نماذج تحتوي على مليارات المعلمات بكفاءة أعلى.
التوازي في البيانات والتوازي في خط الأنابيب
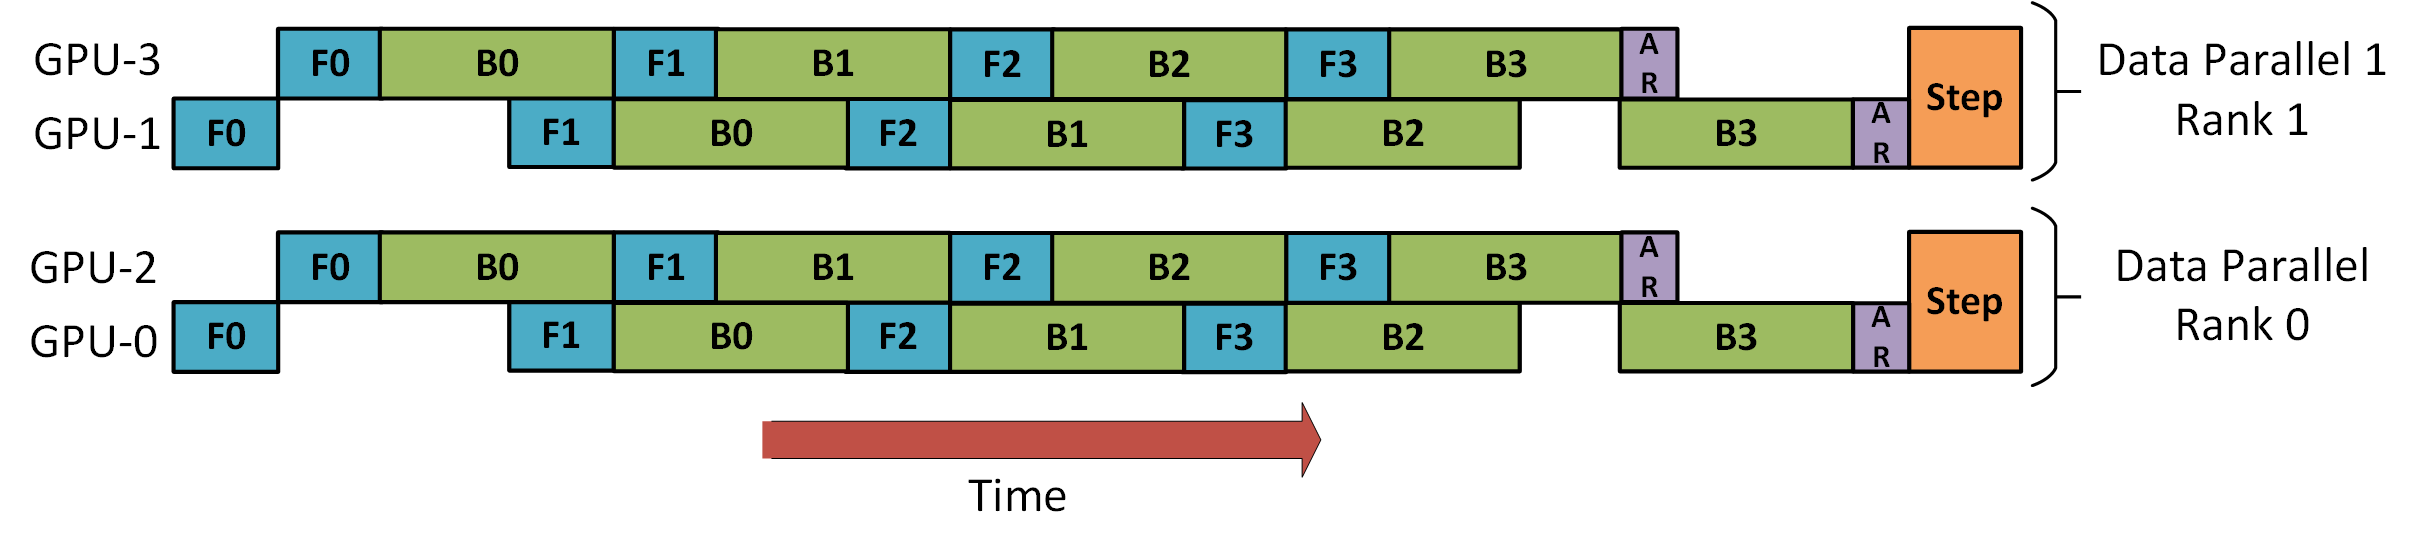
يوزّع توازٍ البيانات والخطّية البيانات على وحدات معالجة الرسوميات (GPUs) ويقسم كل دفعة مصغّرة من البيانات إلى دفعات مجهرية لتحقيق توازٍ الخطّية.
يعامل كل رتبة من رتب توازي البيانات العملية وكأنه لا يوجد سوى وحدة معالجة رسومية واحدة بدلاً من وحدتين، لكن يمكن لوحدتي المعالجة الرسومية 0 و1 تفريغ دفعات البيانات الجزئية إلى وحدتي المعالجة الرسومية 2 و3 لتقليل وقت الخمول.
تُحسّن هذه الطريقة معالجة البيانات بالتوازي من خلال تقليل نسبة استخدام وحدات معالجة الرسوميات أثناء الخمول.
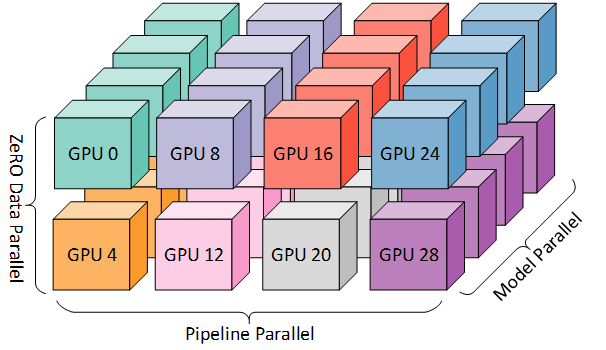
توازي بيانات ZeRO، وتوازي خط الأنابيب، وتوازي النموذج (توازي ثلاثي الأبعاد)
تتضافر موازاة البيانات، وموازاة خط المعالجة، وموازاة النموذج لتشكيل الموازاة ثلاثية الأبعاد بغرض تحسين كفاءة الذاكرة والحوسبة.
يُحَقَّق الكفاءة في استخدام الذاكرة من خلال تقسيم النموذج على وحدات معالجة الرسوميات (GPUs) وقسمته أيضاً إلى مراحل لإنشاء خط أنابيب. وهذا يتيح لوحدات معالجة الرسوميات العمل بالتوازي على دفعات بيانات مصغّرة، مما يقلّل من استهلاك الذاكرة للنموذج والمُحسِّن (optimizer) والتفعيلات (activations).
تُفعَّل كفاءة الحساب من خلال توازٍ البيانات في ZeRO، حيث يخزّن كل معالج رسومي (GPU) شريحة من النموذج والمُحسِّن والتفعيلات. وهذا يتيح عرض نطاق ترددي أعلى للتواصل بين عقد توازٍ البيانات، لأن التواصل يمكن أن يحدث بشكل مستقل أو بالتوازي مع مراحل خط الأنابيب الأخرى.
هذا النهج قابل للتوسع إلى نماذج ضخمة جداً تحتوي على تريليونات من المعاملات.