
Transformers documentation
AWQ
AWQ
Activation-aware Weight Quantization (AWQ)は、LLMの性能にとって重要な少数の重みを保持することで、性能の低下を最小限に抑えながらモデルを4ビットに圧縮します。
AWQアルゴリズムでモデルを量子化するためのライブラリはいくつかあり、llm-awq、autoawq、optimum-intelなどが挙げられます。Transformersは、llm-awqおよびautoawqライブラリで量子化されたモデルの読み込みをサポートしています。本ガイドでは、autoawqで量子化されたモデルの読み込み方法を示しますが、llm-awqで量子化されたモデルの場合も、プロセスはほぼ同様です。
以下のコマンドを実行して、autoawqをインストールします。
pip install autoawq
AutoAWQ は Transformers をバージョン 4.47.1 にダウングレードします。AutoAWQ で推論を実行する場合は、AutoAWQ のインストール後に Transformers のバージョンを再インストールする必要がある場合があります。
モデルの config.json ファイル内の quant_method キーを確認して、AWQ 量子化モデルかどうかを特定します。
{
  "_name_or_path": "/workspace/process/huggingfaceh4_zephyr-7b-alpha/source",
  "architectures": [
    "MistralForCausalLM"
  ],
  ...
  ...
  ...
  "quantization_config": {
    "quant_method": "awq",
    "zero_point": true,
    "group_size": 128,
    "bits": 4,
    "version": "gemm"
  }
}AWQ量子化モデルをfrom_pretrained()で読み込みます。パフォーマンス上の理由から、デフォルトでは他の重みがfp16に設定されます。これらの他の重みを別の形式で読み込むには、dtypeパラメータを使用します。
モデルがCPUにロードされている場合は、device_mapパラメータを使用してアクセラレータに移動します。
from transformers import AutoModelForCausalLM, AutoTokenizer
from accelerate import Accelerator
import torch

device = Accelerator().device

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/zephyr-7B-alpha-AWQ",
  dtype=torch.float32,
  device_map=device
)
attn_implementation を使用して FlashAttention2 を有効にし、推論をさらに高速化します。
from transformers import AutoModelForCausalLM, AutoTokenizer
from accelerate import Accelerator

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/zephyr-7B-alpha-AWQ",
  attn_implementation="flash_attention_2",
  device_map=Accelerator().device
)
融合モジュール
Fused modulesは、精度とパフォーマンスの向上をもたらします。LlamaおよびMistralアーキテクチャのAWQモジュールには、標準でサポートされていますが、サポートされていないアーキテクチャのAWQモジュールもフュージョンできます。
Fused modulesは、FlashAttention2などの他の最適化技術と組み合わせることはできません。
AwqConfig を作成し、fuse_max_seq_len と do_fuse=True を設定して、フュージョン済みモジュールを有効にします。fuse_max_seq_len パラメータはシーケンスの総長を指定するもので、コンテキスト長と推定される生成長を含める必要があります。安全策として、より大きな値を設定してください。
以下の例では、TheBloke/Mistral-7B-OpenOrca-AWQ モデルの AWQ モジュールを融合します。
import torch
from transformers import AwqConfig, AutoModelForCausalLM

quantization_config = AwqConfig(
    bits=4,
    fuse_max_seq_len=512,
    do_fuse=True,
)
model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/Mistral-7B-OpenOrca-AWQ",
  quantization_config=quantization_config
).to(0)
TheBloke/Mistral-7B-OpenOrca-AWQ モデルは、batch_size=1 で、fused modules を使用する場合と使用しない場合の両方でベンチマークされました。
| バッチサイズ | プリフィル長 | デコード長 | プリフィル トークン/秒 | デコードトークン/秒 | メモリ(VRAM) |
|---|---|---|---|---|---|
| 1 | 32 | 32 | 60.0984 | 38.4537 | 4.50 GB (5.68%) |
| 1 | 64 | 64 | 1333.67 | 31.6604 | 4.50 GB (5.68%) |
| 1 | 128 | 128 | 2434.06 | 31.6272 | 4.50 GB (5.68%) |
| 1 | 256 | 256 | 3072.26 | 38.1731 | 4.50 GB (5.68%) |
| 1 | 512 | 512 | 3184.74 | 31.6819 | 4.59 GB (5.80%) |
| 1 | 1024 | 1024 | 3148.18 | 36.8031 | 4.81 GB (6.07%) |
| 1 | 2048 | 2048 | 2927.33 | 35.2676 | 5.73 GB (7.23%) |
| バッチサイズ | プリフィル長 | デコード長 | プリフィル トークン/秒 | デコードトークン/秒 | メモリ(VRAM) |
|---|---|---|---|---|---|
| 1 | 32 | 32 | 81.4899 | 80.2569 | 4.00 GB (5.05%) |
| 1 | 64 | 64 | 1756.1 | 106.26 | 4.00 GB (5.05%) |
| 1 | 128 | 128 | 2479.32 | 105.631 | 4.00 GB (5.06%) |
| 1 | 256 | 256 | 1813.6 | 85.7485 | 4.01 GB (5.06%) |
| 1 | 512 | 512 | 2848.9 | 97.701 | 4.11 GB (5.19%) |
| 1 | 1024 | 1024 | 3044.35 | 87.7323 | 4.41 GB (5.57%) |
| 1 | 2048 | 2048 | 2715.11 | 89.4709 | 5.57 GB (7.04%) |
optimum-benchmark ライブラリを使用して、フュージョン済みモジュールとフュージョン未実施モジュールの速度およびスループットもテストされました。
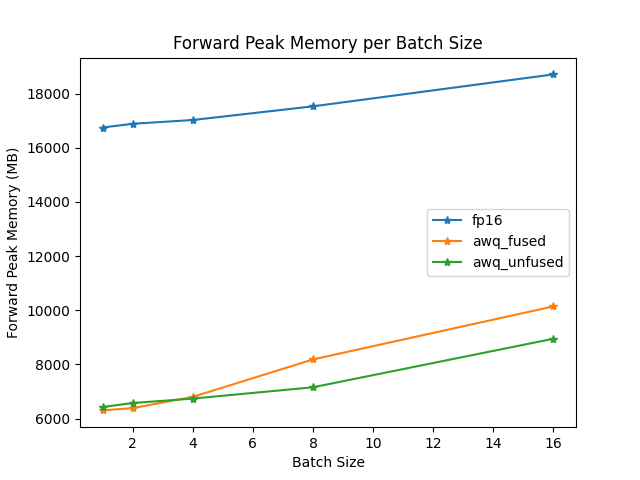
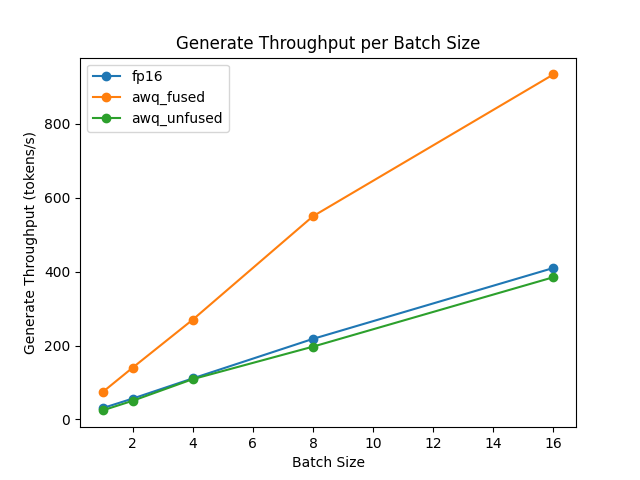
fused モジュールをサポートしないアーキテクチャでは、AwqConfig を作成し、modules_to_fuse でカスタムの fusing マッピングを定義して、どのモジュールを fuse する必要があるかを決定します。
以下の例では、TheBloke/Yi-34B-AWQ モデルの AWQ モジュールを融合します。
import torch
from transformers import AwqConfig, AutoModelForCausalLM

quantization_config = AwqConfig(
    bits=4,
    fuse_max_seq_len=512,
    modules_to_fuse={
        "attention": ["q_proj", "k_proj", "v_proj", "o_proj"],
        "layernorm": ["ln1", "ln2", "norm"],
        "mlp": ["gate_proj", "up_proj", "down_proj"],
        "use_alibi": False,
        "num_attention_heads": 56,
        "num_key_value_heads": 8,
        "hidden_size": 7168
    }
)

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/Yi-34B-AWQ",
  quantization_config=quantization_config
).to(0)
パラメータ modules_to_fuse には、以下のキーを含める必要があります。
"attention": 以下の順序で融合する attention レイヤーの名前: query、key、value、output projection レイヤー。これらのレイヤーを融合したくない場合は、空のリストを渡してください。"layernorm": 置き換えたい LayerNorm レイヤーの名称をすべて指定します。これらのレイヤーを融合させない場合は、空のリストを渡してください。"mlp": 単一の MLP レイヤーに融合したい MLP レイヤーの名前を、(gate (dense, layer, post-attention) / up / down レイヤー) の順で指定します。"use_alibi": モデルが ALiBi 位置埋め込みを使用する場合に指定します。"num_attention_heads": アテンションヘッドの数。"num_key_value_heads": Grouped Query Attention (GQA) の実装に使用する key value heads の数。パラメータの値 アテンション num_key_value_heads=num_attention_headsマルチヘッドアテンション num_key_value_heads=1Multi-Query Attention num_key_value_heads=...グループクエリアテンション "hidden_size": 隠れ表現の次元数。
ExLlamaV2
ExLlamaV2 カーネルにより、より高速なプリフィルとデコーディングがサポートされます。ExLlamaV2 対応の最新バージョンの autoawq をインストールするには、以下のコマンドを実行してください。
pip install git+https://github.com/casper-hansen/AutoAWQ.git
ExLlamaV2カーネルを有効にするには、AwqConfigでversion="exllama"を設定してください。
ExLlamaV2 は AMD GPU でサポートされています。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, AwqConfig

quantization_config = AwqConfig(version="exllama")

model = AutoModelForCausalLM.from_pretrained(
    "TheBloke/Mistral-7B-Instruct-v0.1-AWQ",
    quantization_config=quantization_config,
    device_map="auto",
)
リソース
モデルの量子化方法、量子化済みモデルを Hub にプッシュする方法など、さらに多くの例については、AWQ デモの ノートブック を実行してください。
Update on GitHub