
Transformers documentation
GGUF
GGUF
GGUFは、GGMLによる推論でモデルを保存するために使用される単一ファイル形式で、モデルのメタデータとテンソルを含みます。多くの量子化データ型をサポートしており(量子化型テーブルを参照)、メモリを大幅に節約できます。
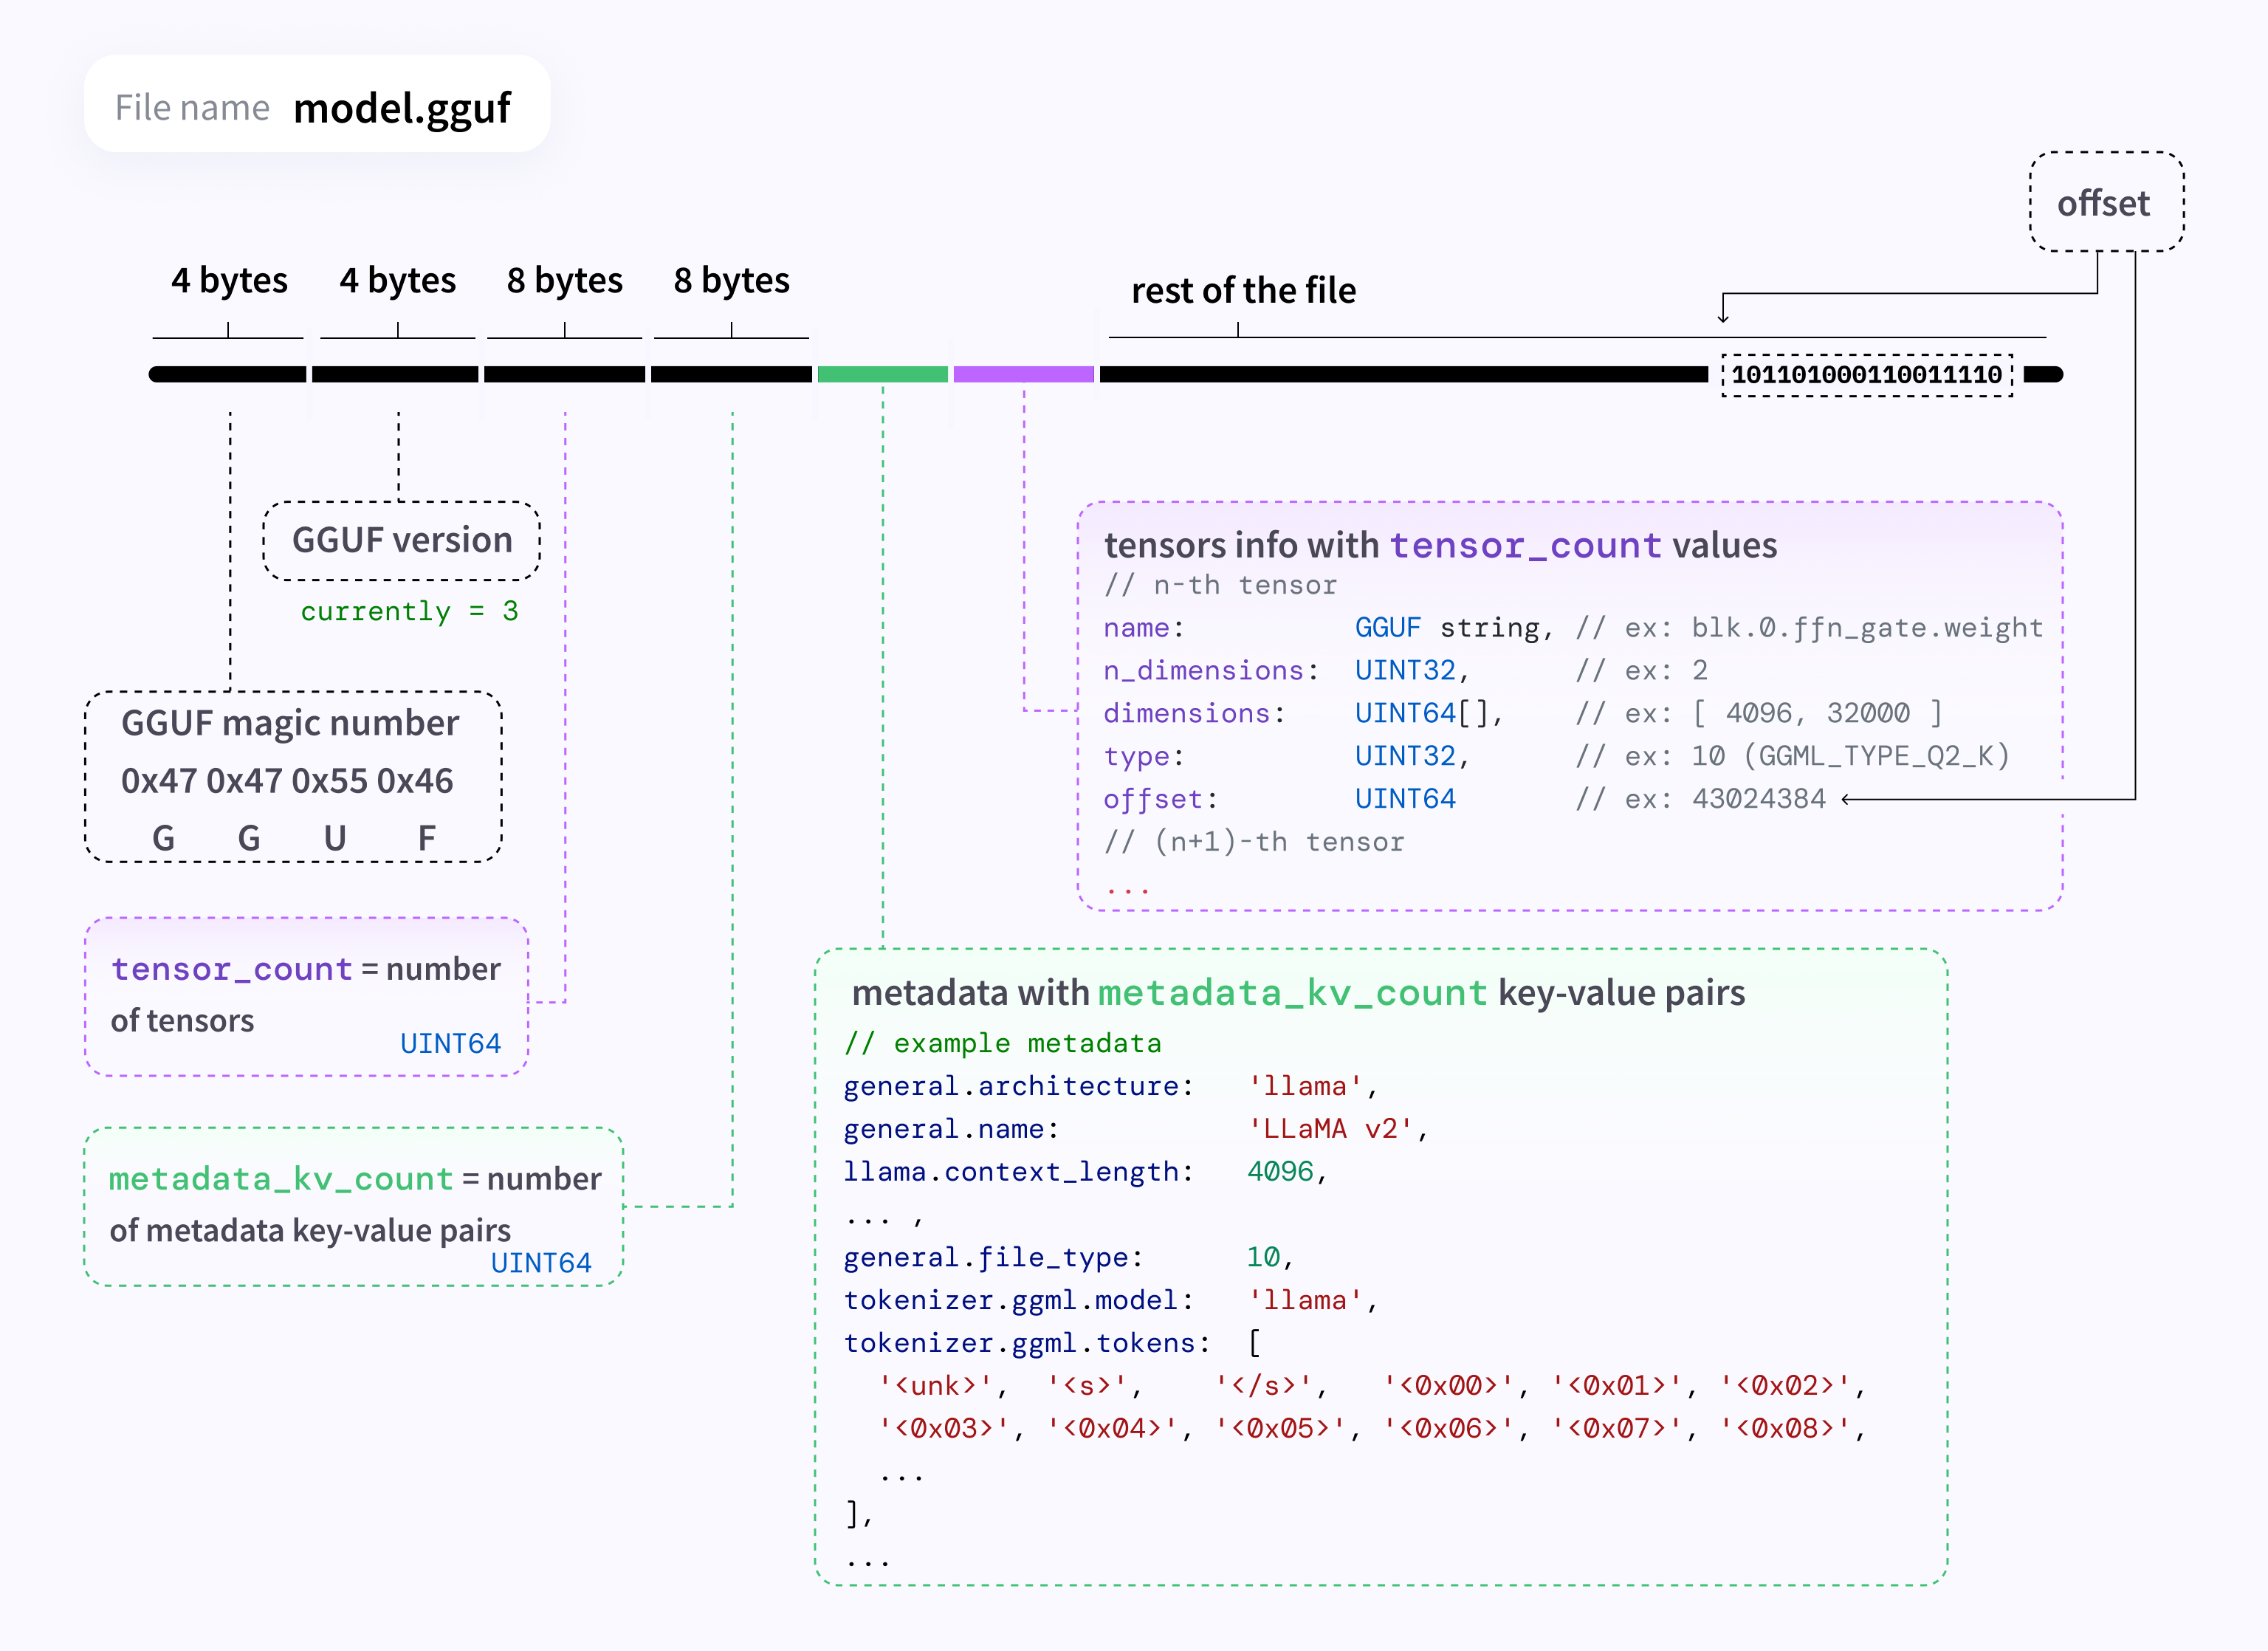
GGUFモデルの読み込み
Install kernels, otherwise the packed path falls back to full dequantization at load.
pip install kernels
Hub カーネル ggml-org/ggml-quantization が利用可能な場合、重みはパックされた状態のまま保持されます。このカーネルが存在する場合、ローダーはデフォルトで MPS を使用し、パックされたブロック上で直接 matmul を実行します。カーネルが利用できない場合、モデルはロード時にデクォンタイズされます。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=filename)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
同じロードがQwen3.5 MoEにも適用できます。
moe_model_id = "unsloth/Qwen3.5-35B-A3B-GGUF"
moe_filename = "Qwen3.5-35B-A3B-Q4_K_M.gguf"

moe_model = AutoModelForCausalLM.from_pretrained(moe_model_id, gguf_file=moe_filename)
moe_tokenizer = AutoTokenizer.from_pretrained(moe_model_id, gguf_file=moe_filename)
Packed パスでは現在、Qwen3.5 と Qwen3.5 MoE がサポートされています。MPS 上で高速であるため、Packed の読み込みでは自動的に float32 が使用されます。別の dtype を設定した場合、ローダーは警告を返します。その他のアーキテクチャは、レガシーローダー経由で処理されます。
アテンション
MPS 上でカーネルがインストールされている場合、GGUF ファイルを読み込む際のデフォルトの attention は ggml-attn です。これは llama.cpp が decode と prefill に使用しているのと同じ flash-attention カーネルです。カーネルを取得できない場合、モデルは元の attention 実装を維持します。attn_implementation(例: "sdpa")を渡す場合は、常にそれが優先されます。
明示的に渡すこともできます:
model = AutoModelForCausalLM.from_pretrained(
    model_id, gguf_file=filename, attn_implementation="ggml-org/ggml-attn"
)
Dequantize
Dequantizing は、読み込み時にすべての重みを展開し、通常の dense モデルを返します。高速な圧縮パスが適用されない場合のフォールバックとして機能します。GgufConfig を使用して明示的に指定することもできます。
import torch

from transformers import AutoModelForCausalLM, GgufConfig

quantization_config = GgufConfig(dequantize=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id, gguf_file=filename, quantization_config=quantization_config, dtype=torch.bfloat16
)指定したdtypeの通常の稠密モデルが得られます。
Qwen3.5およびQwen3.5 MoE以外のアーキテクチャは、常にデクアンタイズを行うレガシーローダーを経由します。
レガシーローダーは、Llama、Mistral、Qwen2、Qwen2Moe、Phi3、Bloom、Falcon、StableLM、GPT2、Starcoder2、およびその他をサポートしています。
サーブ
transformers serve は、リポジトリ内の各 .gguf ファイルを個別のモデルとして一覧表示します。リポジトリには複数の量子化バージョンが含まれるため、読み込む対象を特定するために、GGUF モデルの名称は <repo>:<file>.gguf という形式になります。リクエストでも同じ形式で指定します。
transformers serve unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf