
Transformers documentation
M2M100
Este modelo foi publicado no HF papers em 2020-10-21 e contribuído para o Hugging Face Transformers em 2021-03-06.
M2M100


Visão geral
O modelo M2M100 foi proposto em Beyond English-Centric Multilingual Machine Translation por Angela Fan, Shruti Bhosale, Holger Schwenk, Zhiyi Ma, Ahmed El-Kishky, Siddharth Goyal, Mandeep Baines, Onur Celebi, Guillaume Wenzek, Vishrav Chaudhary, Naman Goyal, Tom Birch, Vitaliy Liptchinsky, Sergey Edunov, Edouard Grave, Michael Auli, Armand Joulin.
O resumo do artigo é o seguinte:
Trabalhos existentes em tradução demonstraram o potencial da tradução automática massivamente multilíngue ao treinar um único modelo capaz de traduzir entre qualquer par de idiomas. No entanto, grande parte desse trabalho é centrado no inglês, pois é treinado apenas com dados que foram traduzidos do inglês ou para o inglês. Embora isso seja suportado por grandes fontes de dados de treinamento, não reflete as necessidades de tradução em todo o mundo. Neste trabalho, criamos um verdadeiro modelo de tradução multilíngue Many-to-Many que pode traduzir diretamente entre qualquer par de 100 idiomas. Construímos e disponibilizamos em código aberto um conjunto de dados de treinamento que cobre milhares de direções de idiomas com dados supervisionados, criados por meio de mineração em larga escala. Em seguida, exploramos como aumentar efetivamente a capacidade do modelo por meio de uma combinação de escala densa e parâmetros esparsos específicos de idioma para criar modelos de alta qualidade. Nosso foco em modelos não centrados no inglês traz ganhos de mais de 10 BLEU ao traduzir diretamente entre direções não em inglês, mantendo desempenho competitivo em relação aos melhores sistemas únicos do WMT. Disponibilizamos em código aberto nossos scripts para que outros possam reproduzir os dados, a avaliação e o modelo final M2M-100.
Este modelo foi contribuído por valhalla.
Dicas e exemplos de uso
M2M100 é um modelo encoder-decoder (seq-to-seq) multilíngue, destinado principalmente a tarefas de tradução. Como o modelo é multilíngue, ele espera que as sequências estejam em um formato específico: um token especial de id de idioma é usado como prefixo tanto no texto de origem quanto no texto de destino. O formato do texto de origem é [lang_code] X [eos], em que lang_code é o id do idioma de origem para o texto de origem e o id do idioma de destino para o texto de destino, sendo X o texto de origem ou de destino.
O M2M100Tokenizer depende de sentencepiece, portanto, certifique-se de instalá-lo antes de executar os exemplos. Para instalar o sentencepiece, execute pip install sentencepiece.
Supervised Training
from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer


model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", device_map="auto")
tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M", src_lang="en", tgt_lang="fr")

src_text = "Life is like a box of chocolates."
tgt_text = "La vie est comme une boîte de chocolat."

model_inputs = tokenizer(src_text, text_target=tgt_text, return_tensors="pt").to(model.device)

loss = model(**model_inputs).loss  # forward pass
Geração
O M2M100 usa o eos_token_id como decoder_start_token_id para a geração, com o id do idioma de destino sendo forçado como o primeiro token gerado. Para forçar o id do idioma de destino como o primeiro token gerado, passe o parâmetro forced_bos_token_id para o método generate. O exemplo a seguir mostra como traduzir do hindi para o francês e do chinês para o inglês usando o checkpoint facebook/m2m100_418M.
from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer


hi_text = "जीवन एक चॉकलेट बॉक्स की तरह है।"
chinese_text = "生活就像一盒巧克力。"

model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", device_map="auto")
tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M")

# translate Hindi to French
tokenizer.src_lang = "hi"
encoded_hi = tokenizer(hi_text, return_tensors="pt").to(model.device)
generated_tokens = model.generate(**encoded_hi, forced_bos_token_id=tokenizer.get_lang_id("fr"))
tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)
"La vie est comme une boîte de chocolat."

# translate Chinese to English
tokenizer.src_lang = "zh"
encoded_zh = tokenizer(chinese_text, return_tensors="pt").to(model.device)
generated_tokens = model.generate(**encoded_zh, forced_bos_token_id=tokenizer.get_lang_id("en"))
tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)
"Life is like a box of chocolate."
Recursos
M2M100Config
classe transformers.M2M100Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truevocab_size: int = 128112max_position_embeddings: int = 1024encoder_layers: int = 12encoder_ffn_dim: int = 4096encoder_attention_heads: int = 16decoder_layers: int = 12decoder_ffn_dim: int = 4096decoder_attention_heads: int = 16encoder_layerdrop: float | int = 0.05decoder_layerdrop: float | int = 0.05use_cache: bool = Trueactivation_function: str = 'relu'd_model: int = 1024dropout: float | int = 0.1attention_dropout: float | int = 0.1activation_dropout: float | int = 0.0init_std: float = 0.02decoder_start_token_id: int | None = 2scale_embedding: bool = Truepad_token_id: int | None = 1bos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2tie_word_embeddings: bool = True )
Parâmetros
- is_encoder_decoder (
bool, opcional, padrãoTrue) — Indica se o modelo é usado como encoder/decoder ou não. - vocab_size (
int, opcional, padrão128112) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - max_position_embeddings (
int, opcional, padrão1024) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. - encoder_layers (
int, opcional, padrão12) — Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - encoder_ffn_dim (
int, opcional, padrão4096) — Dimensão da camada “intermediária” (frequentemente chamada de feed-forward) no encoder. - encoder_attention_heads (
int, opcional, padrão16) — Número de cabeças de atenção para cada camada de atenção no codificador do Transformer. - decoder_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. Se não for definido, usará o mesmo valor denum_layers. - decoder_ffn_dim (
int, opcional, padrão4096) — Dimensão da camada “intermediária” (frequentemente chamada de feed-forward) no decoder. - decoder_attention_heads (
int, opcional, padrão16) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - encoder_layerdrop (
Union[float, int], opcional, padrão0.05) — A probabilidade de LayerDrop para o encoder. Veja o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - decoder_layerdrop (
Union[float, int], opcional, padrão0.05) — A probabilidade de LayerDrop para o decoder. Veja o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - activation_function (
str, opcional, padrãorelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - d_model (
int, opcional, padrão1024) — Tamanho das camadas do codificador e da camada pooler. - dropout (
Union[float, int], opcional, padrão0.1) — A proporção para todas as camadas de dropout. - attention_dropout (
Union[float, int], opcional, padrão0.1) — A taxa de dropout para as probabilidades de atenção. - activation_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as ativações dentro da camada totalmente conectada. - init_std (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - decoder_start_token_id (
int, opcional, padrão2) — Se um modelo encoder-decoder inicia a decodificação com um token diferente debos, o id desse token. - scale_embedding (
bool, opcional, padrãoTrue) — Se as embeddings devem ser escalonadas dividindo por sqrt(d_model). - pad_token_id (
int, opcional, padrão1) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão0) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão2) — ID do token usado para o fim do fluxo no vocabulário. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo.
Esta é a classe de configuração para armazenar a configuração de um M2M100Model. Ela é usada para instanciar um modelo M2M 100 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/m2m100_418M
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import M2M100Config, M2M100Model

>>> # Initializing a M2M100 facebook/m2m100_418M style configuration
>>> configuration = M2M100Config()

>>> # Initializing a model (with random weights) from the facebook/m2m100_418M style configuration
>>> model = M2M100Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
M2M100Tokenizer
classe transformers.M2M100Tokenizer
< source >( vocab_filespm_filesrc_lang = Nonetgt_lang = Nonebos_token = '<s>'eos_token = '</s>'sep_token = '</s>'pad_token = '<pad>'unk_token = '<unk>'language_codes = 'm2m100'sp_model_kwargs: dict[str, typing.Any] | None = Nonenum_madeup_words = 8**kwargs )
Parâmetros
- vocab_file (
str) — Caminho para o arquivo de vocabulário. - spm_file (
str) — Caminho para o arquivo SentencePiece (geralmente com a extensão .spm) que contém o vocabulário. - src_lang (
str, opcional) — Uma string que representa o idioma de origem. - tgt_lang (
str, opcional) — Uma string que representa o idioma de destino. - eos_token (
str, opcional, padrão"</s>") — O token de fim de sequência. - sep_token (
str, opcional, padrão"</s>") — O token separador, usado ao construir uma sequência a partir de múltiplas sequências, por exemplo, duas sequências para classificação de sequência ou um texto e uma pergunta para question answering. Também é usado como o último token de uma sequência construída com tokens especiais. - unk_token (
str, opcional, padrão"<unk>") — O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso. - pad_token (
str, opcional, padrão"<pad>") — O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes. - language_codes (
str, opcional, padrão"m2m100") — Quais códigos de idioma usar. Deve ser um dos valores"m2m100"ou"wmt21". - sp_model_kwargs (
dict, opcional) — Será passado para oSentencePieceProcessor.__init__()método. O wrapper em Python para SentencePiece pode ser usado, entre outras coisas, para definir:-
enable_sampling: Ativa a regularização de subpalavras. -
nbest_size: Parâmetros de amostragem para unigramas. Inválido para BPE-Dropout.nbest_size = {0,1}: Nenhuma amostragem é realizada.nbest_size > 1: amostra dos resultados do nbest_size.nbest_size < 0: assume que nbest_size é infinito e amostra de todas as hipóteses (lattice) usando o algoritmo de filtragem para frente e amostragem para trás (forward-filtering-and-backward-sampling).
-
alpha: Parâmetro de suavização para amostragem de unigramas e probabilidade de dropout para operações de mesclagem no BPE-dropout.
-
Construa um tokenizer M2M100. Baseado em SentencePiece.
Este tokenizer herda de PreTrainedTokenizer, que contém a maioria dos métodos principais. Os usuários devem consultar essa superclasse para obter mais informações sobre esses métodos.
Exemplos:
>>> from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer

>>> model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M")
>>> tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M", src_lang="en", tgt_lang="ro")
>>> src_text = " UN Chief Says There Is No Military Solution in Syria"
>>> tgt_text = "Şeful ONU declară că nu există o soluţie militară în Siria"
>>> model_inputs = tokenizer(src_text, text_target=tgt_text, return_tensors="pt")
>>> outputs = model(**model_inputs)  # should work
build_inputs_with_special_tokens
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
Parâmetros
- token_ids_0 (
list[int]) — Lista de IDs aos quais os tokens especiais serão adicionados. - token_ids_1 (
list[int], opcional) — Lista opcional de IDs para pares de sequências.
Retorna
list[int]
Lista de IDs de entrada com os tokens especiais apropriados.
Construa as entradas do modelo a partir de uma sequência ou de um par de sequências para tarefas de classificação de sequência, concatenando e adicionando tokens especiais. Uma sequência MBART tem o seguinte formato, em que X representa a sequência:
input_ids(para o encoder)X [eos, src_lang_code]decoder_input_ids: (para o decoder)X [eos, tgt_lang_code]
O BOS nunca é usado. Pares de sequências não são o caso de uso esperado, mas serão processados sem um separador.
get_special_tokens_mask
< source >( token_ids_0: listtoken_ids_1: list[int] | None = Nonealready_has_special_tokens: bool = False ) → list[int]
Parâmetros
- token_ids_0 (
list[int]) — Lista de IDs. - token_ids_1 (
list[int], opcional) — Lista opcional de IDs para pares de sequências. - already_has_special_tokens (
bool, opcional, padrãoFalse) — Indica se a lista de tokens já está formatada com tokens especiais para o modelo.
Retorna
list[int]
Uma lista de inteiros no intervalo [0, 1]: 1 para um token especial, 0 para um token de sequência.
Recupera os ids de sequência de uma lista de tokens que não possui tokens especiais adicionados. Este método é chamado ao adicionar tokens especiais usando o método prepare_for_model do tokenizer.
create_token_type_ids_from_sequences
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
Crie uma máscara a partir das duas sequências passadas para ser usada em uma tarefa de classificação de pares de sequências.
Este método constrói dinamicamente os IDs de tipo de token com base nos atributos de configuração do tokenizer:
token_type_ids_pattern: Padrão a ser usado (“all_zeros” ou “bert_style”)token_type_ids_include_special_tokens: Se deve considerar tokens especiais no cálculo do comprimento
Exemplos:
# All zeros pattern (default, used by RoBERTa, BART, etc.)
tokenizer.token_type_ids_pattern = "all_zeros"
# Returns: [0, 0, 0, ...] for both sequences

# BERT-style pattern (first sequence gets 0s, second gets 1s)
tokenizer.token_type_ids_pattern = "bert_style"
# Returns: [0, 0, 0, ..., 1, 1, 1, ...] for sequence pairsM2M100Model
classe transformers.M2M100Model
< source >( config: M2M100Config )
Parâmetros
- config (M2M100Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo M2M 100 puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneencoder_outputs: tuple[tuple[torch.Tensor]] | None = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqModelOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- decoder_input_ids (
torch.LongTensorde forma(batch_size, target_sequence_length), opcional) — Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes. O que são IDs de entrada do decodificador? O M2M100 usa o eos_token_id como token inicial para a geração de decoder_input_ids. Se past_key_values for usado, opcionalmente, apenas os últimos decoder_input_ids precisam ser inseridos (veja past_key_values).Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
O que são IDs de entrada do decodificador?
O M2M100 usa o
eos_token_idcomo o token inicial para a geração dedecoder_input_ids. Sepast_key_valuesfor usado, opcionalmente apenas o últimodecoder_input_idsprecisa ser inserido (vejapast_key_values). - decoder_attention_mask (
torch.LongTensorde forma(batch_size, target_sequence_length), opcional) — Comportamento padrão: gera um tensor que ignora tokens de preenchimento emdecoder_input_ids. A máscara causal também será usada por padrão. - encoder_outputs (
tuple[tuple[torch.Tensor]], opcional) — A tupla consiste em (last_hidden_state, opcional:hidden_states, opcional:attentions)last_hidden_statede forma(batch_size, sequence_length, hidden_size), opcional) é uma sequência de hidden-states na saída da última camada do encoder. Usado na cross-attention do decoder. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - decoder_inputs_embeds (
torch.Tensorde forma(batch_size, target_sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passardecoder_input_idsvocê pode escolher passar diretamente uma representação incorporada. Sepast_key_valuesfor usado, opcionalmente apenas o últimodecoder_inputs_embedsprecisa ser entrada (vejapast_key_values). Isso é útil se você quiser mais controle sobre como converterdecoder_input_idsíndices em vetores associados do que a matriz de busca de incorporação interna do modelo.Se
decoder_input_idsedecoder_inputs_embedsestiverem ambos não definidos,decoder_inputs_embedsassume o valor deinputs_embeds. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values).
Retorna
Seq2SeqModelOutput ou tuple(torch.Tensor)
Um Seq2SeqModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (M2M100Config) e das entradas.
O método forward do M2M100Model substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do decodificador do modelo.Se
past_key_valuesfor usado, apenas o último hidden-state das sequências, com forma(batch_size, 1, hidden_size), é retornado.past_key_values (
EncoderDecoderCache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — Trata-se de uma instância de EncoderDecoderCache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas opcionais do embedding inicial.
decoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
cross_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas opcionais do embedding inicial.
encoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
M2M100ForConditionalGeneration
classe transformers.M2M100ForConditionalGeneration
< source >( config: M2M100Config )
Parâmetros
- config (M2M100Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O Modelo M2M100 com uma cabeça de modelagem de linguagem. Pode ser usado para sumarização.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneencoder_outputs: tuple[tuple[torch.Tensor]] | None = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqLMOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- decoder_input_ids (
torch.LongTensorde forma(batch_size, target_sequence_length), opcional) — Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes. O que são IDs de entrada do decodificador? O M2M100 usa o eos_token_id como token inicial para a geração de decoder_input_ids. Se past_key_values for usado, opcionalmente, apenas os últimos decoder_input_ids precisam ser inseridos (veja past_key_values).Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
O que são IDs de entrada do decodificador?
O M2M100 usa o
eos_token_idcomo o token inicial para a geração dedecoder_input_ids. Sepast_key_valuesfor usado, opcionalmente apenas o últimodecoder_input_idsprecisa ser inserido (vejapast_key_values). - decoder_attention_mask (
torch.LongTensorde forma(batch_size, target_sequence_length), opcional) — Comportamento padrão: gera um tensor que ignora tokens de preenchimento emdecoder_input_ids. A máscara causal também será usada por padrão. - encoder_outputs (
tuple[tuple[torch.Tensor]], opcional) — A tupla consiste em (last_hidden_state, opcional:hidden_states, opcional:attentions)last_hidden_statede forma(batch_size, sequence_length, hidden_size), opcional) é uma sequência de hidden-states na saída da última camada do encoder. Usado na cross-attention do decoder. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - decoder_inputs_embeds (
torch.Tensorde forma(batch_size, target_sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passardecoder_input_idsvocê pode escolher passar diretamente uma representação incorporada. Sepast_key_valuesfor usado, opcionalmente apenas o últimodecoder_inputs_embedsprecisa ser entrada (vejapast_key_values). Isso é útil se você quiser mais controle sobre como converterdecoder_input_idsíndices em vetores associados do que a matriz de busca de incorporação interna do modelo.Se
decoder_input_idsedecoder_inputs_embedsestiverem ambos não definidos,decoder_inputs_embedsassume o valor deinputs_embeds. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[0, ..., config.vocab_size]ou ser -100 (veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size]. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values).
Retorna
Seq2SeqLMOutput ou tuple(torch.Tensor)
Um Seq2SeqLMOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (M2M100Config) e das entradas.
O método forward de M2M100ForConditionalGeneration sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem.logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).past_key_values (
EncoderDecoderCache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — Trata-se de uma instância de EncoderDecoderCache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
decoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
cross_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
encoder_attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Tradução de exemplo:
>>> from transformers import AutoTokenizer, M2M100ForConditionalGeneration

>>> model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M")
>>> tokenizer = AutoTokenizer.from_pretrained("facebook/m2m100_418M")

>>> text_to_translate = "Life is like a box of chocolates"
>>> model_inputs = tokenizer(text_to_translate, return_tensors="pt")

>>> # translate to French
>>> gen_tokens = model.generate(**model_inputs, forced_bos_token_id=tokenizer.get_lang_id("fr"))
>>> print(tokenizer.batch_decode(gen_tokens, skip_special_tokens=True))
Usando Flash Attention 2
Flash Attention 2 é uma versão mais rápida e otimizada do cálculo das pontuações de atenção, que depende de kernels cuda.
Instalação
Primeiro, verifique se o seu hardware é compatível com Flash Attention 2. A lista mais recente de hardware compatível pode ser encontrada na documentação oficial.
Em seguida, instale a versão mais recente do Flash Attention 2:
pip install -U flash-attn --no-build-isolation
Uso
Para carregar um modelo usando Flash Attention 2, podemos passar o argumento attn_implementation="flash_attention_2" para from_pretrained(). Você pode usar a precisão torch.float16 ou torch.bfloat16.
from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer


model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", attn_implementation="flash_attention_2", device_map="auto").eval()
tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M")

# translate Hindi to French
hi_text = "जीवन एक चॉकलेट बॉक्स की तरह है।"
tokenizer.src_lang = "hi"
encoded_hi = tokenizer(hi_text, return_tensors="pt").to(model.device)
generated_tokens = model.generate(**encoded_hi, forced_bos_token_id=tokenizer.get_lang_id("fr"))
tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)
"La vie est comme une boîte de chocolat."
Acelerações esperadas
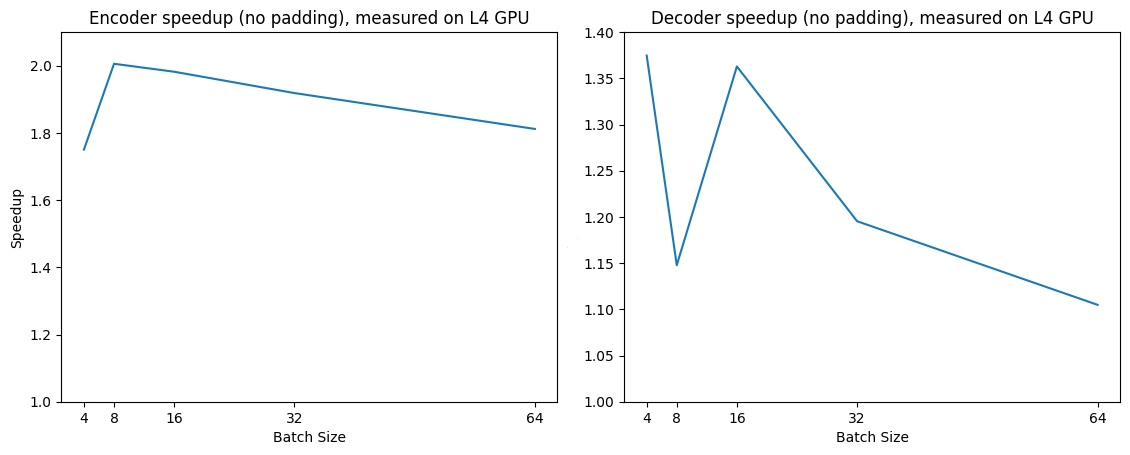
Abaixo está um diagrama de aceleração esperado que compara o tempo de inferência puro entre a implementação nativa e o Flash Attention 2.
Usando Scaled Dot Product Attention (SDPA)
O PyTorch inclui um operador nativo de atenção de produto escalar com escala (SDPA) como parte de torch.nn.functional. Essa função
abrange várias implementações que podem ser aplicadas dependendo das entradas e do hardware em uso. Consulte a documentação oficial ou a página GPU Inference para mais informações.
O SDPA é usado por padrão para torch>=2.1.1 quando uma implementação está disponível, mas você também pode definir attn_implementation="sdpa" em from_pretrained() para solicitar explicitamente o uso do SDPA.
from transformers import M2M100ForConditionalGeneration


model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", attn_implementation="sdpa", device_map="auto")
...
Para obter as melhores acelerações, recomendamos carregar o modelo em meia precisão (por exemplo, torch.float16 ou torch.bfloat16).