
Transformers documentation
GGUF
GGUF
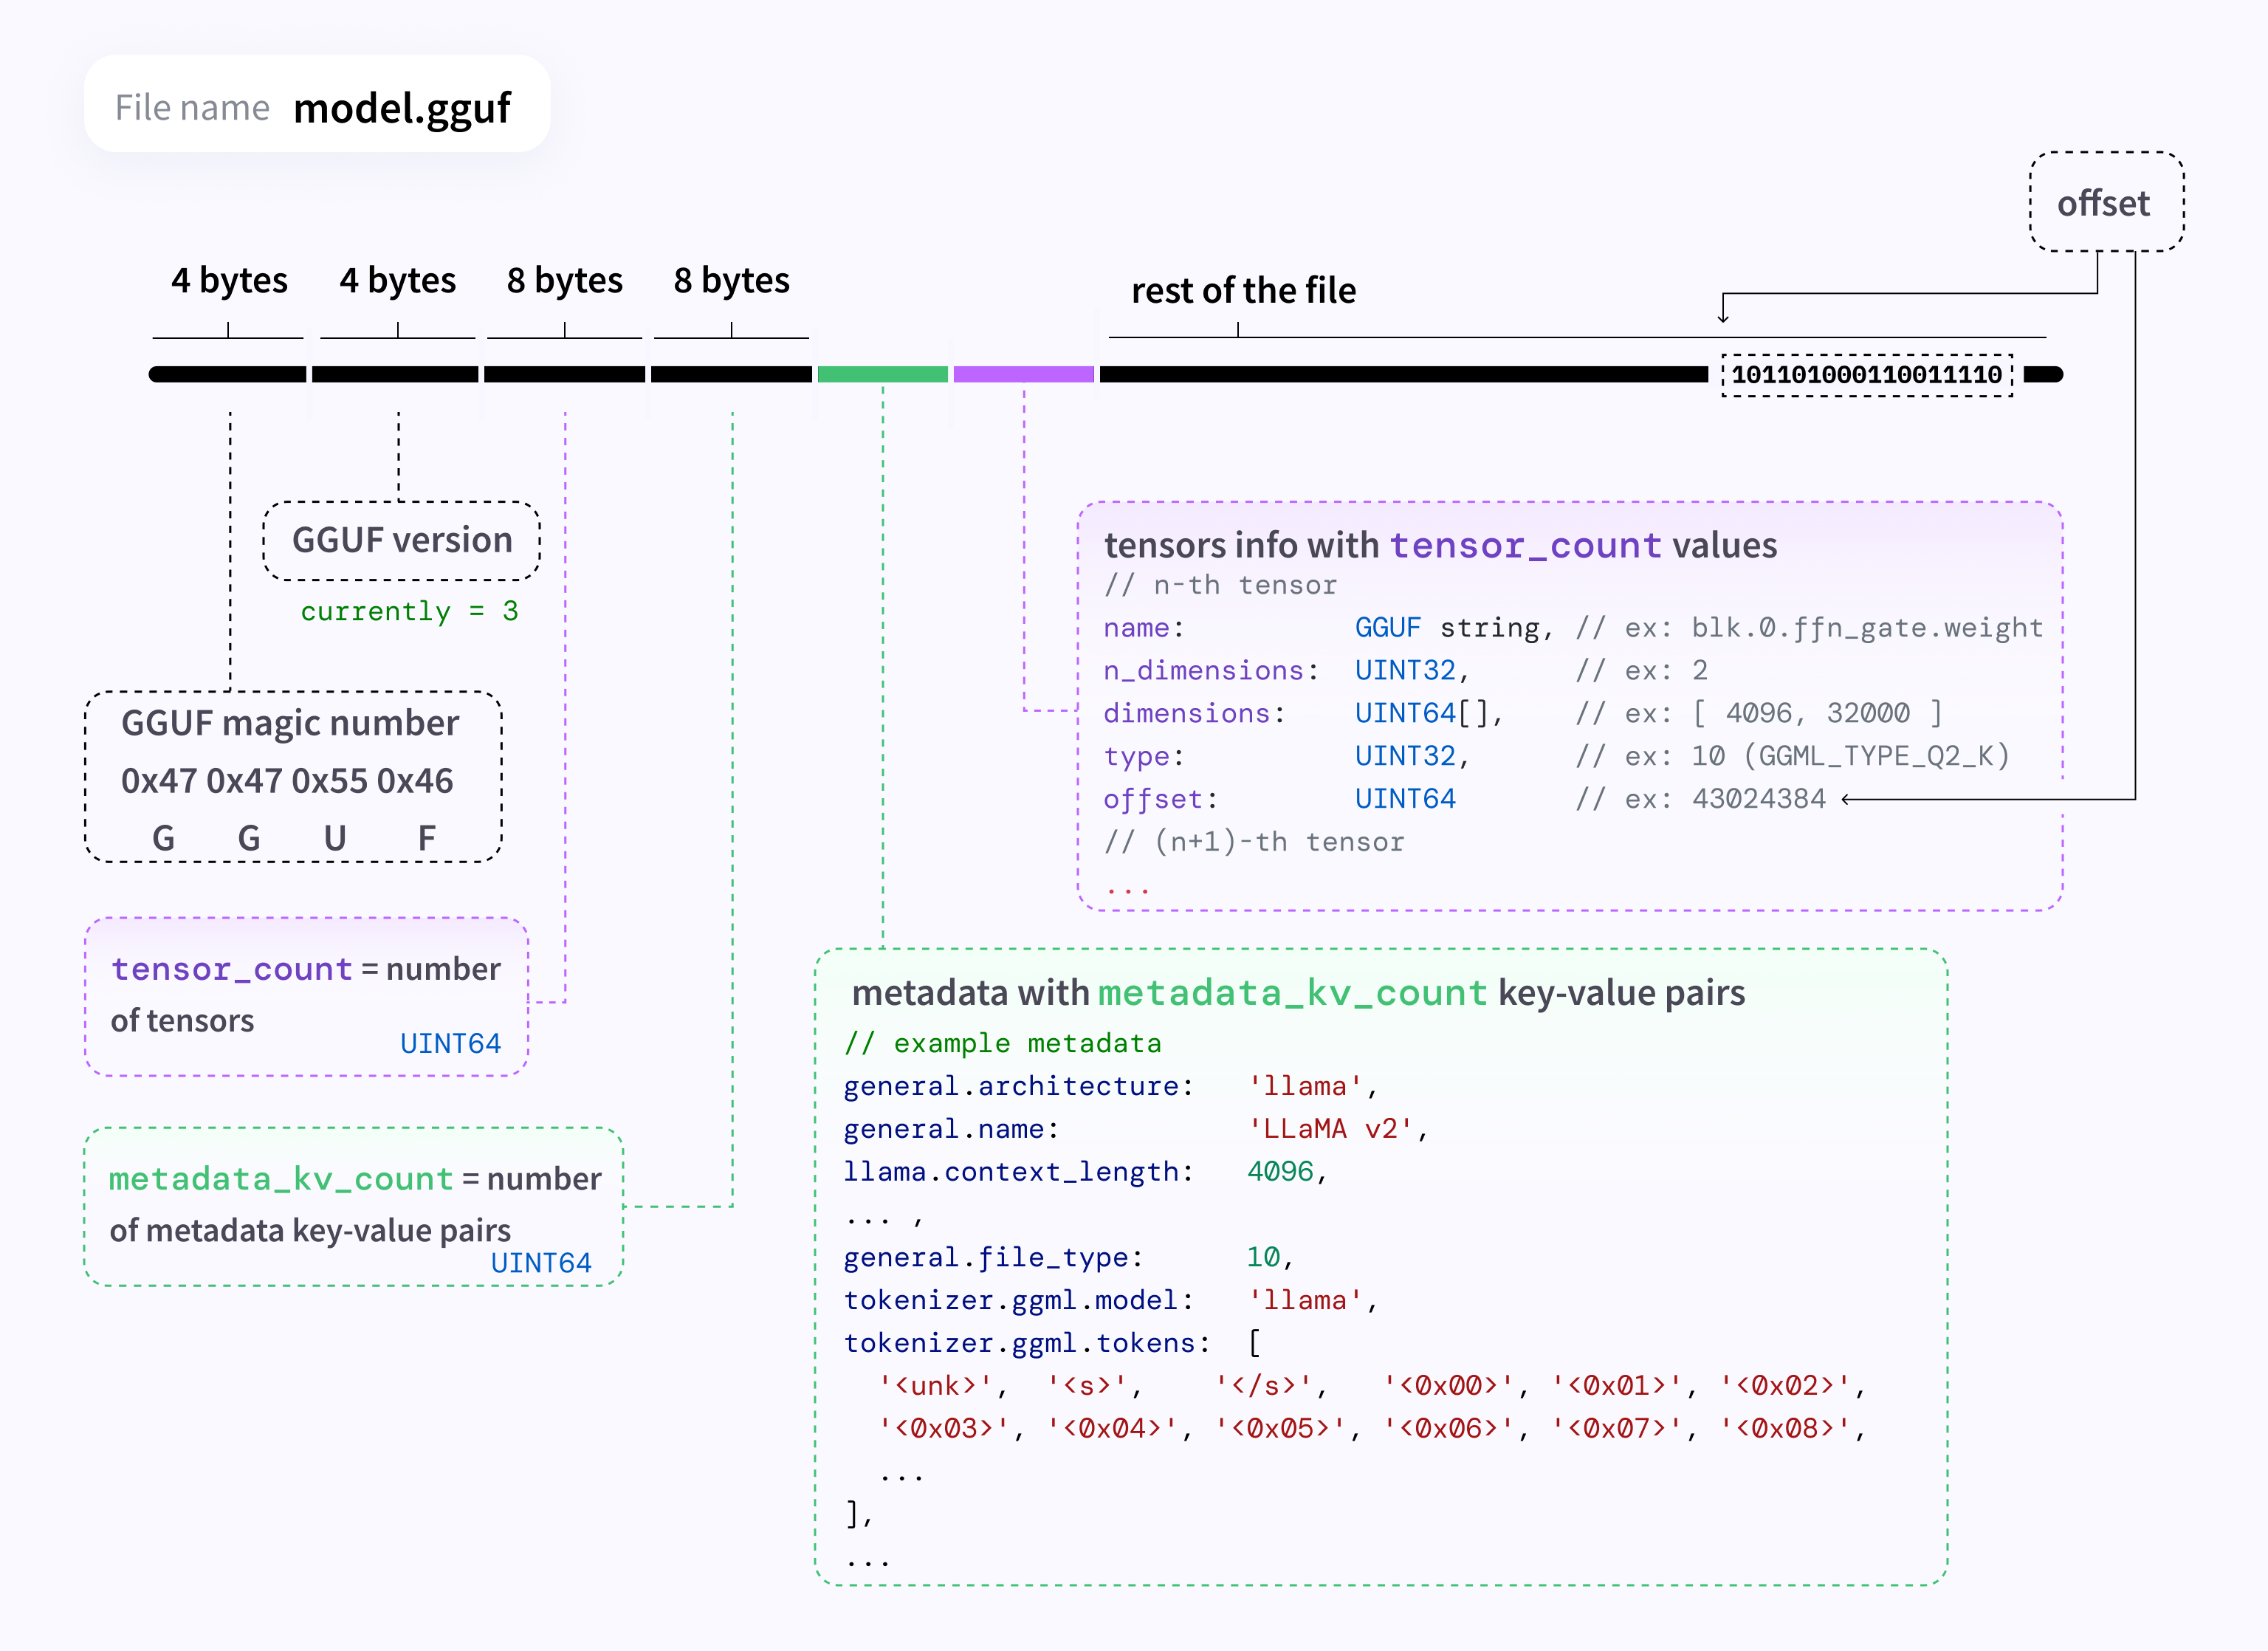
GGUF é um formato de arquivo único usado para armazenar modelos para inferência com GGML, contendo os metadados do modelo e os tensores. Ele suporta muitos tipos de dados quantizados (consulte a tabela de tipos de quantização), o que economiza uma quantidade significativa de memória.
Carregar modelos GGUF
Instale o kernels, caso contrário, o caminho compactado recorre à dequantização completa no carregamento.
pip install kernels
Os pesos permanecem empacotados quando o kernel do Hub ggml-org/ggml-quantization está disponível. O carregador usa MPS por padrão quando esse kernel está presente e executa os matmuls diretamente nos blocos empacotados. Se o kernel não estiver disponível, o modelo é desquantizado no carregamento.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=filename)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
O mesmo load funciona para o Qwen3.5 MoE.
moe_model_id = "unsloth/Qwen3.5-35B-A3B-GGUF"
moe_filename = "Qwen3.5-35B-A3B-Q4_K_M.gguf"

moe_model = AutoModelForCausalLM.from_pretrained(moe_model_id, gguf_file=moe_filename)
moe_tokenizer = AutoTokenizer.from_pretrained(moe_model_id, gguf_file=moe_filename)
O caminho empacotado atualmente suporta Qwen3.5 e Qwen3.5 MoE. Os carregamentos empacotados usam float32 automaticamente, pois é mais rápido no MPS. Se você definir outro dtype, o carregador retorna um aviso. Outras arquiteturas passam pelo carregador legado.
Atenção
No MPS, com os kernels instalados, ggml-attn é a atenção padrão ao carregar um arquivo GGUF: o mesmo kernel de flash-attention que o llama.cpp usa para decode e prefill. Se o kernel não puder ser obtido, o modelo mantém sua implementação de atenção. A passagem de attn_implementation (por exemplo, "sdpa") sempre tem precedência.
Você também pode passá-lo explicitamente:
model = AutoModelForCausalLM.from_pretrained(
    model_id, gguf_file=filename, attn_implementation="ggml-org/ggml-attn"
)
Desquantizar
Dequantizar descompacta todos os pesos no momento do carregamento e devolve um modelo denso comum. É o recurso de fallback sempre que o caminho rápido e compactado não se aplica. Você também pode solicitá-lo explicitamente com GgufConfig.
import torch

from transformers import AutoModelForCausalLM, GgufConfig

quantization_config = GgufConfig(dequantize=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id, gguf_file=filename, quantization_config=quantization_config, dtype=torch.bfloat16
)
Você obtém um modelo denso regular no dtype que você passou.
Arquiteturas diferentes de Qwen3.5 e Qwen3.5 MoE passam pelo carregador legado, que sempre realiza a desquantização.
O carregador legado suporta Llama, Mistral, Qwen2, Qwen2Moe, Phi3, Bloom, Falcon, StableLM, GPT2, Starcoder2 e muitos outros.
Servir
transformers serve lista cada arquivo .gguf em um repositório como um modelo individual. Um modelo GGUF é nomeado como <repo>:<file>.gguf, pois um repositório contém várias quantizações e o id precisa indicar qual delas carregar. As solicitações o nomeiam da mesma forma.
transformers serve unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf