
Transformers documentation
ميزات التوليد
ميزات التوليد
يدعم واجهة generate() بعض الميزات لبناء التطبيقات فوقها.
ستوضح لك هذه الدليل كيفية استخدام هذه الميزات.
البث
يبدأ Streaming بإرجاع النص فور توليده، فلا يضطر المستخدم إلى الانتظار لرؤية الاستجابة المولّدة كاملة دفعة واحدة. وتكمن أهميته في التطبيقات الموجهة للمستخدمين لأنه يقلل من زمن الاستجابة المُدرَك ويسمح للمستخدمين بمراقبة تقدم عملية التوليد.
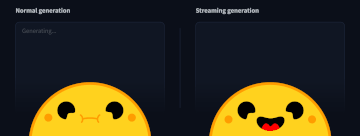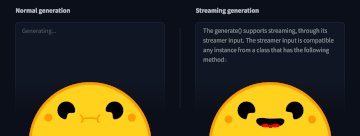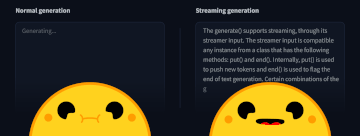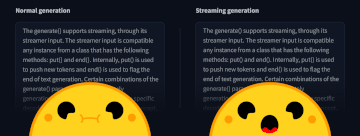
تعرف على المزيد حول البث في وثائق Text Generation Inference.
أنشئ مثيلًا من TextStreamer باستخدام مُجزّئ الرموز. مرّر TextStreamer إلى معامل streamer في generate() لبثّ المخرجات كلمةً تلو الأخرى.
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

tokenizer = AutoTokenizer.from_pretrained("openai-community/gpt2")
model = AutoModelForCausalLM.from_pretrained("openai-community/gpt2")
inputs = tokenizer(["The secret to baking a good cake is "], return_tensors="pt")
streamer = TextStreamer(tokenizer)

_ = model.generate(**inputs, streamer=streamer, max_new_tokens=20)
يتوافق معامل streamer مع أي فئة تتضمن طريقتي put() وend(). تُستخدم الطريقة put() لدفع الرموز الجديدة، بينما تُستخدم الطريقة end() للإشارة إلى نهاية التوليد. يمكنك إنشاء فئة streamer خاصة بك طالما أنها تتضمن هاتين الطريقتين، أو يمكنك استخدام فئات streamer الأساسية في Transformers.
الوسم المائي
يُعدّ التوقيع المائي مفيدًا للكشف عما إذا كان النص مُولَّدًا. يقوم استراتيجية التوقيع المائي في Transformers بتلوين مجموعة فرعية من الرموز باللون الأخضر بشكل عشوائي. عند توليد الرموز الخضراء، يُضاف انحياز صغير إلى قيم اللوجيت الخاصة بها، مما يزيد من احتمالية توليدها. يمكنك اكتشاف النص المولَّد من خلال مقارنة نسبة الرموز الخضراء بالكمية المعتادة من الرموز الخضراء الموجودة في النصوص التي يكتبها البشر.
تُدعَّم تقنية العلامة المائية لأي نموذج توليدي في Transformers ولا تتطلب نموذج تصنيف إضافي للكشف عن النص المُعلَّم مائيًا.
أنشئ WatermarkingConfig بقيمة الانحياز التي ستُضاف إلى القيم اللوجستية (logits) وخوارزمية العلامة المائية. يستخدم المثال أدناه خوارزمية "selfhash"، حيث يعتمد اختيار الرموز الخضراء على الرمز الحالي فقط. مرّر WatermarkingConfig إلى generate().
تكتشف فئة WatermarkDetector نسبة الرموز الخضراء في النص المولّد، ولهذا يُوصى بإزالة نص الاستدعاء إذا كان أطول بكثير من النص المولّد. كما يمكن أن يكون للتعبئة تأثير على WatermarkDetector.
from transformers import AutoTokenizer, AutoModelForCausalLM, WatermarkDetector, WatermarkingConfig

model = AutoModelForCausalLM.from_pretrained("openai-community/gpt2")
tokenizer = AutoTokenizer.from_pretrained("openai-community/gpt2")
tokenizer.pad_token_id = tokenizer.eos_token_id
tokenizer.padding_side = "left"

inputs = tokenizer(["This is the beginning of a long story", "Alice and Bob are"], padding=True, return_tensors="pt")
input_len = inputs["input_ids"].shape[-1]

watermarking_config = WatermarkingConfig(bias=2.5, seeding_scheme="selfhash")
out = model.generate(**inputs, watermarking_config=watermarking_config, do_sample=False, max_length=20)
أنشئ مثيلًا من WatermarkDetector ومرر مخرجات النموذج إليه للكشف عما إذا كان النص مولّدًا آليًا. يجب أن يكون WatermarkDetector مطابقًا لـ WatermarkingConfig المستخدم أثناء التوليد.
detector = WatermarkDetector(model_config=model.config, device="cpu", watermarking_config=watermarking_config)
detection_out = detector(out, return_dict=True)
detection_out.prediction
array([True, True])