
Transformers documentation
Perplexity لنماذج الطول الثابت
Perplexity لنماذج الطول الثابت
تُعدّ مقياس الحيرة (PPL) من أكثر المقاييس شيوعًا لتقييم نماذج اللغة. وقبل التعمق في الموضوع، ينبغي لنا أن نذكر أن هذا المقياس ينطبق تحديدًا على النماذج اللغوية الكلاسيكية (التي تُسمّى أحيانًا نماذج اللغة التوليفية الذاتية أو السببية)، وهو غير معرّف جيدًا لنماذج اللغة المقنّعة مثل BERT.
يُعرَّف الارتباك (Perplexity) بأنه متوسط الاحتمال السالب اللوغاريتمي المُسَلَّب (exponentiated) لسلسلة رموز. إذا كانت لدينا سلسلة مُرمَّزة $X = (x_0, x_1, \dots, x_t)$، فإن الارتباك الخاص بـ هو:
حيث أن $\log p\theta (x_i|x{<i})$ هو احتمال السجل للرمز رقم i مشروطًا بالرموز السابقة $x_{<i}$ وفقًا لنموذجنا. بحدس، يمكن التفكير فيه على أنه تقييم لقدرة النموذج على التنبؤ بشكل متساوٍ بين مجموعة الرموز المحددة في مجموعة البيانات. ومن المهم ملاحظة أن هذا يعني أن عملية تجزئة الرموز لها تأثير مباشر على حيرة النموذج، وهو ما يجب مراعاته دائمًا عند مقارنة نماذج مختلفة.
وهذا يعادل أيضاً رفع أس التداخل المتقاطع بين البيانات وتوقعات النموذج. لمزيد من الفهم الحدسي حول المفاجأة وعلاقتها بعدد البتات لكل حرف (BPC) وضغط البيانات، راجعوا هذا المقال الرائع على The Gradient.
حساب PPL باستخدام نماذج ذات طول ثابت
لو لم نكن مقيدين بحجم سياق النموذج، لكنا نقيس حيرة النموذج (perplexity) عن طريق تحليل تسلسلي ذاتي (autoregressive) لتسلسل ما، مع اشتراط كل خطوة على كامل التسلسل الفرعي السابق لها، كما هو موضح أدناه.
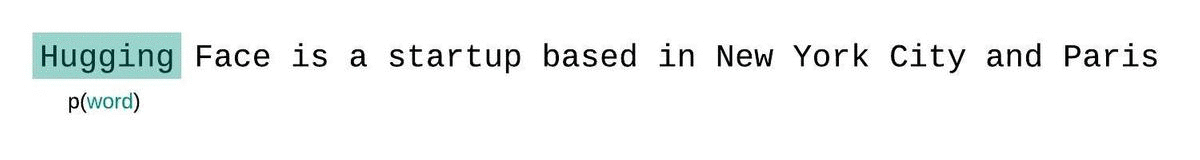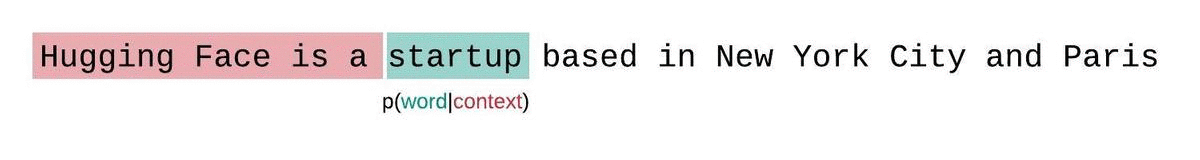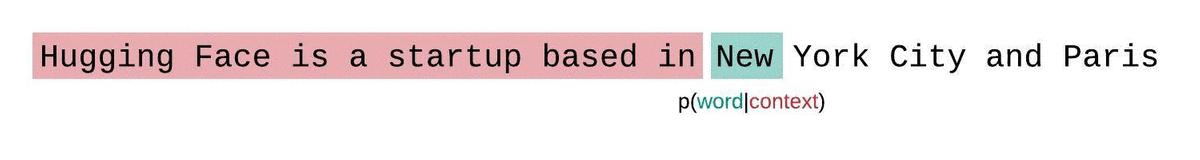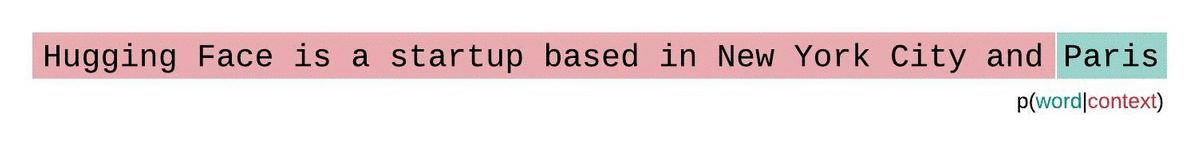
عند العمل مع النماذج التقريبية، يكون لدينا عادةً قيد على عدد الرموز التي يمكن للنموذج معالجتها. أكبر إصدار من GPT-2, على سبيل المثال، له طول ثابت يبلغ 1024 رمزًا، لذا لا يمكننا حساب $p\theta(x_t|x{<t})$ مباشرةً عندما تكون أكبر من 1024.
بدلاً من ذلك، يُقسَّم التسلسل عادةً إلى تسلسلات فرعية تساوي الحد الأقصى لحجم الإدخال في النموذج. إذا كان الحد الأقصى لحجم الإدخال في النموذج هو $k$، فإننا نقرّب احتمال الرمز بالشرط على الرموز التي تسبقه فقط بدلاً من السياق بأكمله. عند تقييم حيرة النموذج (perplexity) لتسلسل، فإن النهج المغرٍ لكنه غير الأمثل هو تقسيم التسلسل إلى مقاطع غير متداخلة وإضافة الاحتمال اللوغاريتمي المفكك لكل مقطع بشكل مستقل.
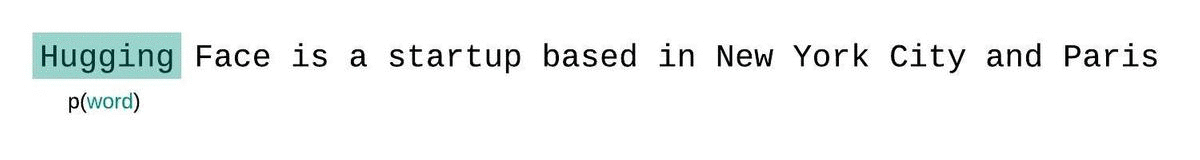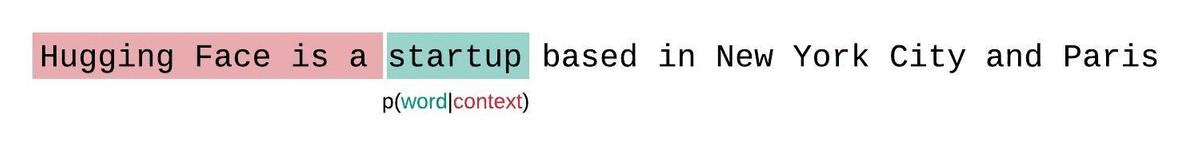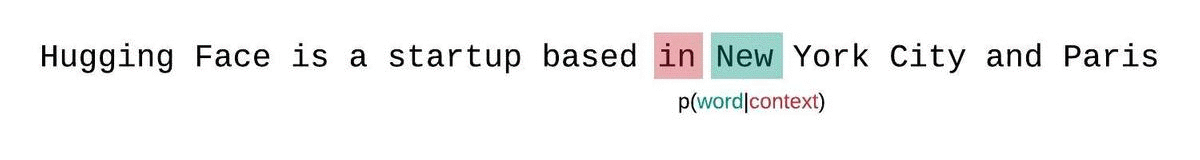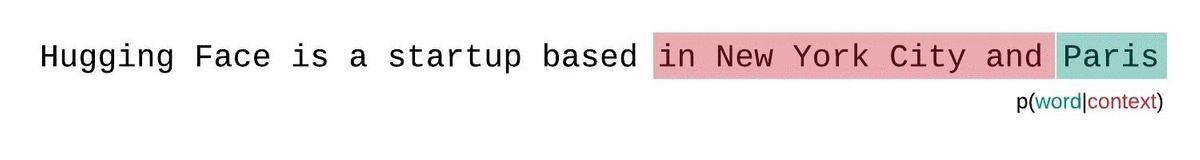
يُحسب هذا بسرعة لأنّ حيرة كل مقطع يمكن حسابها في تمريرة أمامية واحدة، لكنه يقدّم تقريباً ضعيفاً لحيرة التعمية المُفكّكة بالكامل، وغالباً ما يعطي قيمة PPL أعلى (أسوأ) لأنّ النموذج سيملك سياقاً أقل في معظم خطوات التنبؤ.
بدلاً من ذلك، ينبغي تقييم PPL لنماذج الطول الثابت باستخدام استراتيجية النافذة المنزلقة. ويتضمن ذلك تحريك نافذة السياق بشكل متكرر بحيث يتوفر للنموذج سياق أوسع عند إجراء كل تنبؤ.
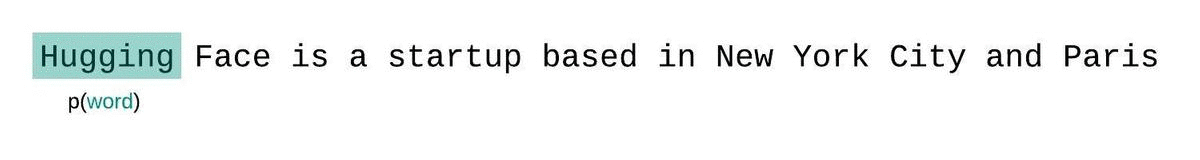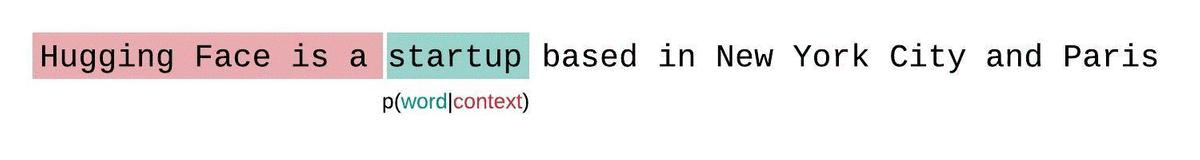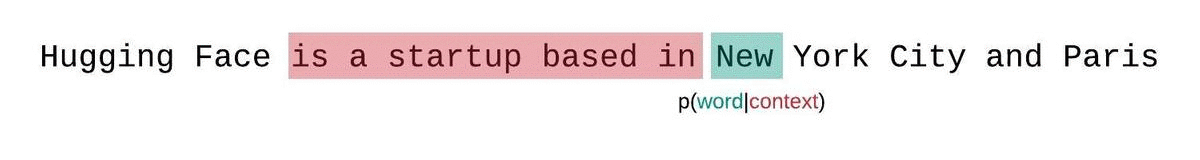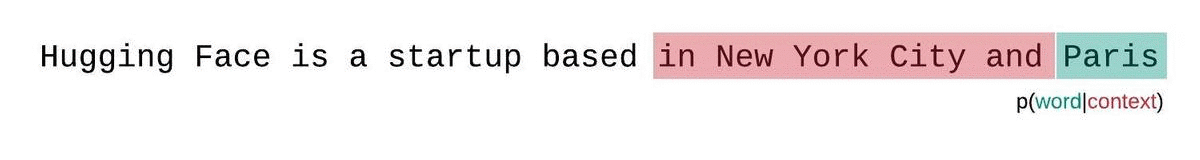
هذا أقرب تقريبيًا إلى التفكيك الحقيقي لاحتمالية التسلسل، وعادةً ما يؤدي إلى نتيجة أكثر ملاءمة. الجانب السلبي هو أنه يتطلب مرورًا أماميًا منفصلًا لكل رمز في المجموعة. حل وسط عملي جيد هو استخدام نافذة منزلقة بخطوات متباعدة، حيث يتم تحريك السياق بخطوات أكبر بدلاً من التحريك برمز واحد في كل مرة. هذا يسمح بإجراء الحسابات بسرعة أكبر بكثير مع منح النموذج سياقًا كبيرًا لإجراء التنبؤات في كل خطوة.
مثال: حساب الارتباك باستخدام GPT-2 في 🤗 Transformers
لنُوضِّح هذه العملية باستخدام GPT-2.
from transformers import GPT2LMHeadModel, GPT2TokenizerFast
from accelerate import Accelerator

device = Accelerator().device
model_id = "openai-community/gpt2-large"
model = GPT2LMHeadModel.from_pretrained(model_id).to(device)
tokenizer = GPT2TokenizerFast.from_pretrained(model_id)
سنقوم بتحميل مجموعة بيانات WikiText-2 وتقييم perplexity باستخدام عدة استراتيجيات مختلفة للنوافذ المنزلقة. وبما أن هذه المجموعة صغيرة ونحن نقوم بتمريرة أمامية واحدة فقط على المجموعة، يمكننا ببساطة تحميل المجموعة بأكملها وتشفيرها في الذاكرة.
from datasets import load_dataset

test = load_dataset("Salesforce/wikitext", "wikitext-2-raw-v1", split="test")
encodings = tokenizer("\n\n".join(test["text"]), return_tensors="pt")
باستخدام 🤗 Transformers، يمكننا ببساطة تمرير input_ids كـ labels إلى نموذجنا، حيث يُعاد متوسط السالب للاحتمالية اللوغاريتمية (negative log-likelihood) لكل رمز كقيمة للخسارة. ومع ذلك، في نهج النافذة المنزلقة لدينا، يوجد تداخل في الرموز التي نمررها إلى النموذج في كل تكرار. لا نريد أن تُحتسب الاحتمالية اللوغاريتمية للرموز التي نتعامل معها كمجرد سياق ضمن خسارتنا، لذا يمكننا تعيين هذه الأهداف إلى -100 حتى يتم تجاهلها. فيما يلي مثال على كيفية القيام بذلك مع خطوة (stride) مقدارها 512. وهذا يعني أن النموذج سيملك 512 رمزًا على الأقل كسياق عند حساب الاحتمالية الشرطية لأي رمز (بشرط توفر 512 رمزًا سابقًا يمكن الاشتراط عليها).
import torch
from tqdm import tqdm

max_length = model.config.n_positions
stride = 512
seq_len = encodings.input_ids.size(1)

nll_sum = 0.0
n_tokens = 0
prev_end_loc = 0
for begin_loc in tqdm(range(0, seq_len, stride)):
    end_loc = min(begin_loc + max_length, seq_len)
    trg_len = end_loc - prev_end_loc  # may be different from stride on last loop
    input_ids = encodings.input_ids[:, begin_loc:end_loc].to(device)
    target_ids = input_ids.clone()
    target_ids[:, :-trg_len] = -100

    with torch.no_grad():
        outputs = model(input_ids, labels=target_ids)

        # loss is calculated using CrossEntropyLoss which averages over valid labels
        # N.B. the model only calculates loss over trg_len - 1 labels, because it internally shifts the labels
        # to the left by 1.
        neg_log_likelihood = outputs.loss

    # Accumulate the total negative log-likelihood and the total number of tokens
    num_valid_tokens = (target_ids != -100).sum().item()  # number of valid tokens in target_ids
    batch_size = target_ids.size(0)
    num_loss_tokens = num_valid_tokens - batch_size  # subtract batch_size due to internal label shift
    nll_sum += neg_log_likelihood * num_loss_tokens
    n_tokens += num_loss_tokens

    prev_end_loc = end_loc
    if end_loc == seq_len:
        break

avg_nll = nll_sum / n_tokens  # average negative log-likelihood per token
ppl = torch.exp(avg_nll)
يعادل تشغيل هذا مع طول الخطوة (stride) مساوٍ لأقصى طول للمدخلات الاستراتيجية غير المثلى وغير النافذة المنزلقة التي ناقشناها أعلاه. وكلما قلّ طول الخطوة، زادت كمية السياق الذي يتوفر للنموذج عند إجراء كل تنبؤ، وعادةً ما تكون قيمة الارتباك (perplexity) المُبلَّغ عنها أفضل.
عند تشغيل الأمر أعلاه مع stride = 1024، أي بدون تداخل، يكون الناتج PPL هو 19.44، وهو ما يقارب تقريبًا القيمة 19.93 المذكورة في ورقة GPT-2. وباستخدام stride = 512 وتطبيق استراتيجية النافذة المتدرجة الخاصة بنا، تنخفض هذه القيمة إلى 16.44. وهذا ليس فقط نتيجة أكثر ملاءمة، بل يتم حسابها بطريقة أقرب إلى التفكيك الذاتي التتابعي الحقيقي لاحتمالية التسلسل.