
Transformers documentation
BridgeTower
Este modelo foi publicado no HF papers em 17/06/2022 e contribuído para o Hugging Face Transformers em 25/01/2023.
BridgeTower
Visão geral
O modelo BridgeTower foi proposto em BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning por Xiao Xu, Chenfei Wu, Shachar Rosenman, Vasudev Lal, Wanxiang Che, Nan Duan. O objetivo deste modelo é construir uma ponte entre cada codificador unimodal e o codificador multimodal, permitindo uma interação abrangente e detalhada em cada camada do codificador multimodal, alcançando assim um desempenho notável em diversas tarefas downstream com custos adicionais de desempenho e computação quase insignificantes.
Este artigo foi aceito na conferência AAAI’23.
O resumo do artigo é o seguinte:
Modelos de Visão-Linguagem (VL) com a arquitetura TWO-TOWER dominaram o aprendizado de representação visual-linguística nos últimos anos. Os modelos de VL atuais ou utilizam codificadores unimodais leves e aprendem a extrair, alinhar e fundir ambas as modalidades simultaneamente em um codificador cross-modal profundo, ou alimentam as representações unimodais da última camada dos codificadores unimodais pré-treinados profundos para o codificador cross-modal superior. Ambas as abordagens potencialmente restringem o aprendizado de representação de visão-linguagem e limitam o desempenho do modelo. Neste artigo, propomos o BRIDGETOWER, que introduz múltiplas camadas de ponte que estabelecem uma conexão entre as camadas superiores dos codificadores unimodais e cada camada do codificador cross-modal. Isso permite um alinhamento e fusão cross-modal eficazes de baixo para cima entre as representações visuais e textuais de diferentes níveis semânticos dos codificadores unimodais pré-treinados no codificador cross-modal. Pré-treinado com apenas 4M de imagens, o BRIDGETOWER atinge desempenho state-of-the-art em diversas tarefas downstream de visão-linguagem. Em particular, no conjunto de teste test-std do VQAv2, o BRIDGETOWER atinge uma precisão de 78,73%, superando o modelo state-of-the-art anterior, o METER, em 1,09% com os mesmos dados de pré-treinamento e custos adicionais de parâmetros e computação quase insignificantes. Notavelmente, ao escalar ainda mais o modelo, o BRIDGETOWER atinge uma precisão de 81,15%, superando modelos que são pré-treinados em conjuntos de dados de ordens de magnitude maiores.
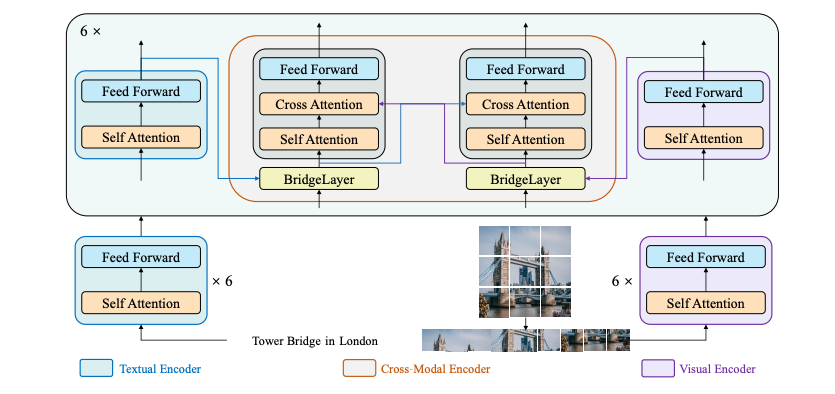 BridgeTower architecture. Taken from the original paper.
Este modelo foi contribuído por Anahita Bhiwandiwalla, Tiep Le e Shaoyen Tseng. O código original pode ser encontrado aqui.
Dicas e exemplos de uso
BridgeTower consiste em um codificador visual, um codificador textual e um codificador cross-modal com múltiplas camadas de ponte leves. O objetivo dessa abordagem foi construir uma ponte entre cada codificador unimodal e o codificador cross-modal para permitir uma interação abrangente e detalhada em cada camada do codificador cross-modal. Em princípio, é possível aplicar qualquer codificador visual, textual ou cross-modal na arquitetura proposta.
O BridgeTowerProcessor encapsula o RobertaTokenizer e o BridgeTowerImageProcessor em uma única instância para codificar o texto e preparar as imagens, respectivamente.
O exemplo a seguir mostra como executar o aprendizado contrastivo usando BridgeTowerProcessor e BridgeTowerForContrastiveLearning.
import requests
from PIL import Image

from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor


url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]

processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")

# forward pass
scores = dict()
for text in texts:
    # prepare inputs
    encoding = processor(image, text, return_tensors="pt").to(model.device)
    outputs = model(**encoding)
    scores[text] = outputs
O exemplo a seguir mostra como executar a recuperação de imagem e texto usando BridgeTowerProcessor e BridgeTowerForImageAndTextRetrieval.
import requests
from PIL import Image

from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor


url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]

processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")

# forward pass
scores = dict()
for text in texts:
    # prepare inputs
    encoding = processor(image, text, return_tensors="pt").to(model.device)
    outputs = model(**encoding)
    scores[text] = outputs.logits[0, 1].item()
O exemplo a seguir mostra como executar o modelamento de linguagem mascarada usando BridgeTowerProcessor e BridgeTowerForMaskedLM.
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests

url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a <mask> looking out of the window"

processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")

# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)

# forward pass
outputs = model(**encoding)

results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())

print(results)
.a cat looking out of the window.
Dicas:
- Esta implementação do BridgeTower usa RobertaTokenizer para gerar embeddings de texto e o modelo CLIP/ViT da OpenAI para calcular embeddings visuais.
- Os checkpoints para o bridgeTower-base e para o bridgetower masked language modeling and image text matching foram liberados.
- Consulte a Tabela 5 para verificar o desempenho do BridgeTower em Image Retrieval e em outras tarefas downstream.
BridgeTowerConfig
classe transformers.BridgeTowerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneshare_cross_modal_transformer_layers: bool = Truehidden_act: str = 'gelu'hidden_size: int = 768initializer_factor: float | int = 1layer_norm_eps: float = 1e-05share_link_tower_layers: bool = Falselink_tower_type: str = 'add'num_attention_heads: int = 12num_hidden_layers: int = 6tie_word_embeddings: bool = Falseinit_layernorm_from_vision_encoder: bool = Falsetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Parâmetros
- share_cross_modal_transformer_layers (
bool, opcional, padrãoTrue) — Indica se as camadas do transformer entre modais são compartilhadas. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - initializer_factor (
Union[float, int], opcional, padrão1) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização). - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - share_link_tower_layers (
bool, opcional, padrãoFalse) — Indica se as camadas da torre de ponte/ligação são compartilhadas. - link_tower_type (
str, opcional, padrão"add") — Tipo da camada de ponte/ligação. - num_attention_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_hidden_layers (
int, opcional, padrão6) — Número de camadas ocultas no decodificador do Transformer. - tie_word_embeddings (
bool, opcional, padrãoFalse) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo. - init_layernorm_from_vision_encoder (
bool, opcional, padrãoFalse) — Se deve inicializar o LayerNorm a partir do codificador de visão. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — O objeto de configuração ou dicionário do backbone de texto. - vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — O objeto de configuração ou dicionário do backbone de visão.
Esta é a classe de configuração para armazenar a configuração de um BridgeTowerModel. Ela é usada para instanciar um modelo Bridgetower de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do BridgeTower/bridgetower-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import BridgeTowerModel, BridgeTowerConfig

>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()

>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BridgeTowerTextConfig
classe transformers.BridgeTowerTextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 50265hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12initializer_factor: float | int = 1intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 514type_vocab_size: int = 1layer_norm_eps: float = 1e-05pad_token_id: int | None = 1bos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2use_cache: bool = Trueis_decoder: bool = Falseadd_cross_attention: bool = False )
Parâmetros
- vocab_size (
int, opcional, padrão50265) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - initializer_factor (
Union[float, int], opcional, padrão1) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização). - intermediate_size (
int, opcional, padrão3072) — Dimensão das representações do MLP. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - hidden_dropout_prob (
Union[float, int], opcional, padrão0.1) — A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no codificador e no pooler. - attention_probs_dropout_prob (
Union[float, int], opcional, padrão0.1) — A taxa de dropout para as probabilidades de atenção. - max_position_embeddings (
int, opcional, padrão514) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. - type_vocab_size (
int, opcional, padrão1) — O tamanho do vocabulário dostoken_type_ids. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - pad_token_id (
int, opcional, padrão1) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão0) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão2) — ID do token usado para o fim do fluxo no vocabulário. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - is_decoder (
bool, opcional, padrãoFalse) — Indica se o modelo é usado como decodificador ou não. SeFalse, o modelo é usado como codificador. - add_cross_attention (
bool, opcional, padrãoFalse) — Se camadas de atenção cruzada devem ser adicionadas ao modelo.
Esta é a classe de configuração para armazenar a configuração de um BridgeTowerModel. Ela é usada para instanciar um modelo Bridgetower de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do BridgeTower/bridgetower-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
BridgeTowerVisionConfig
classe transformers.BridgeTowerVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768num_hidden_layers: int = 12num_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16image_size: int | list[int] | tuple[int, int] = 288initializer_factor: float | int = 1layer_norm_eps: float = 1e-05stop_gradient: bool = Falseshare_layernorm: bool = Trueremove_last_layer: bool = False )
Parâmetros
- hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão16) — O tamanho (resolução) de cada patch. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão288) — O tamanho (resolução) de cada imagem. - initializer_factor (
Union[float, int], opcional, padrão1) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização). - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - stop_gradient (
bool, opcional, padrãoFalse) — Se deve interromper o gradiente para o treinamento. - share_layernorm (
bool, opcional, padrãoTrue) — Indica se as camadas LayerNorm são compartilhadas. - remove_last_layer (
bool, opcional, padrãoFalse) — Indica se a última camada do codificador de visão deve ser removida.
Esta é a classe de configuração para armazenar a configuração de um BridgeTowerModel. Ela é usada para instanciar um modelo Bridgetower de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do BridgeTower/bridgetower-base
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
BridgeTowerImageProcessor
classe transformers.BridgeTowerImageProcessor
< source >( **kwargs: *<class 'transformers.models.bridgetower.image_processing_bridgetower.BridgeTowerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 288}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 288}): Tamanho da imagem de saída após aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão3) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.48145466, 0.4578275, 0.40821073]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.26862954, 0.26130258, 0.27577711]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional, padrãoTrue) — Se deve recortar a imagem pelo centro. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - size_divisor (
int, kwargs, padrão32) — O tamanho pelo qual é garantido que tanto a altura quanto a largura sejam divisíveis.
Constrói um processador de imagens BridgeTowerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - image_like_kwargs (
dict[str, Any], opcional) — Flag para desenvolvedores destinada a entradas adicionais semelhantes a imagens que também serão pré-processadas. Use apenas se passar as entradas como kwarg não funcionar. Por exemplo,preprocess(images, masks=masks)é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos,preprocess(images, image_like_inputs={"masks": masks})pode ser usado em vez disso. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
BridgeTowerImageProcessorPil
classe transformers.BridgeTowerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.bridgetower.image_processing_pil_bridgetower.BridgeTowerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 288}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 288}): Tamanho da imagem de saída após aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão3) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.48145466, 0.4578275, 0.40821073]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.26862954, 0.26130258, 0.27577711]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional, padrãoTrue) — Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional, padrãoTrue) — Se deve recortar a imagem pelo centro. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - size_divisor (
int, kwargs, padrão32) — O tamanho pelo qual é garantido que tanto a altura quanto a largura sejam divisíveis.
Constrói um processador de imagens BridgeTowerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - image_like_kwargs (
dict[str, Any], opcional) — Flag para desenvolvedores destinada a entradas adicionais semelhantes a imagens que também serão pré-processadas. Use apenas se passar as entradas como kwarg não funcionar. Por exemplo,preprocess(images, masks=masks)é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos,preprocess(images, image_like_inputs={"masks": masks})pode ser usado em vez disso. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
BridgeTowerProcessor
classe transformers.BridgeTowerProcessor
< source >( image_processortokenizer )
Constrói um BridgeTowerProcessor que encapsula um processador de imagem e um tokenizador em um único processador.
BridgeTowerProcessor oferece todas as funcionalidades de BridgeTowerImageProcessor e RobertaTokenizer. Consulte ~BridgeTowerImageProcessor e ~RobertaTokenizer para mais informações.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = Nonevideos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = Noneaudio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.processing_utils.ProcessingKwargs'> )
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], opcional) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - text (
Union[str, list[str], list[list[str]]], opcional) — A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se você passar uma entrada pré-tokenizada, definais_split_into_words=Truepara evitar ambiguidade com entradas em lote. - videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]], opcional) — Vídeo a ser pré-processado. Espera um único vídeo ou um lote de vídeos com valores de pixel variando de 0 a 255. Se passar vídeos com valores de pixel entre 0 e 1, definado_rescale=False. - audio (
Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]], opcional) — O áudio ou lote de áudios a ser preparado. Cada áudio pode ser um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada áudio deve ter a forma (C, T), onde C é o número de canais e T é o comprimento de amostras do áudio. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
- **kwargs (ProcessingKwargs, opcional) — Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
BridgeTowerModel
classe transformers.BridgeTowerModel
< source >( config: BridgeTowerConfig )
Parâmetros
- config (BridgeTowerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo BridgeTower Model transformer puro, que produz um objeto BridgeTowerModelOutput sem nenhum head específico
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneimage_embeds: typing.Optional[torch.Tensor] = Noneimage_token_type_idx: int | None = Nonelabels: typing.Optional[torch.LongTensor] = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BridgeTowerModelOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- token_type_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em[0, 1]:- 0 corresponde a um token de sentence A,
- 1 corresponde a um token de sentence B.
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando BridgeTowerImageProcessor. Consulte BridgeTowerImageProcessor.call() para detalhes (BridgeTowerProcessor usa BridgeTowerImageProcessor para processar imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - image_embeds (
torch.Tensorde forma(batch_size, num_patches, hidden_size), opcional) — Opcionalmente, em vez de passarpixel_values, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converterpixel_valuesem incorporações de patches. - image_token_type_idx (
int, opcional) —- Os ids de tipo de token para imagens.
- labels (
torch.LongTensorde forma(batch_size,), opcional) — Os rótulos ainda não são suportados. - interpolate_pos_encoding (
bool, opcional, padrãoFalse) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
BridgeTowerModelOutput ou tuple(torch.Tensor)
Um BridgeTowerModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BridgeTowerConfig) e das entradas.
O método forward do BridgeTowerModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
text_features (
torch.Tensorde forma(batch_size, text_sequence_length, hidden_size)) — Sequência de hidden-states na saída de texto da última camada do modelo.image_features (
torch.Tensorde forma(batch_size, image_sequence_length, hidden_size)) — Sequência de hidden-states na saída de imagem da última camada do modelo.pooler_output (
torch.Tensorde forma(batch_size, hidden_size x 2)) — Concatenação do estado oculto da última camada do primeiro token da sequência de texto e da sequência de imagem (token de classificação), respectivamente, após processamento adicional por meio de camadas usadas para tarefas de pré-treino auxiliares.hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")

>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
BridgeTowerForContrastiveLearning
classe transformers.BridgeTowerForContrastiveLearning
< source >( config: BridgeTowerConfig )
Parâmetros
- config (BridgeTowerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo BridgeTower com uma cabeça contrastiva de imagem-texto no topo, calculando a perda contrastiva de imagem-texto.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneimage_embeds: typing.Optional[torch.Tensor] = Nonereturn_loss: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BridgeTowerContrastiveOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- token_type_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em[0, 1]:- 0 corresponde a um token de sentence A,
- 1 corresponde a um token de sentence B.
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando BridgeTowerImageProcessor. Consulte BridgeTowerImageProcessor.call() para detalhes (BridgeTowerProcessor usa BridgeTowerImageProcessor para processar imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - image_embeds (
torch.Tensorde forma(batch_size, num_patches, hidden_size), opcional) — Opcionalmente, em vez de passarpixel_values, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converterpixel_valuesem incorporações de patches. - return_loss (
bool, opcional) — Se deve ou não retornar a perda contrastiva.
Retorna
BridgeTowerContrastiveOutput ou tuple(torch.Tensor)
Um BridgeTowerContrastiveOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BridgeTowerConfig) e das entradas.
O método forward de BridgeTowerForContrastiveLearning substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandoreturn_losséTrue) — Perda contrastiva de imagem-texto.logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).text_embeds (
torch.Tensor), opcional, retornado quando o modelo é inicializado comwith_projection=True) — Os embeddings de texto obtidos ao aplicar a camada de projeção ao pooler_output.image_embeds (
torch.Tensor), optional, returned when model is initialized withwith_projection=True) — The image embeddings obtained by applying the projection layer to the pooler_output.cross_embeds (
torch.Tensor), opcional, retornado quando o modelo é inicializado comwith_projection=True) — As incorporações cruzadas de texto-imagem obtidas aplicando a camada de projeção ao pooler_output.hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).
Exemplos:
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch

>>> image_urls = [
...     "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
...     "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]

>>> with httpx.stream("GET", urls[0]) as response:
...     image1 = Image.open(BytesIO(response.read()))

>>> with httpx.stream("GET", urls[1]) as response:
...     image2 = Image.open(BytesIO(response.read()))

>>> images = [image1, image2]

>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")

>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss

>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss

>>> print("Loss", round(loss.item(), 4))
Loss 0.0019

>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
BridgeTowerForMaskedLM
classe transformers.BridgeTowerForMaskedLM
< source >( config: BridgeTowerConfig )
Parâmetros
- config (BridgeTowerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo BridgeTower com uma cabeça de modelagem de linguagem no topo, conforme feito durante o pré-treinamento.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneimage_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MaskedLMOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- token_type_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em[0, 1]:- 0 corresponde a um token de sentence A,
- 1 corresponde a um token de sentence B.
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando BridgeTowerImageProcessor. Consulte BridgeTowerImageProcessor.call() para detalhes (BridgeTowerProcessor usa BridgeTowerImageProcessor para processar imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - image_embeds (
torch.Tensorde forma(batch_size, num_patches, hidden_size), opcional) — Opcionalmente, em vez de passarpixel_values, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converterpixel_valuesem incorporações de patches. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[-100, 0, ..., config.vocab_size](veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size].
Retorna
MaskedLMOutput ou tuple(torch.Tensor)
Um MaskedLMOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BridgeTowerConfig) e das entradas.
O método forward de BridgeTowerForMaskedLM sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem mascarada (MLM).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a <mask> looking out of the window"

>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**encoding)

>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())

>>> print(results)
.a cat looking out of the window.
BridgeTowerForImageAndTextRetrieval
classe transformers.BridgeTowerForImageAndTextRetrieval
< source >( config: BridgeTowerConfig )
Parâmetros
- config (BridgeTowerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo BridgeTower transformer com uma cabeça de classificador no topo (uma camada linear no topo do estado oculto final do token [CLS]) para correspondência de imagem para texto.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneimage_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SequenceClassifierOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- token_type_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em[0, 1]:- 0 corresponde a um token de sentence A,
- 1 corresponde a um token de sentence B.
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando BridgeTowerImageProcessor. Consulte BridgeTowerImageProcessor.call() para detalhes (BridgeTowerProcessor usa BridgeTowerImageProcessor para processar imagens). - pixel_mask (
torch.LongTensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - image_embeds (
torch.Tensorde forma(batch_size, num_patches, hidden_size), opcional) — Opcionalmente, em vez de passarpixel_values, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converterpixel_valuesem incorporações de patches. - labels (
torch.LongTensorde forma(batch_size, 1), opcional) — Rótulos para o cálculo da perda de correspondência entre imagem e texto. 0 indica que os pares não correspondem e 1 indica que correspondem. Os pares com 0 serão ignorados no cálculo.
Retorna
SequenceClassifierOutput ou tuple(torch.Tensor)
Um SequenceClassifierOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BridgeTowerConfig) e das entradas.
O método forward de BridgeTowerForImageAndTextRetrieval substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).logits (
torch.Tensorde forma(batch_size, config.num_labels)) — Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]

>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

>>> # forward pass
>>> scores = dict()
>>> for text in texts:
...     # prepare inputs
...     encoding = processor(image, text, return_tensors="pt")
...     outputs = model(**encoding)
...     scores[text] = outputs.logits[0, 1].item()