
Transformers documentation
KOSMOS-2
Este modelo foi publicado em HF papers em 2023-06-26 e contribuído para Hugging Face Transformers em 2023-10-30.
KOSMOS-2
Visão geral
O modelo KOSMOS-2 foi proposto em Kosmos-2: Grounding Multimodal Large Language Models to the World por Zhiliang Peng, Wenhui Wang, Li Dong, Yaru Hao, Shaohan Huang, Shuming Ma, Furu Wei.
KOSMOS-2 é um modelo de linguagem causal baseado em Transformer e é treinado usando a tarefa de previsão da próxima palavra em um conjunto de dados em escala de web de pares de imagem-texto fundamentados GRIT. As coordenadas espaciais das caixas delimitadoras no conjunto de dados são convertidas em uma sequência de tokens de localização, que são anexados aos respectivos trechos de texto das entidades (por exemplo, a snowman seguido por <patch_index_0044><patch_index_0863>). O formato dos dados é semelhante a “hiperlinks” que conectam as regiões dos objetos em uma imagem ao seu trecho de texto na legenda correspondente.
O resumo do artigo é o seguinte:
Apresentamos o Kosmos-2, um Modelo de Linguagem Grande Multimodal (MLLM), que habilita novas capacidades de perceber descrições de objetos (por exemplo, bounding boxes) e ancorar texto ao mundo visual. Especificamente, representamos expressões referenciais como links em Markdown, ou seja, “[text span](bounding boxes)”, onde as descrições de objetos são sequências de tokens de localização. Juntamente com corpora multimodais, construímos dados em larga escala de pares de imagem-texto ancorados (chamados GrIT) para treinar o modelo. Além das capacidades existentes dos MLLMs (por exemplo, perceber modalidades gerais, seguir instruções e realizar aprendizado in-context), o Kosmos-2 integra a capacidade de ancoragem em aplicações downstream. Avaliamos o Kosmos-2 em uma ampla gama de tarefas, incluindo (i) ancoragem multimodal, como compreensão de expressões referenciais e ancoragem de frases, (ii) referência multimodal, como geração de expressões referenciais, (iii) tarefas de percepção-linguagem e (iv) compreensão e geração de linguagem. Este trabalho estabelece a base para o desenvolvimento da Embodiment AI e lança luz sobre a grande convergência de linguagem, percepção multimodal, ação e modelagem de mundo, que é um passo fundamental rumo à inteligência artificial geral. O código e os modelos pré-treinados estão disponíveis em https://aka.ms/kosmos-2.
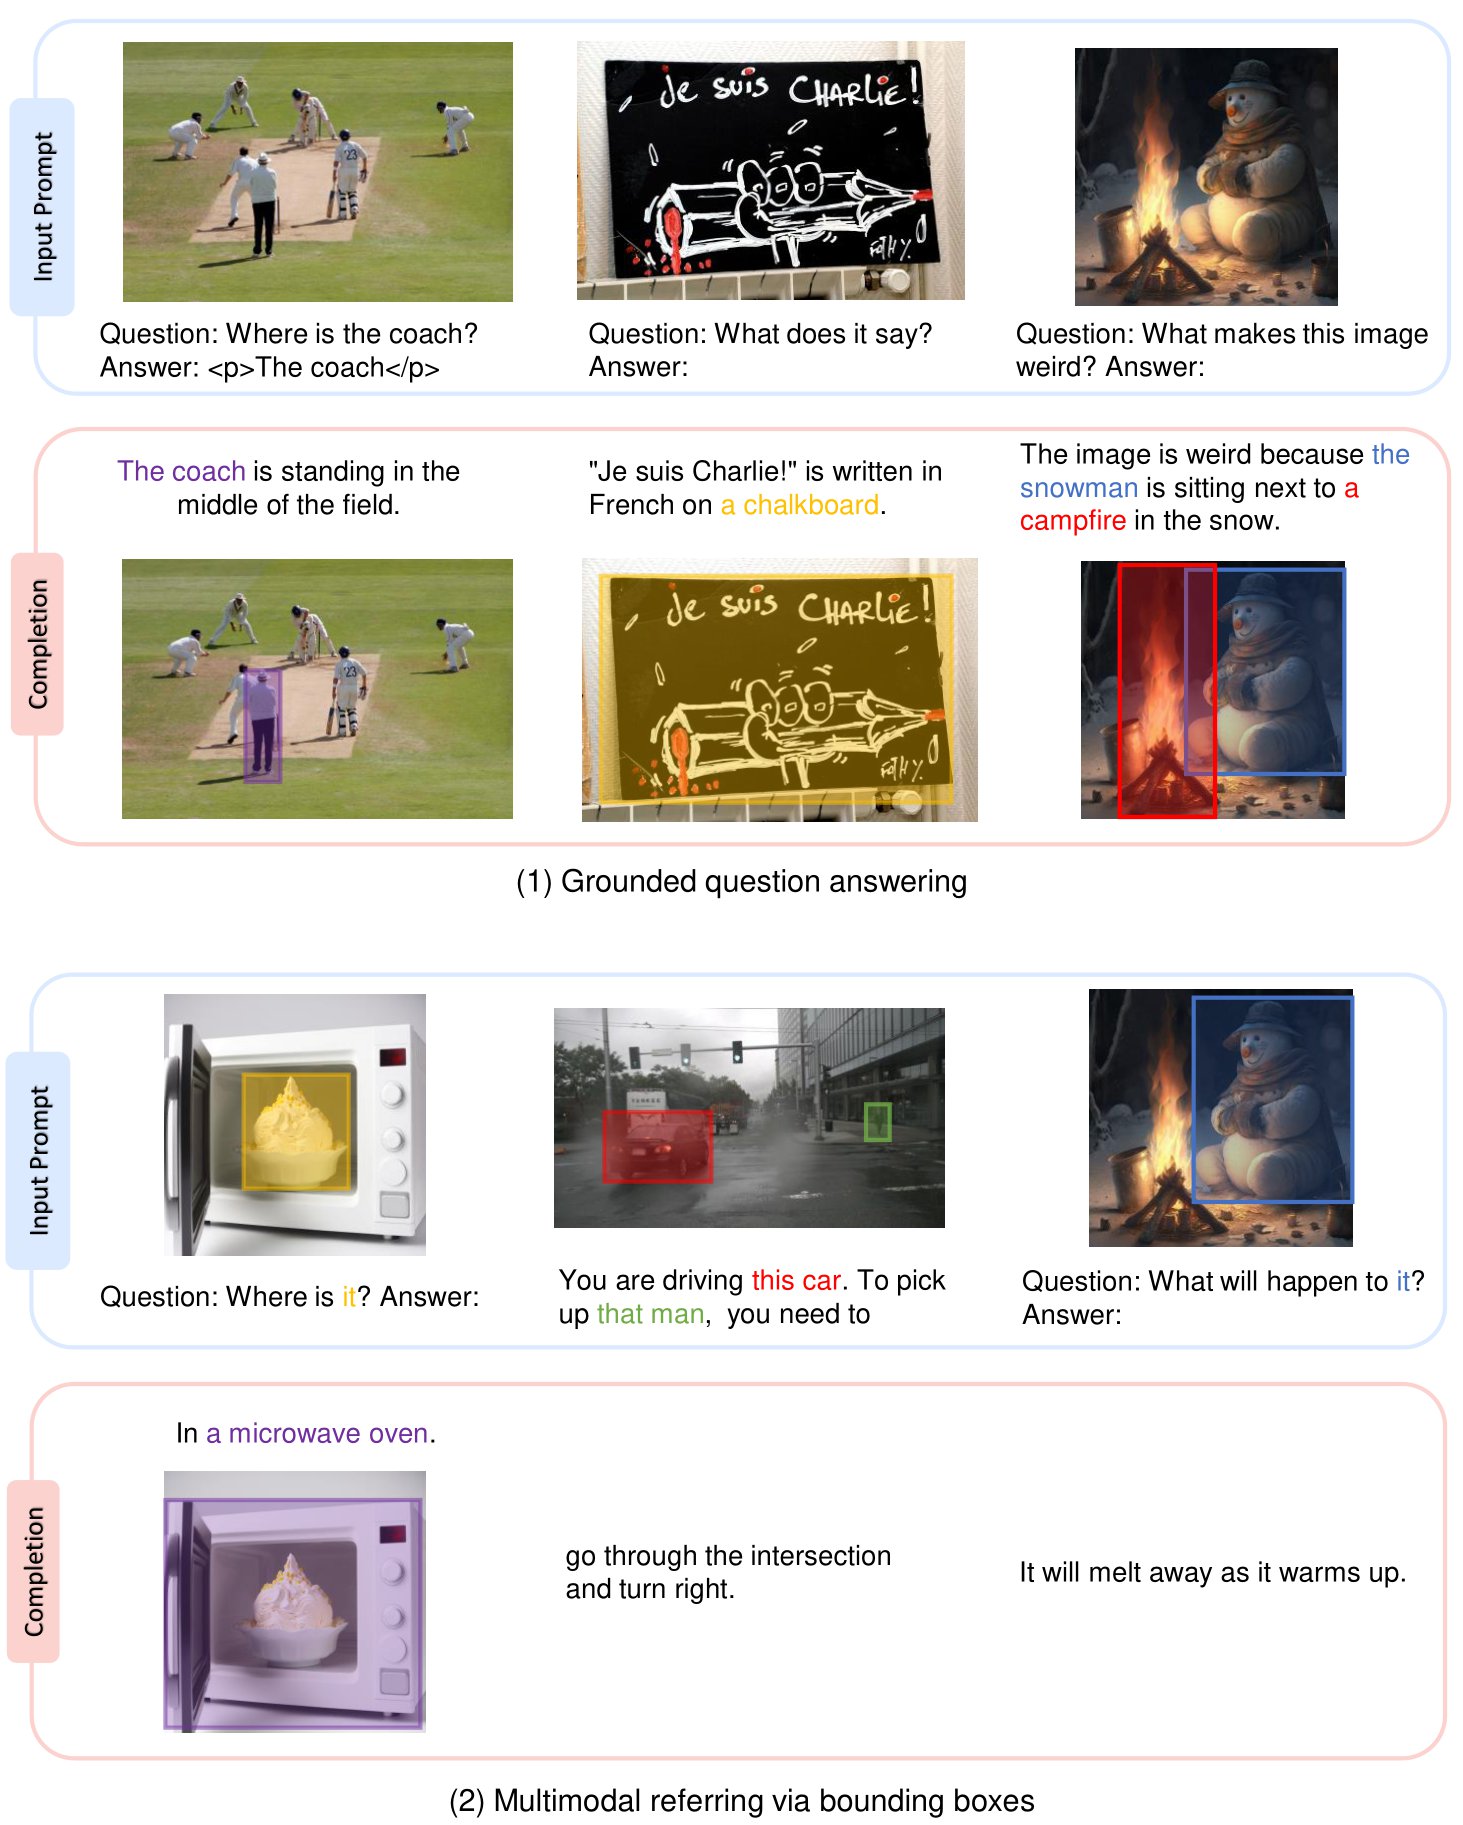 Overview of tasks that KOSMOS-2 can handle. Taken from the original paper.
Exemplo
import requests
from PIL import Image

from transformers import AutoProcessor, Kosmos2ForConditionalGeneration


model = Kosmos2ForConditionalGeneration.from_pretrained("microsoft/kosmos-2-patch14-224", device_map="auto")
processor = AutoProcessor.from_pretrained("microsoft/kosmos-2-patch14-224")

url = "https://huggingface.co/microsoft/kosmos-2-patch14-224/resolve/main/snowman.jpg"
image = Image.open(requests.get(url, stream=True).raw)

prompt = "<grounding> An image of"

inputs = processor(text=prompt, images=image, return_tensors="pt").to(model.device)

generated_ids = model.generate(
    pixel_values=inputs["pixel_values"],
    input_ids=inputs["input_ids"],
    attention_mask=inputs["attention_mask"],
    image_embeds=None,
    image_embeds_position_mask=inputs["image_embeds_position_mask"],
    use_cache=True,
    max_new_tokens=64,
)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
processed_text = processor.post_process_generation(generated_text, cleanup_and_extract=False)
processed_text
'<grounding> An image of<phrase> a snowman</phrase><object><patch_index_0044><patch_index_0863></object> warming himself by<phrase> a fire</phrase><object><patch_index_0005><patch_index_0911></object>.'

caption, entities = processor.post_process_generation(generated_text)
caption
'An image of a snowman warming himself by a fire.'

entities
[('a snowman', (12, 21), [(0.390625, 0.046875, 0.984375, 0.828125)]), ('a fire', (41, 47), [(0.171875, 0.015625, 0.484375, 0.890625)])]
Este modelo foi contribuído por Yih-Dar SHIEH. O código original pode ser encontrado aqui.
Kosmos2Config
classe transformers.Kosmos2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonelatent_query_num: int = 64tie_word_embeddings: bool = True )
Parâmetros
- text_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — O objeto de configuração ou dicionário do backbone de texto. - vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — O objeto de configuração ou dicionário do backbone de visão. - latent_query_num (
int, opcional, padrão 64) — O número de tokens de consulta latente que representam os recursos da imagem usados no componente decodificador de texto. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo.
Esta é a classe de configuração para armazenar a configuração de um Kosmos2Model. Ela é usada para instanciar um modelo Kosmos2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do microsoft/kosmos-2-patch14-224
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import Kosmos2Config, Kosmos2Model

>>> # Initializing a Kosmos-2 kosmos-2-patch14-224 style configuration
>>> configuration = Kosmos2Config()

>>> # Initializing a model (with random weights) from the kosmos-2-patch14-224 style configuration
>>> model = Kosmos2Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Kosmos2TextConfig
classe transformers.Kosmos2TextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 65037max_position_embeddings: int = 2048embed_dim: int = 2048layers: int = 24ffn_dim: int = 8192attention_heads: int = 32activation_function: str = 'gelu'dropout: float | int = 0.1attention_dropout: float | int = 0.1activation_dropout: float | int = 0.0layerdrop: float | int = 0.0layer_norm_eps: float = 1e-05init_std: float = 0.02scale_embedding: bool = Trueuse_cache: bool = Truetie_word_embeddings: bool = Truepad_token_id: int | None = 1bos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2add_cross_attention: bool = False )
Parâmetros
- vocab_size (
int, opcional, padrão65037) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - max_position_embeddings (
int, opcional, padrão2048) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. - embed_dim (
int, opcional, padrão2048) — Dimensão dos embeddings e dos estados ocultos. - layers (
int, opcional, padrão24) — Número de camadas ocultas no decodificador do Transformer. - ffn_dim (
int, opcional, padrão8192) — Dimensão das representações do MLP. - attention_heads (
int, opcional, padrão32) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - activation_function (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - dropout (
Union[float, int], opcional, padrão0.1) — A proporção para todas as camadas de dropout. - attention_dropout (
Union[float, int], opcional, padrão0.1) — A taxa de dropout para as probabilidades de atenção. - activation_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as ativações dentro da camada totalmente conectada. - layerdrop (
Union[float, int], opcional, padrão0.0) — A probabilidade de LayerDrop. Consulte o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - init_std (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - scale_embedding (
bool, opcional, padrãoTrue) — Se as embeddings devem ser escalonadas dividindo por sqrt(d_model). - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo. - pad_token_id (
int, opcional, padrão1) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão0) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão2) — ID do token usado para o fim do fluxo no vocabulário. - add_cross_attention (
bool, opcional, padrãoFalse) — Se camadas de atenção cruzada devem ser adicionadas ao modelo.
Esta é a classe de configuração para armazenar a configuração de um Kosmos2Model. Ela é usada para instanciar um modelo Kosmos2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do microsoft/kosmos-2-patch14-224
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Kosmos2VisionConfig
classe transformers.Kosmos2VisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1024intermediate_size: int = 4096num_hidden_layers: int = 24num_attention_heads: int = 16num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 14hidden_act: str = 'quick_gelu'layer_norm_eps: float = 1e-05attention_dropout: float | int = 0.0initializer_range: float = 0.02initializer_factor: float = 1.0 )
Parâmetros
- hidden_size (
int, opcional, padrão1024) — Dimensão das representações ocultas. - intermediate_size (
int, opcional, padrão4096) — Dimensão das representações do MLP. - num_hidden_layers (
int, opcional, padrão24) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão16) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão224) — O tamanho (resolução) de cada imagem. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão14) — O tamanho (resolução) de cada patch. - hidden_act (
str, opcional, padrãoquick_gelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - initializer_factor (
float, opcional, padrão1.0) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
Esta é a classe de configuração para armazenar a configuração de um Kosmos2Model. Ela é usada para instanciar um modelo Kosmos2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do microsoft/kosmos-2-patch14-224
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Kosmos2Processor
classe transformers.Kosmos2Processor
< source >( image_processortokenizernum_patch_index_tokens = 1024*kwargs )
Constrói um Kosmos2Processor que encapsula um processador de imagem e um tokenizer em um único processador.
Kosmos2Processor oferece todas as funcionalidades de image_processor_class e tokenizer_class. Consulte ~image_processor_class e ~tokenizer_class para mais informações.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] = None**kwargs: *<class 'transformers.models.kosmos2.processing_kosmos2.Kosmos2ProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], opcional) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - text (
Union[str, list[str]], opcional) — A sequência ou lote de sequências a serem codificadas. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se você passar uma entrada pré-tokenizada, definais_split_into_words=Truepara evitar ambiguidade com entradas em lote. - add_eos_token (
bool, kwargs, padrãoFalse) — Indica se o id do tokenEOSdeve ser incluído na codificação quandoadd_special_tokens=True. - bboxes (
Union[list[tuple[int]], *kwargs*, list[tuple[float]], list[list[tuple[int]]], list[list[tuple[float]]]], opcional) — As bounding boxes associadas atexts. - num_image_tokens (
int, kwargs, opcional, padrão 64) — O número de posições (consecutivas) usadas para marcar os espaços reservados que armazenam as informações da imagem. Esse valor deve ser o mesmo delatent_query_numna instância deKosmos2Configque você está usando. - first_image_token_id (
int, kwargs, opcional) — O id do token que será usado para a primeira posição da subsequência reservada para armazenar informações da imagem. Se não for definido, o valor padrão seráself.tokenizer.unk_token_id + 1. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
- **kwargs (ProcessingKwargs, opcional) — Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Kosmos2Model
classe transformers.Kosmos2Model
< source >( config: Kosmos2Config )
Parâmetros
- config (Kosmos2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo KOSMOS-2 para geração de texto e recursos de imagem. O modelo consiste em um codificador de visão e um modelo de linguagem.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_ids: typing.Optional[torch.Tensor] = Noneimage_embeds_position_mask: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneimage_embeds: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneinterpolate_pos_encoding: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Kosmos2ModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usandoimage_processor_class. Consulteimage_processor_class.__call__para mais detalhes (processor_classusaimage_processor_classpara processar as imagens). - input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- image_embeds_position_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para indicar a localização na sequência onde as características da imagem devem ser inseridas. Valores da máscara selecionados em[0, 1]:- 1 para os locais em que as características da imagem devem ser inseridas,
- 0 para posições que não são de recursos de imagem (ou seja, para tokens de texto).
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - image_embeds (
torch.Tensorde forma(batch_size, latent_query_num, hidden_size), opcional) — Sequência de estados ocultos na saída deKosmos2ImageToTextProjection. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - interpolate_pos_encoding (
bool, opcional, padrãoFalse) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
Kosmos2ModelOutput ou tuple(torch.Tensor)
Um Kosmos2ModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Kosmos2Config) e das entradas.
O método forward do Kosmos2Model sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do modelo.past_key_values (
~cache_utils.Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — Trata-se de uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se
config.is_encoder_decoder=True, nos blocos de atenção cruzada) que podem ser usados (veja a entradapast_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
image_embeds (
torch.Tensorde forma(batch_size, latent_query_num, hidden_size), opcional) — Sequência de hidden-states na saída deKosmos2ImageToTextProjection.projection_attentions (
tuple(torch.Tensor), opcional) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção fornecidos por
Kosmos2ImageToTextProjection, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.vision_model_output (
BaseModelOutputWithPooling, opcional) — A saída doKosmos2VisionModel.
Exemplos:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Kosmos2Model

>>> model = Kosmos2Model.from_pretrained("microsoft/kosmos-2-patch14-224")
>>> processor = AutoProcessor.from_pretrained("microsoft/kosmos-2-patch14-224")

>>> url = "https://huggingface.co/microsoft/kosmos-2-patch14-224/resolve/main/snowman.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> text = (
...     "<grounding> An image of<phrase> a snowman</phrase><object><patch_index_0044><patch_index_0863>"
...     "</object> warming himself by<phrase> a fire</phrase><object><patch_index_0005><patch_index_0911>"
...     "</object>"
... )

>>> inputs = processor(text=text, images=image, return_tensors="pt", add_eos_token=True)

>>> last_hidden_state = model(
...     pixel_values=inputs["pixel_values"],
...     input_ids=inputs["input_ids"],
...     attention_mask=inputs["attention_mask"],
...     image_embeds_position_mask=inputs["image_embeds_position_mask"],
... ).last_hidden_state
>>> list(last_hidden_state.shape)
[1, 91, 2048]
get_image_features
< source >( pixel_values: Tensorinterpolate_pos_encoding: bool | None = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithProjectionAttentions or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usandoimage_processor_class. Consulteimage_processor_class.__call__para mais detalhes (processor_classusaimage_processor_classpara processar as imagens). - interpolate_pos_encoding (
bool, opcional, padrãoFalse) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
BaseModelOutputWithProjectionAttentions ou tuple(torch.Tensor)
Uma BaseModelOutputWithProjectionAttentions ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Kosmos2Config) e das entradas.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.Tensorde forma(batch_size, hidden_size)) — Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional através das camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para a família de modelos BERT, isso retorna o token de classificação após o processamento através de uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
projection_attentions (
tuple(torch.Tensor)) — Tupla detorch.Tensor(uma para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção fornecidos por
Kosmos2ImageToTextProjection, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Kosmos2ForConditionalGeneration
classe transformers.Kosmos2ForConditionalGeneration
< source >( config: Kosmos2Config )
Parâmetros
- config (Kosmos2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo KOSMOS-2 para gerar texto e caixas delimitadoras a partir de uma imagem. O modelo consiste em um codificador de visão e um modelo de linguagem.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_ids: typing.Optional[torch.Tensor] = Noneimage_embeds_position_mask: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneimage_embeds: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Kosmos2ForConditionalGenerationModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usandoimage_processor_class. Consulteimage_processor_class.__call__para mais detalhes (processor_classusaimage_processor_classpara processar as imagens). - input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- image_embeds_position_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para indicar a localização na sequência onde as características da imagem devem ser inseridas. Valores da máscara selecionados em[0, 1]:- 1 para os locais em que as características da imagem devem ser inseridas,
- 0 para posições que não são de recursos de imagem (ou seja, para tokens de texto).
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - image_embeds (
torch.Tensorde forma(batch_size, latent_query_num, hidden_size), opcional) — Sequência de hidden-states na saída deKosmos2ImageToTextProjection. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem da esquerda para a direita (previsão da próxima palavra). Os índices devem estar em[-100, 0, ..., config.vocab_size](veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size] - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - logits_to_keep (
Union[int, torch.Tensor], opcional, padrão0) — Se for umint, calcula os logits para os últimoslogits_to_keeptokens. Se for0, calcula os logits para todos osinput_ids(caso especial). Apenas os logits do último token são necessários para a geração, e calculá-los apenas para esse token pode economizar memória, o que se torna bastante significativo para sequências longas ou tamanho de vocabulário grande. Se for umtorch.Tensor, deve ser 1D, correspondendo aos índices a serem mantidos na dimensão de comprimento da sequência. Isso é útil ao usar o formato de tensor empacotado (uma única dimensão para lote e comprimento da sequência).
Retorna
Kosmos2ForConditionalGenerationModelOutput ou tuple(torch.Tensor)
Um Kosmos2ForConditionalGenerationModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Kosmos2Config) e das entradas.
O método forward de Kosmos2ForConditionalGeneration substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).past_key_values (
~cache_utils.Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — Trata-se de uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se
config.is_encoder_decoder=True, nos blocos de atenção cruzada) que podem ser usados (veja a entradapast_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
image_embeds (
torch.Tensorde forma(batch_size, latent_query_num, hidden_size), opcional) — Sequência de hidden-states na saída deKosmos2ImageToTextProjection.projection_attentions (
tuple(torch.Tensor), opcional) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção fornecidos por
Kosmos2ImageToTextProjection, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.vision_model_output (
BaseModelOutputWithPooling, opcional) — A saída doKosmos2VisionModel.
Exemplos:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Kosmos2ForConditionalGeneration

>>> model = Kosmos2ForConditionalGeneration.from_pretrained("microsoft/kosmos-2-patch14-224")
>>> processor = AutoProcessor.from_pretrained("microsoft/kosmos-2-patch14-224")

>>> url = "https://huggingface.co/microsoft/kosmos-2-patch14-224/resolve/main/snowman.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> prompt = "<grounding> An image of"

>>> inputs = processor(text=prompt, images=image, return_tensors="pt")

>>> generated_ids = model.generate(
...     pixel_values=inputs["pixel_values"],
...     input_ids=inputs["input_ids"],
...     attention_mask=inputs["attention_mask"],
...     image_embeds=None,
...     image_embeds_position_mask=inputs["image_embeds_position_mask"],
...     use_cache=True,
...     max_new_tokens=64,
... )
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> processed_text = processor.post_process_generation(generated_text, cleanup_and_extract=False)
>>> processed_text
'<grounding> An image of<phrase> a snowman</phrase><object><patch_index_0044><patch_index_0863></object> warming himself by<phrase> a fire</phrase><object><patch_index_0005><patch_index_0911></object>.'

>>> caption, entities = processor.post_process_generation(generated_text)
>>> caption
'An image of a snowman warming himself by a fire.'

>>> entities
[('a snowman', (12, 21), [(0.390625, 0.046875, 0.984375, 0.828125)]), ('a fire', (41, 47), [(0.171875, 0.015625, 0.484375, 0.890625)])]