
Transformers documentation
محوّل الطيف الصوتي
نُشر هذا النموذج في أوراق HF في 2021-04-05، وأُضيف إلى مكتبة Hugging Face Transformers في 2022-11-21.
محوّل الطيف الصوتي


نظرة عامة
قُدِّم نموذج Audio Spectrogram Transformer في AST: Audio Spectrogram Transformer بواسطة Yuan Gong وYu-An Chung وJames Glass. يطبّق نموذج Audio Spectrogram Transformer Vision Transformer على الصوت، وذلك من خلال تحويل الصوت إلى صورة (طيف ترددي). ويحقق النموذج نتائج متقدمة من الطراز الأول في تصنيف الصوت.
المستخلص من الورقة البحثية هو كالتالي:
على مدى العقد الماضي، تم اعتماد الشبكات العصبية التلافيفية (CNNs) على نطاق واسع كعنصر أساسي لبناء نماذج تصنيف الصوت من الطرف إلى الطرف، والتي تهدف إلى تعلّم إسقاط مباشر من مطيافات الصوت إلى التسميات المقابلة. ولالتقاط السياق العام بعيد المدى بشكل أفضل، أصبح الاتجاه الحديث هو إضافة آلية الانتباه الذاتي فوق الشبكة التلافيفية، مما يُشكّل نموذجًا هجينًا يجمع بين CNN والانتباه. ومع ذلك، لا يزال من غير الواضح ما إذا كان الاعتماد على CNN ضروريًا، وما إذا كانت الشبكات العصبية المعتمدة كليًا على الانتباه كافية للحصول على أداء جيد في تصنيف الصوت. في هذه الورقة، نجيب عن هذا السؤال من خلال تقديم محوّل مطياف الصوت (AST)، وهو أول نموذج خالٍ من التلافيف ويعتمد كليًا على الانتباه لتصنيف الصوت. قمنا بتقييم AST على معايير مختلفة لتصنيف الصوت، حيث حقق نتائج جديدة متقدمة بلغت 0.485 mAP على AudioSet، ودقة 95.6% على ESC-50، ودقة 98.1% على Speech Commands V2.
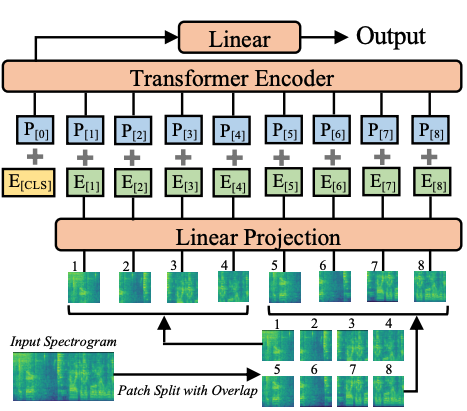 Audio Spectrogram Transformer architecture. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- عند ضبط نموذج Audio Spectrogram Transformer (AST) على مجموعة بياناتك الخاصة، يُوصى بالاهتمام بتطبيع المدخلات (لضمان أن يكون متوسط المدخلات 0 وانحرافها المعياري 0.5). يتولى ASTFeatureExtractor هذه المهمة. لاحظ أنه يستخدم متوسط AudioSet وانحرافه المعياري افتراضياً. يمكنك الاطلاع على
ast/src/get_norm_stats.pyلمعرفة كيفية حساب المؤلفين الإحصاءات لمجموعة بيانات فرعية. - لاحظ أن AST يتطلب معدل تعلم منخفض (حيث يستخدم المؤلفون معدل تعلم أصغر بعشر مرات مقارنةً بنموذج CNN الذي اقترحوه في ورقة PSLA)، كما أنه يتقارب بسرعة، لذا يُرجى البحث عن معدل تعلم وجدول زمني لمعدل التعلم مناسبين لمهمتك.
استخدام الانتباه القياسي بنقطة منتج
يتضمن PyTorch مُشغّلًا أصليًا للانتباه بنقطة جدولية مُقيّمة (SDPA) كجزء من torch.nn.functional. تشمل هذه الدالة عدة تطبيقات يمكن تطبيقها اعتمادًا على المدخلات والعتاد المستخدم. راجع التوثيق الرسمي أو صفحة GPU Inference لمزيد من المعلومات.
يُستخدم SDPA افتراضيًا لـ torch>=2.1.1 عندما تكون هناك نسخة تنفيذية متاحة، لكن يمكنك أيضًا تعيين attn_implementation="sdpa" في from_pretrained() لطلب استخدام SDPA بشكل صريح.
from transformers import ASTForAudioClassification


model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
للحصول على أفضل تسارعات، ننصح بتحميل النموذج بدقة نصفية (مثل torch.float16 أو torch.bfloat16).
في معيار محلي (A100-40GB، PyTorch 2.3.0، نظام التشغيل Ubuntu 22.04) باستخدام float32 ونموذج MIT/ast-finetuned-audioset-10-10-0.4593، لاحظنا التسارعات التالية أثناء الاستدلال.
| حجم الدفعة | متوسط زمن الاستدلال (مللي ثانية)، وضع العاجل | متوسط زمن الاستدلال (مللي ثانية)، نموذج sdpa | تسريع، Sdpa / Eager (x) |
|---|---|---|---|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء باستخدام Audio Spectrogram Transformer.
- يمكن العثور على دفتر ملاحظات يوضح الاستدلال باستخدام AST لتصنيف الصوت هنا.
- يُؤمَّن دعم ASTForAudioClassification من خلال هذا دفتر ملاحظات.
- انظر أيضاً: تصنيف الصوت.
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
ASTConfig
فئة transformers.ASTConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0initializer_range: float = 0.02layer_norm_eps: float = 1e-12patch_size: int | list[int] | tuple[int, int] = 16qkv_bias: bool = Truefrequency_stride: int = 10time_stride: int = 10max_length: int = 1024num_mel_bins: int = 128 )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم. - frequency_stride (
int، اختياري، القيمة الافتراضية 10) — خطوة التردد المستخدمة عند تقطيع الطيف الصوتي إلى قطع. - time_stride (
int، اختياري، القيمة الافتراضية 10) — خطوة زمنية تُستخدم عند تقطيع الطيف الصوتي إلى قطع. - max_length (
int، اختياري، القيمة الافتراضية 1024) — البُعد الزمني للتمثيلات الطيفية. - num_mel_bins (
int، اختياري، القيمة الافتراضية128) — عدد ميزات mel المستخدمة لكل إطار إدخال. يجب أن يتوافق مع القيمة المستخدمة في فئةAutoFeatureExtractor.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Audio Spectrogram Transformer. تُستخدم لاستحداث نموذج Audio Spectrogram Transformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ MIT/ast-finetuned-audioset-10-10-0.4593
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import ASTConfig, ASTModel

>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()

>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ASTFeatureExtractor
فئة transformers.ASTFeatureExtractor
< source >( feature_size = 1sampling_rate = 16000num_mel_bins = 128max_length = 1024padding_value = 0.0do_normalize = Truemean = -4.2677393std = 4.5689974return_attention_mask = False**kwargs )
المعاملات
- feature_size (
int، اختياري، القيمة الافتراضية 1) — أبعاد الميزة للميزات المستخرجة. - sampling_rate (
int, اختياري، القيمة الافتراضية 16000) — معدل أخذ العينات الذي يجب أن تُرقَم به ملفات الصوت، ويُعبَّر عنه بالهرتز (Hz). - num_mel_bins (
int، اختياري، القيمة الافتراضية 128) — عدد نوافذ ترددات Mel. - max_length (
int، اختياري، القيمة الافتراضية 1024) — الحد الأقصى للطول الذي يتم من خلاله توسيد/تقليص الميزات المستخرجة. - do_normalize (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع ميزات log-Mel باستخدامmeanوstdأم لا. - mean (
float، اختياري، القيمة الافتراضية -4.2677393) — القيمة المتوسطة المستخدمة لتطبيع ميزات log-Mel. يستخدم متوسط AudioSet افتراضيًا. - std (
float، اختياري، القيمة الافتراضية 4.5689974) — قيمة الانحراف المعياري المستخدمة لتطبيع ميزات log-Mel. يستخدم انحراف AudioSet المعياري افتراضيًا. - return_attention_mask (
bool، اختياري، الافتراضيFalse) — ما إذا كان ينبغي لـ call() إرجاعattention_maskأم لا.
ينشئ مستخرج ميزات Audio Spectrogram Transformer (AST).
يرث مستخرج الميزات هذا من SequenceFeatureExtractor الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
تستخرج هذه الفئة ميزات بنك مرشحات الميّل من الكلام الخام باستخدام TorchAudio إذا كان مثبتاً، أو باستخدام numpy في حال عدم توفّره، ثم تُضيف حشواً أو تقصّرها إلى طول ثابت، وتُطبّق عليها عملية تطبيع باستخدام المتوسط والانحراف المعياري.
__call__
< source >( raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]]sampling_rate: int | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = None**kwargs )
المعاملات
- raw_speech (
np.ndarray،list[float]،list[np.ndarray]،list[list[float]]) — التسلسل أو الدفعة من التسلسلات التي سيتم ملؤها. يمكن أن يكون كل تسلسل مصفوفة numpy، أو قائمة من قيم float، أو قائمة من مصفوفات numpy، أو قائمة من قوائم قيم float. يجب أن يكون الصوت أحادي القناة وليس ستيريو، أي قيمة float واحدة لكل خطوة زمنية. - sampling_rate (
int, اختياري) — معدل أخذ العينات الذي تم به أخذ عينات مدخلraw_speech. يُوصى بشدة بتمريرsampling_rateعند استدعاء forward لمنع الأخطاء الصامتة. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات بدلاً من قائمة من الأعداد الصحيحة في Python. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن نوع Numpy.
الطريقة الرئيسية لتحويل السلسلة أو السلاسل إلى ميزات وتجهيزها للنموذج.
ASTModel
فئة transformers.ASTModel
< source >( config: ASTConfig )
المعاملات
- config (ASTConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Audio Spectrogram Transformer الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, max_length, num_mel_bins)) — قيم عائمة لميزات mel المستخرجة من موجة الصوت الخام. يمكن الحصول على موجة الصوت الخام عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال عبر مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_features، يجب استخدام AutoFeatureExtractor لاستخراج ميزات mel، وإضافة الحشو، والتحويل إلى tensor من النوعtorch.Tensor. راجع call() - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
BaseModelOutputWithPooling أو tuple(torch.Tensor)
BaseModelOutputWithPooling أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على التهيئة (ASTConfig) والمدخلات.
تُعيد طريقة ASTModel الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.pooler_output (
torch.Tensorمن الشكل(batch_size, hidden_size)) — حالة الطبقة المخفية الأخيرة للرمز الأول من التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. تُدرَّب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
ASTForAudioClassification
فئة transformers.ASTForAudioClassification
< source >( config: ASTConfig )
المعاملات
- config (ASTConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Audio Spectrogram Transformer مع رأس تصنيف صوتي في الأعلى (طبقة خطية فوق المخرجات المجمّعة) على سبيل المثال لمجموعات بيانات مثل AudioSet وSpeech Commands v2.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SequenceClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, max_length, num_mel_bins)) — قيم عائمة لميزات mel المستخرجة من موجة الصوت الخام. يمكن الحصول على موجة الصوت الخام عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال عبر مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_features، يجب استخدام AutoFeatureExtractor لاستخراج ميزات mel، وإضافة الحشو، والتحويل إلى tensor من النوعtorch.Tensor. راجع call() - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/انحدار الصوت. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
SequenceClassifierOutput أو tuple(torch.Tensor)
SequenceClassifierOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (ASTConfig) والمدخلات.
تُعيد طريقة ASTForAudioClassification الأمامية تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...

>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...