
Transformers documentation
Wav2Vec2
نُشر هذا النموذج في أوراق HF في 2020-06-20، وأُضيف إلى مكتبة Hugging Face Transformers في 2021-02-02.
Wav2Vec2


نظرة عامة
قُدِّم نموذج Wav2Vec2 في wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations بواسطة Alexei Baevski وHenry Zhou وAbdelrahman Mohamed وMichael Auli.
المستخلص من الورقة البحثية هو كالتالي:
نُظهر لأول مرة أن تعلّم تمثيلات قوية من الصوت المنطوق وحده، يليه ضبط دقيق على صوت منطوق مُنصَت، يمكن أن يتفوق على أفضل الأساليب شبه المُشرَّحة مع البساطة المفاهيمية. يقوم wav2vec 2.0 بإخفاء مدخلات الصوت في الفضاء الكامن، ويحلّ مهمة تباينية معرّفة على كمّية من التمثيلات الكامنة التي يتم تعلّمها بشكل مشترك. تحقق التجارب باستخدام جميع البيانات المُوسَّمة من Librispeech من معدل خطأ كلمات 1.8/3.3 على مجموعات الاختبار النظيفة/الأخرى. عند تقليل كمية البيانات المُوسَّمة إلى ساعة واحدة، يتفوق wav2vec 2.0 على أحدث تقنيات سابقة على مجموعة فرعية من 100 ساعة، مع استخدام بيانات مُوسَّمة أقل بمئة مرة. وحتى باستخدام عشر دقائق فقط من البيانات المُوسَّمة مع تدريب مسبق على 53 ألف ساعة من البيانات غير المُوسَّمة، يتحقق معدل خطأ كلمات 4.8/8.2. وهذا يُثبت جدوى التعرف على الكلام مع كميات محدودة من البيانات المُوسَّمة.
تمت مساهمة هذا النموذج من قِبل patrickvonplaten.
ملاحظة: أصدرت Meta (FAIR) إصدارًا جديدًا من Wav2Vec2-BERT 2.0 - تم تدريبه مسبقًا على 4.5 مليون ساعة من الصوت. ننصح بشكل خاص باستخدامه لمهام الضبط الدقيق، على سبيل المثال وفقًا لـ هذا الدليل.
اضبط
use_kernels=Trueفي from_pretrained() لاستبدال الطبقات المدعومة بنوى مُحسَّنة من Hub. راجع تحميل النوى لمعرفة المزيد.
نصائح للاستخدام
- Wav2Vec2 هو نموذج كلامي يقبل مصفوفة من الأرقام العشرية (float) تتوافق مع الموجة الخام لإشارة الكلام.
- تم تدريب نموذج Wav2Vec2 باستخدام التصنيف الزمني المتصل (CTC)، لذا يجب فك ترميز مخرجات النموذج باستخدام Wav2Vec2CTCTokenizer.
استخدام Flash Attention 2
Flash Attention 2 هي نسخة أسرع ومحسّنة من النموذج.
التثبيت
أولاً، تحقق من توافق عتادك مع Flash Attention 2. يمكن العثور على أحدث قائمة بالعتاد المتوافق في التوثيق الرسمي.
بعد ذلك، ثبّت أحدث إصدار من Flash Attention 2:
pip install -U flash-attn --no-build-isolation
الاستخدام
لتحميل نموذج باستخدام Flash Attention 2، يمكننا تمرير الحجة attn_implementation="flash_attention_2" إلى from_pretrained(). كما سنقوم بتحميل النموذج بدقة نصفية (مثل torch.float16)، لأن ذلك يؤدي إلى تدهور شبه معدوم في جودة الصوت مع انخفاض كبير في استهلاك الذاكرة وتسريع لعملية الاستدلال:
from transformers import Wav2Vec2Model


model = Wav2Vec2Model.from_pretrained("facebook/wav2vec2-large-960h-lv60-self", attn_implementation="flash_attention_2", device_map="auto")
...
التسارعات المتوقعة
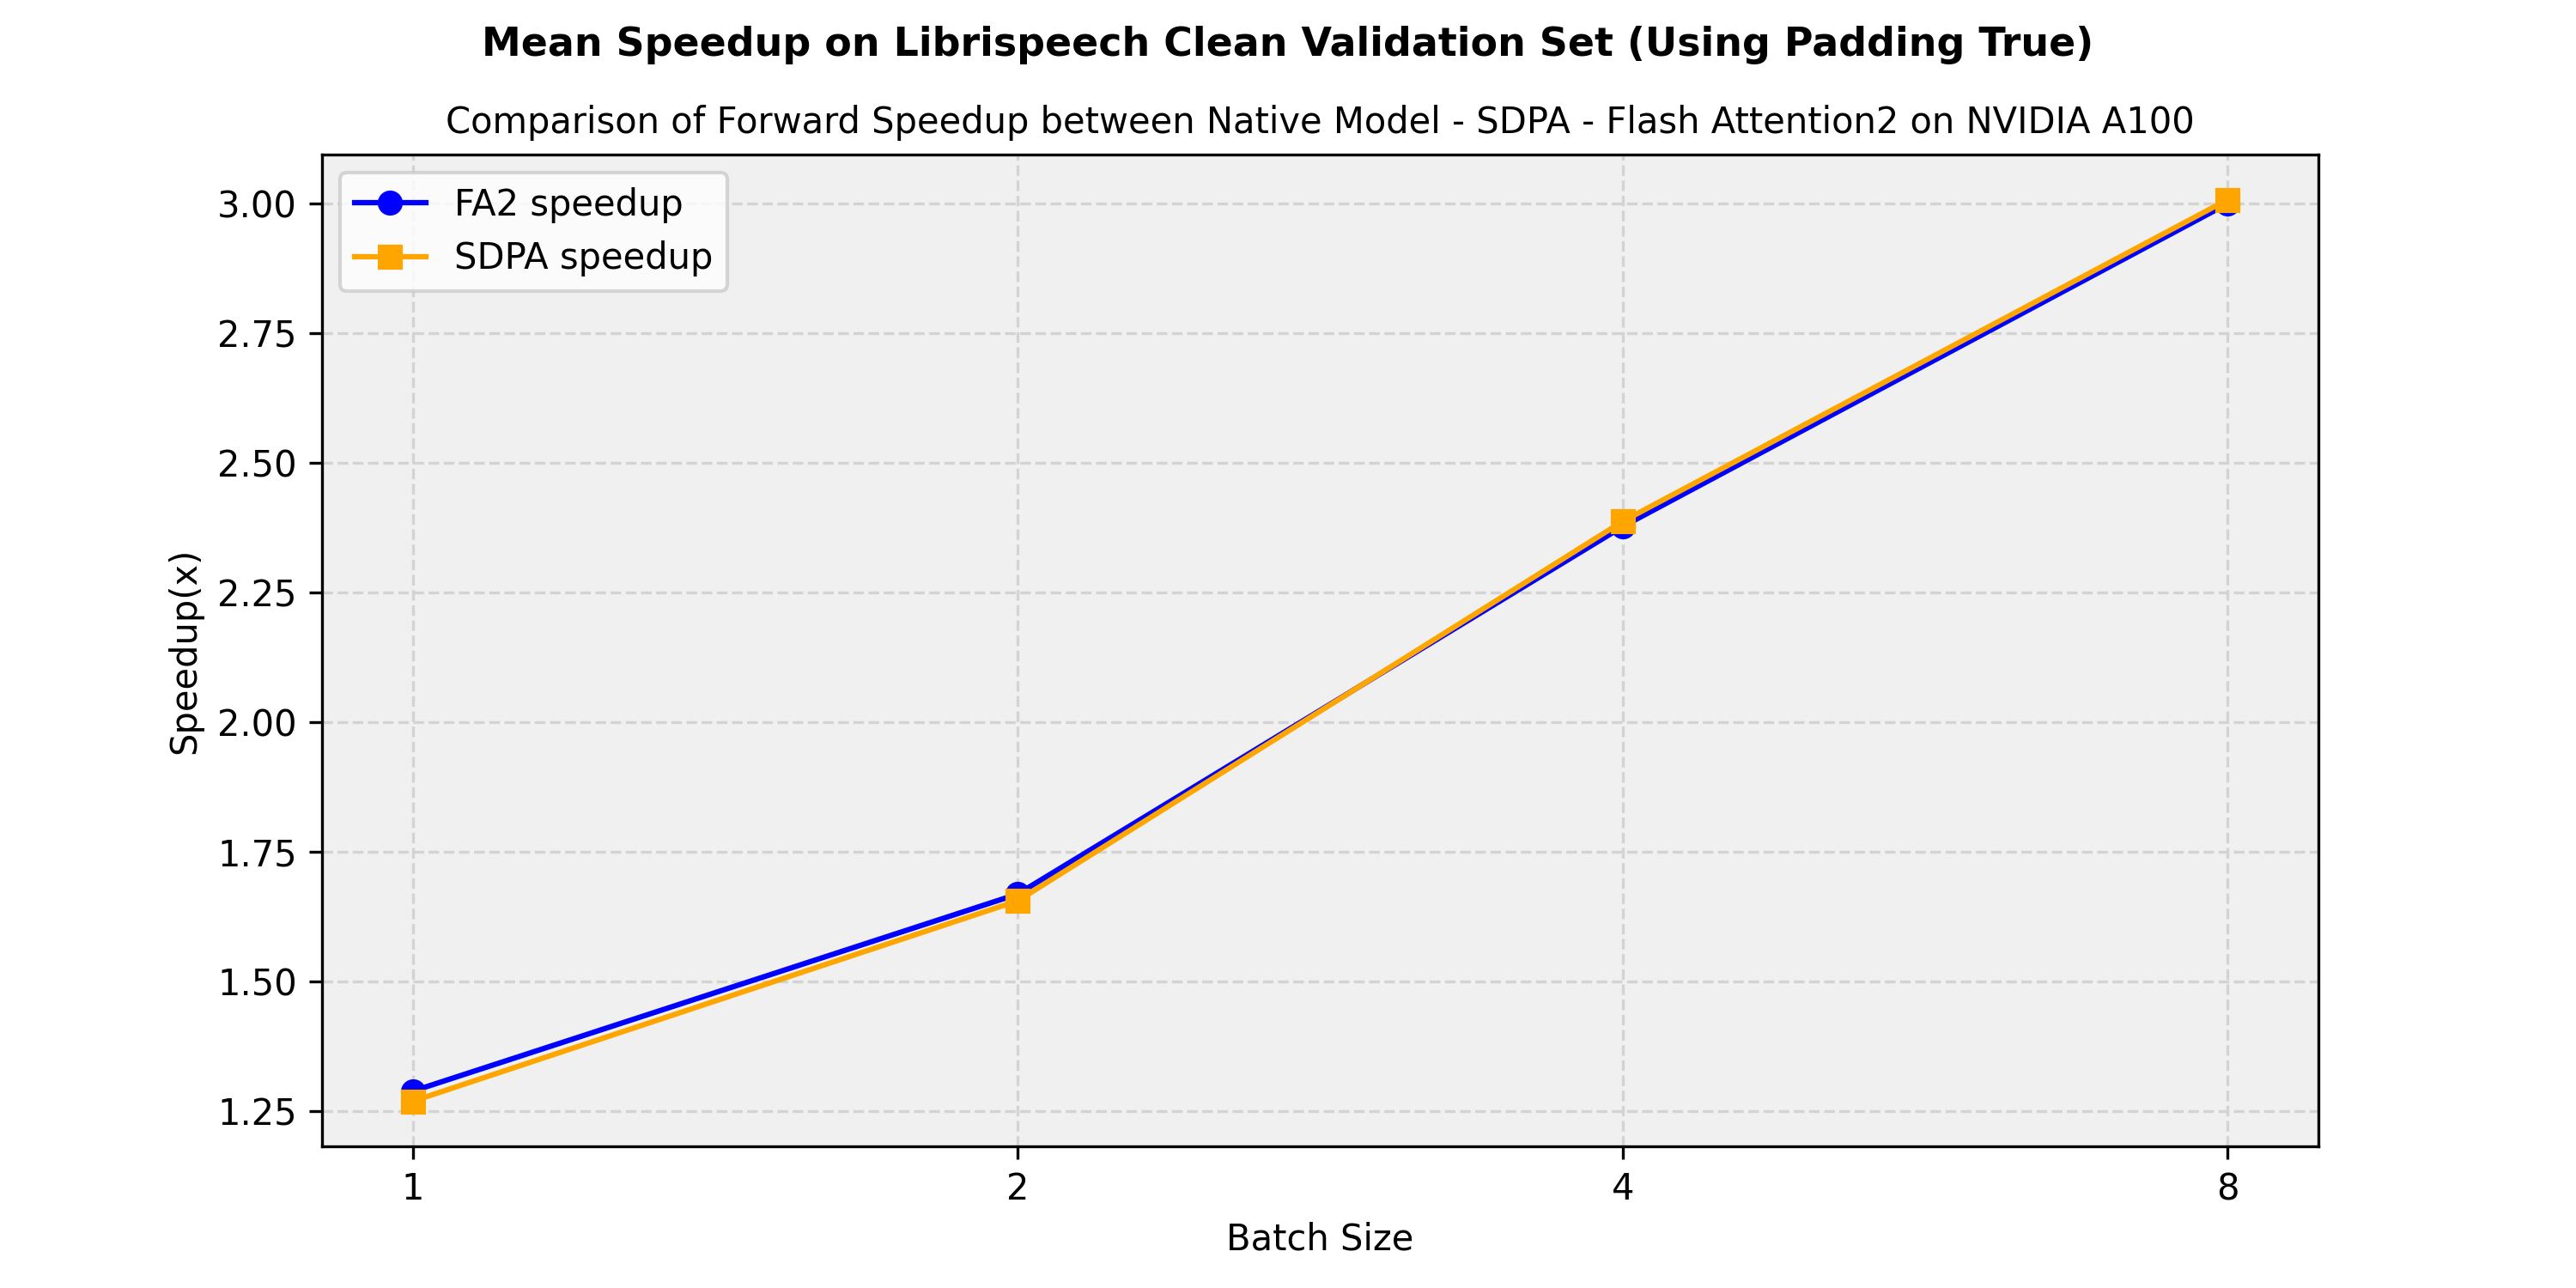
فيما يلي مخطط يُظهر التسريع المتوقع عند مقارنة زمن الاستدلال الخالص بين التنفيذ الأصلي في transformers لنموذج facebook/wav2vec2-large-960h-lv60-self والإصدارين flash-attention-2 و sdpa (scale-dot-product-attention). نُظهر متوسط التسريع المحقق على مجموعة التحقق librispeech_asr clean:
الموارد
قائمة بموارد رسمية من Hugging Face وموارد من المجتمع (المشار إليها بـ 🌎) لمساعدتك على البدء مع Wav2Vec2. إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب (Pull Request) وسنقوم بمراجعته! يُفضّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
- دفتر ملاحظات حول كيفية الاستفادة من نموذج Wav2Vec2 مُدرَّب مسبقًا لتصنيف المشاعر. 🌎
- يُؤمّن هذا دفتر الملاحظات دعمًا لـ Wav2Vec2ForCTC.
- دليل مهمة تصنيف الصوت
- منشور على المدونة حول تعزيز Wav2Vec2 باستخدام n-grams في 🤗 Transformers.
- منشور على المدونة حول كيفية ضبط نموذج Wav2Vec2 لخدمة التعرف على الكلام بالإنجليزية باستخدام 🤗 Transformers.
- مقال مدونة حول ضبط XLS-R لخدمة التعرف على الكلام متعددة اللغات باستخدام 🤗 Transformers.
- دفتر ملاحظات حول كيفية إنشاء ترجمات لفيديوهات يوتيوب من أي فيديو عبر استنساخ الصوت باستخدام Wav2Vec2. 🌎
- يُؤمَّن دعم Wav2Vec2ForCTC عبر دفتر ملاحظات حول كيفية ضبط نموذج التعرف على الكلام باللغة الإنجليزية، وكيفية ضبط نموذج التعرف على الكلام بأي لغة.
- دليل مهمة التعرف التلقائي على الكلام
🚀 النشر
- منشور على المدونة حول كيفية نشر Wav2Vec2 لـ التعرف التلقائي على الكلام باستخدام Transformers من Hugging Face و Amazon SageMaker.
Wav2Vec2Config
فئة transformers.Wav2Vec2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int | None = 32hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout: float | int = 0.1activation_dropout: float | int = 0.1attention_dropout: float | int = 0.1feat_proj_dropout: float | int = 0.0feat_quantizer_dropout: float | int = 0.0final_dropout: float | int = 0.1layerdrop: float | int = 0.1initializer_range: float = 0.02layer_norm_eps: float = 1e-05feat_extract_norm: str = 'group'feat_extract_activation: str = 'gelu'conv_dim: list[int] | tuple[int, ...] = (512, 512, 512, 512, 512, 512, 512)conv_stride: list[int] | tuple[int, ...] = (5, 2, 2, 2, 2, 2, 2)conv_kernel: list[int] | tuple[int, ...] = (10, 3, 3, 3, 3, 2, 2)conv_bias: bool = Falsenum_conv_pos_embeddings: int = 128num_conv_pos_embedding_groups: int = 16do_stable_layer_norm: bool = Falseapply_spec_augment: bool = Truemask_time_prob: float | int = 0.05mask_time_length: int = 10mask_time_min_masks: int = 2mask_feature_prob: float | int = 0.0mask_feature_length: int = 10mask_feature_min_masks: int = 0num_codevectors_per_group: int = 320num_codevector_groups: int = 2contrastive_logits_temperature: float = 0.1num_negatives: int = 100codevector_dim: int = 256proj_codevector_dim: int = 256diversity_loss_weight: float = 0.1ctc_loss_reduction: str = 'sum'ctc_zero_infinity: bool = Falseuse_weighted_layer_sum: bool = Falseclassifier_proj_size: int = 256tdnn_dim: list[int] | tuple[int, ...] = (512, 512, 512, 512, 1500)tdnn_kernel: list[int] | tuple[int, ...] = (5, 3, 3, 1, 1)tdnn_dilation: list[int] | tuple[int, ...] = (1, 2, 3, 1, 1)xvector_output_dim: int = 512pad_token_id: int | None = 0bos_token_id: int | None = 1eos_token_id: int | list[int] | None = 2add_adapter: bool = Falseadapter_kernel_size: int = 3adapter_stride: int = 2num_adapter_layers: int = 3output_hidden_size: int | None = Noneadapter_attn_dim: int | None = None )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية32) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمالية dropout لجميع الطبقات المتصلة بالكامل في التضمينات والمُشفِّر (encoder) والمُجمِّع (pooler). - activation_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة dropout للتفعيلات داخل الطبقة المتصلة بالكامل. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - feat_proj_dropout (
float, اختياري، القيمة الافتراضية 0.0) — احتمالية الإسقاط (dropout) لمخرج مُشفِّر الميزات. - feat_quantizer_dropout (
float, اختياري، القيمة الافتراضية 0.0) — احتمال الإسقاط (dropout) الخاص بمخرج مُشفِّر الميزات الذي يستخدمه المُكمِّم (quantizer). - final_dropout (
float، اختياري، القيمة الافتراضية 0.1) — احتمالية الإسقاط (dropout) لطبقة الإسقاط النهائية في Wav2Vec2ForCTC. - layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمالية LayerDrop. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - feat_extract_norm (
str، اختياري، القيمة الافتراضية"group") — التطبيع الذي يُطبَّق على طبقات الالتفاف أحادية البعد في مُرمِّز الميزات. إما"group"لتطبيع المجموعات على الطبقة الالتفافية أحادية البعد الأولى فقط، أو"layer"لتطبيع الطبقات على جميع طبقات الالتفاف أحادية البعد. - feat_extract_activation (
str,optional, defaults to“gelu”) -- The non-linear activation function (function or string) in the 1D convolutional layers of the feature extractor. If string,“gelu”,“relu”,“selu”and“gelu_new”` are supported. - conv_dim (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية(512, 512, 512, 512, 512, 512, 512)) — مجموعة من الأعداد الصحيحة تحدد عدد قنوات الإدخال والإخراج لكل طبقة تلافيفية أحادية البعد في مشفّر الميزات. يحدد طول conv_dim عدد طبقات التلافيف أحادية البعد. - conv_stride (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية(5, 2, 2, 2, 2, 2, 2)) — مجموعة من الأعداد الصحيحة تُعرّف خطوة (stride) كل طبقة تلافيفية أحادية البعد في مُشفِّر الميزات. يحدد طول conv_stride عدد الطبقات التلافيفية، ويجب أن يطابق طول conv_dim. - conv_kernel (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية(10, 3, 3, 3, 3, 3, 3)) — مجموعة من الأعداد الصحيحة تحدد حجم النواة لكل طبقة تلافية أحادية البعد في مشفّر الميزات. يحدد طول conv_kernel عدد الطبقات التلافية، ويجب أن يطابق طول conv_dim. - conv_bias (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كانت طبقات الالتفاف أحادية البعد تحتوي على انحياز. - num_conv_pos_embeddings (
int، اختياري، القيمة الافتراضية 128) — عدد التضمينات الموضعية التلافيفية. يحدد حجم النواة لطبقة التضمينات الموضعية التلافيفية أحادية البعد. - num_conv_pos_embedding_groups (
int، اختياري، القيمة الافتراضية 16) — عدد مجموعات طبقة التضمينات الموضعية التحويلية أحادية البُعد. - do_stable_layer_norm (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تطبيق معمارية stable لطبقة normalization في مُشفِّر Transformer. يتوافقdo_stable_layer_norm is Trueمع تطبيق طبقة normalization قبل طبقة الانتباه، بينما يتوافقdo_stable_layer_norm is Falseمع تطبيق طبقة normalization بعد طبقة الانتباه. - apply_spec_augment (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيق توسيع البيانات SpecAugment على مخرجات مُشفِّر الميزات. للاطلاع على المرجع، راجع SpecAugment: A Simple Data Augmentation Method for Automatic Speech Recognition. - mask_time_prob (
float, optional, defaults to 0.05) — Percentage (between 0 and 1) of all feature vectors along the time axis which will be masked. The masking procedure generates ”mask_time_problen(time_axis)/mask_time_length” independent masks over the axis. If reasoning from the probability of each feature vector to be chosen as the start of the vector span to be masked, mask_time_prob should be `prob_vector_startmask_time_length. Note that overlap may decrease the actual percentage of masked vectors. This is only relevant ifapply_spec_augment is True`. - mask_time_length (
int، اختياري، القيمة الافتراضية 10) — طول امتداد المتجه على محور الزمن. - mask_time_min_masks (
int, اختياري، القيمة الافتراضية 2)، — الحد الأدنى لعدد الأقنعة بطولmask_feature_lengthالتي يتم توليدها على محور الزمن، في كل خطوة زمنية، بغض النظر عنmask_feature_prob. لا يكون ذا صلة إلا إذا كان ”mask_time_prob*len(time_axis)/mask_time_length < mask_time_min_masks” - mask_feature_prob (
float, optional, defaults to 0.0) — Percentage (between 0 and 1) of all feature vectors along the feature axis which will be masked. The masking procedure generates ”mask_feature_problen(feature_axis)/mask_time_length” independent masks over the axis. If reasoning from the probability of each feature vector to be chosen as the start of the vector span to be masked, mask_feature_prob should be `prob_vector_startmask_feature_length. Note that overlap may decrease the actual percentage of masked vectors. This is only relevant ifapply_spec_augment is True`. - mask_feature_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — النسبة المئوية (بين 0 و 1) لجميع متجهات الميزات على محور الميزات التي سيتم إخفاؤها. يولّد إجراء الإخفاءmask_feature_prob*len(feature_axis)/mask_time_lengthأقنعة مستقلة على المحور. إذا كنت تستنتج من احتمال اختيار كل متجه ميزات كنقطة بداية للمدى الذي سيُخفى، فيجب أن تكون قيمة mask_feature_prob هيprob_vector_start*mask_feature_length. لاحظ أن التداخل قد يقلل من النسبة الفعلية للمتجهات المخفية. لا ينطبق هذا إلا إذا كانت قيمةapply_spec_augmentهيTrue. - mask_feature_length (
int، اختياري، القيمة الافتراضية 10) — طول النطاق المتجهي على محور الميزة. - mask_feature_min_masks (
int, اختياري، القيمة الافتراضية 0)، — الحد الأدنى لعدد الأقنعة بطولmask_feature_lengthالتي يتم توليدها على طول محور الميزة، في كل خطوة زمنية، بغض النظر عنmask_feature_prob. لا ينطبق إلا إذا كان ”mask_feature_prob*len(feature_axis)/mask_feature_length < mask_feature_min_masks” - num_codevectors_per_group (
int، اختياري، القيمة الافتراضية 320) — عدد العناصر في كل كتاب تكميم (مجموعة). - num_codevectors_per_group (
int، اختياري، القيمة الافتراضية 320) — عدد العناصر في كل كتاب تكميم (مجموعة). - num_codevector_groups (
int, اختياري، القيمة الافتراضية 2) — عدد مجموعات متجهات الترميز (codevector groups) لاختزال متجهات الترميز الضربي (product codevector quantization). - contrastive_logits_temperature (
float، اختياري، القيمة الافتراضية 0.1) — درجة الحرارة kappa في دالة الخسارة التباينية. - num_negatives (
int، اختياري، القيمة الافتراضية 100) — عدد العينات السالبة لخسارة التباينية. - codevector_dim (
int، اختياري، القيمة الافتراضية 256) — أبعاد متجهات الميزات المُكمّاة. - proj_codevector_dim (
int، اختياري، القيمة الافتراضية 256) — أبعاد الإسقاط النهائي لكل من الميزات المُكمّاة وميزات المحوّل. - diversity_loss_weight (
int، اختياري، القيمة الافتراضية 0.1) — وزن مكوّن خسارة تنوّع كودبوك. - ctc_loss_reduction (
str، اختياري، القيمة الافتراضية"sum") — يحدد طريقة الاختزال (reduction) المطبقة على مخرجاتtorch.nn.CTCLoss. لا ينطبق إلا عند تدريب نسخة من Wav2Vec2ForCTC. - ctc_zero_infinity (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم تصفير الخسائر اللانهائية والتدرجات المرتبطة بها فيtorch.nn.CTCLoss. تحدث الخسائر اللانهائية بشكل رئيسي عندما تكون المدخلات قصيرة جداً بحيث لا يمكن محاذاة الأهداف. لا ينطبق إلا عند تدريب مثيل من Wav2Vec2ForCTC. - use_weighted_layer_sum (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام متوسط مرجح لمخرجات الطبقات بأوزان متعلمة. لا ينطبق إلا عند استخدام كائن من Wav2Vec2ForSequenceClassification. - classifier_proj_size (
int، اختياري، القيمة الافتراضية 256) — أبعاد الإسقاط قبل متوسط تجميع الرموز للتصنيف. - tdnn_dim (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية(512, 512, 512, 512, 1500)) — مجموعة من الأعداد الصحيحة تحدد عدد قنوات الإخراج لكل طبقة تلافيفية أحادية البعد في وحدة TDNN من نموذج XVector. يحدد طول tdnn_dim عدد طبقات TDNN. - tdnn_kernel (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية(5, 3, 3, 1, 1)) — مجموعة من الأعداد الصحيحة تحدد حجم النواة لكل طبقة تلافيفية أحادية البعد في وحدة TDNN ضمن نموذج XVector. يجب أن يطابق طول tdnn_kernel طول tdnn_dim. - tdnn_dilation (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية(1, 2, 3, 1, 1)) — مجموعة من الأعداد الصحيحة تحدد عامل التمدد (dilation) لكل طبقة تلافيفية أحادية البعد في وحدة TDNN ضمن نموذج XVector. يجب أن يطابق طول tdnn_dilation طول tdnn_dim. - xvector_output_dim (
int، اختياري، القيمة الافتراضية 512) — أبعاد متجهات التضمين XVector. - pad_token_id (
int، اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int، اختياري، القيمة الافتراضية1) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]]، اختياري، القيمة الافتراضية2) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - add_adapter (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب تجميع شبكة تلافيفية فوق مُشفِّر Wav2Vec2. قد يكون مفيداً جداً لبدء تشغيل Wav2Vec2 بشكل دافئ لنماذج SpeechEncoderDecoder. - adapter_kernel_size (
int، اختياري، القيمة الافتراضية 3) — حجم النواة للطبقات التلافيفية في شبكة المحوّل. لا ينطبق إلا إذا كانadd_adapter is True. - adapter_stride (
int، اختياري، القيمة الافتراضية 2) — خطوة طبقات الالتفاف في شبكة المحوّل. لا ينطبق إلا إذا كانadd_adapter is True. - num_adapter_layers (
int، اختياري، القيمة الافتراضية 3) — عدد طبقات الالتفاف التي يجب استخدامها في شبكة المحوّل. لا ينطبق إلا إذا كانadd_adapter is True. - output_hidden_size (
int، اختياري) — أبعاد طبقة مخرج المُشفِّر. إذا لم يُعرَّف، فإن القيمة الافتراضية هي hidden-size. لا ينطبق إلا إذا كانadd_adapter is True. - adapter_attn_dim (
int, اختياري) — أبعاد أوزان مُكيّف الانتباه (attention adapter) المستخدمة في كل كتلة انتباه. مثال على نموذج يستخدم مُكيّفات الانتباه هو facebook/mms-1b-all.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Wav2Vec2Model. تُستخدم لإنشاء نموذج Wav2Vec2 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/wav2vec2-base-960h
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import Wav2Vec2Config, Wav2Vec2Model

>>> # Initializing a Wav2Vec2 facebook/wav2vec2-base-960h style configuration
>>> configuration = Wav2Vec2Config()

>>> # Initializing a model (with random weights) from the facebook/wav2vec2-base-960h style configuration
>>> model = Wav2Vec2Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Wav2Vec2CTCTokenizer
فئة transformers.Wav2Vec2CTCTokenizer
< source >( vocab_filebos_token = '<s>'eos_token = '</s>'unk_token = '<unk>'pad_token = '<pad>'word_delimiter_token = '|'replace_word_delimiter_char = ' 'do_lower_case = Falsetarget_lang = None**kwargs )
المعاملات
- vocab_file (
str) — ملف يحتوي على المفردات. - bos_token (
str، اختياري، القيمة الافتراضية"<s>") — رمز بداية الجملة. - eos_token (
str، اختياري، القيمة الافتراضية"</s>") — رمز نهاية الجملة. - unk_token (
str، اختياري، القيمة الافتراضية"<unk>") — رمز المجهول. لا يمكن تحويل الرمز غير الموجود في المفردات إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه. - pad_token (
str، اختياري، القيمة الافتراضية"<pad>") — الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة. - word_delimiter_token (
str، اختياري، القيمة الافتراضية"|") — الرمز المستخدم لتحديد نهاية الكلمة. - do_lower_case (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم قبول المدخلات بحروف صغيرة وتحويل المخرجات إلى حروف صغيرة عند فك الترميز. - target_lang (
str، اختياري) — لغة الهدف التي يجب أن يضبطها مُجزِّئ الرموز (tokenizer) افتراضيًا. يجب تعريفtarget_langلمفردات متعددة اللغات المتداخلة مثل facebook/mms-1b-all. - **kwargs — معلمات إضافية تُمرَّر إلى PreTrainedTokenizer
ينشئ مُرمِّز Wav2Vec2CTC.
يرث هذا المُجزِّئ من PreTrainedTokenizer الذي يحتوي على بعض الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى الفئة الأصلية لمزيد من المعلومات حول هذه الطرق.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
المعاملات
- text (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نصوص مُقسّمة مسبقًا إلى رموز). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسّمة مسبقًا)، فيجب تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_pair (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نصوص مُقسّمة مسبقًا إلى رموز). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسّمة مسبقًا)، فيجب تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_target (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات التي سيتم ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُقسَّمة مسبقًا)، فيجب عليك تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_pair_target (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات التي سيتم ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُقسَّمة مسبقًا)، فيجب عليك تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - tokenizer_kwargs (
dict[str, Any], اختياري) — معاملات إضافية (kwargs) تُمرَّر إلى مُجزِّئ النص (tokenizer). سيتم دمج هذه المعاملات مع المعاملات الصريحة ومعاملات أخرى، مع إعطاء الأولوية للمعاملات الصريحة. - add_special_tokens (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسيةPretrainedTokenizerBase.build_inputs_with_special_tokens، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. يكون هذا مفيدًا إذا كنت ترغب في إضافة رموزbosأوeosتلقائيًا. - padding (
bool,strأو PaddingStrategy, اختياري, الافتراضي هوFalse) — يُفعّل التحكم في الحشو. يقبل القيم التالية:Trueأو'longest': يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).'max_length': يتم ملء النص حتى الطول الأقصى المحدد عبر الحجةmax_lengthأو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.Falseأو'do_not_pad'(الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
- truncation (
bool,strأو TruncationStrategy, اختياري, الافتراضي هوFalse) — تفعيل التحكم في القص. يقبل القيم التالية:Trueأو'longest_first': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. يتم هذا القص رمزًا تلو الآخر، حيث يُزال رمز من أطول تسلسل في الزوج إذا كان قد قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).'only_first': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يُقصّ هذا الخيار سوى التسلسل الأول من الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).'only_second': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يتم قصّ النص الثاني من الزوج إلا إذا قُدِّم زوج من النصوص (أو دفعة من الأزواج).Falseأو'do_not_truncate'(الافتراضي): لا يوجد اقتطاع (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال في النموذج).
- max_length (
int, اختياري) — يتحكم في الحد الأقصى للطول الذي ستستخدمه إحدى معاملات القص/الحشو.إذا تُرك غير مُعيَّن أو عُدِّل إلى
None، فسيتم استخدام الطول الأقصى المُعرَّف مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب طولًا أقصى. وإذا لم يكن للنموذج طول إدخال أقصى محدد (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى طول أقصى. - stride (
int، اختياري، القيمة الافتراضية 0) — إذا تم تعيينه إلى رقم معmax_length، فستحتوي الرموز الزائدة المُعاد عندreturn_overflowing_tokens=Trueعلى بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة. - is_split_into_words (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان المدخل مُجزَّأً مسبقاً (على سبيل المثال، مقسَّماً إلى كلمات). إذا تم ضبطه علىTrue، يفترض المُجزِّئ أن المدخل مقسَّم بالفعل إلى كلمات (على سبيل المثال، عن طريق تقسيمه على المسافات) وسيُجزِّئها. هذا مفيد لتصنيف الكيانات الاسمية أو تصنيف الرموز. - pad_to_multiple_of (
int, اختياري) — إذا تم ضبطه، سيتم توسيط التسلسل إلى مضاعف للقيمة المقدمة. يتطلب تفعيلpadding. هذا مفيد بشكل خاص لتمكين استخدام نوى Tensor على أجهزة NVIDIA التي تتمتع بقابلية حساب>= 7.5(Volta). - padding_side (
str، اختياري) — الجهة التي يجب تطبيق الحشو عليها في النموذج. يجب اختيارها من بين [‘right’، ‘left’]. القيمة الافتراضية تُختار من سمة الفئة التي تحمل الاسم نفسه. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات بدلاً من قائمة من الأعداد الصحيحة في Python. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن نوع Numpy.
- return_token_type_ids (
bool, اختياري) — ما إذا كان يجب إرجاع معرّفات أنواع الرموز. إذا تُركت القيمة الافتراضية، فسيتم إرجاع معرّفات أنواع الرموز وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما تحددها خاصيةreturn_outputs. - return_attention_mask (
bool, اختياري) — ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما هو معرّف بواسطةreturn_outputsالخاصية. - return_overflowing_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم إرجاع تسلسلات الرموز الزائدة أم لا. إذا تم تقديم زوج من تسلسلات معرفات الإدخال (أو دفعة من الأزواج) معtruncation_strategy = longest_firstأوTrue، فسيتم رفع خطأ بدلاً من إرجاع الرموز الزائدة. - return_special_tokens_mask (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع معلومات قناع الرموز الخاصة أم لا. - return_offsets_mapping (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان يجب إرجاع(char_start, char_end)لكل رمز.يتوفر هذا فقط على مُرمّزيات سريعة ترث من PreTrainedTokenizerFast، فإذا كنت تستخدم مُرمّزي Python، فسيُطلق هذا الدالة
NotImplementedError. - return_length (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع أطوال المدخلات المُرمّزة أم لا. - verbose (
bool، اختياري، الافتراضيTrue) — ما إذا كان يجب طباعة مزيد من المعلومات والتحذيرات أم لا. - **kwargs — تُمرَّر إلى طريقة
self.tokenize()
يعيد
BatchEncoding يحتوي على الحقول التالية:
-
input_ids — قائمة معرّفات الرموز التي تُغذّى بها النموذج.
-
token_type_ids — قائمة معرّفات أنواع الرموز التي تُمرَّر إلى النموذج (عندما يكون
return_token_type_ids=Trueأو إذا كان “token_type_ids” ضمنself.model_input_names). -
attention_mask — قائمة بالفهارس تحدد الرموز التي ينبغي للنموذج الانتباه إليها (عندما يكون
return_attention_mask=Trueأو إذا كان “attention_mask” ضمنself.model_input_names). -
overflowing_tokens — قائمة تسلسلات الرموز المتجاوزة (عند تحديد
max_lengthوreturn_overflowing_tokens=True). -
num_truncated_tokens — عدد الرموز المقصوصة (عند تحديد
max_lengthوreturn_overflowing_tokens=True). -
special_tokens_mask — قائمة من الأصفار والواحدات، حيث تشير الواحدة إلى الرموز الخاصة المضافة وتصفّر إلى رموز التسلسل العادية (عندما يكون
add_special_tokens=Trueوreturn_special_tokens_mask=True). -
length — طول المدخلات (عندما يكون
return_length=True)
الطريقة الرئيسية لتجزئة (tokenization) وتجهيز تسلسل واحد أو عدة تسلسلات، أو زوج واحد أو عدة أزواج من التسلسلات، للنموذج.
decode
< source >( token_ids: typing.Union[int, list[int], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = Noneoutput_char_offsets: bool = Falseoutput_word_offsets: bool = False**kwargs ) → str or Wav2Vec2CTCTokenizerOutput
المعاملات
- token_ids (
Union[int, list[int], np.ndarray, torch.Tensor]) — قائمة معرّفات المدخلات المُرمَّزة. يمكن الحصول عليها باستخدام طريقة__call__. - skip_special_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إزالة الرموز الخاصة أثناء فك الترميز أم لا. - clean_up_tokenization_spaces (
bool, اختياري) — ما إذا كان سيتم تنظيف مسافات الترميز أم لا. - output_char_offsets (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان يجب إخراج إزاحات الأحرف أم لا. يمكن استخدام إزاحات الأحرف مع معدل أخذ العينات ومعدل تخفيض عينة النموذج لحساب الطوابع الزمنية للأحرف المنقولة.يرجى الاطلاع على المثال أدناه لفهم أفضل لكيفية الاستفادة من
output_char_offsets. - output_word_offsets (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان يجب إخراج إزاحات الكلمات أم لا. يمكن استخدام إزاحات الكلمات مع معدل أخذ العينات ومعدل تخفيض عينة النموذج لحساب الطوابع الزمنية للكلمات المنقولة.يرجى الاطلاع على المثال أدناه لفهم أفضل لكيفية الاستفادة من
output_word_offsets. - kwargs (معلمات إضافية بالكلمات المفتاحية، اختيارية) — سيتم تمريرها إلى طريقة فك الترميز المحددة للنموذج الأساسي.
يعيد
str أو Wav2Vec2CTCTokenizerOutput
قائمة الجُمل المُفكَّكة. ستكون Wav2Vec2CTCTokenizerOutput عندما يكون output_char_offsets == True أو output_word_offsets == True.
يحوّل تسلسلًا من المعرّفات في نص، باستخدام مُجزّئ الرموز (tokenizer) وقاموس الرموز، مع خيارات لإزالة الرموز الخاصة وتنظيف مسافات تجزئة الرموز.
يشبه ذلك القيام بـ self.convert_tokens_to_string(self.convert_ids_to_tokens(token_ids)).
مثال:
>>> # Let's see how to retrieve time steps for a model
>>> from transformers import AutoTokenizer, AutoFeatureExtractor, AutoModelForCTC
>>> from datasets import load_dataset
>>> import datasets
>>> import torch

>>> # import model, feature extractor, tokenizer
>>> model = AutoModelForCTC.from_pretrained("facebook/wav2vec2-base-960h")
>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")

>>> # load first sample of English common_voice
>>> dataset = load_dataset("mozilla-foundation/common_voice_11_0", "en", split="train", streaming=True)
>>> dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))
>>> dataset_iter = iter(dataset)
>>> sample = next(dataset_iter)

>>> # forward sample through model to get greedily predicted transcription ids
>>> input_values = feature_extractor(sample["audio"]["array"], return_tensors="pt").input_values
>>> logits = model(input_values).logits[0]
>>> pred_ids = torch.argmax(logits, axis=-1)

>>> # retrieve word stamps (analogous commands for `output_char_offsets`)
>>> outputs = tokenizer.decode(pred_ids, output_word_offsets=True)
>>> # compute `time_offset` in seconds as product of downsampling ratio and sampling_rate
>>> time_offset = model.config.inputs_to_logits_ratio / feature_extractor.sampling_rate

>>> word_offsets = [
...     {
...         "word": d["word"],
...         "start_time": round(d["start_offset"] * time_offset, 2),
...         "end_time": round(d["end_offset"] * time_offset, 2),
...     }
...     for d in outputs.word_offsets
... ]
>>> # compare word offsets with audio `en_train_0/common_voice_en_19121553.mp3` online on the dataset viewer:
>>> # https://huggingface.co/datasets/mozilla-foundation/common_voice_11_0/viewer/en
>>> word_offsets[:3]
[{'word': 'THE', 'start_time': 0.7, 'end_time': 0.78}, {'word': 'TRICK', 'start_time': 0.88, 'end_time': 1.08}, {'word': 'APPEARS', 'start_time': 1.2, 'end_time': 1.64}]
batch_decode
< source >( sequences: typing.Union[list[int], list[list[int]], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = Noneoutput_char_offsets: bool = Falseoutput_word_offsets: bool = False**kwargs ) → list[str] or Wav2Vec2CTCTokenizerOutput
المعاملات
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — قائمة من معرّفات المدخلات المُرمّزة. يمكن الحصول عليها باستخدام طريقة__call__. - skip_special_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إزالة الرموز الخاصة أثناء فك الترميز أم لا. - clean_up_tokenization_spaces (
bool, اختياري) — ما إذا كان سيتم تنظيف مسافات الترميز أم لا. - output_char_offsets (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان يجب إخراج إزاحات الأحرف أم لا. يمكن استخدام إزاحات الأحرف بالاقتران مع معدل أخذ العينات ومعدل تخفيض عينة النموذج لحساب الطوابع الزمنية للأحرف المنقوشة.يرجى الاطلاع على مثال decode() لفهم أفضل لكيفية الاستفادة من
output_char_offsets. يعمل batch_decode() بنفس الطريقة مع المخرجات المجمّعة. - output_word_offsets (
bool, اختياري, الافتراضيFalse) — ما إذا كان يجب إخراج إزاحات الكلمات أم لا. يمكن استخدام إزاحات الكلمات بالاقتران مع معدل أخذ العينات ومعدل تخفيض عينة النموذج لحساب الطوابع الزمنية للكلمات المنقولة. الرجاء الاطلاع على مثال decode() لفهم كيفية الاستفادة من output_word_offsets بشكل أفضل. تعمل batch_decode() بنفس الطريقة مع المخرجات المجمعة.يرجى الاطلاع على مثال decode() لفهم كيفية الاستفادة من
output_word_offsetsبشكل أفضل. يعمل batch_decode() بنفس الطريقة مع المخرجات المجمّعة. - kwargs (معلمات إضافية بالكلمات المفتاحية، اختيارية) — سيتم تمريرها إلى طريقة فك الترميز المحددة للنموذج الأساسي.
يعيد
list[str] أو Wav2Vec2CTCTokenizerOutput
قائمة الجُمل المُفكَّكة. ستكون Wav2Vec2CTCTokenizerOutput عندما يكون output_char_offsets == True أو output_word_offsets == True.
تحويل قائمة من قوائم معرّفات الرموز إلى قائمة من النصوص عن طريق استدعاء decode.
تعيين اللغة المستهدفة لقاموس متعدد اللغات متداخل
Wav2Vec2FeatureExtractor
فئة transformers.Wav2Vec2FeatureExtractor
< source >( feature_size = 1sampling_rate = 16000padding_value = 0.0return_attention_mask = Falsedo_normalize = True**kwargs )
المعاملات
- feature_size (
int، اختياري، القيمة الافتراضية 1) — أبعاد الميزة للميزات المستخرجة. - sampling_rate (
int, اختياري، القيمة الافتراضية 16000) — معدل أخذ العينات الذي يجب أن تُرقَم به ملفات الصوت، ويُعبَّر عنه بالهرتز (Hz). - padding_value (
float، اختياري، القيمة الافتراضية 0.0) — القيمة المستخدمة لملء قيم الحشو. - do_normalize (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع المدخلات إلى متوسط صفري وتباين وحدة. يمكن أن يساعد التطبيع في تحسين أداء بعض النماذج بشكل كبير، على سبيل المثال، wav2vec2-lv60. - return_attention_mask (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان الدالة() يجب أن تُرجعattention_mask.نماذج Wav2Vec2 التي تم ضبط
config.feat_extract_norm == "group"لها، مثل wav2vec2-base، لم يتم تدريبها باستخدام قناع الانتباهattention_mask. بالنسبة لهذه النماذج، يجب ببساطة ملءinput_valuesبالقيمة 0، ولا ينبغي تمريرattention_mask.بالنسبة إلى نماذج Wav2Vec2 التي تم ضبط
config.feat_extract_norm == "layer"لها، مثل wav2vec2-lv60، يجب تمريرattention_maskللاستدلال الدُفعي.
ينشئ مستخرج ميزات Wav2Vec2.
يرث مستخرج الميزات هذا من SequenceFeatureExtractor الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
__call__
< source >( raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]]padding: bool | str | transformers.utils.generic.PaddingStrategy = Falsemax_length: int | None = Nonetruncation: bool = Falsepad_to_multiple_of: int | None = Nonereturn_attention_mask: bool | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonesampling_rate: int | None = None**kwargs )
المعاملات
- raw_speech (
np.ndarray،list[float]،list[np.ndarray]،list[list[float]]) — التسلسل أو الدفعة من التسلسلات التي سيتم ملؤها. يمكن أن يكون كل تسلسل مصفوفة numpy، أو قائمة من قيم float، أو قائمة من مصفوفات numpy، أو قائمة من قوائم قيم float. يجب أن يكون الصوت أحادي القناة وليس ستيريو، أي قيمة float واحدة لكل خطوة زمنية. - padding (
bool,strأو PaddingStrategy, اختياري, الافتراضي هوFalse) — اختر استراتيجية لإضافة الحشو إلى التسلسلات المُعادَة (وفقًا لجانب الحشو وفهرس الحشو الخاص بالنموذج) من بين الخيارات التالية:Trueأو'longest': يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).'max_length': يتم ملء النص حتى الطول الأقصى المحدد عبر الحجةmax_lengthأو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.Falseأو'do_not_pad'(الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
- max_length (
int، اختياري) — الحد الأقصى لطول القائمة المُعادَة وطول الحشو بشكل اختياري (انظر أعلاه). - truncation (
bool) — يفعّل القصّ لقطع تسلسلات الإدخال الأطول من max_length إلى max_length. - pad_to_multiple_of (
int, اختياري) — إذا تم تعيينه، سيتم توسيط التسلسل إلى مضاعف للقيمة المُقدَّمة.يُعدّ هذا مفيدًا بشكل خاص لتفعيل استخدام نوى التينسور (Tensor Cores) على أجهزة NVIDIA التي تتمتع بقابلية معالجة
>= 7.5(Volta)، أو على وحدات TPU التي تستفيد من أن تكون أطوال التسلسلات مضاعفات للعدد 128. - return_attention_mask (
bool, اختياري) — ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقًا للقيمة الافتراضية الخاصة بمعالج الميزات (feature_extractor) المعني.نماذج Wav2Vec2 التي تم ضبط
config.feat_extract_norm == "group"لها، مثل wav2vec2-base، لم يتم تدريبها باستخدامattention_mask. بالنسبة لهذه النماذج، يجب ببساطة ملءinput_valuesبالقيمة 0 دون تمريرattention_mask.بالنسبة إلى نماذج Wav2Vec2 التي تم ضبط
config.feat_extract_norm == "layer"لها، مثل wav2vec2-lv60، يجب تمريرattention_maskعند الاستدلال على دفعات. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات بدلاً من قائمة من الأعداد الصحيحة في Python. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن نوع Numpy.
- sampling_rate (
int, اختياري) — معدل أخذ العينات الذي تم به أخذ عينات مدخلraw_speech. يُوصى بشدة بتمريرsampling_rateعند استدعاء forward لمنع الأخطاء الصامتة. - padding_value (
float، اختياري، القيمة الافتراضية 0.0) —
الطريقة الرئيسية لتحويل السلسلة أو السلاسل إلى ميزات وتجهيزها للنموذج.
Wav2Vec2Processor
فئة transformers.Wav2Vec2Processor
< source >( feature_extractortokenizer )
ينشئ معالج Wav2Vec2Processor يجمع مستخرج الميزات ومجزئ الرموز في معالج واحد.
يوفر Wav2Vec2Processor جميع وظائف Wav2Vec2FeatureExtractor وWav2Vec2CTCTokenizer. راجع ~Wav2Vec2FeatureExtractor و~Wav2Vec2CTCTokenizer لمزيد من المعلومات.
__call__
< source >( audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | None = None**kwargs: *<class 'transformers.models.wav2vec2.processing_wav2vec2.Wav2Vec2ProcessorKwargs'> )
المعاملات
- audio (
Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]], اختياري) — الصوت أو مجموعة الأصوات التي يجب تحضيرها. يمكن أن يكون كل صوت مصفوفة NumPy أو متجه PyTorch. في حالة استخدام مصفوفة NumPy أو متجه PyTorch، يجب أن يكون شكل كل صوت (C, T)، حيث C هو عدد القنوات، وT هو طول العينة للصوت. - text (
Union[str, list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى رموز). إذا مررت مدخلًا مُقسَّمًا مسبقًا إلى رموز، فاضبطis_split_into_words=Trueلتجنب الغموض مع المدخلات الدفعية. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (ProcessingKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
pad
< source >( *args**kwargs )
المعاملات
- input_features —
عندما يكون الحجة الأولى قاموسًا يحتوي على دفعة من الموترات، أو عند وجود حجة
input_features، يتم تمريرها إلى Wav2Vec2FeatureExtractor.pad(). - labels —
عند وجود الحجة
label، يتم تمريرها إلى PreTrainedTokenizer.pad().
يعمل هذا الأسلوب على دفعات من الميزات المستخرجة و/أو النص المُرمَّز. إنه يمرر جميع الحجج إلى Wav2Vec2FeatureExtractor.pad() و/أو PreTrainedTokenizer.pad() اعتماداً على نمط الإدخال، ويعيد مخرجاتهما. إذا تم تمرير النمطين معاً، يتم استدعاء Wav2Vec2FeatureExtractor.pad() وPreTrainedTokenizer.pad().
from_pretrained
< source >( pretrained_model_name_or_path: str | os.PathLikecache_dir: str | os.PathLike | None = Noneforce_download: bool = Falselocal_files_only: bool = Falsetoken: str | bool | None = Nonerevision: str = 'main'**kwargs )
المعاملات
- pretrained_model_name_or_path (
strأوos.PathLike) — يمكن أن يكون هذا:- سلسلة نصية، وهي معرّف النموذج لمُستخرج ميزات مُدرَّب مسبقاً مستضاف داخل مستودع نموذج على huggingface.co.
- مسار إلى مجلد يحتوي على ملف مستخرج الميزات المحفوظ باستخدام طريقة
save_pretrained()، على سبيل المثال
./my_model_directory/. - مسار إلى ملف JSON لمُستخرج ميزات محفوظ، على سبيل المثال:
./my_model_directory/preprocessor_config.json.
- **kwargs —
حجج إضافية بالكلمات المفتاحية تُمرَّر إلى كلٍّ من
from_pretrained() و
~tokenization_utils_base.PreTrainedTokenizer.from_pretrained.
أنشئ معالجًا مرتبطًا بنموذج مُدرَّب مسبقًا.
تستدعي طريقة الفئة هذه ببساطة مستخرج الميزات from_pretrained() ومعالج الصور ImageProcessingMixin وطريقة المرمّز
~tokenization_utils_base.PreTrainedTokenizer.from_pretrained. يُرجى الرجوع إلى سلاسل التوثيق للطرق المذكورة أعلاه لمزيد من المعلومات.
save_pretrained
< source >( save_directorypush_to_hub: bool = False**kwargs )
المعاملات
- save_directory (
strأوos.PathLike) — المجلد الذي سيتم فيه حفظ ملف مستخرج الميزات بصيغة JSON وملفات المُرمِّز (سيتم إنشاء المجلد إذا لم يكن موجوداً). - push_to_hub (
bool، اختياري، الافتراضيFalse) — ما إذا كان سيتم دفع نموذجك إلى مركز نماذج Hugging Face بعد حفظه. يمكنك تحديد المستودع الذي تريد الدفع إليه باستخدامrepo_id(سيكون الافتراضي هو اسمsave_directoryفي نطاقك). - kwargs (
dict[str, Any]، اختياري) — حجج إضافية بأسماء تُمرَّر إلى طريقة push_to_hub().
يحفظ سمات هذا المعالج (مستخرج الميزات، المرمّز…) في المجلد المحدد بحيث يمكن إعادة تحميله باستخدام طريقة from_pretrained().
تستدعي طريقة الفئة هذه ببساطة save_pretrained() و save_pretrained(). يُرجى الرجوع إلى توثيق طرق الاستدعاء أعلاه لمزيد من المعلومات.
تُمرّر هذه الطريقة جميع معاملاتها إلى batch_decode() الخاصة بـ PreTrainedTokenizer. يُرجى الرجوع إلى سلسلة التوثيق (docstring) لهذه الطريقة لمزيد من المعلومات.
تُمرّر هذه الطريقة جميع معاملاتها إلى decode() الخاصة بـ PreTrainedTokenizer. يُرجى الرجوع إلى سلسلة التوثيق (docstring) لهذه الطريقة لمزيد من المعلومات.
Wav2Vec2ProcessorWithLM
فئة transformers.Wav2Vec2ProcessorWithLM
< source >( feature_extractor: FeatureExtractionMixintokenizer: PreTrainedTokenizerBasedecoder: BeamSearchDecoderCTC )
ينشئ Wav2Vec2ProcessorWithLM الذي يغلّف مستخرج الميزات ومُرمِّز الرموز في مُعالِج واحد.
يوفر Wav2Vec2ProcessorWithLM جميع وظائف feature_extractor_class وtokenizer_class. راجع ~feature_extractor_class و~tokenizer_class لمزيد من المعلومات.
__call__
< source >( *args**kwargs )
المعاملات
- return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
عند استخدامه في الوضع العادي، يحوّل هذا الإجراء جميع معامِله إلى ~FeatureExtractionMixin.pad الخاص بمستخرج الميزات ويعيد ناتجه. أما عند استخدامه في سياق ~Wav2Vec2ProcessorWithLM.as_target_processor، فيحوّل هذا الإجراء جميع معامِله إلى pad() الخاص بـ Wav2Vec2CTCTokenizer. يُرجى الرجوع إلى سلسلة التوثيق (docstring) للإجراءين المذكورين أعلاه لمزيد من المعلومات.
from_pretrained
< source >( pretrained_model_name_or_path**kwargs )
المعاملات
- pretrained_model_name_or_path (
strأوos.PathLike) — يمكن أن يكون هذا:- سلسلة نصية، وهي معرّف النموذج لمُستخرج ميزات مُدرَّب مسبقاً مستضاف داخل مستودع نموذج على huggingface.co.
- مسار إلى مجلد يحتوي على ملف مستخرج الميزات المحفوظ باستخدام طريقة
save_pretrained()، على سبيل المثال
./my_model_directory/. - مسار إلى ملف JSON لمُستخرج ميزات محفوظ، على سبيل المثال:
./my_model_directory/preprocessor_config.json.
- **kwargs — حجج إضافية بالكلمات المفتاحية تُمرَّر إلى كلٍّ من SequenceFeatureExtractor و PreTrainedTokenizer
أنشئ كائنًا من Wav2Vec2ProcessorWithLM من معالج Wav2Vec2 مُدرَّب مسبقًا.
This class method is simply calling the feature extractor’s from_pretrained(), Wav2Vec2CTCTokenizer’s from_pretrained(), and
pyctcdecode.BeamSearchDecoderCTC.load_from_hf_hub.يرجى الرجوع إلى توثيق الدوال (docstrings) للطرق المذكورة أعلاه للحصول على مزيد من المعلومات.
batch_decode
< source >( logits: ndarraypool: multiprocessing.pool.Pool | None = Nonenum_processes: int | None = Nonebeam_width: int | None = Nonebeam_prune_logp: float | None = Nonetoken_min_logp: float | None = Nonehotwords: collections.abc.Iterable[str] | None = Nonehotword_weight: float | None = Nonealpha: float | None = Nonebeta: float | None = Noneunk_score_offset: float | None = Nonelm_score_boundary: bool | None = Noneoutput_word_offsets: bool = Falsen_best: int = 1 )
المعاملات
- logits (
np.ndarray) — متجه logits الناتج عن النموذج، ويمثل احتمالات السجل (log probabilities) لكل رمز. - pool (
multiprocessing.Pool, اختياري) — مجموعة (pool) اختيارية يديرها المستخدم. إذا لم يتم تعيينها، فسيتم إنشاؤها وإغلاقها تلقائيًا. يجب إنشاء المجموعة بعدWav2Vec2ProcessorWithLM. وإلا فلن تكون نموذج اللغة (LM) متاحًا لعمليات المجموعة الفرعية.حالياً، يمكن استخدام أحواض (pools) أنشئت بسياق «fork» فقط. إذا تم تمرير حوض «spawn»، فسيتم تجاهله وسيُستخدم فك الترميز التسلسلي بدلاً من ذلك.
- num_processes (
int، اختياري) — إذا لم يتم تعيينpool، فهو عدد العمليات التي يجب توزيع الدالة عليها بالتوازي. القيمة الافتراضية هي عدد وحدات المعالجة المركزية المتاحة. - beam_width (
int، اختياري) — الحد الأقصى لعدد الحزم في كل خطوة من خطوات فك الترميز. القيمة الافتراضية هي DEFAULT_BEAM_WIDTH في pyctcdecode. - beam_prune_logp (
int, اختياري) — تُقصّ الأشعة التي تكون أسوأ بكثير من أفضل شعاع. القيمة الافتراضية هي DEFAULT_PRUNE_LOGP الخاصة بـ pyctcdecode. - token_min_logp (
int، اختياري) — تُتجاهل الرموز التي تكون قيمتها logp أقل من هذا الحد، ما لم تكن argmax للإطار. القيمة الافتراضية هي DEFAULT_MIN_TOKEN_LOGP في pyctcdecode. - hotwords (
list[str]، اختياري) — قائمة بالكلمات ذات الأهمية الإضافية، وقد تكون خارج نطاق نموذج اللغة - hotword_weight (
int, اختياري) — معامل وزن لأهمية الكلمات الساخنة. القيمة الافتراضية هي DEFAULT_HOTWORD_WEIGHT في pyctcdecode. - alpha (
float, اختياري) — الوزن الخاص بنموذج اللغة أثناء الاندماج الضحل - beta (
float, اختياري) — الوزن المُستخدم لضبط درجة الطول أثناء التقييم - unk_score_offset (
float, اختياري) — مقدار إزاحة درجة تسجيل (log score) للرموز المجهولة - lm_score_boundary (
bool، اختياري) — ما إذا كان على kenlm مراعاة الحدود عند التقييم - output_word_offsets (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم إخراج إزاحات الكلمات أم لا. يمكن استخدام إزاحات الكلمات بالاقتران مع معدل أخذ العينات ومعدل تخفيض عينة النموذج لحساب الطوابع الزمنية للكلمات المنقولة. - n_best (
int, اختياري, الافتراضي هو1) — عدد أفضل الفرضيات التي يجب إرجاعها. إذا كانn_bestأكبر من 1، فإنtextالمُرجع سيكون قائمة قوائم من النصوص،logit_scoreستكون قائمة قوائم من الأعداد العشرية، وlm_scoreستكون قائمة قوائم من الأعداد العشرية، حيث يتوافق طول القائمة الخارجية مع حجم الدفعة (batch size) ويتوافق طول القائمة الداخلية مع عدد الفرضيات المُرجعة. يجب أن تكون القيمة >= 1.يرجى الاطلاع على مثال decode() لفهم كيفية الاستفادة من
output_word_offsetsبشكل أفضل. يعمل batch_decode() بنفس الطريقة مع المخرجات المجمّعة.
ترجمة مخرجات الترميز الدفعية إلى نص صوتي مع دعم نماذج اللغة.
تستخدم هذه الدالة multiprocessing في Python. حاليًا، يتوفر multiprocessing فقط على أنظمة Unix (انظر هذه المشكلة).
إذا كنت تقوم بفك ترميز عدة دفعات، ففكّر في إنشاء
Poolوتوريده إلىbatch_decode. وإلا، فسيكونbatch_decodeبطيئاً جداً لأنه سيقوم بإنشاءPoolجديد لكل استدعاء. راجع مثال الاستخدام أدناه.
مثال: انظر إلى فك ترميز عدة مقاطع صوتية.
decode
< source >( logits: ndarraybeam_width: int | None = Nonebeam_prune_logp: float | None = Nonetoken_min_logp: float | None = Nonehotwords: collections.abc.Iterable[str] | None = Nonehotword_weight: float | None = Nonealpha: float | None = Nonebeta: float | None = Noneunk_score_offset: float | None = Nonelm_score_boundary: bool | None = Noneoutput_word_offsets: bool = Falsen_best: int = 1 )
المعاملات
- logits (
np.ndarray) — متجه logits الناتج عن النموذج، ويمثل احتمالات السجل (log probabilities) لكل رمز. - beam_width (
int، اختياري) — الحد الأقصى لعدد الحزم في كل خطوة من خطوات فك الترميز. القيمة الافتراضية هي DEFAULT_BEAM_WIDTH في pyctcdecode. - beam_prune_logp (
int, اختياري) — حدّ لقصّ الحزم التي تكون قيم log-probs فيها أقل من best_beam_logp + beam_prune_logp. يجب أن تكون القيمة <= 0. القيمة الافتراضية هي DEFAULT_PRUNE_LOGP في pyctcdecode. - token_min_logp (
int, اختياري) — تُتخطى الرموز التي تكون قيم log-prob الخاصة بها أقل من token_min_logp، ما لم تكن تحمل أعلى قيمة log-prob ضمن العبارة. القيمة الافتراضية هي DEFAULT_MIN_TOKEN_LOGP في pyctcdecode. - hotwords (
list[str]، اختياري) — قائمة بالكلمات ذات الأهمية الإضافية التي قد تكون مفقودة من مفردات نموذج اللغة، مثل [“huggingface”] - hotword_weight (
int, اختياري) — معامل مضاعفة يرفع درجات الكلمات الساخنة. القيمة الافتراضية هي DEFAULT_HOTWORD_WEIGHT في pyctcdecode. - alpha (
float, اختياري) — الوزن الخاص بنموذج اللغة أثناء الاندماج الضحل - beta (
float, اختياري) — الوزن المُستخدم لضبط درجة الطول أثناء التقييم - unk_score_offset (
float, اختياري) — مقدار إزاحة درجة تسجيل (log score) للرموز المجهولة - lm_score_boundary (
bool، اختياري) — ما إذا كان على kenlm مراعاة الحدود عند التقييم - output_word_offsets (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم إخراج إزاحات الكلمات أم لا. يمكن استخدام إزاحات الكلمات بالاقتران مع معدل أخذ العينات ومعدل تخفيض عينة النموذج لحساب الطوابع الزمنية للكلمات المنقولة. - n_best (
int, اختياري, الافتراضي هو1) — عدد أفضل الفرضيات التي يجب إرجاعها. إذا كانn_bestأكبر من 1، فإنtextالمُرجعة ستكون قائمة من النصوص،logit_scoreستكون قائمة من الأعداد العشرية، وlm_scoreستكون قائمة من الأعداد العشرية، حيث يتوافق طول هذه القوائم مع عدد الفرضيات المُرجعة. يجب أن تكون القيمة >= 1.يرجى الاطلاع على المثال أدناه لفهم أفضل لكيفية الاستفادة من
output_word_offsets.
فكّ ترميز مخرجات اللوجيت إلى نصّ صوتي مع دعم نماذج اللغة.
مثال:
>>> # Let's see how to retrieve time steps for a model
>>> from transformers import AutoTokenizer, AutoProcessor, AutoModelForCTC
>>> from datasets import load_dataset
>>> import datasets
>>> import torch

>>> # import model, feature extractor, tokenizer
>>> model = AutoModelForCTC.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")
>>> processor = AutoProcessor.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")

>>> # load first sample of English common_voice
>>> dataset = load_dataset("mozilla-foundation/common_voice_11_0", "en", split="train", streaming=True)
>>> dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))
>>> dataset_iter = iter(dataset)
>>> sample = next(dataset_iter)

>>> # forward sample through model to get greedily predicted transcription ids
>>> input_values = processor(sample["audio"]["array"], return_tensors="pt").input_values
>>> with torch.no_grad():
...     logits = model(input_values).logits[0].cpu().numpy()

>>> # retrieve word stamps (analogous commands for `output_char_offsets`)
>>> outputs = processor.decode(logits, output_word_offsets=True)
>>> # compute `time_offset` in seconds as product of downsampling ratio and sampling_rate
>>> time_offset = model.config.inputs_to_logits_ratio / processor.feature_extractor.sampling_rate

>>> word_offsets = [
...     {
...         "word": d["word"],
...         "start_time": round(d["start_offset"] * time_offset, 2),
...         "end_time": round(d["end_offset"] * time_offset, 2),
...     }
...     for d in outputs.word_offsets
... ]
>>> # compare word offsets with audio `en_train_0/common_voice_en_19121553.mp3` online on the dataset viewer:
>>> # https://huggingface.co/datasets/mozilla-foundation/common_voice_11_0/viewer/en
>>> word_offsets[:4]
[{'word': 'THE', 'start_time': 0.68, 'end_time': 0.78}, {'word': 'TRACK', 'start_time': 0.88, 'end_time': 1.1}, {'word': 'APPEARS', 'start_time': 1.18, 'end_time': 1.66}, {'word': 'ON', 'start_time': 1.86, 'end_time': 1.92}]
فك ترميز عدة مقاطع صوتية
إذا كنت تخطط لفك ترميز عدة دفعات من ملفات الصوت، فيجب أن تفكر في استخدام batch_decode() مع تمرير كائن مُهيأ من multiprocessing.Pool.
وإلا، فإن أداء batch_decode() سيكون أبطأ من استدعاء decode() لكل ملف صوت على حدة، لأنه يهيئ كائن Pool جديدًا داخليًا مع كل استدعاء. راجع المثال أدناه:
# Let's see how to use a user-managed pool for batch decoding multiple audios
from multiprocessing import get_context

import datasets
import torch
from datasets import load_dataset

from transformers import AutoModelForCTC, AutoProcessor


# import model, feature extractor, tokenizer
model = AutoModelForCTC.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm", device_map="auto")
processor = AutoProcessor.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")

# load example dataset
dataset = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")
dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))


def map_to_array(example):
    example["speech"] = example["audio"]["array"]
    return example


# prepare speech data for batch inference
dataset = dataset.map(map_to_array, remove_columns=["audio"])


def map_to_pred(batch, pool):
    inputs = processor(batch["speech"], sampling_rate=16_000, padding=True, return_tensors="pt").to(model.device)
    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        logits = model(**inputs).logits

    transcription = processor.batch_decode(logits.cpu().numpy(), pool).text
    batch["transcription"] = transcription
    return batch


# note: pool should be instantiated *after* `Wav2Vec2ProcessorWithLM`.
#       otherwise, the LM won't be available to the pool's sub-processes
# select number of processes and batch_size based on number of CPU cores available and on dataset size
with get_context("fork").Pool(processes=2) as pool:
    result = dataset.map(
        map_to_pred, batched=True, batch_size=2, fn_kwargs={"pool": pool}, remove_columns=["speech"]
    )

result["transcription"][:2]
['MISTER QUILTER IS THE APOSTLE OF THE MIDDLE CLASSES AND WE ARE GLAD TO WELCOME HIS GOSPEL', "NOR IS MISTER COULTER'S MANNER LESS INTERESTING THAN HIS MATTER"]
المخرجات الخاصة بـ Wav2Vec2
فئة transformers.models.wav2vec2_with_lm.processing_wav2vec2_with_lm.Wav2Vec2DecoderWithLMOutput
< source >( text: list[list[str]] | list[str] | strlogit_score: list[list[float]] | list[float] | float = Nonelm_score: list[list[float]] | list[float] | float = Noneword_offsets: list[list[list[dict[str, int | str]]]] | list[list[dict[str, int | str]]] | list[dict[str, int | str]] = None )
المعاملات
- text (قائمة من
strأوstr) — النتائج المُفكَّكة (logits) في نص. عادةً ما تكون نصّيةً صوتية. - logit_score (قائمة من
floatأوfloat) — الدرجة الكلية لـ logit الخاصة بالأشعة المرتبطة بالنص المُنتَج. - lm_score (قائمة من
float) — قيمة lm_score المدمجة للأشعة المرتبطة بالنص المُنتَج. - word_offsets (قائمة من
list[dict[str, Union[int, str]]]أوlist[dict[str, Union[int, str]]]) — إزاحات الكلمات المُفكَّكة. عند الجمع مع معدل أخذ العينات ومعدل تخفيض عينة النموذج، يمكن استخدام إزاحات الكلمات لحساب الطوابع الزمنية لكل كلمة.
نوع المخرجات لـ Wav2Vec2DecoderWithLM، مع النسخ.
فئة transformers.modeling_outputs.Wav2Vec2BaseModelOutput
< source >( last_hidden_state: typing.Optional[torch.Tensor] = Noneextract_features: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor, ...] | None = Noneattentions: tuple[torch.Tensor, ...] | None = None )
المعاملات
- last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات الخفاء عند مخرجات الطبقة الأخيرة من النموذج. - extract_features (
torch.Tensorمن الشكل(batch_size, sequence_length, conv_dim[-1])) — تسلسل من متجهات الميزات المستخرجة من الطبقة الالتفافية الأخيرة في النموذج. - hidden_states (
tuple(torch.Tensor), اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج التضمينات + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
- attentions (
tuple(torch.Tensor), اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
الفئة الأساسية للنماذج التي تم تدريبها باستخدام هدف خسارة Wav2Vec2.
فئة transformers.models.wav2vec2.modeling_wav2vec2.Wav2Vec2ForPreTrainingOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneprojected_states: typing.Optional[torch.Tensor] = Noneprojected_quantized_states: typing.Optional[torch.Tensor] = Nonecodevector_perplexity: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = Nonecontrastive_loss: typing.Optional[torch.Tensor] = Nonediversity_loss: typing.Optional[torch.Tensor] = None )
المعاملات
- loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — Total loss as the sum of the contrastive loss (L_m) and the diversity loss (L_d) as stated in the official paper. - projected_states (
torch.Tensorمن الشكل(batch_size, sequence_length, config.proj_codevector_dim)) — حالات النموذج المخفية المُسقطَة إلى config.proj_codevector_dim والتي يمكن استخدامها للتنبؤ بالحالات المُكمَّاة المُسقطَة المُقنَّعة. - projected_quantized_states (
torch.Tensorمن الشكل(batch_size, sequence_length, config.proj_codevector_dim)) — متجهات ميزات مُستخرَجة ومُكمّاة ومُرمَّزة إلى config.proj_codevector_dim تمثّل متجهات الهدف الموجبة لفقد التبايني. - codevector_perplexity (
torch.Tensorمن الشكل(1,)) — قيمة الحيرة (Perplexity) لتوزيع متجهات الكود (codevector)، وتُستخدم لقياس تنوع دفتر الكود (codebook). - hidden_states (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_hidden_states=Trueتمريرconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحد لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- attentions (
tuple[torch.Tensor], اختياري, يُعاد عندoutput_attentions=Trueتمريرconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحد لكل طبقة) من الشكل(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- contrastive_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The contrastive loss (L_m) as stated in the official paper. - diversity_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The diversity loss (L_d) as stated in the official paper.
نوع المخرجات الخاص بـ Wav2Vec2ForPreTraining، مع إمكانية تضمين الحالات المخفية والانتباهات.
Wav2Vec2Model
فئة transformers.Wav2Vec2Model
< source >( config: Wav2Vec2Config )
المعاملات
- config (Wav2Vec2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Wav2Vec2 الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonemask_time_indices: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Wav2Vec2BaseModelOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — قيم عشرية لموجة الصوت الخام المدخلة. يمكن الحصول على القيم عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال عبر مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_values، يجب استخدام AutoProcessor للإضافة الحشوية (padding) والتحويل إلى متجه من النوعtorch.Tensor. راجع Wav2Vec2Processor.call() للتفاصيل. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- mask_time_indices (
torch.BoolTensorمن الشكل(batch_size, sequence_length)، اختياري) — فهارس لإخفاء الميزات المستخرجة من أجل خسارة التباينية. عند التواجد في وضع التدريب، يتعلم النموذج التنبؤ بالميزات المستخرجة المخفية في فضاء config.proj_codevector_dim.
يعيد
Wav2Vec2BaseModelOutput أو tuple(torch.Tensor)
Wav2Vec2BaseModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعدادات (Wav2Vec2Config) والمدخلات.
تتجاوز طريقة Wav2Vec2Model الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.extract_features (
torch.Tensorمن الشكل(batch_size, sequence_length, conv_dim[-1])) — تسلسل متجهات الميزات المستخرجة من الطبقة الالتفافية الأخيرة في النموذج.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
Wav2Vec2ForCTC
فئة transformers.Wav2Vec2ForCTC
< source >( config: Wav2Vec2Configtarget_lang: str | None = None )
المعاملات
- config (Wav2Vec2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
- target_lang (
str، اختياري) — معرّف لغة أوزان المُكيّف. تُخزَّن أوزان المُكيّف في صيغة adapter..safetensors أو adapter. .bin. يكون ذا صلة فقط عند استخدام مثيل من Wav2Vec2ForCTC مع المُكيّفات. يستخدم ‘eng’ افتراضياً.
نموذج Wav2Vec2 مع رأس language modeling في الأعلى لتصنيف الزمن المتصل (CTC).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CausalLMOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — قيم عشرية لموجة الصوت الخام المدخلة. يمكن الحصول على القيم عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال عبر مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_values، يجب استخدام AutoProcessor للإضافة الحشوية (padding) والتحويل إلى متجه من النوعtorch.Tensor. راجع Wav2Vec2Processor.call() للتفاصيل. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- labels (
torch.LongTensorمن الشكل(batch_size, target_length)، اختياري) — التسميات لتصنيف الزمن المتصل. لاحظ أنtarget_lengthيجب أن يكون أصغر من أو يساوي طول التسلسل لقيمات الإخراج. يتم اختيار الفهارس من[-100, 0, ..., config.vocab_size - 1]. تُتجاهل (تُقنَّع) جميع التسميات المضبوطة على-100، ولا يُحسب الخسارة إلا للتسميات الموجودة في[0, ..., config.vocab_size - 1].
يعيد
CausalLMOutput أو tuple(torch.Tensor)
CausalLMOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (Wav2Vec2Config) والمدخلات.
تُعيد طريقة Wav2Vec2ForCTC الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoProcessor, Wav2Vec2ForCTC
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> processor = AutoProcessor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForCTC.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = processor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
...     logits = model(**inputs).logits
>>> predicted_ids = torch.argmax(logits, dim=-1)

>>> # transcribe speech
>>> transcription = processor.batch_decode(predicted_ids)
>>> transcription[0]
...

>>> inputs["labels"] = processor(text=dataset[0]["text"], return_tensors="pt").input_ids

>>> # compute loss
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
load_adapter
< source >( target_lang: strforce_load = True**kwargs )
المعاملات
- target_lang (
str) — يجب أن يكون معرّف لغة لوزن مُكيّف (adapter) موجود. تُخزَّن أوزان المُكيِّف بالصيغة adapter..safetensors أو adapter. .bin - force_load (
bool، القيمة الافتراضيةTrue) — ما إذا كان سيتم تحميل الأوزان حتى في حال تطابقtarget_langمعself.target_lang. - cache_dir (
Union[str, os.PathLike], اختياري) — مسار إلى مجلد يجب تخزين إعدادات النموذج المُدرَّب مسبقًا المُحمَّل فيه مؤقتًا إذا لم يُستخدم التخزين المؤقت القياسي. - force_download (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إجبار إعادة تنزيل أوزان النموذج وملفات الإعداد، مع تجاوز النسخ المخزنة مؤقتاً إذا كانت موجودة. - proxies (
dict[str, str]، اختياري) — قاموس لخوادم الوكيل (proxy) للاستخدام حسب البروتوكول أو نقطة النهاية، على سبيل المثال{'http': 'foo.bar:3128', 'http://hostname': 'foo.bar:4012'}. تُستخدم هذه الوكلاء في كل طلب. - local_files_only(
bool, اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب الاطلاع على الملفات المحلية فقط (أي عدم محاولة تنزيل النموذج). - token (
strأوbool، اختياري) — الرمز الذي يُستخدم كتفويض حامل HTTP للملفات البعيدة. إذا كانTrue، أو لم يُحدد، فسيتم استخدام الرمز الذي تم إنشاؤه عند تشغيلhf auth login(المخزَّن في~/.huggingface). - revision (
str, اختياري, الافتراضي هو"main") — إصدار النموذج المحدد الذي سيتم استخدامه. يمكن أن يكون اسم فرع، أو اسم وسم، أو معرف التزامن (commit id)، حيث نستخدم نظامًا قائمًا على git لتخزين النماذج والموارد الأخرى على huggingface.co، لذاrevisionيمكن أن يكون أي معرّف يسمح به git.لاختبار طلب سحب قمت بإنشائه على Hub، يمكنك تمرير
revision="refs/pr/<pr_number>". - mirror (
str، اختياري) — مصدر المرآة لتسريع عمليات التنزيل في الصين. إذا كنت من الصين وتواجه مشكلة في الوصول، يمكنك ضبط هذا الخيار لحلها. يُرجى ملاحظة أننا لا نضمن حداثة البيانات أو أمانها. راجع موقع المرآة لمزيد من المعلومات.
حمّل نموذج مُكيّف لغوي من نموذج مُكيّف مُدرَّب مسبقًا.
فعّل وضع “offline-mode” الخاص لاستخدام هذه الطريقة في بيئة محمية بجدار ناري.
أمثلة:
>>> from transformers import Wav2Vec2ForCTC, AutoProcessor

>>> ckpt = "facebook/mms-1b-all"
>>> processor = AutoProcessor.from_pretrained(ckpt)
>>> model = Wav2Vec2ForCTC.from_pretrained(ckpt, target_lang="eng")
>>> # set specific language
>>> processor.tokenizer.set_target_lang("spa")
>>> model.load_adapter("spa")
Wav2Vec2ForSequenceClassification
فئة transformers.Wav2Vec2ForSequenceClassification
< source >( config: Wav2Vec2Config )
المعاملات
- config (Wav2Vec2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Wav2Vec2 مع رأس تصنيف تسلسلي في الأعلى (طبقة خطية فوق المخرجات المجمعة) لمهام مثل SUPERB Keyword Spotting.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SequenceClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, sequence_length)) — قيم عشرية لموجة الصوت الخام المُدخلة. يمكن الحصول على هذه القيم عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال باستخدام مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_values، يجب استخدام AutoProcessor لإضافة الحشو والتحويل إلى متجه من النوعtorch.Tensor. راجع Wav2Vec2Processor.call() للتفاصيل. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/الانحدار التسلسلي. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
يعيد
SequenceClassifierOutput أو tuple(torch.Tensor)
SequenceClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Wav2Vec2Config) والمدخلات.
تُعيد طريقة Wav2Vec2ForSequenceClassification الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال على تصنيف بوسم واحد:
>>> import torch
>>> from transformers import AutoTokenizer, Wav2Vec2ForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h", num_labels=num_labels)

>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
مثال على تصنيف متعدد التسميات:
>>> import torch
>>> from transformers import AutoTokenizer, Wav2Vec2ForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h", problem_type="multi_label_classification")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained(
...     "facebook/wav2vec2-base-960h", num_labels=num_labels, problem_type="multi_label_classification"
... )

>>> labels = torch.sum(
...     torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
Wav2Vec2ForAudioFrameClassification
فئة transformers.Wav2Vec2ForAudioFrameClassification
< source >( config: Wav2Vec2Config )
المعاملات
- config (Wav2Vec2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Wav2Vec2 مع رأس تصنيف الإطارات في الأعلى لمهام مثل تحديد المتحدثين.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → TokenClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, sequence_length)) — قيم عشرية لموجة الصوت الخام المُدخلة. يمكن الحصول على هذه القيم عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال باستخدام مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_values، يجب استخدام AutoProcessor لإضافة الحشو والتحويل إلى متجه من النوعtorch.Tensor. راجع Wav2Vec2Processor.call() للتفاصيل. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/الانحدار التسلسلي. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
يعيد
TokenClassifierOutput أو tuple(torch.Tensor)
TokenClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (Wav2Vec2Config) والمدخلات.
تتجاوز طريقة Wav2Vec2ForAudioFrameClassification الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة التصنيف.logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.num_labels)) — درجات التصنيف (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForAudioFrameClassification
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForAudioFrameClassification.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], return_tensors="pt", sampling_rate=sampling_rate)
>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> probabilities = torch.sigmoid(logits[0])
>>> # labels is a one-hot array of shape (num_frames, num_speakers)
>>> labels = (probabilities > 0.5).long()
>>> labels[0].tolist()
...
Wav2Vec2ForXVector
فئة transformers.Wav2Vec2ForXVector
< source >( config: Wav2Vec2Config )
المعاملات
- config (Wav2Vec2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Wav2Vec2 مع رأس لاستخراج الميزات من نوع XVector في الأعلى، للمهام مثل التحقق من المتحدث.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → XVectorOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, sequence_length)) — قيم عشرية لموجة الصوت الخام المُدخلة. يمكن الحصول على هذه القيم عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال باستخدام مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_values، يجب استخدام AutoProcessor لإضافة الحشو والتحويل إلى متجه من النوعtorch.Tensor. راجع Wav2Vec2Processor.call() للتفاصيل. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/الانحدار التسلسلي. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
يعيد
XVectorOutput أو tuple(torch.Tensor)
أمر XVectorOutput أو مجموعة (tuple) من
torch.Tensor (في حال تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (Wav2Vec2Config) والمدخلات.
تتجاوز طريقة Wav2Vec2ForXVector الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة التصنيف.logits (
torch.Tensorمن الشكل(batch_size, config.xvector_output_dim)) — حالات المخفية للتصنيف قبل AMSoftmax.embeddings (
torch.Tensorof shape(batch_size, config.xvector_output_dim)) — تمثيلات النطق المستخدمة في الاسترجاع القائم على تشابه المتجهات.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج التضمينات + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForXVector
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForXVector.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(
...     [d["array"] for d in dataset[:2]["audio"]], sampling_rate=sampling_rate, return_tensors="pt", padding=True
... )
>>> with torch.no_grad():
...     embeddings = model(**inputs).embeddings

>>> embeddings = torch.nn.functional.normalize(embeddings, dim=-1).cpu()

>>> # the resulting embeddings can be used for cosine similarity-based retrieval
>>> cosine_sim = torch.nn.CosineSimilarity(dim=-1)
>>> similarity = cosine_sim(embeddings[0], embeddings[1])
>>> threshold = 0.7  # the optimal threshold is dataset-dependent
>>> if similarity < threshold:
...     print("Speakers are not the same!")
>>> round(similarity.item(), 2)
...
Wav2Vec2ForPreTraining
فئة transformers.Wav2Vec2ForPreTraining
< source >( config: Wav2Vec2Config )
المعاملات
- config (Wav2Vec2Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Wav2Vec2 مع مُكمِّم ورأس VQ في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonemask_time_indices: typing.Optional[torch.BoolTensor] = Nonesampled_negative_indices: typing.Optional[torch.BoolTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Wav2Vec2ForPreTrainingOutput or tuple(torch.Tensor)
المعاملات
- input_values (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — قيم عشرية لموجة الصوت الخام المدخلة. يمكن الحصول على القيم عن طريق تحميل ملف صوتي من نوع.flacأو.wavفي مصفوفة من النوعlist[float]أوnumpy.ndarrayأوtorch.Tensor، على سبيل المثال عبر مكتبة torchcodec (pip install torchcodec) أو مكتبة soundfile (pip install soundfile). لتجهيز المصفوفة إلىinput_values، يجب استخدام AutoProcessor للإضافة الحشوية (padding) والتحويل إلى متجه من النوعtorch.Tensor. راجع Wav2Vec2Processor.call() للتفاصيل. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- mask_time_indices (
torch.BoolTensorمن الشكل(batch_size, sequence_length)، اختياري) — فهارس لإخفاء الميزات المستخرجة من أجل خسارة التباينية. عند التواجد في وضع التدريب، يتعلم النموذج التنبؤ بالميزات المستخرجة المخفية في فضاء config.proj_codevector_dim. - sampled_negative_indices (
torch.BoolTensorمن الشكل(batch_size, sequence_length, num_negatives)، اختياري) — فهارس تُظهر متجهات الهدف المُكمّاة المستخدمة كمتجهات سالبة مُعَيَّنة في خسارة التباينية. مدخل مطلوب للتدريب المسبق.
يعيد
Wav2Vec2ForPreTrainingOutput أو tuple(torch.Tensor)
Wav2Vec2ForPreTrainingOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (Wav2Vec2Config) والمدخلات.
تتجاوز طريقة Wav2Vec2ForPreTraining الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
*optional*، يُعاد عند تمريرsample_negative_indices،torch.Tensorمن الشكل(1,)) — إجمالي الخسارة كمجموع خسارة التباين (L_m) وخسارة التنوع (L_d) كما هو مذكور في الورقة الرسمية.projected_states (
torch.Tensorمن الشكل(batch_size, sequence_length, config.proj_codevector_dim)) — حالات النموذج المخفية المُسقطَة إلى config.proj_codevector_dim والتي يمكن استخدامها للتنبؤ بالحالات الكمّية المُسقطَة المقنّعة.projected_quantized_states (
torch.Tensorof shape(batch_size, sequence_length, config.proj_codevector_dim)) — متجهات الميزات المستخرجة المُكمّاة والمُرمّزة إلى config.proj_codevector_dim وتمثل متجهات الهدف الموجبة لخسارة التباينية.codevector_perplexity (
torch.Tensorمن الشكل(1,)) — قيمة الحيرة (perplexity) لتوزيع codevector، وتُستخدم لقياس تنوع دفتر الرموز (codebook).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
contrastive_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The contrastive loss (L_m) as stated in the official paper.diversity_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The diversity loss (L_d) as stated in the official paper.
مثال:
>>> import torch
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForPreTraining
>>> from transformers.models.wav2vec2.modeling_wav2vec2 import _compute_mask_indices, _sample_negative_indices
>>> from datasets import load_dataset

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base")
>>> model = Wav2Vec2ForPreTraining.from_pretrained("facebook/wav2vec2-base")

>>> ds = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")
>>> input_values = feature_extractor(ds[0]["audio"]["array"], return_tensors="pt").input_values  # Batch size 1

>>> # compute masked indices
>>> batch_size, raw_sequence_length = input_values.shape
>>> sequence_length = model._get_feat_extract_output_lengths(raw_sequence_length).item()
>>> mask_time_indices = _compute_mask_indices(
...     shape=(batch_size, sequence_length), mask_prob=0.2, mask_length=2
... )
>>> sampled_negative_indices = _sample_negative_indices(
...     features_shape=(batch_size, sequence_length),
...     num_negatives=model.config.num_negatives,
...     mask_time_indices=mask_time_indices,
... )
>>> mask_time_indices = torch.tensor(data=mask_time_indices, device=input_values.device, dtype=torch.long)
>>> sampled_negative_indices = torch.tensor(
...     data=sampled_negative_indices, device=input_values.device, dtype=torch.long
... )

>>> with torch.no_grad():
...     outputs = model(input_values, mask_time_indices=mask_time_indices)

>>> # compute cosine similarity between predicted (=projected_states) and target (=projected_quantized_states)
>>> cosine_sim = torch.cosine_similarity(outputs.projected_states, outputs.projected_quantized_states, dim=-1)

>>> # show that cosine similarity is much higher than random
>>> cosine_sim[mask_time_indices.to(torch.bool)].mean() > 0.5
tensor(True)

>>> # for contrastive loss training model should be put into train mode
>>> model = model.train()
>>> loss = model(
...     input_values, mask_time_indices=mask_time_indices, sampled_negative_indices=sampled_negative_indices
... ).loss