
Transformers documentation
Bark
تمت مساهمة هذا النموذج في Hugging Face Transformers في 17 يوليو 2023.
Bark

نظرة عامة
Bark هو نموذج لتحويل النص إلى كلام يعتمد على معمارية الترانسفورمر، وقد اقترحه Suno AI في suno-ai/bark.
يتكوّن Bark من أربعة نماذج رئيسية:
- BarkSemanticModel (يُشار إليه أيضاً بنموذج «النص»): نموذج تحويلي ذاتي التوليد السببي يستقبل كنص مُرمَّز (مُرمَّز إلى رموز) مدخلات، ويتنبأ برموز نصية دلالية تلتقط المعنى الدلالي للنص.
- BarkCoarseModel (يُشار إليه أيضاً بنموذج «الصوتيات الخشنة»): وهو محوّل ذاتي تسلسلي سببي، يستقبل كمدخلات نتائج نموذج BarkSemanticModel. يهدف إلى التنبؤ بكودكتا الصوت الأولين اللذين يتطلبهما EnCodec.
- BarkFineModel (نموذج «الصوتيات الدقيقة»)، وهو هذه المرة محوّل مُشفِّر-مُفكِّك ذاتي غير سببي، يتنبأ بشكل تكراري بكتب الرموز الأخيرة بناءً على مجموع تمثيلات كتب الرموز السابقة.
- بعد أن يتنبأ بجميع قنوات كتاب الرموز من EncodecModel، يستخدم Bark ذلك لفك ترميز مصفوفة الصوت الناتجة.
يجب الإشارة إلى أن كلًا من الوحدات الثلاث الأولى يمكن أن تدعم تضمينات المتحدث الشرطية (conditional speaker embeddings) لتكييف الصوت الناتج وفقًا لصوت محدد مسبقًا.
تمت مساهمة هذا النموذج من قِبل Yoach Lacombe (ylacombe) وSanchit Gandhi (sanchit-gandhi). يمكن العثور على الكود الأصلي هنا.
تحسين Bark
يمكن تحسين Bark بعدد قليل من الأسطر الإضافية من الكود، مما يقلل بصمة الذاكرة الخاصة به بشكل كبير ويسرّع الاستدلال.
استخدام الدقة النصفية
يمكنك تسريع الاستدلال وتقليل بصمة الذاكرة بنسبة 50% ببساطة عن طريق تحميل النموذج بدقة نصفية.
from transformers import BarkModel


model = BarkModel.from_pretrained("suno/bark-small", device_map="auto")
استخدام تفريغ المعالج
كما ذُكر أعلاه، يتكوّن Bark من أربعة نماذج فرعية، تُستدعى بالتتابع أثناء توليد الصوت. بعبارة أخرى، بينما يُستخدم أحد النماذج الفرعية، تبقى النماذج الفرعية الأخرى خاملة.
إذا كنت تستخدم معالج CUDA GPU أو Intel XPU، فإن حلاً بسيطاً للاستفادة من خفض بنسبة 80% في حجم الذاكرة هو نقل النماذج الفرعية من الجهاز إلى المعالج المركزي (CPU) عندما تكون غير نشطة. يُسمى هذا الإجراء إسناد المعالجة إلى المعالج المركزي (CPU offloading). يمكنك استخدامه بسطر واحد من الكود على النحو التالي:
model.enable_cpu_offload()
لاحظ أن 🤗 Accelerate يجب تثبيته قبل استخدام هذه الميزة. إليك كيفية تثبيته.
استخدام Flash Attention 2
Flash Attention 2 هي نسخة أسرع وأكثر تحسينًا من التحسين السابق.
التثبيت
أولاً، تحقق من توافق عتادك مع Flash Attention 2. يمكن العثور على أحدث قائمة بالعتاد المتوافق في التوثيق الرسمي. ثم ثبّت أحدث إصدار من Flash Attention 2:
pip install -U flash-attn --no-build-isolation
الاستخدام
لتحميل نموذج باستخدام Flash Attention 2، يمكننا تمرير علم attn_implementation="flash_attention_2" إلى from_pretrained(). كما سنقوم بتحميل النموذج بدقة نصفية (مثل torch.float16)، لأن ذلك يؤدي إلى تدهور شبه معدوم في جودة الصوت مع انخفاض كبير في استهلاك الذاكرة وتسريع لعملية الاستدلال:
model = BarkModel.from_pretrained("suno/bark-small", attn_implementation="flash_attention_2", device_map="auto")مقارنة الأداء
يُظهر المخطط أدناه زمن الاستجابة لتنفيذ الانتباه الأصلي (بدون تحسين) مقارنةً بـ Flash Attention 2. في جميع الحالات، قمنا بتوليد 400 رمز دلالي على بطاقة GPU من طراز A100 بسعة 40GB باستخدام PyTorch 2.1:
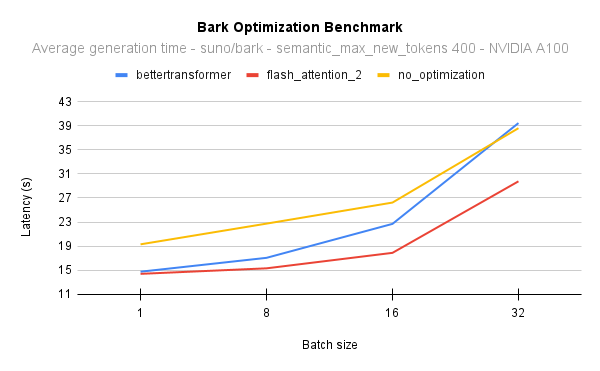
لإعطاء صورة أوضح، على بطاقة NVIDIA A100 وعند توليد 400 رمز دلالي بحجم دفعة (batch size) يساوي 16، يمكنك الحصول على معدل إنتاجية أعلى بـ 17 مرة، مع أن يكون أسرع بثانيتين مقارنةً بتوليد الجمل واحدة تلو الأخرى باستخدام التنفيذ الأصلي للنموذج. بمعنى آخر، سيتم توليد جميع العينات أسرع بـ 17 مرة.
دمج تقنيات التحسين
يمكنك دمج تقنيات التحسين، واستخدام CPU offload والدقة النصفية وFlash Attention 2 جميعها في آنٍ واحد.
from transformers import BarkModel


# load in fp16 and use Flash Attention 2
model = BarkModel.from_pretrained("suno/bark-small", attn_implementation="flash_attention_2", device_map="auto")

# enable CPU offload
model.enable_cpu_offload()
اطّلع على المزيد حول تقنيات تحسين الاستدلال هنا.
نصائح للاستخدام
توفر Suno مكتبة من الإعدادات المسبقة للأصوات بعدة لغات هنا. كما تم رفع هذه الإعدادات المسبقة في المحور هنا أو هنا.
from transformers import AutoProcessor, BarkModel


processor = AutoProcessor.from_pretrained("suno/bark")
model = BarkModel.from_pretrained("suno/bark", device_map="auto")

voice_preset = "v2/en_speaker_6"

inputs = processor("Hello, my dog is cute", voice_preset=voice_preset)

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
يمكن لـ Bark توليد كلام واقعي للغاية ومتعدد اللغات بالإضافة إلى أصوات أخرى - بما في ذلك الموسيقى والضوضاء الخلفية ومؤثرات الصوت البسيطة.
# Multilingual speech - simplified Chinese
inputs = processor("惊人的!我会说中文")

# Multilingual speech - French - let's use a voice_preset as well
inputs = processor("Incroyable! Je peux générer du son.", voice_preset="fr_speaker_5")

# Bark can also generate music. You can help it out by adding music notes around your lyrics.
inputs = processor("♪ Hello, my dog is cute ♪")

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
يمكن للنموذج أيضاً إنتاج تواصل غير لفظي مثل الضحك والزفير والبكاء.
# Adding non-speech cues to the input text
inputs = processor("Hello uh [clears throat], my dog is cute [laughter]")

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
لحفظ الصوت، ما عليك سوى أخذ معدل العينة من إعدادات النموذج وبعض أدوات scipy:
from scipy.io.wavfile import write as write_wav


# save audio to disk, but first take the sample rate from the model config
sample_rate = model.generation_config.sample_rate
write_wav("bark_generation.wav", sample_rate, audio_array)
BarkConfig
فئة transformers.BarkConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonesemantic_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonecoarse_acoustics_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonefine_acoustics_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonecodec_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02 )
المعاملات
- semantic_config (BarkSemanticConfig، اختياري) — إعدادات النموذج الفرعي الدلالي الأساسي.
- coarse_acoustics_config (BarkCoarseConfig، اختياري) — إعدادات نموذج الصوتيات الخشن الأساسي.
- fine_acoustics_config (BarkFineConfig، اختياري) — إعدادات نموذج الصوتيات الدقيقة الفرعي الأساسي.
- codec_config (AutoConfig، اختياري) — إعدادات نموذج الترميز الفرعي الأساسي.
- initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات BarkModel. تُستخدم لاستنساخ نموذج Bark وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استنساخ إعدادات باستخدام القيم الافتراضية سيُنتج إعدادات مشابهة لتلك الخاصة بـ suno/bark
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     BarkSemanticConfig,
...     BarkCoarseConfig,
...     BarkFineConfig,
...     BarkModel,
...     BarkConfig,
...     AutoConfig,
... )

>>> # Initializing Bark sub-modules configurations.
>>> semantic_config = BarkSemanticConfig()
>>> coarse_acoustics_config = BarkCoarseConfig()
>>> fine_acoustics_config = BarkFineConfig()
>>> codec_config = AutoConfig.from_pretrained("facebook/encodec_24khz")


>>> # Initializing a Bark module style configuration
>>> configuration = BarkConfig(
...     semantic_config, coarse_acoustics_config, fine_acoustics_config, codec_config
... )

>>> # Initializing a model (with random weights)
>>> model = BarkModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BarkProcessor
فئة transformers.BarkProcessor
< source >( tokenizerspeaker_embeddings = None )
المعاملات
- tokenizer (
BertTokenizer) — مُجزِّئ الرموز هو مدخل إلزامي. - speaker_embeddings (
dict[dict[str]]، اختياري) — قاموس متداخل اختياري لتضمينات المتحدثين. يحتوي المستوى الأول على أسماء إعدادات الصوت (مثل"en_speaker_4"). يحتوي المستوى الثاني على تضمينات"semantic_prompt"و"coarse_prompt"و"fine_prompt". تتوافق القيم مع مسارnp.ndarrayالمقابل. راجع هنا لقائمة بأسماءvoice_preset_names.
ينشئ BarkProcessor الذي يغلّف مُجزِّئ (tokenizer) في مُعالِج واحد.
يوفر BarkProcessor جميع وظائف BertTokenizer. راجع ~BertTokenizer لمزيد من المعلومات.
__call__
< source >( text = Nonevoice_preset = Nonereturn_tensors = 'pt'max_length = 256add_special_tokens = Falsereturn_attention_mask = Truereturn_token_type_ids = False**kwargs ) → BatchEncoding
المعاملات
- text (`
) -- The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, setis_split_into_words=True` to avoid ambiguity with batched inputs. - voice_preset (
str,dict[np.ndarray]) — إعداد الصوت المسبق، أي تضمينات المتحدث. يمكن أن يكون اسمًا صالحًا لإعداد voice_preset، مثل"en_speaker_1"، أو قاموسًا مباشرًا من تضميناتnp.ndarrayلكل نموذج فرعي منBark. أو يمكن أن يكون اسم ملف صالح لإعداد صوت مسبق محلي واحد بصيغة.npzيحتوي على المفاتيح"semantic_prompt"و"coarse_prompt"و"fine_prompt". - return_tensors (`
, defaults topt`) — إذا تم ضبطه، فسيُرجع متجهات (tensors) لإطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- max_length (
int, الافتراضي هو256) — يتحكم في الحد الأقصى للطول الذي سيُستخدم بواسطة أحد معاملات القص/الحشو. إذا تُرك غير مُعيَّن أو تم تعيينه إلى None، فسيُستخدم الحد الأقصى للطول المُعرَّف مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب حدًا أقصى للطول. إذا لم يكن للنموذج حد أقصى محدد لطول الإدخال (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى حد أقصى للطول.إذا تُرك غير مُعيَّن أو عُدِّل إلى
None، فسيتم استخدام الطول الأقصى المُعرَّف مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب طولًا أقصى. وإذا لم يكن للنموذج طول إدخال أقصى محدد (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى طول أقصى. - add_special_tokens (
bool، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسيةPretrainedTokenizerBase.build_inputs_with_special_tokens، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. يكون هذا مفيدًا إذا كنت ترغب في إضافة رموزbosأوeosتلقائيًا. - return_attention_mask (
bool, الافتراضي هوTrue) — ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقًا للافتراضي الخاص بمجزّئ الرموز المحدد، كما هو معرّف بواسطةreturn_outputsالخاصية. - return_token_type_ids (
bool, القيمة الافتراضية هيFalse) — ما إذا كان يجب إرجاع معرّفات أنواع الرموز. إذا تُركت القيمة الافتراضية، فسيتم إرجاع معرّفات أنواع الرموز وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المعني، كما تحددها خاصيةreturn_outputs.
يعيد
كائن BatchEncoding يحتوي على مخرجات tokenizer.
إذا تم تقديم إعداد مسبق للصوت، فسيحتوي الكائن المُعاد على مفتاح "history_prompt"
يحتوي على BatchFeature، أي الإعداد المسبق للصوت مع نوع الموترات الصحيح.
from_pretrained
< source >( pretrained_processor_name_or_pathspeaker_embeddings_dict_path = 'speaker_embeddings_path.json'**kwargs )
المعاملات
- pretrained_model_name_or_path (
strأوos.PathLike) — يمكن أن يكون هذا:- سلسلة نصية، وهي معرف النموذج لمعالج BarkProcessor مُدرَّب مسبقاً ومُستضاف داخل مستودع نموذج على huggingface.co.
- مسار إلى مجلد يحتوي على معالج محفوظ باستخدام طريقة save_pretrained()، على سبيل المثال
./my_model_directory/.
- speaker_embeddings_dict_path (
str، اختياري، القيمة الافتراضية"speaker_embeddings_path.json") — اسم ملف.jsonالذي يحتوي على قاموس speaker_embeddings الموجود فيpretrained_model_name_or_path. إذا كانت القيمةNone، فلن يتم تحميل speaker_embeddings. - **kwargs —
معلمات إضافية تُمرَّر إلى
~tokenization_utils_base.PreTrainedTokenizer.from_pretrained.
أنشئ معالج Bark مرتبطاً بنموذج مُدرَّب مسبقاً.
save_pretrained
< source >( save_directoryspeaker_embeddings_dict_path = 'speaker_embeddings_path.json'speaker_embeddings_directory = 'speaker_embeddings'push_to_hub: bool = False**kwargs )
المعاملات
- save_directory (
strأوos.PathLike) — المجلد الذي سيتم حفظ ملفات المرمّز (tokenizer) وتضمينات المتكلمين فيه (سيتم إنشاء المجلد إذا لم يكن موجودًا). - speaker_embeddings_dict_path (
str، اختياري، القيمة الافتراضية"speaker_embeddings_path.json") — اسم ملف.jsonالذي سيحتوي على قاموس المسارات المتداخلة الخاص بـ speaker_embeddings، إذا كان موجودًا، وسيُوضع فيpretrained_model_name_or_path/speaker_embeddings_directory. - speaker_embeddings_directory (
str، اختياري، القيمة الافتراضية"speaker_embeddings/") — اسم المجلد الذي سيتم حفظ مصفوفات speaker_embeddings فيه. - push_to_hub (
bool، اختياري، الافتراضيFalse) — ما إذا كان سيتم دفع نموذجك إلى مركز نماذج Hugging Face بعد حفظه. يمكنك تحديد المستودع الذي تريد الدفع إليه باستخدامrepo_id(سيكون الافتراضي هو اسمsave_directoryفي نطاقك). - kwargs — حجج إضافية مُعرَّفة بالكلمات المفتاحية تُمرَّر إلى طريقة push_to_hub().
يحفظ سمات هذا المعالج (المجزّئ…) في المجلد المحدد بحيث يمكن إعادة تحميله باستخدام طريقة from_pretrained().
BarkModel
فئة transformers.BarkModel
< source >( config: BarkConfig )
المعاملات
- config (BarkConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Bark الكامل، وهو نموذج لتحويل النص إلى كلام يتكون من 4 نماذج فرعية:
- BarkSemanticModel (يُشار إليه أيضاً بنموذج «النص»): نموذج تحويلي ذاتي التوليد السببي يستقبل كنص مُرمَّز مدخلات، ويتنبأ برموز نصية دلالية تلتقط المعنى الدلالي للنص.
- BarkCoarseModel (يُشار إليه أيضاً بنموذج «الصوتيات الخشنة»)، وهو أيضاً محوّل ذاتي تسلسلي سببي،
يستقبل في مدخلاته نتائج النموذج السابق. يهدف إلى استرجاع أول كتيبيّين صوتيين ضروريين
لتشفير
encodec. - BarkFineModel (نموذج «الصوتيات الدقيقة»)، وهو هذه المرة محوّل مُشفِّر-مُفكِّك ذاتي غير سببي، يتنبأ بشكل تكراري بكتب الرموز الأخيرة بناءً على مجموع تمثيلات كتب الرموز السابقة.
- بعد أن تتنبأ بجميع قنوات كتاب الرموز من EncodecModel، يستخدم Bark ذلك لفك ترميز مصفوفة الصوت الناتجة.
يجب الإشارة إلى أن كلًا من الوحدات الثلاث الأولى يمكن أن تدعم تضمينات المتحدث الشرطية (conditional speaker embeddings) لتكييف الصوت الناتج وفقًا لصوت محدد مسبقًا.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
generate
< source >( input_ids: typing.Optional[torch.Tensor] = Nonehistory_prompt: dict[str, torch.Tensor] | None = Nonereturn_output_lengths: bool | None = None**kwargs ) → By default
المعاملات
- input_ids (
Optional[torch.Tensor]من الشكل (batch_size, seq_len)، اختياري) — المعرّفات المدخلة. سيتم اقتطاعها حتى 256 رمزًا. لاحظ أن الأصوات الناتجة ستكون بنفس طول أطول توليد ضمن الدفعة. - history_prompt (
Optional[dict[str,torch.Tensor]]، اختياري) — موجّه متحدثBarkاختياري. يُرجى ملاحظة أن هذا النموذج يقبل حالياً موجّه متحدث واحد فقط لكل دفعة. - kwargs (اختياري) — المتبقي من قاموس معاملات الكلمات المفتاحية. تنقسم معاملات الكلمات المفتاحية إلى نوعين:
- بدون بادئة، سيتم إدخالها على أنها
**kwargsلطريقةgenerateلكل نموذج فرعي. - مع بادئة semantic_، coarse_، fine_، ستكون مدخلات لطريقة
generateالخاصة بالمدلولي والخشن والدقيق على التوالي. ولها الأولوية على الكلمات المفتاحية التي لا تحمل بادئة.
هذا يعني أنه يمكنك، على سبيل المثال، تحديد استراتيجية توليد لجميع النماذج الفرعية باستثناء نموذج واحد.
- بدون بادئة، سيتم إدخالها على أنها
- return_output_lengths (
bool, اختياري) — ما إذا كان يجب إرجاع أطوال الموجات الصوتية أم لا. مفيد عند معالجة الدُفعات.
يعيد
بشكل افتراضي
- audio_waveform (
torch.Tensorمن الشكل (batch_size, seq_len)): موجة الصوت المولّدة. عندما يكونreturn_output_lengths=True: يعيد مجموعة (tuple) تتكون من: - audio_waveform (
torch.Tensorمن الشكل (batch_size, seq_len)): موجة الصوت المولّدة. - output_lengths (
torch.Tensorمن الشكل (batch_size)): طول كل موجة صوتية في الدفعة
يولّد صوتًا من موجه إدخال وموجه متحدث إضافي اختياري من Bark.
مثال:
>>> from transformers import AutoProcessor, BarkModel

>>> processor = AutoProcessor.from_pretrained("suno/bark-small")
>>> model = BarkModel.from_pretrained("suno/bark-small")

>>> # To add a voice preset, you can pass `voice_preset` to `BarkProcessor.__call__(...)`
>>> voice_preset = "v2/en_speaker_6"

>>> inputs = processor("Hello, my dog is cute, I need him in my life", voice_preset=voice_preset)

>>> audio_array = model.generate(**inputs, semantic_max_new_tokens=100)
>>> audio_array = audio_array.cpu().numpy().squeeze()
enable_cpu_offload
< source >( accelerator_id: int | None = 0**kwargs )
ينقل جميع النماذج الفرعية إلى وحدة المعالجة المركزية (CPU) باستخدام accelerate، مما يقلل من استهلاك الذاكرة مع تأثير ضئيل على الأداء. تنقل هذه الطريقة نموذجًا فرعيًا كاملًا واحدًا في كل مرة إلى المُسرِّع (accelerator) عند استخدامه، ويبقى النموذج الفرعي في المُسرِّع حتى تشغيل النموذج الفرعي التالي.
BarkSemanticModel
فئة transformers.BarkSemanticModel
< source >( config: BarkSubModelConfig )
المعاملات
- config (
BarkSubModelConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Bark الدلالي (أو النصي). يتشارك نفس البنية المعمارية مع النموذج الخشن. إنه نموذج ذاتي التراجع يشبه GPT-2، ويحمل رأساً لنمذجة اللغة في قمته.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → CausalLMOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
CausalLMOutputWithPast أو tuple(torch.Tensor)
CausalLMOutputWithPast أو مجموعة (tuple) من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (BarkConfig) والمدخلات.
تتجاوز طريقة BarkCausalModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
BarkCoarseModel
فئة transformers.BarkCoarseModel
< source >( config: BarkSubModelConfig )
المعاملات
- config (
BarkSubModelConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Bark الصوتي الخشن. يشارك النموذج الدلالي (أو النصي) نفس البنية. وهو نموذج ذاتي التراجع يشبه GPT-2، مع رأس لنمذجة اللغة في قمته.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → CausalLMOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
CausalLMOutputWithPast أو tuple(torch.Tensor)
CausalLMOutputWithPast أو مجموعة (tuple) من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (BarkConfig) والمدخلات.
تتجاوز طريقة BarkCausalModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
BarkFineModel
فئة transformers.BarkFineModel
< source >( config: BarkFineConfig )
المعاملات
- config (BarkFineConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Bark الخاص بالصوتيات الدقيقة. وهو نموذج غير سببي يشبه GPT ويتضمن config.n_codes_total من طبقات التضمين ورؤوس نمذجة اللغة، واحدة لكل دفتر رموز.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( codebook_idx: intinput_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskedLMOutput or tuple(torch.Tensor)
المعاملات
- codebook_idx (
int) — مؤشر دفتر الرموز الذي سيتم التنبؤ به. - input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — لم يتم تنفيذه بعد. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MaskedLMOutput أو tuple(torch.Tensor)
MaskedLMOutput أو مجموعة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (BarkConfig) والمدخلات.
تتجاوز طريقة BarkFineModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة المقنّعة (MLM).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
BarkCausalModel
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → CausalLMOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
CausalLMOutputWithPast أو tuple(torch.Tensor)
CausalLMOutputWithPast أو مجموعة (tuple) من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (BarkConfig) والمدخلات.
تتجاوز طريقة BarkCausalModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
BarkCoarseConfig
فئة transformers.BarkCoarseConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneblock_size: int = 1024input_vocab_size: int = 10048output_vocab_size: int = 10048num_layers: int = 12num_heads: int = 12hidden_size: int = 768dropout: float | int = 0.0bias: bool = Trueinitializer_range: float = 0.02use_cache: bool = True )
المعاملات
- block_size (
int، اختياري، القيمة الافتراضية 1024) — أقصى طول تسلسل قد يُستخدم مع هذا النموذج. يُنصح عادةً بإعداد هذه القيمة على رقم كبير احتياطاً (مثل 512 أو 1024 أو 2048). - input_vocab_size (
int, اختياري، القيمة الافتراضية 10_048) — حجم مفردات نموذج Bark الفرعي. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinputs_idsالمُمررة عند استدعاء{model}. القيمة الافتراضية هي 10_048، لكن ينبغي التفكير فيها بعناية مع مراعاة النموذج الفرعي المختار. - output_vocab_size (
int، اختياري، القيمة الافتراضية 10_048) — حجم مفردات المخرجات لنموذج Bark الفرعي. يحدد عدد الرموز المختلفة التي يمكن تمثيلها عبر:output_idsعند تمرير{model}إلى الأمام. القيمة الافتراضية هي 10_048، لكن ينبغي دراستها بعناية في ضوء النموذج الفرعي المختار. - num_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — النسبة لجميع طبقات dropout. - bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام الانحياز في الطبقات الخطية وطبقات تطبيع الطبقة أم لا - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
هذه فئة الإعدادات المخزنة لإعدادات BarkModel. تُستخدم لاستنساخ نموذج Bark وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استنساخ إعدادات باستخدام القيم الافتراضية سيُنتج إعدادات مشابهة لتلك الخاصة بـ suno/bark
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import BarkCoarseConfig, BarkCoarseModel

>>> # Initializing a Bark sub-module style configuration
>>> configuration = BarkCoarseConfig()

>>> # Initializing a model (with random weights) from the suno/bark style configuration
>>> model = BarkCoarseModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BarkFineConfig
فئة transformers.BarkFineConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneblock_size: int = 1024input_vocab_size: int = 10048output_vocab_size: int = 10048num_layers: int = 12num_heads: int = 12hidden_size: int = 768dropout: float | int = 0.0bias: bool = Trueinitializer_range: float = 0.02use_cache: bool = Truetie_word_embeddings: bool = Truen_codes_total: int = 8n_codes_given: int = 1 )
المعاملات
- block_size (
int، اختياري، القيمة الافتراضية 1024) — أقصى طول تسلسل قد يُستخدم مع هذا النموذج. يُنصح عادةً بإعداد هذه القيمة على رقم كبير احتياطاً (مثل 512 أو 1024 أو 2048). - input_vocab_size (
int, اختياري، القيمة الافتراضية 10_048) — حجم مفردات نموذج Bark الفرعي. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinputs_idsالمُمررة عند استدعاء{model}. القيمة الافتراضية هي 10_048، لكن ينبغي التفكير فيها بعناية مع مراعاة النموذج الفرعي المختار. - output_vocab_size (
int، اختياري، القيمة الافتراضية 10_048) — حجم مفردات المخرجات لنموذج Bark الفرعي. يحدد عدد الرموز المختلفة التي يمكن تمثيلها عبر:output_idsعند تمرير{model}إلى الأمام. القيمة الافتراضية هي 10_048، لكن ينبغي دراستها بعناية في ضوء النموذج الفرعي المختار. - num_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — النسبة لجميع طبقات dropout. - bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام الانحياز في الطبقات الخطية وطبقات تطبيع الطبقة أم لا - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج. - n_codes_total (
int، اختياري، القيمة الافتراضية 8) — إجمالي عدد كتل رموز الصوت المتوقعة. يُستخدم في النموذج الفرعي للصوتيات الدقيقة. - n_codes_given (
int، اختياري، القيمة الافتراضية 1) — عدد دواوين الرموز الصوتية التي يتم التنبؤ بها في نموذج الصوتيات الخشن الفرعي. يُستخدم في نماذج الصوتيات الفرعية.
هذه فئة الإعدادات المخزنة لإعدادات BarkModel. تُستخدم لاستنساخ نموذج Bark وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استنساخ إعدادات باستخدام القيم الافتراضية سيُنتج إعدادات مشابهة لتلك الخاصة بـ suno/bark
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import BarkFineConfig, BarkFineModel

>>> # Initializing a Bark sub-module style configuration
>>> configuration = BarkFineConfig()

>>> # Initializing a model (with random weights) from the suno/bark style configuration
>>> model = BarkFineModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BarkSemanticConfig
فئة transformers.BarkSemanticConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneblock_size: int = 1024input_vocab_size: int = 10048output_vocab_size: int = 10048num_layers: int = 12num_heads: int = 12hidden_size: int = 768dropout: float | int = 0.0bias: bool = Trueinitializer_range: float = 0.02use_cache: bool = True )
المعاملات
- block_size (
int، اختياري، القيمة الافتراضية 1024) — أقصى طول تسلسل قد يُستخدم مع هذا النموذج. يُنصح عادةً بإعداد هذه القيمة على رقم كبير احتياطاً (مثل 512 أو 1024 أو 2048). - input_vocab_size (
int, اختياري، القيمة الافتراضية 10_048) — حجم مفردات نموذج Bark الفرعي. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinputs_idsالمُمررة عند استدعاء{model}. القيمة الافتراضية هي 10_048، لكن ينبغي التفكير فيها بعناية مع مراعاة النموذج الفرعي المختار. - output_vocab_size (
int، اختياري، القيمة الافتراضية 10_048) — حجم مفردات المخرجات لنموذج Bark الفرعي. يحدد عدد الرموز المختلفة التي يمكن تمثيلها عبر:output_idsعند تمرير{model}إلى الأمام. القيمة الافتراضية هي 10_048، لكن ينبغي دراستها بعناية في ضوء النموذج الفرعي المختار. - num_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — النسبة لجميع طبقات dropout. - bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام الانحياز في الطبقات الخطية وطبقات تطبيع الطبقة أم لا - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
هذه فئة الإعدادات المخزنة لإعدادات BarkModel. تُستخدم لاستنساخ نموذج Bark وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استنساخ إعدادات باستخدام القيم الافتراضية سيُنتج إعدادات مشابهة لتلك الخاصة بـ suno/bark
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import BarkSemanticConfig, BarkSemanticModel

>>> # Initializing a Bark sub-module style configuration
>>> configuration = BarkSemanticConfig()

>>> # Initializing a model (with random weights) from the suno/bark style configuration
>>> model = BarkSemanticModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config