
Transformers documentation
VideoMAE
نُشر هذا النموذج في أوراق HF في 23 مارس 2022، وأُضيف إلى مكتبة Hugging Face Transformers في 4 أغسطس 2022.
VideoMAE


نظرة عامة
قُدِّم نموذج VideoMAE في VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training من قِبل Zhan Tong وYibing Song وJue Wang وLimin Wang. يوسّع VideoMAE نطاق المشفّرات التلقائية المقنّعة (MAE) إلى الفيديو، مدّعيًا أداءً متقدمًا على عدة معايير تصنيف فيديو.
المستخلص من الورقة البحثية هو كالتالي:
تتطلب نماذج التحوّل (Transformers) المصممة للفيديو، بشكل عام، تدريبًا مسبقًا على مجموعات بيانات ضخمة جدًا لتحقيق أداء متميز على مجموعات بيانات أصغر نسبيًا. في هذه الورقة، نُظهر أن مشفّرات الفيديو المقنّعة (VideoMAE) هي متعلّمون فعّالون من حيث استخدام البيانات للتدريب المسبق غير المُشرط (SSVP) للفيديو. استلهمنا من ImageMAE الحديثة واقترحنا تصميمًا مخصصًا لتقنية التغطية (Masking) وإعادة بناء أنابيب الفيديو (Video Tube). اتضح أن هذه التصاميم البسيطة فعّالة في التغلب على تسرّب المعلومات الناتج عن الارتباط الزمني أثناء إعادة بناء الفيديو. توصلنا إلى ثلاث نتائج مهمة حول SSVP: (1) نسبة تغطية عالية جدًا (أي من 90% إلى 95%) لا تزال تمنح أداءً مواتيًا لـ VideoMAE. المحتوى الزمني المتكرر في الفيديو يتيح نسبة تغطية أعلى مما هو الحال مع الصور. (2) يحقق VideoMAE نتائج مبهرة على مجموعات بيانات صغيرة جدًا (أي حوالي 3k-4k فيديو) دون استخدام أي بيانات إضافية. يُعزى هذا جزئيًا إلى صعوبة مهمة إعادة بناء الفيديو التي تفرض تعلّم البنى على مستوى عالٍ. (3) يُظهر VideoMAE أن جودة البيانات أهم من كمية البيانات في SSVP. انزياح المجال (Domain Shift) بين مجموعة البيانات للتدريب المسبق ومجموعة البيانات المستهدفة هو من القضايا المهمة في SSVP. ومن الجدير بالذكر أن نموذج VideoMAE الخاص بنا، الذي يعتمد على هيكل ViT القياسي، يحقق 83.9% على Kinects-400، و75.3% على Something-Something V2، و90.8% على UCF101، و61.1% على HMDB51 دون استخدام أي بيانات إضافية.
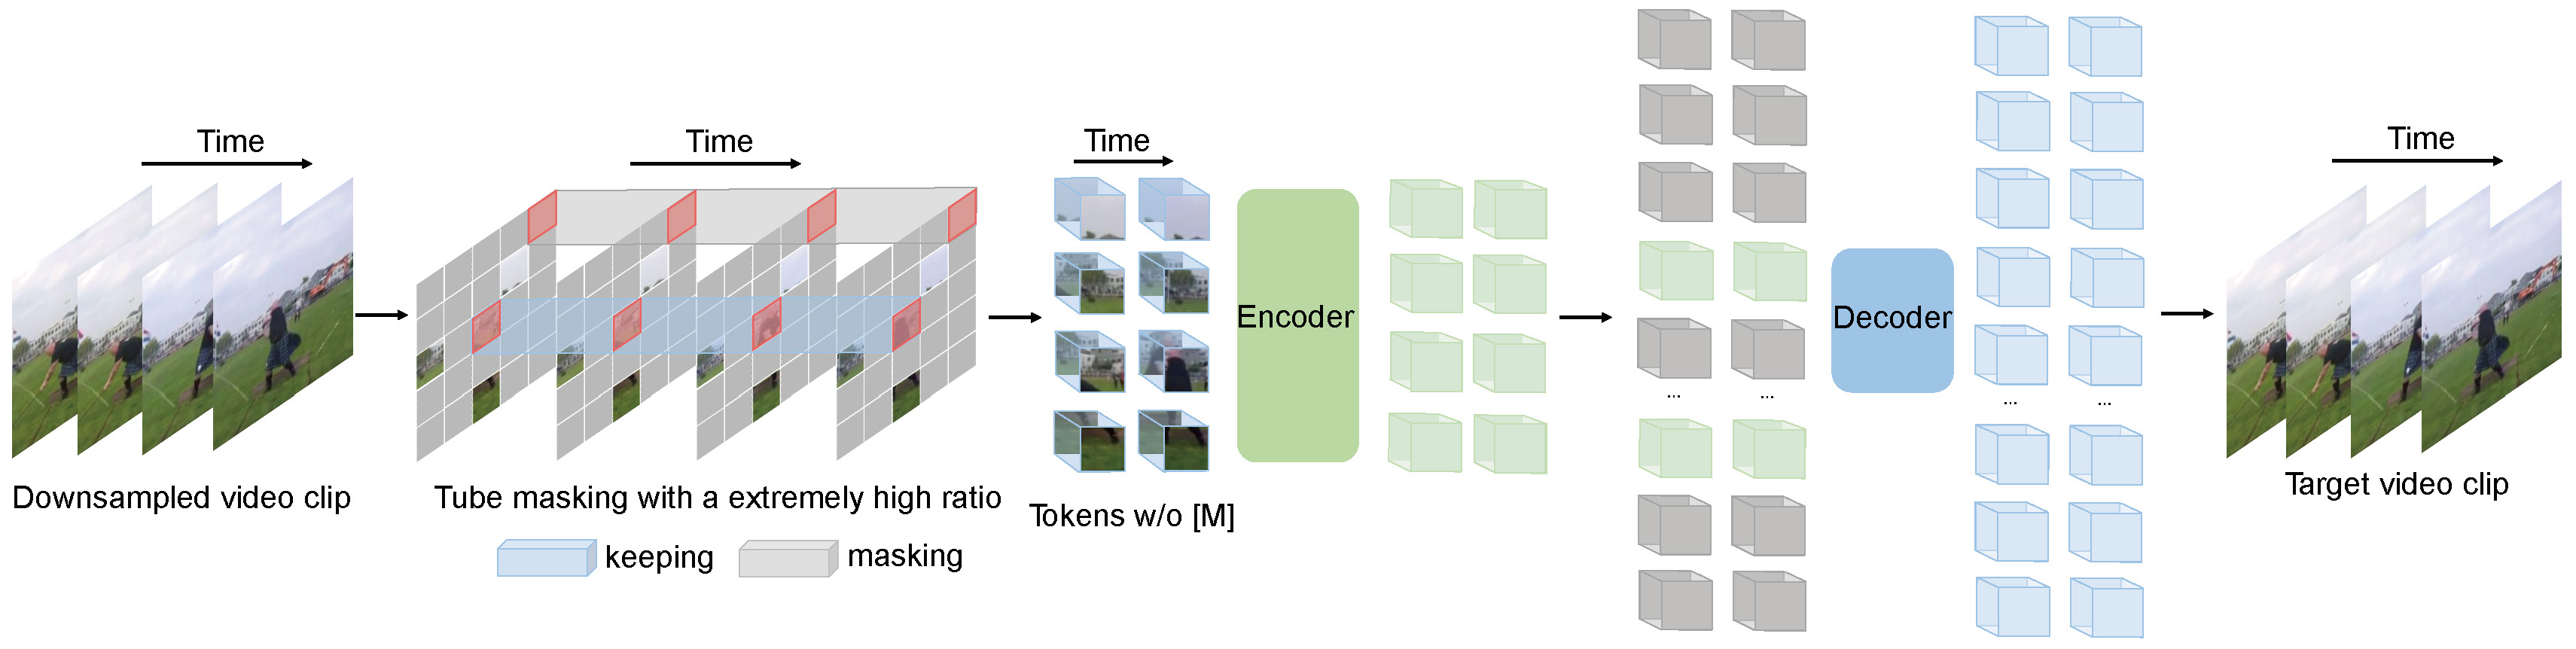 VideoMAE pre-training. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
استخدام الانتباه القياسي بنقطة منتج
يتضمن PyTorch مُشغّلًا أصليًا للانتباه بنقطة جدولية مُقيّمة (SDPA) كجزء من torch.nn.functional. تشمل هذه الدالة عدة تطبيقات يمكن تطبيقها اعتمادًا على المدخلات والعتاد المستخدم. راجع التوثيق الرسمي أو صفحة GPU Inference لمزيد من المعلومات.
يُستخدم SDPA افتراضيًا لـ torch>=2.1.1 عندما تكون هناك نسخة تنفيذية متاحة، لكن يمكنك أيضًا تعيين attn_implementation="sdpa" في from_pretrained() لطلب استخدام SDPA بشكل صريح.
from transformers import VideoMAEForVideoClassification


model = VideoMAEForVideoClassification.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics", attn_implementation="sdpa", device_map="auto")
...
للحصول على أفضل تسارعات، ننصح بتحميل النموذج بدقة نصفية (مثل torch.float16 أو torch.bfloat16).
في معيار محلي (A100-40GB، PyTorch 2.3.0، نظام التشغيل Ubuntu 22.04) باستخدام float32 ونموذج MCG-NJU/videomae-base-finetuned-kinetics، لاحظنا التسارعات التالية أثناء الاستدلال.
| حجم الدفعة | متوسط زمن الاستدلال (مللي ثانية)، وضع العاجل | متوسط زمن الاستدلال (مللي ثانية)، نموذج sdpa | تسريع، Sdpa / Eager (x) |
|---|---|---|---|
| 1 | 37 | 10 | 3.7 |
| 2 | 24 | 18 | 1.33 |
| 4 | 43 | 32 | 1.34 |
| 8 | 84 | 60 | 1.4 |
الموارد
قائمة بالموارد الرسمية من Hugging Face وموارد المجتمع (المشار إليها بـ 🌎) لمساعدتك على البدء باستخدام VideoMAE. إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب (Pull Request) وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
تصنيف الفيديو
- دفتر ملاحظات يوضح كيفية ضبط نموذج VideoMAE على مجموعة بيانات مخصصة.
- دليل مهمة تصنيف الفيديو
- مساحة 🤗 تُظهر كيفية تنفيذ الاستدلال باستخدام نموذج تصنيف الفيديو.
VideoMAEConfig
فئة transformers.VideoMAEConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneimage_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3num_frames: int = 16tubelet_size: int = 2hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0initializer_range: float = 0.02layer_norm_eps: float = 1e-12qv_bias: bool = Trueuse_mean_pooling: bool = Truedecoder_num_attention_heads: int = 6decoder_hidden_size: int = 384decoder_num_hidden_layers: int = 4decoder_intermediate_size: int = 1536norm_pix_loss: bool = True )
المعاملات
- image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - num_frames (
int، اختياري، القيمة الافتراضية 16) — عدد الإطارات في كل فيديو. - tubelet_size (
int، اختياري، القيمة الافتراضية 2) — عدد الأنابيب. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - qv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والقيم في طبقات الانتباه الذاتي. - use_mean_pooling (
bool, اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب استخدام متوسط الحالة المخفية النهائية بدلاً من استخدام الحالة المخفية النهائية لرمز [CLS]. - decoder_num_attention_heads (
int, اختياري، القيمة الافتراضية 6) — عدد رؤوس الانتباه لكل طبقة انتباه في المُفكِّك. - decoder_hidden_size (
int، اختياري، القيمة الافتراضية 384) — أبعاد المُفكِّك. - decoder_num_hidden_layers (
int، اختياري، القيمة الافتراضية 4) — عدد الطبقات المخفية في المُفكِّك. - decoder_intermediate_size (
int, اختياري، القيمة الافتراضية 1536) — أبعاد طبقة "الوسيطة" (أي طبقة التغذية الأمامية) في المُفكِّك. - norm_pix_loss (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تطبيع بكسلات الباتش المستهدف.
هذه فئة الإعدادات المخزنة لإعدادات نموذج VideoMAEModel. تُستخدم لتوليد نموذج Videomae بناءً على الحُجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ MCG-NJU/videomae-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import VideoMAEConfig, VideoMAEModel

>>> # Initializing a VideoMAE videomae-base style configuration
>>> configuration = VideoMAEConfig()

>>> # Randomly initializing a model from the configuration
>>> model = VideoMAEModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
VideoMAEImageProcessor
فئة transformers.VideoMAEImageProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور VideoMAEImageProcessor.
preprocess
< source >( videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- videos (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — فيديو أو دفعة من الفيديوهات للمعالجة المسبقة. يتوقع فيديو واحدًا (قائمة من الإطارات) أو دفعة من الفيديوهات (قائمة من قوائم الإطارات). يمكن أن يكون كل إطار صورة PIL، أو مصفوفة numpy، أو tensor من torch بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر إطارات بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
VideoMAEImageProcessorPil
فئة transformers.VideoMAEImageProcessorPil
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور VideoMAEImageProcessor.
preprocess
< source >( videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- videos (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — فيديو أو دفعة من الفيديوهات للمعالجة المسبقة. يتوقع فيديو واحدًا (قائمة من الإطارات) أو دفعة من الفيديوهات (قائمة من قوائم الإطارات). يمكن أن يكون كل إطار صورة PIL، أو مصفوفة numpy، أو tensor من torch بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر إطارات بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — الحجم على شكل{"height": int, "width" int}الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّمpad_size، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكونdo_pad=True. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات. - disable_grouping (
bool، kwargs، اختياري) — ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int، kwargs، اختياري) — عدد رموز الصورة التي سيتم استخدامها لكل صورة في المدخلات. تمت إضافته من أجل التوافق مع الإصدارات السابقة، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
VideoMAEVideoProcessor
فئة transformers.VideoMAEVideoProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.VideosKwargs'> )
المعاملات
- do_convert_rgb (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'shortest_edge' -- 224}): يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت قيمة size من نوع int. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None]، kwargs، القيمة الافتراضية2) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا كانت قيمةdo_resizeهيTrue. - do_rescale (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري، القيمة الافتراضية0.00392156862745098) — عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطًا علىTrue. - do_normalize (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري، القيمة الافتراضية[0.5, 0.5, 0.5]) — الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_center_crop (
bool، kwargs، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم قص الصورة من المنتصف. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]، kwargs، القيمة الافتراضية{'height' -- 224, 'width': 224}): حجم الصورة الناتجة بعد تطبيقcenter_crop. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - do_sample_frames (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب أخذ عينات من الإطارات من الفيديو قبل المعالجة، أو معالجة الفيديو بالكامل. - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — بيانات وصفية للفيديو تتضمن معلومات عن المدة الإجمالية، ومعدل الإطارات في الثانية (fps)، والإجمالي عدد الإطارات. ستُستخدم هذه البيانات لعينة الإطارات من الفيديو أو لحساب الطوابع الزمنية. لا تقم بتمرير أي بيانات وصفية إلا إذا كنت تحاول فك ترميز الفيديو يدوياً قبل المعالجة. - fps (
Annotated[int | float | None, None], kwargs) — عدد الإطارات المستهدفة التي يجب أخذها كل ثانية عند تعيينdo_sample_frames=True. - num_frames (
Annotated[int | None, None]، kwargs) — الحد الأقصى لعدد الإطارات التي يجب أخذها عينة عند تعيينdo_sample_frames=True. - return_metadata (
bool، kwargs، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع بيانات وصفية للفيديو أم لا. بيانات الوصفية للفيديو هي كائن يحتوي على معلومات حول مدة الفيديو، ومعدل الإطارات في الثانية (fps)، وخلفية فك الترميز، وما إلى ذلك. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — إذا تم ضبطه، فسيُعاد تينسورات من إطار عمل محدد. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن NumPy.
- **kwargs (VideosKwargs، اختياري) — خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
ينشئ معالج فيديو من نوع VideoMAEVideoProcessor.
preprocess
< source >( videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]]**kwargs: *<class 'transformers.processing_utils.VideosKwargs'> ) → ~image_processing_base.BatchFeature
المعاملات
- videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]) — فيديو يُعالج مسبقاً. يتوقع فيديو واحداً أو دفعة من الفيديوهات بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر فيديوهات بقيم بكسل بين 0 و1، فاضبطdo_rescale=False. - do_convert_rgb (
bool، kwargs، اختياري) — ما إذا كان يجب تحويل الصورة إلى RGB. - do_resize (
bool، kwargs، اختياري) — ما إذا كان يجب تغيير حجم الصورة. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — يصف الأبعاد القصوى للمدخلات إلى النموذج. - default_to_square (
bool، kwargs، اختياري) — ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كانت القيمة عددًا صحيحًا. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — مرشّح إعادة العينة (Resampling filter) المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعدادPILImageResampling. لا يكون له أي تأثير إلا إذا تم تعيينdo_resizeإلىTrue. - do_rescale (
bool، kwargs، اختياري) — ما إذا كان يجب إعادة تحجيم الصورة. - rescale_factor (
float، kwargs، اختياري) — معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كانdo_rescaleمضبوطاً علىTrue. - do_normalize (
bool، kwargs، اختياري) — ما إذا كان سيتم تطبيع الصورة. - image_mean (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - image_std (
Union[float, list[float], tuple[float, ...]]، kwargs، اختياري) — انحراف المعيار للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيينdo_normalizeإلىTrue. - do_center_crop (
bool، kwargs، اختياري) — ما إذا كان يجب قص الصورة من المنتصف. - do_pad (
bool، kwargs، اختياري) — ما إذا كان سيتم توسيط الصورة. يتم التوسيط إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية التوسيط الدقيقة على النموذج. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — حجم الصورة الناتجة بعد تطبيقcenter_crop. - data_format (
Union[str, ~image_utils.ChannelDimension]، kwargs، اختياري) — يُؤمَّن دعمChannelDimension.FIRSTفقط. أُضيف من أجل التوافق مع المعالجات البطيئة. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, اختياري) — تنسيق بُعد القناة للصورة المدخلة. إذا لم يُضبط، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي:"channels_first"أوChannelDimension.FIRST: صورة بتنسيق (num_channels, height, width)."channels_last"أوChannelDimension.LAST: صورة بصيغة (الارتفاع، العرض، عدد القنوات)."none"أوChannelDimension.NONE: صورة بصيغة (الارتفاع، العرض).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم تعيينه، يُستنتج الجهاز من مقاطع الفيديو المدخلة. - do_sample_frames (
bool، kwargs، اختياري) — ما إذا كان يجب أخذ عينات من الإطارات من الفيديو قبل المعالجة، أم معالجة الفيديو بالكامل. - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — بيانات وصفية للفيديو تتضمن معلومات عن المدة الإجمالية، ومعدل الإطارات في الثانية (fps)، والإجمالي عدد الإطارات. ستُستخدم هذه البيانات لعينة الإطارات من الفيديو أو لحساب الطوابع الزمنية. لا تقم بتمرير أي بيانات وصفية إلا إذا كنت تحاول فك ترميز الفيديو يدوياً قبل المعالجة. - fps (
Annotated[int | float | None, None], kwargs) — عدد الإطارات المستهدفة التي يجب أخذها كل ثانية عند تعيينdo_sample_frames=True. - num_frames (
Annotated[int | None, None]، kwargs) — الحد الأقصى لعدد الإطارات التي يجب أخذها عينة عند تعيينdo_sample_frames=True. - return_metadata (
bool، kwargs، اختياري) — ما إذا كان يجب إرجاع بيانات وصفية للفيديو أم لا. بيانات الوصفية للفيديو هي كائن يحتوي على معلومات حول مدة الفيديو، ومعدل الإطارات في الثانية (fps)، وخلفية فك الترميز، وما إلى ذلك. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — تُرجع تينسورات مكدّسة إذا تم ضبطها على'pt'، وإلا تُرجع قائمة من التينسورات.
يعيد
~image_processing_base.BatchFeature
- data (
dict) — قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب call (مثل ‘pixel_values’). - tensor_type (
Union[None, str, TensorType]، اختياري) — يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
VideoMAEModel
فئة transformers.VideoMAEModel
< source >( config: VideoMAEConfig )
المعاملات
- config (VideoMAEConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Videomae الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorbool_masked_pos: typing.Optional[torch.BoolTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام VideoMAEImageProcessor. راجع VideoMAEImageProcessor.call() للتفاصيل (يستخدمprocessor_classVideoMAEImageProcessor لمعالجة الصور). - bool_masked_pos (
torch.BoolTensorof shape(batch_size, sequence_length), اختياري) — المواضع المقنّعة (Boolean masked positions). يحدد البقع (patches) المقنّعة (1) وتلك غير المقنّعة (0). يجب أن يحتوي كل فيديو في الدفعة (batch) على نفس عدد البقع المقنّعة. إذا كانتNone، تُعتبر جميع البقع. طول التسلسل هو(num_frames // tubelet_size) * (image_size // patch_size) ** 2.
يعيد
BaseModelOutput أو tuple(torch.Tensor)
BaseModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (VideoMAEConfig) والمدخلات.
تتجاوز طريقة VideoMAEModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import VideoMAEVideoProcessor, VideoMAEModel
>>> from huggingface_hub import hf_hub_download

>>> # replace this with your own video file
>>> video_path = hf_hub_download(
...     repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )

>>> video_processor = VideoMAEVideoProcessor.from_pretrained("MCG-NJU/videomae-base")
>>> model = VideoMAEModel.from_pretrained("MCG-NJU/videomae-base")

>>> # prepare video for the model
>>> inputs = video_processor(video_path, return_tensors="pt")

>>> # forward pass
>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1568, 768]
VideoMAEForPreTraining
يتضمن VideoMAEForPreTraining مُفكّكًا (decoder) في الأعلى للتدريب المسبق غير المُراقَب ذاتيًا.
فئة transformers.VideoMAEForPreTraining
< source >( config: VideoMAEConfig )
المعاملات
- config (VideoMAEConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج VideoMAE من نوع transformer مع decoder في الأعلى للتدريب المسبق غير المُشرط.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorbool_masked_pos: BoolTensor**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → VideoMAEForPreTrainingOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام VideoMAEImageProcessor. راجع VideoMAEImageProcessor.call() للتفاصيل (يستخدمprocessor_classVideoMAEImageProcessor لمعالجة الصور). - bool_masked_pos (
torch.BoolTensorمن الشكل(batch_size, sequence_length)) — المواضع المقنّعة (Boolean masked positions). تُظهر البقع (patches) المقنّعة (1) وتلك غير المقنّعة (0). يجب أن يحتوي كل فيديو في الدفعة (batch) على نفس عدد البقع المقنّعة. طول التسلسل هو(num_frames // tubelet_size) * (image_size // patch_size) ** 2.
يعيد
VideoMAEForPreTrainingOutput أو tuple(torch.Tensor)
VideoMAEForPreTrainingOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (VideoMAEConfig) والمدخلات.
تتجاوز طريقة VideoMAEForPreTraining الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)) — خسارة إعادة بناء البكسلات.logits (
torch.Tensorمن الشكل(batch_size, patch_size ** 2 * num_channels)) — قيم logits لإعادة بناء البكسلات.hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, VideoMAEForPreTraining
>>> import numpy as np
>>> import torch

>>> num_frames = 16
>>> video = list(np.random.randint(0, 256, (num_frames, 3, 224, 224)))

>>> image_processor = AutoImageProcessor.from_pretrained("MCG-NJU/videomae-base")
>>> model = VideoMAEForPreTraining.from_pretrained("MCG-NJU/videomae-base")

>>> pixel_values = image_processor(video, return_tensors="pt").pixel_values

>>> num_patches_per_frame = (model.config.image_size // model.config.patch_size) ** 2
>>> seq_length = (num_frames // model.config.tubelet_size) * num_patches_per_frame
>>> bool_masked_pos = torch.randint(0, 2, (1, seq_length)).bool()

>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss = outputs.loss
VideoMAEForVideoClassification
فئة transformers.VideoMAEForVideoClassification
< source >( config: VideoMAEConfig )
المعاملات
- config (VideoMAEConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج VideoMAE مُحوِّل (Transformer) مع رأس تصنيف فيديو في الأعلى (طبقة خطية فوق الحالات المخفية المُجمَّعة بمتوسط جميع الرموز) على سبيل المثال لـ ImageNet.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ImageClassifierOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام VideoMAEImageProcessor. راجع VideoMAEImageProcessor.call() للتفاصيل (يستخدمprocessor_classVideoMAEImageProcessor لمعالجة الصور). - labels (
torch.LongTensorof shape(batch_size,), اختياري) — التسميات لحساب خسارة تصنيف الصور/الانحدار. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
يعيد
ImageClassifierOutput أو tuple(torch.Tensor)
ImageClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
حسب الإعداد (VideoMAEConfig) والمدخلات.
تتجاوز طريقة VideoMAEForVideoClassification الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل مرحلة) من الشكل(batch_size, sequence_length, hidden_size). حالات مخفية (تُسمى أيضًا خرائط الميزات) للنموذج عند إخراج كل مرحلة.attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> import torch
>>> from transformers import VideoMAEVideoProcessor, VideoMAEForVideoClassification
>>> from huggingface_hub import hf_hub_download

>>> # replace this with your own video file
>>> video_path = hf_hub_download(
...     repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )

>>> video_processor = VideoMAEVideoProcessor.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics")
>>> model = VideoMAEForVideoClassification.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics")

>>> inputs = video_processor(video_path, return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
...     logits = outputs.logits

>>> # model predicts one of the 400 Kinetics-400 classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
eating spaghetti