
Transformers documentation
ViTMAE
نُشر هذا النموذج في أوراق HF في 11-11-2021، وأُضيف إلى مكتبة Hugging Face Transformers في 18-01-2022.


ViTMAE
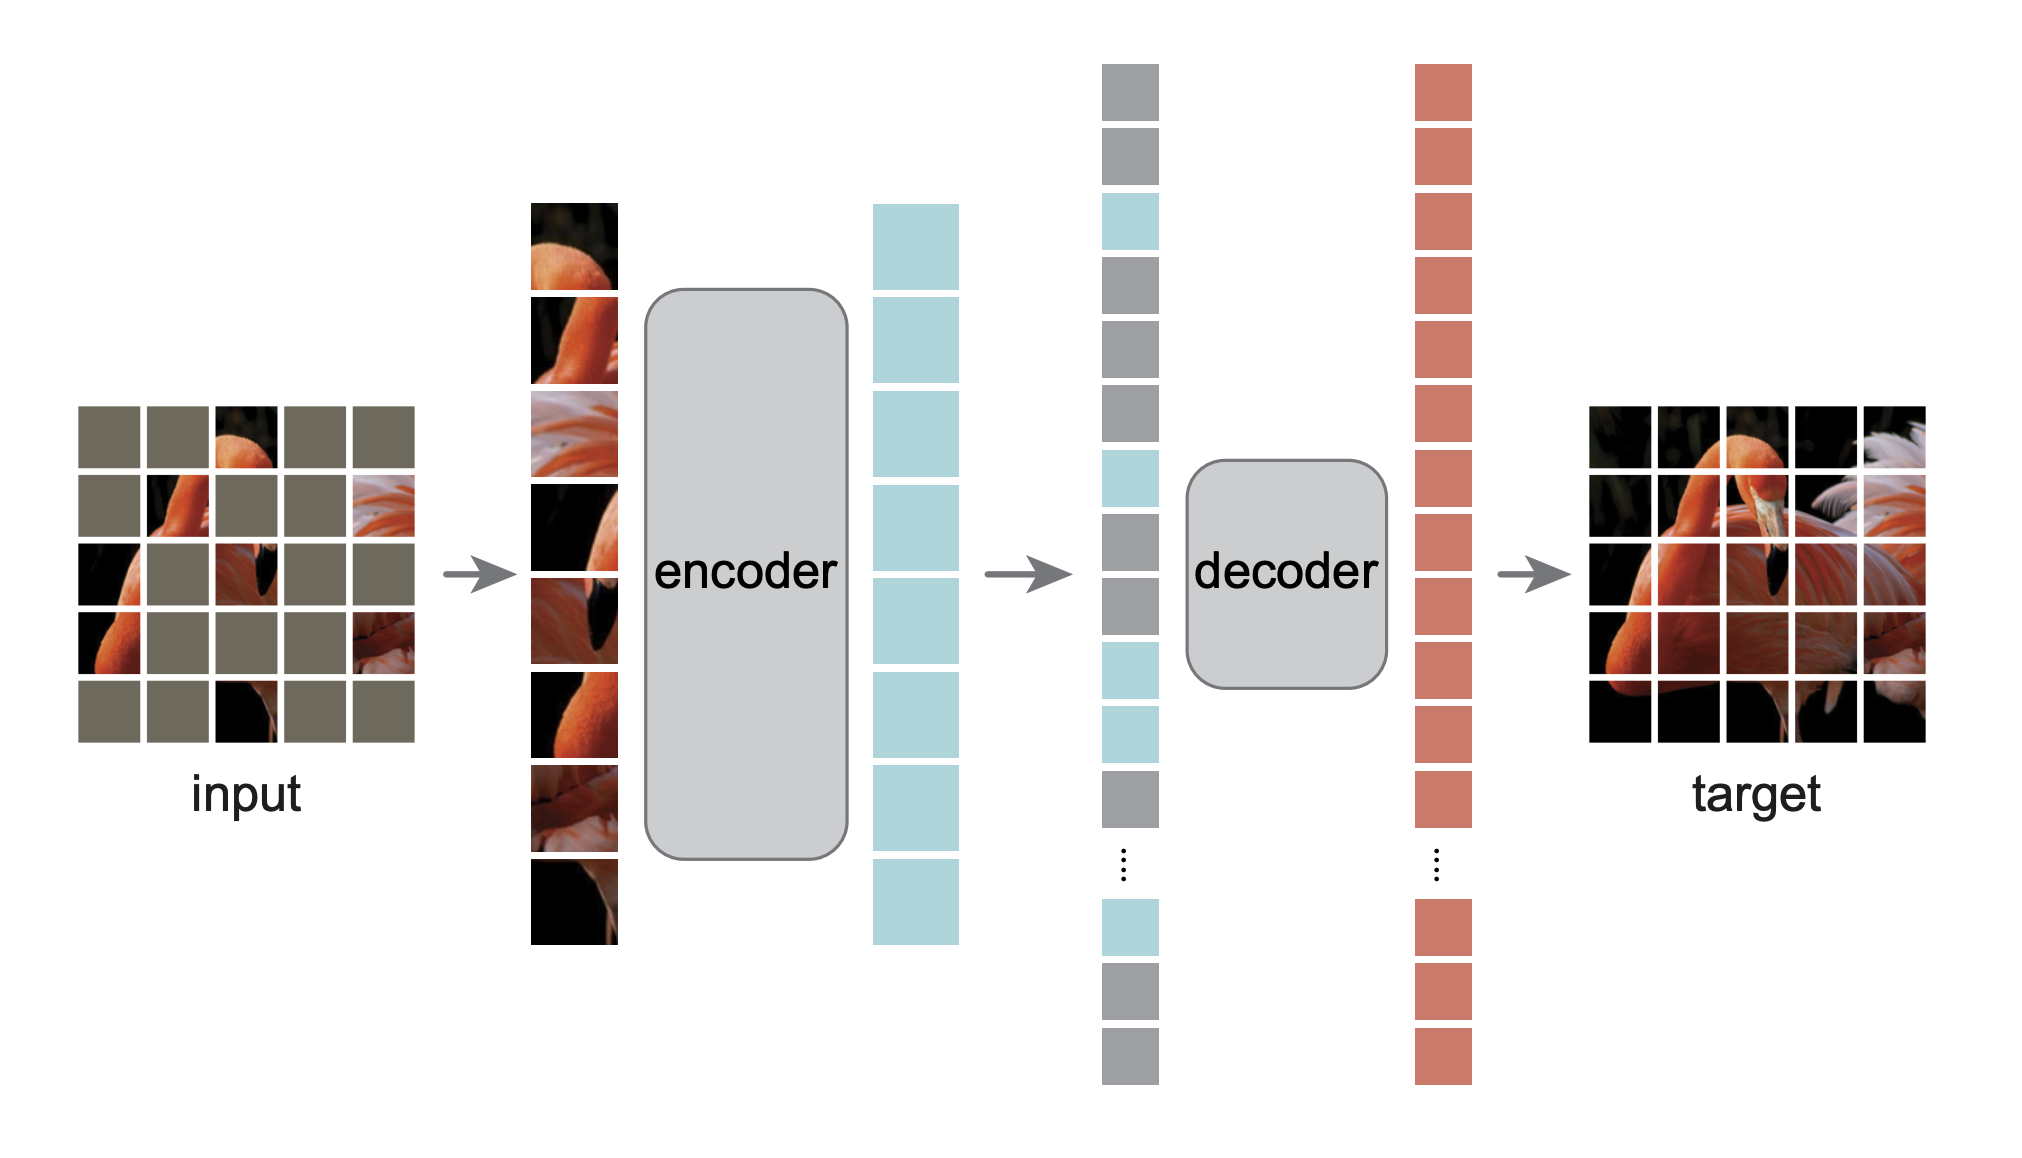
ViTMAE هو نموذج رؤية ذاتي الإشراف يتم تدريبه مسبقًا عن طريق إخفاء أجزاء كبيرة من الصورة (حوالي 75%). يعالج المُشفِّر (encoder) قطع الصورة المرئية، بينما يعيد المُفكِّك (decoder) بناء البكسلات المفقودة من القطع المُشفَّرة ورموز الإخفاء (mask tokens). بعد التدريب المسبق، يمكن إعادة استخدام المُشفِّر لمهام لاحقة مثل تصنيف الصور أو كشف الأشياء — وغالبًا ما يتفوق على النماذج المدربة بالتعلم المُشرَف.
يمكنك العثور على جميع نقاط التفتيش الأصلية لـ ViTMAE تحت منظمة AI at Meta.
انقر على نماذج ViTMAE في الشريط الجانبي الأيمن لمزيد من الأمثلة حول كيفية تطبيق ViTMAE على مهام الرؤية.
يُظهر المثال أدناه كيفية إعادة بناء البكسلات المفقودة باستخدام فئة ViTMAEForPreTraining.
import requests
import torch
from PIL import Image

from transformers import ViTImageProcessor, ViTMAEForPreTraining


url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)

processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}

model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
    outputs = model(**inputs)

reconstruction = outputs.logits
ملاحظات
- يُستخدم ViTMAE عادةً في مرحلتين: التدريب المسبق ذاتي الإشراف باستخدام ViTMAEForPreTraining، ثم التخلّي عن المُفكّك (decoder) وضبط المُشفِّر (encoder) بدقة. وبعد ضبط الدقة، يمكن إدخال الأوزان في نموذج مثل ViTForImageClassification.
- استخدم ViTImageProcessor لتحضير المدخلات.
الموارد
- راجع هذا دفتر الملاحظات لمعرفة كيفية تصور البكسلات المُعاد بناؤها من ViTMAEForPreTraining.
ViTMAEConfig
فئة transformers.ViTMAEConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_probs_dropout_prob: float | int = 0.0initializer_range: float = 0.02layer_norm_eps: float = 1e-12image_size: int | list[int] | tuple[int, int] = 224patch_size: int | list[int] | tuple[int, int] = 16num_channels: int = 3qkv_bias: bool = Truedecoder_num_attention_heads: int = 16decoder_hidden_size: int = 512decoder_num_hidden_layers: int = 8decoder_intermediate_size: int = 2048mask_ratio: float = 0.75norm_pix_loss: bool = False )
المعاملات
- hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمالية الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - image_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية224) — الحجم (الدقة) لكل صورة. - patch_size (
Union[int, list[int], tuple[int, int]]، اختياري، القيمة الافتراضية16) — حجم (دقة) كل رقعة. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - qkv_bias (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم. - decoder_num_attention_heads (
int, اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - decoder_hidden_size (
int، اختياري، القيمة الافتراضية512) — أبعاد التمثيلات المخفية. - decoder_num_hidden_layers (
int، اختياري، القيمة الافتراضية 8) — عدد الطبقات المخفية في المُفكِّك. - decoder_intermediate_size (
int، اختياري، القيمة الافتراضية2048) — أبعاد تمثيلات MLP. - mask_ratio (
float، اختياري، القيمة الافتراضية 0.75) — نسبة عدد الرموز المقنّعة في تسلسل الإدخال. - norm_pix_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم التدريب مع استخدام بكسلات مُعايرة (انظر الجدول 3 في الورقة). لقد حسّن استخدام البكسلات المُعايرة جودة التمثيل في تجارب المؤلفين.
هذه فئة الإعدادات المخزنة لإعدادات نموذج VitMAEModel. تُستخدم لاستحداث نموذج Vit Mae وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/vit-mae-base
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import ViTMAEConfig, ViTMAEModel

>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()

>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ViTMAEModel
فئة transformers.ViTMAEModel
< source >( config: ViTMAEConfig )
المعاملات
- config (ViTMAEConfig) — إعدادات النموذج.
نموذج Vit Mae الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonenoise: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool | None = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ViTMAEModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ViTImageProcessor. راجع ViTImageProcessor.call() للتفاصيل (يستخدمprocessor_classViTImageProcessor لمعالجة الصور). - noise (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — يُستخدم بشكل رئيسي لأغراض الاختبار للتحكم في العشوائية والحفاظ على قابلية إعادة الإنتاج - interpolate_pos_encoding (
bool، اختياري، الافتراضيFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. يُستخدم هذا بشكل رئيسي لتطبيق النموذج على صور ذات دقة أعلى. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
ViTMAEModelOutput أو tuple(torch.Tensor)
ViTMAEModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعدادات (ViTMAEConfig) والمدخلات.
تتجاوز طريقة ViTMAEModel الأمامية الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرجات الطبقة الأخيرة من النموذج.قناع (
torch.Tensorمن الشكل(batch_size, sequence_length)) — متجه يشير إلى البقع المقنّعة (1) والتي ليست كذلك (0).ids_restore (
torch.LongTensorمن الشكل(batch_size, sequence_length)) — متجه يحتوي على الفهرس الأصلي للرقع المقنّعة (المُبعثرة).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
ViTMAEForPreTraining
فئة transformers.ViTMAEForPreTraining
< source >( config: ViTMAEConfig )
المعاملات
- config (ViTMAEConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج ViTMAE وهو محوّل (Transformer) مزوّد بفكّ تشفير (decoder) في الأعلى للتدريب المسبق غير المُشرط (self-supervised).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonenoise: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool | None = Noneattention_mask: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ViTMAEForPreTrainingOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام ViTImageProcessor. راجع ViTImageProcessor.call() للتفاصيل (يستخدمprocessor_classViTImageProcessor لمعالجة الصور). - noise (
torch.Tensorمن الشكل(batch_size, sequence_length)، اختياري) — يُستخدم بشكل رئيسي لأغراض الاختبار للتحكم في العشوائية والحفاظ على قابلية إعادة الإنتاج - interpolate_pos_encoding (
bool، اختياري، الافتراضيFalse) — ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا. يُستخدم هذا بشكل رئيسي لاستخدام النموذج على صور ذات دقة أعلى. - attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
يعيد
ViTMAEForPreTrainingOutput أو tuple(torch.Tensor)
أُكْجَة ViTMAEForPreTrainingOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (ViTMAEConfig) والمدخلات.
تتجاوز طريقة ViTMAEForPreTraining الخاصة بالتقديم الأمامي الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)) — خسارة إعادة بناء البكسلات.logits (
torch.Tensorمن الشكل(batch_size, sequence_length, patch_size ** 2 * num_channels)) — قيم logits لإعادة بناء البكسلات.قناع (
torch.Tensorمن الشكل(batch_size, sequence_length)) — متجه يشير إلى البقع المقنّعة (1) والتي ليست كذلك (0).ids_restore (
torch.LongTensorمن الشكل(batch_size, sequence_length)) — متجه يحتوي على الفهرس الأصلي للرقع المقنّعة (المُبعثرة).hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore