
Transformers documentation
AWQ
AWQ
يحافظ تكميم الأوزان الواعي بالتفعيل (AWQ) على نسبة صغيرة من الأوزان التي تُعدّ مهمة لأداء نماذج اللغة الكبيرة، وذلك لضغط النموذج إلى 4 بتات مع الحد الأدنى من تدهور الأداء.
تتوفر عدة مكتبات لتكميم النماذج باستخدام خوارزمية AWQ، مثل llm-awq وautoawq أو optimum-intel. يدعم Transformers تحميل النماذج المكمّمة باستخدام مكتبتَي llm-awq وautoawq. سيوضح لك هذا الدليل كيفية تحميل النماذج المكمّمة باستخدام autoawq، لكن العملية مشابهة للنماذج المكمّمة باستخدام llm-awq.
قم بتشغيل الأمر أدناه لتثبيت autoawq
pip install autoawq
يُعيد AutoAWQ تثبيت Transformers إلى الإصدار 4.47.1. إذا كنت ترغب في تنفيذ الاستدلال باستخدام AutoAWQ، فقد تحتاج إلى إعادة تثبيت إصدار Transformers الخاص بك بعد تثبيت AutoAWQ.
حدد نموذجًا مُكمَّمًا بطريقة AWQ عن طريق فحص المفتاح quant_method في ملف config.json الخاص بالنموذج.
{
  "_name_or_path": "/workspace/process/huggingfaceh4_zephyr-7b-alpha/source",
  "architectures": [
    "MistralForCausalLM"
  ],
  ...
  ...
  ...
  "quantization_config": {
    "quant_method": "awq",
    "zero_point": true,
    "group_size": 128,
    "bits": 4,
    "version": "gemm"
  }
}
حمّل النموذج المُكمَّم بـ AWQ باستخدام from_pretrained(). يقوم هذا تلقائيًا بإعداد الأوزان الأخرى إلى fp16 افتراضيًا لأسباب تتعلق بالأداء. استخدم معامل dtype لتحميل هذه الأوزان الأخرى بتنسيق مختلف.
إذا تم تحميل النموذج على وحدة المعالجة المركزية (CPU)، فاستخدم معامل device_map لنقله إلى مُسرِّع.
from transformers import AutoModelForCausalLM, AutoTokenizer
from accelerate import Accelerator
import torch

device = Accelerator().device

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/zephyr-7B-alpha-AWQ",
  dtype=torch.float32,
  device_map=device
)
استخدم attn_implementation لتفعيل FlashAttention2 من أجل تسريع الاستدلال بشكل أكبر.
from transformers import AutoModelForCausalLM, AutoTokenizer
from accelerate import Accelerator

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/zephyr-7B-alpha-AWQ",
  attn_implementation="flash_attention_2",
  device_map=Accelerator().device
)
وحدات مدمجة
توفر الوحدات المدمجة دقةً وأداءً محسَّنين. وهي مدعومة بشكل افتراضي للوحدات AWQ الخاصة ببنية Llama وبنية Mistral، لكن يمكنك أيضًا دمج وحدات AWQ للبنى غير المدعومة.
لا يمكن دمج الوحدات المدمجة مع تقنيات التحسين الأخرى مثل FlashAttention2.
أنشئ AwqConfig و اضبط المعاملين fuse_max_seq_len و do_fuse=True لتفعيل الوحدات المدمجة. يمثل معامل fuse_max_seq_len طول التسلسل الكلي، وينبغي أن يتضمن طول السياق وطول التوليد المتوقع. اضبطه على قيمة أكبر لضمان الأمان.
يُدمج المثال أدناه وحدات AWQ الخاصة بنموذج TheBloke/Mistral-7B-OpenOrca-AWQ.
import torch
from transformers import AwqConfig, AutoModelForCausalLM

quantization_config = AwqConfig(
    bits=4,
    fuse_max_seq_len=512,
    do_fuse=True,
)
model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/Mistral-7B-OpenOrca-AWQ",
  quantization_config=quantization_config
).to(0)
تم إجراء اختبار أداء لنموذج TheBloke/Mistral-7B-OpenOrca-AWQ باستخدام batch_size=1 مع الوحدات المدمجة وبدونها.
| حجم الدفعة | طول التعبئة المسبقة | طول فك الترميز | رموز التعبئة المسبقة/ث | فكّ رموز الرموز/ثانية | الذاكرة (ذاكرة الفيديو) |
|---|---|---|---|---|---|
| 1 | 32 | 32 | 60.0984 | 38.4537 | 4.50 غيغابايت (5.68%) |
| 1 | 64 | 64 | 1333.67 | 31.6604 | 4.50 غيغابايت (5.68%) |
| 1 | 128 | 128 | 2434.06 | 31.6272 | 4.50 غيغابايت (5.68%) |
| 1 | 256 | 256 | 3072.26 | 38.1731 | 4.50 غيغابايت (5.68%) |
| 1 | 512 | 512 | 3184.74 | 31.6819 | 4.59 غيغابايت (5.80%) |
| 1 | 1024 | 1024 | 3148.18 | 36.8031 | 4.81 غيغابايت (6.07%) |
| 1 | 2048 | 2048 | 2927.33 | 35.2676 | 5.73 غيغابايت (7.23%) |
| حجم الدفعة | طول التعبئة المسبقة | طول فك الترميز | رموز التمهيد/ث | فكّ رموز الرموز/ثانية | الذاكرة (ذاكرة الفيديو) |
|---|---|---|---|---|---|
| 1 | 32 | 32 | 81.4899 | 80.2569 | 4.00 غيغابايت (5.05%) |
| 1 | 64 | 64 | 1756.1 | 106.26 | 4.00 غيغابايت (5.05%) |
| 1 | 128 | 128 | 2479.32 | 105.631 | 4.00 غيغابايت (5.06%) |
| 1 | 256 | 256 | 1813.6 | 85.7485 | 4.01 غيغابايت (5.06%) |
| 1 | 512 | 512 | 2848.9 | 97.701 | 4.11 غيغابايت (5.19%) |
| 1 | 1024 | 1024 | 3044.35 | 87.7323 | 4.41 غيغابايت (5.57%) |
| 1 | 2048 | 2048 | 2715.11 | 89.4709 | 5.57 غيغابايت (7.04%) |
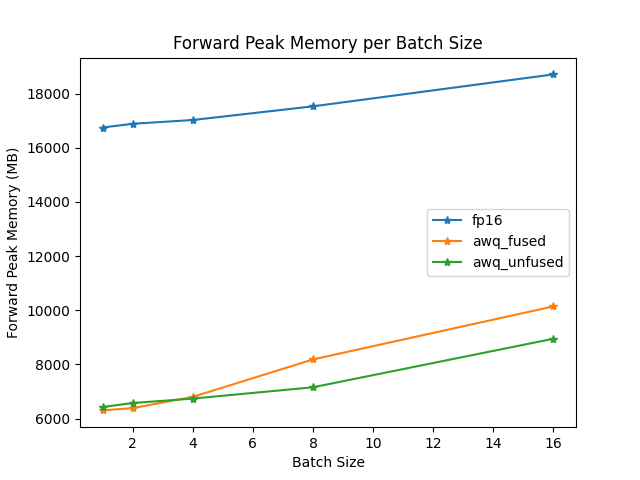
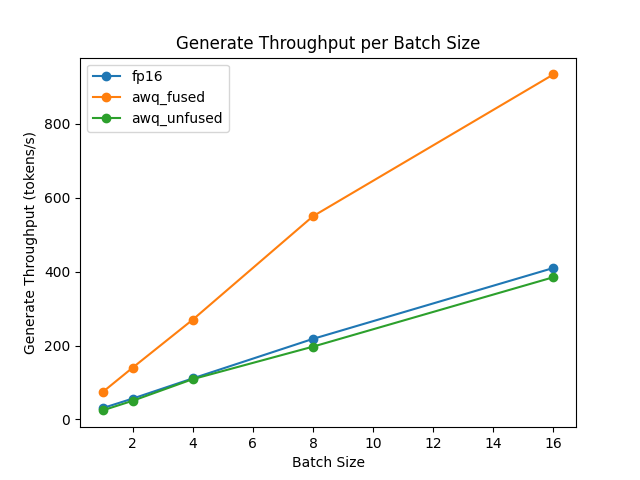
تم اختبار السرعة ومعدل الإنتاجية للوحدات المدمجة وغير المدمجة أيضاً باستخدام مكتبة optimum-benchmark.
بالنسبة للبنى المعمارية التي لا تدعم الوحدات المدمجة، أنشئ AwqConfig وحدد خرائط دمج مخصصة في modules_to_fuse لتحديد الوحدات التي يجب دمجها.
يُدمج المثال أدناه وحدات AWQ الخاصة بنموذج TheBloke/Yi-34B-AWQ.
import torch
from transformers import AwqConfig, AutoModelForCausalLM

quantization_config = AwqConfig(
    bits=4,
    fuse_max_seq_len=512,
    modules_to_fuse={
        "attention": ["q_proj", "k_proj", "v_proj", "o_proj"],
        "layernorm": ["ln1", "ln2", "norm"],
        "mlp": ["gate_proj", "up_proj", "down_proj"],
        "use_alibi": False,
        "num_attention_heads": 56,
        "num_key_value_heads": 8,
        "hidden_size": 7168
    }
)

model = AutoModelForCausalLM.from_pretrained(
  "TheBloke/Yi-34B-AWQ",
  quantization_config=quantization_config
).to(0)
يجب أن يتضمن المعامل modules_to_fuse المفاتيح التالية.
"attention": أسماء طبقات الانتباه التي سيتم دمجها بالترتيب التالي: طبقة الإسقاط للاستعلام، وطبقة الإسقاط للمفتاح، وطبقة الإسقاط للقيمة، وطبقة الإسقاط للإخراج. إذا كنت لا تريد دمج هذه الطبقات، فمرر قائمة فارغة."layernorm": أسماء جميع طبقات LayerNorm التي تريد استبدالها بطبقة LayerNorm مدمجة مخصصة. إذا كنت لا تريد دمج هذه الطبقات، فمرر قائمة فارغة."mlp": أسماء طبقات MLP التي تريد دمجها في طبقة MLP واحدة، بالترتيب: (طبقات gate (dense, layer, post-attention) / طبقات up / طبقات down)."use_alibi": إذا كان نموذجك يستخدم تضمين الموضع ALiBi."num_attention_heads": عدد رؤوس الانتباه."num_key_value_heads": عدد رؤوس المفاتيح والقيم التي يجب استخدامها لتنفيذ الانتباه الاستعلامي المجمّع (GQA).قيمة المعامل انتباه num_key_value_heads=num_attention_headsالانتباه متعدد الرؤوس num_key_value_heads=1انتباه الاستعلام المتعدد num_key_value_heads=...انتباه الاستعلامات المجمّعة "hidden_size": بُعد التمثيلات المخفية.
ExLlamaV2
تدعم نوى ExLlamaV2 عمليات التعبئة المسبقة والتفكيك بشكل أسرع. نفّذ الأمر أدناه لتثبيت أحدث إصدار من autoawq مع دعم ExLlamaV2.
pip install git+https://github.com/casper-hansen/AutoAWQ.git
اضبط version="exllama" في AwqConfig لتفعيل نواة ExLlamaV2.
يُؤمَّن دعم ExLlamaV2 على وحدات معالجة الرسوميات من AMD.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, AwqConfig

quantization_config = AwqConfig(version="exllama")

model = AutoModelForCausalLM.from_pretrained(
    "TheBloke/Mistral-7B-Instruct-v0.1-AWQ",
    quantization_config=quantization_config,
    device_map="auto",
)
الموارد
شغّل دفتر ملاحظات عرض AWQ لمزيد من الأمثلة حول كيفية تكميم نموذج، ودفع نموذج مُكمَّم إلى Hub، والمزيد.
Update on GitHub