
Transformers documentation
GGUF
GGUF
GGUF هو تنسيق ملف واحد يُستخدم لتخزين النماذج للاستدلال باستخدام GGML، ويتضمن بيانات النموذج الوصفية والمتجهات. وهو يدعم العديد من أنواع البيانات المُكمّاة (راجع جدول أنواع الكمّ)، مما يوفر كمية كبيرة من الذاكرة.
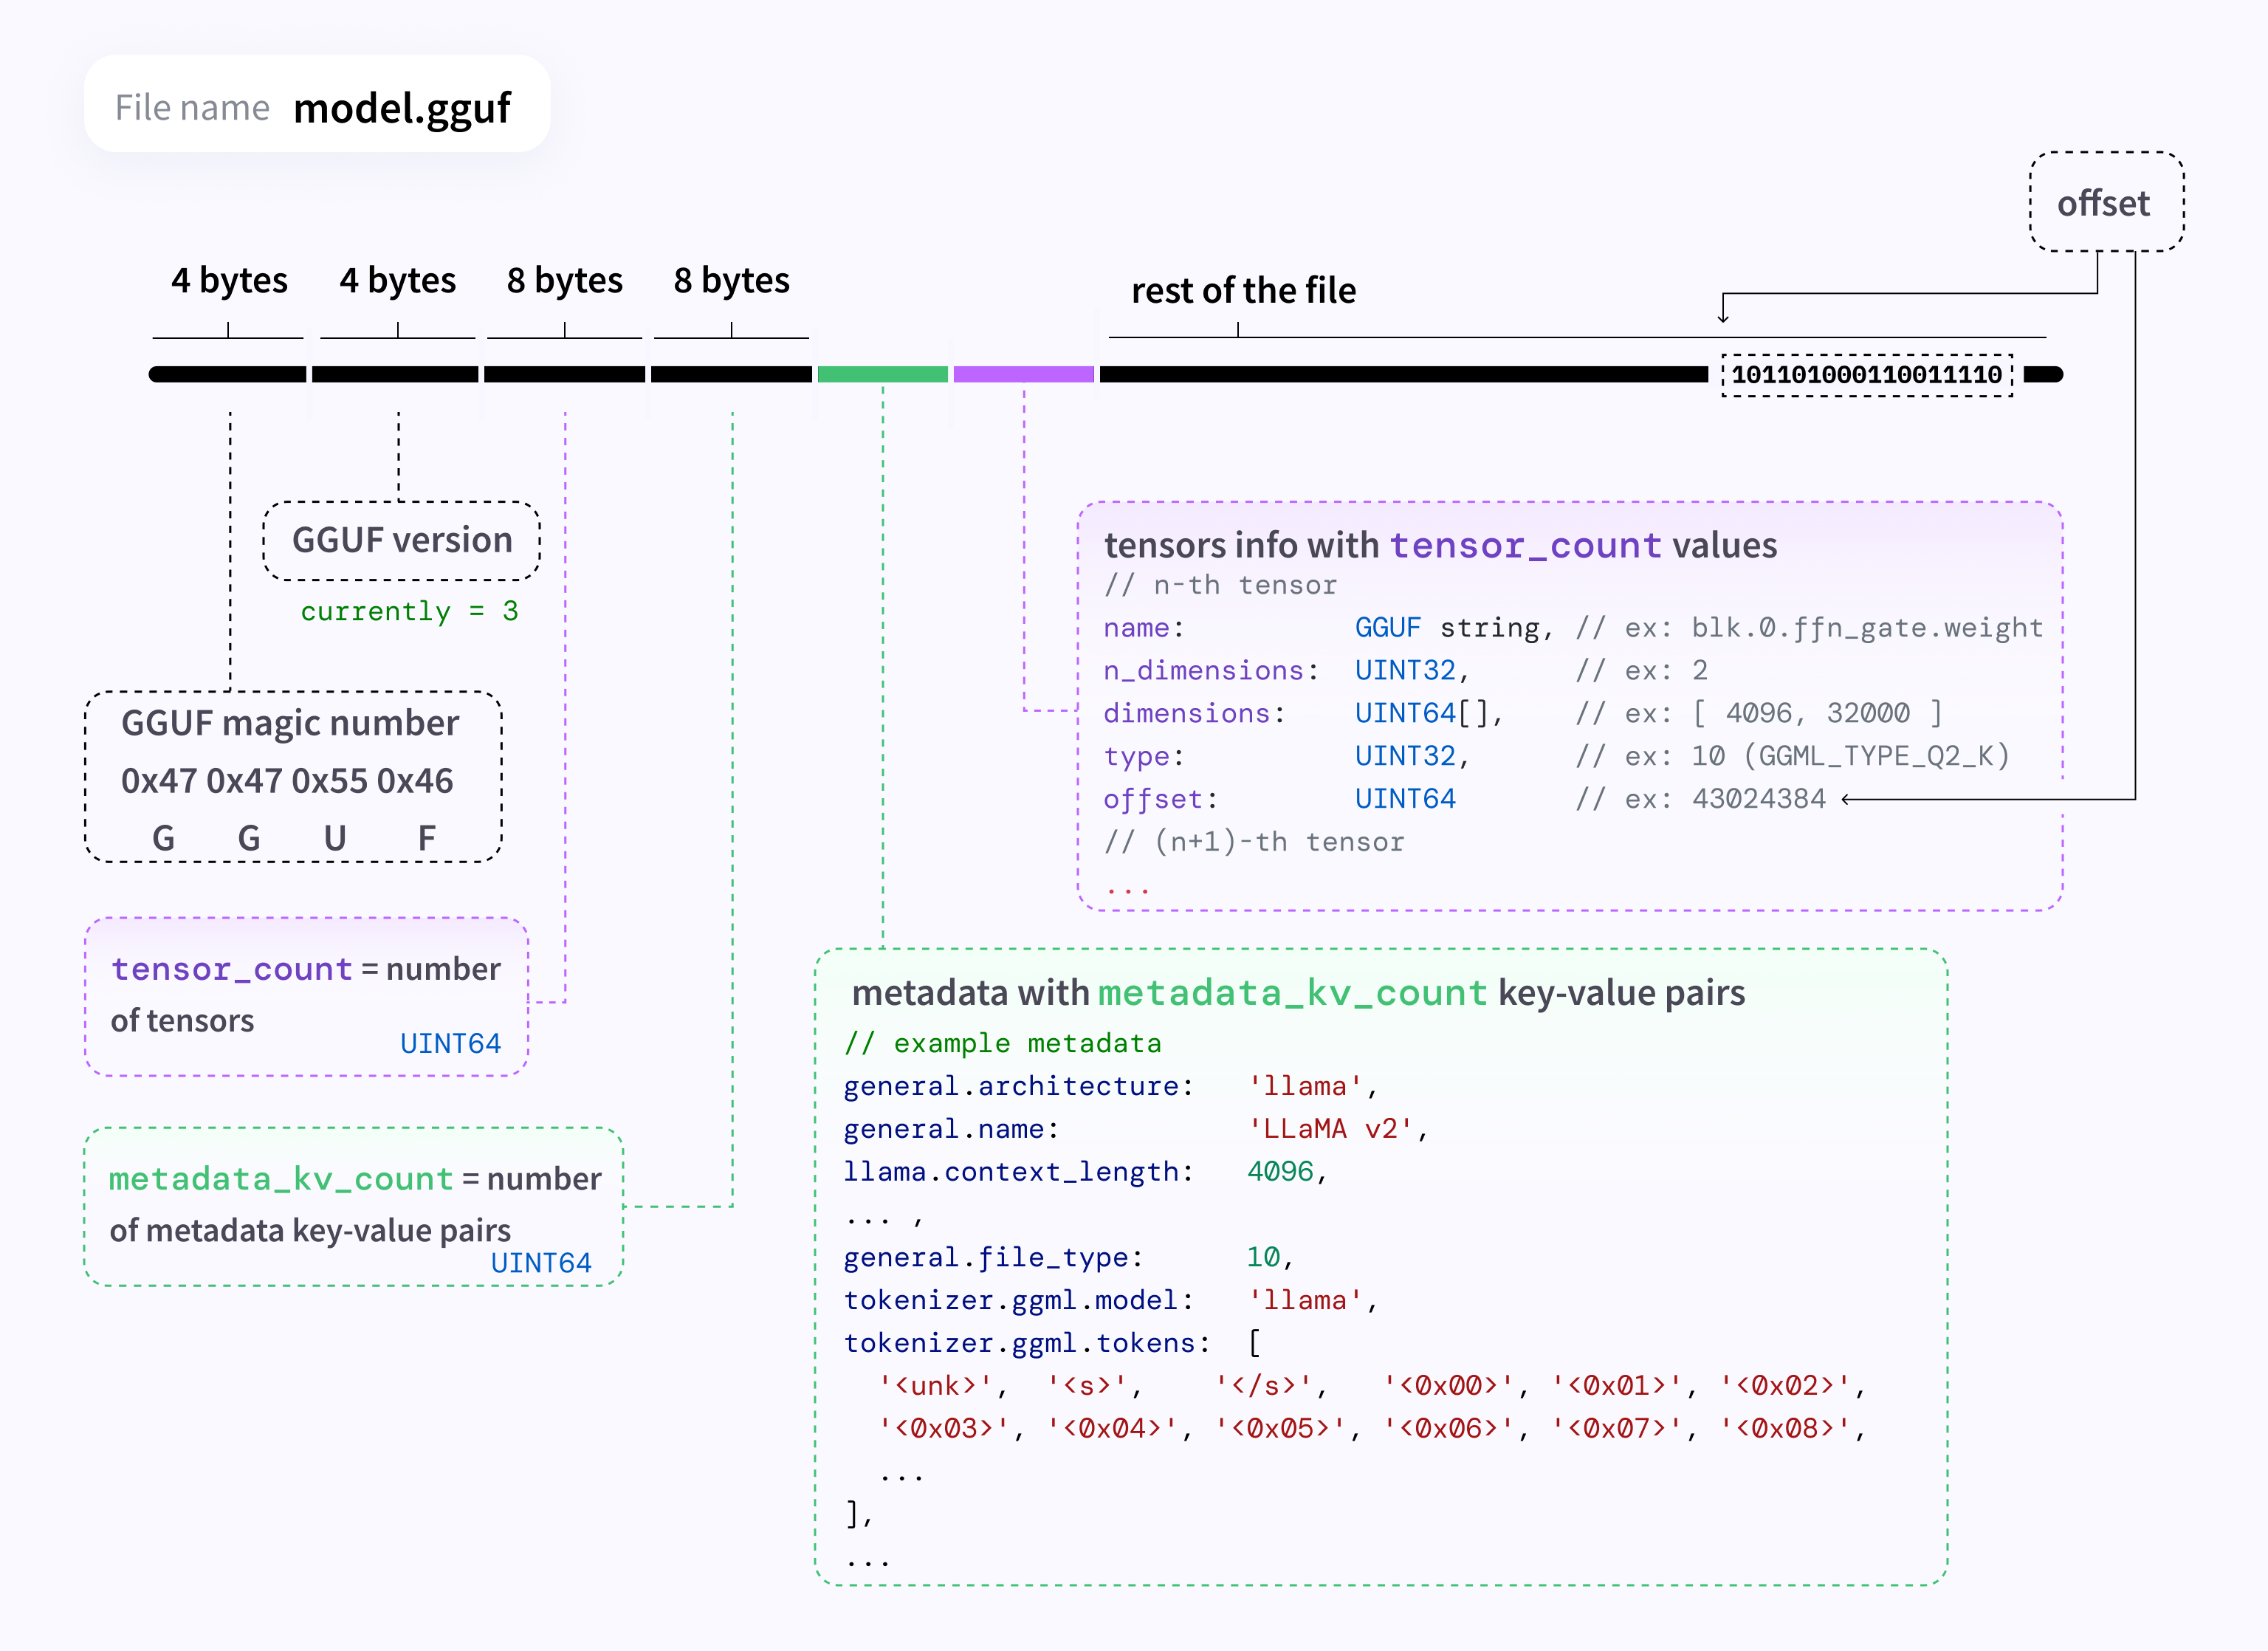
تحميل نماذج GGUF
قم بتثبيت kernels، وإلا فإن المسار المعبأ سيعود إلى إلغاء التكميم الكامل عند التحميل.
pip install kernels
تبقى الأوزان مضغوطة عندما يكون نواة Hub ggml-org/ggml-quantization متاحة. يعتمد المُحمِّل افتراضياً على MPS عند وجود تلك النواة، وينفّذ عمليات ضرب المصفوفات مباشرةً على الكتل المضغوطة. أما إذا لم تكن النواة متاحة، فيتم فك ضغط النموذج عند التحميل.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=filename)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
يعمل نفس التحميل مع Qwen3.5 MoE.
moe_model_id = "unsloth/Qwen3.5-35B-A3B-GGUF"
moe_filename = "Qwen3.5-35B-A3B-Q4_K_M.gguf"

moe_model = AutoModelForCausalLM.from_pretrained(moe_model_id, gguf_file=moe_filename)
moe_tokenizer = AutoTokenizer.from_pretrained(moe_model_id, gguf_file=moe_filename)
يدعم المسار المُجمَّع حاليًا Qwen3.5 و Qwen3.5 MoE. تستخدم عمليات التحميل المُجمَّعة float32 تلقائيًا لأنها أسرع على MPS. إذا قمت بتعيين dtype آخر، سيعيد المُحمِّل تحذيرًا. تمرّ المعماريات الأخرى عبر المُحمِّل التقليدي.
الانتباه
على MPS، عند تثبيت النوى، يكون ggml-attn هو الانتباه الافتراضي عند تحميل ملف GGUF: وهو نواة flash-attention نفسها التي يستخدمها llama.cpp للترميز المسبق والتفكيك. إذا تعذّر جلب النواة، يحتفظ النموذج بتنفيذ الانتباه الخاص به. كما أن تمرير attn_implementation (مثل "sdpa") له الأولوية دائمًا.
يمكنك أيضًا تمريره بشكل صريح:
model = AutoModelForCausalLM.from_pretrained(
    model_id, gguf_file=filename, attn_implementation="ggml-org/ggml-attn"
)
إلغاء التكميم
يقوم فك التكميم بفك ضغط كل وزن عند وقت التحميل وإرجاع نموذج كثيف عادي. وهو الخيار الاحتياطي في كل مرة لا ينطبق فيها المسار المضغوط السريع. يمكنك أيضاً طلبه صراحةً باستخدام GgufConfig.
import torch

from transformers import AutoModelForCausalLM, GgufConfig

quantization_config = GgufConfig(dequantize=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id, gguf_file=filename, quantization_config=quantization_config, dtype=torch.bfloat16
)
تحصل على نموذج كثيف عادي في dtype الذي مررته.
تمرّ المعماريات الأخرى غير Qwen3.5 وQwen3.5 MoE عبر مُحمِّل الإصدار القديم، الذي يقوم دائمًا بإلغاء التكميم.
يدعم المُحمِّل القديم نماذج Llama وMistral وQwen2 وQwen2Moe وPhi3 وBloom وFalcon وStableLM وGPT2 وStarcoder2 وغيرها.
استضافة
يقوم transformers serve بعرض كل ملف .gguf في المستودع كنموذج مستقل. يُسمّى نموذج GGUF باسم <repo>:<file>.gguf، لأن المستودع يحتوي على عدة كمّات، ويجب أن يوضّح المعرّف أيّ منها يجب تحميله. تُسمّى الطلبات بنفس الطريقة.
transformers serve unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf