
Transformers documentation
Bark
Este modelo foi contribuído para o Hugging Face Transformers em 17/07/2023.
Bark

Visão geral
Bark é um modelo de texto para fala baseado em transformers proposto pela Suno AI em suno-ai/bark.
Bark é composto por 4 modelos principais:
- BarkSemanticModel (também chamado de modelo de “texto”): um modelo transformer causal auto-regressivo que recebe como entrada texto tokenizado e prevê tokens semânticos de texto que capturam o significado do texto.
- BarkCoarseModel (também referido como o modelo de “acústica grosseira”): um transformer autoregressivo causal que recebe como entrada os resultados do modelo BarkSemanticModel. Ele visa prever os dois primeiros codebooks de áudio necessários para o EnCodec.
- BarkFineModel (o modelo de “acústica fina”), desta vez um transformer autoencoder não causal, que prevê iterativamente os últimos codebooks com base na soma dos embeddings dos codebooks anteriores.
- Depois de prever todos os canais do codebook a partir do EncodecModel, o Bark o utiliza para decodificar o array de áudio de saída.
Deve-se observar que cada um dos três primeiros módulos pode suportar incorporações condicionais de falante para condicionar o som de saída de acordo com uma voz específica predefinida.
Este modelo foi contribuído por Yoach Lacombe (ylacombe) e Sanchit Gandhi (sanchit-gandhi). O código original pode ser encontrado aqui.
Otimizando o Bark
O Bark pode ser otimizado com apenas algumas linhas extras de código, o que reduz significativamente sua pegada de memória e acelera a inferência.
Usando meia precisão
Você pode acelerar a inferência e reduzir a pegada de memória em 50% simplesmente carregando o modelo em meia precisão.
from transformers import BarkModel


model = BarkModel.from_pretrained("suno/bark-small", device_map="auto")
Usando offload de CPU
Conforme mencionado acima, o Bark é composto por 4 submodelos, que são chamados sequencialmente durante a geração de áudio. Em outras palavras, enquanto um submodelo está em uso, os outros submodelos ficam ociosos.
Se você estiver usando uma GPU CUDA ou uma XPU da Intel, uma solução simples para aproveitar uma redução de 80% no uso de memória é descarregar os submodelos do dispositivo para a CPU quando eles estiverem ociosos. Essa operação é chamada de descarregamento para a CPU. Você pode usá-la com uma única linha de código, conforme mostrado a seguir:
model.enable_cpu_offload()
Observe que o 🤗 Accelerate deve ser instalado antes de usar esse recurso. Veja como instalá-lo.
Usando Flash Attention 2
Flash Attention 2 é uma versão ainda mais rápida e otimizada da otimização anterior.
Instalação
Primeiro, verifique se o seu hardware é compatível com Flash Attention 2. A lista mais recente de hardware compatível pode ser encontrada na documentação oficial. Em seguida, instale a versão mais recente do Flash Attention 2:
pip install -U flash-attn --no-build-isolation
Uso
Para carregar um modelo usando Flash Attention 2, podemos passar a flag attn_implementation="flash_attention_2" para from_pretrained(). Também carregaremos o modelo em meia precisão (por exemplo, torch.float16), pois isso resulta em quase nenhuma degradação na qualidade do áudio, mas com uso de memória significativamente menor e inferência mais rápida:
model = BarkModel.from_pretrained("suno/bark-small", attn_implementation="flash_attention_2", device_map="auto")Comparação de desempenho
O diagrama a seguir mostra a latência da implementação nativa de atenção (sem otimização) em comparação com o Flash Attention 2. Em todos os casos, geramos 400 tokens semânticos em uma GPU A100 de 40GB com PyTorch 2.1:
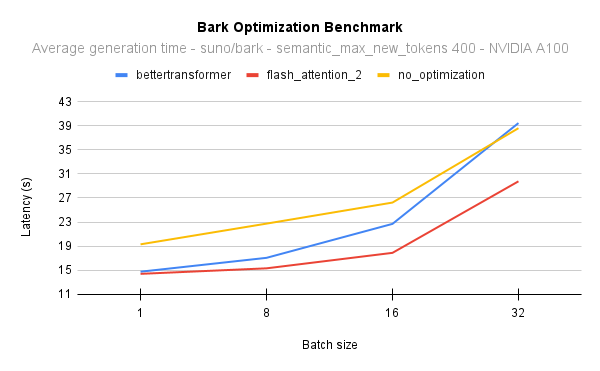
Para contextualizar, em uma NVIDIA A100 e ao gerar 400 tokens semânticos com um batch size de 16, é possível obter 17 vezes o throughput e ainda ser 2 segundos mais rápido do que gerar frases uma a uma com a implementação nativa do modelo. Em outras palavras, todas as amostras serão geradas 17 vezes mais rápido.
Combinando técnicas de otimização
Você pode combinar técnicas de otimização e usar offload de CPU, meia precisão e Flash Attention 2 todos ao mesmo tempo.
from transformers import BarkModel


# load in fp16 and use Flash Attention 2
model = BarkModel.from_pretrained("suno/bark-small", attn_implementation="flash_attention_2", device_map="auto")

# enable CPU offload
model.enable_cpu_offload()
Saiba mais sobre técnicas de otimização de inferência aqui.
Dicas de uso
A Suno oferece uma biblioteca de presets de voz em diversos idiomas aqui. Esses presets também estão disponíveis no hub aqui ou aqui.
from transformers import AutoProcessor, BarkModel


processor = AutoProcessor.from_pretrained("suno/bark")
model = BarkModel.from_pretrained("suno/bark", device_map="auto")

voice_preset = "v2/en_speaker_6"

inputs = processor("Hello, my dog is cute", voice_preset=voice_preset)

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
O Bark pode gerar fala multilíngue altamente realista, bem como outros tipos de áudio, incluindo música, ruído de fundo e efeitos sonoros simples.
# Multilingual speech - simplified Chinese
inputs = processor("惊人的!我会说中文")

# Multilingual speech - French - let's use a voice_preset as well
inputs = processor("Incroyable! Je peux générer du son.", voice_preset="fr_speaker_5")

# Bark can also generate music. You can help it out by adding music notes around your lyrics.
inputs = processor("♪ Hello, my dog is cute ♪")

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
O modelo também pode produzir comunicações não verbais, como risos, suspiros e choro.
# Adding non-speech cues to the input text
inputs = processor("Hello uh [clears throat], my dog is cute [laughter]")

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
Para salvar o áudio, basta obter a taxa de amostragem da configuração do modelo e usar uma utilidade do scipy:
from scipy.io.wavfile import write as write_wav


# save audio to disk, but first take the sample rate from the model config
sample_rate = model.generation_config.sample_rate
write_wav("bark_generation.wav", sample_rate, audio_array)
BarkConfig
classe transformers.BarkConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonesemantic_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonecoarse_acoustics_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonefine_acoustics_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonecodec_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02 )
Parâmetros
- semantic_config (BarkSemanticConfig, opcional) — Configuração do submodelo semântico subjacente.
- coarse_acoustics_config (BarkCoarseConfig, opcional) — Configuração do submodelo de acústica grossa subjacente.
- fine_acoustics_config (BarkFineConfig, opcional) — Configuração do submodelo de acústica fina subjacente.
- codec_config (AutoConfig, opcional) — Configuração do submodelo de codec subjacente.
- initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
Esta é a classe de configuração para armazenar a configuração de um BarkModel. Ela é usada para instanciar um modelo Bark de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do suno/bark
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import (
...     BarkSemanticConfig,
...     BarkCoarseConfig,
...     BarkFineConfig,
...     BarkModel,
...     BarkConfig,
...     AutoConfig,
... )

>>> # Initializing Bark sub-modules configurations.
>>> semantic_config = BarkSemanticConfig()
>>> coarse_acoustics_config = BarkCoarseConfig()
>>> fine_acoustics_config = BarkFineConfig()
>>> codec_config = AutoConfig.from_pretrained("facebook/encodec_24khz")


>>> # Initializing a Bark module style configuration
>>> configuration = BarkConfig(
...     semantic_config, coarse_acoustics_config, fine_acoustics_config, codec_config
... )

>>> # Initializing a model (with random weights)
>>> model = BarkModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BarkProcessor
classe transformers.BarkProcessor
< source >( tokenizerspeaker_embeddings = None )
Parâmetros
- tokenizer (
BertTokenizer) — O tokenizer é uma entrada obrigatória. - speaker_embeddings (
dict[dict[str]], opcional) — Dicionário aninhado opcional de embeddings de falante. O primeiro nível contém os nomes dos presets de voz (por exemplo,"en_speaker_4"). O segundo nível contém os embeddings de"semantic_prompt","coarse_prompt"e"fine_prompt". Os valores correspondem ao caminho donp.ndarraycorrespondente. Veja aqui uma lista devoice_preset_names.
Constrói um BarkProcessor que encapsula um tokenizer em um único processor.
BarkProcessor oferece todas as funcionalidades de BertTokenizer. Consulte o ~BertTokenizer para mais informações.
__call__
< source >( text = Nonevoice_preset = Nonereturn_tensors = 'pt'max_length = 256add_special_tokens = Falsereturn_attention_mask = Truereturn_token_type_ids = False**kwargs ) → BatchEncoding
Parâmetros
- text (`
) -- The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, setis_split_into_words=True` to avoid ambiguity with batched inputs. - voice_preset (
str,dict[np.ndarray]) — O preset de voz, ou seja, os embeddings do falante. Pode ser um nome de voice_preset válido, por exemplo"en_speaker_1", ou diretamente um dicionário de embeddingsnp.ndarraypara cada submodelo doBark. Ou pode ser um nome de arquivo válido de um preset de voz local único em.npzcontendo as chaves"semantic_prompt","coarse_prompt"e"fine_prompt". - return_tensors (`
, defaults topt`) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
- max_length (
int, padrão é256) — Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/padronização.Se não for definido ou for definido como
None, isso usará o comprimento máximo predefinido do modelo, caso um dos parâmetros de truncamento/preenchimento exija um comprimento máximo. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/preenchimento para um comprimento máximo será desativado. - add_special_tokens (
bool, padrãoFalse) — Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacentePretrainedTokenizerBase.build_inputs_with_special_tokens, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar tokensbosoueosautomaticamente. - return_attention_mask (
bool, padrão éTrue) — Se deve retornar a attention mask. Se mantido o padrão, retornará a attention mask de acordo com o padrão do tokenizer específico, definido pelo atributoreturn_outputs. - return_token_type_ids (
bool, padrão éFalse) — Se deve retornar os IDs de tipo de token. Se mantido no padrão, retornará os IDs de tipo de token de acordo com o padrão do tokenizer específico, definido peloreturn_outputsatributo.
Retorna
Um objeto BatchEncoding contendo a saída do tokenizer.
Se um preset de voz for fornecido, o objeto retornado incluirá uma chave "history_prompt"
contendo um BatchFeature, ou seja, o preset de voz com o tipo de tensor adequado.
from_pretrained
< source >( pretrained_processor_name_or_pathspeaker_embeddings_dict_path = 'speaker_embeddings_path.json'**kwargs )
Parâmetros
- pretrained_model_name_or_path (
strouos.PathLike) — Pode ser:- uma string, o model id de um BarkProcessor pré-treinado hospedado em um repositório de modelos no huggingface.co.
- um caminho para um diretório contendo um processador salvo usando o método save_pretrained(), por exemplo,
./my_model_directory/.
- speaker_embeddings_dict_path (
str, opcional, padrão"speaker_embeddings_path.json") — O nome do arquivo.jsonque contém o dicionário speaker_embeddings, localizado empretrained_model_name_or_path. SeNone, nenhum speaker_embeddings é carregado. - **kwargs —
Argumentos de palavra-chave adicionais passados para
~tokenization_utils_base.PreTrainedTokenizer.from_pretrained.
Instancie um processador Bark associado a um modelo pré-treinado.
save_pretrained
< source >( save_directoryspeaker_embeddings_dict_path = 'speaker_embeddings_path.json'speaker_embeddings_directory = 'speaker_embeddings'push_to_hub: bool = False**kwargs )
Parâmetros
- save_directory (
strouos.PathLike) — Diretório onde os arquivos do tokenizer e os embeddings de falante serão salvos (o diretório será criado se não existir). - speaker_embeddings_dict_path (
str, opcional, padrão"speaker_embeddings_path.json") — O nome do arquivo.jsonque conterá o dicionário de caminhos aninhados de speaker_embeddings, caso exista, e que ficará localizado empretrained_model_name_or_path/speaker_embeddings_directory. - speaker_embeddings_directory (
str, opcional, padrão"speaker_embeddings/") — O nome da pasta em que os arrays de speaker_embeddings serão salvos. - push_to_hub (
bool, opcional, padrãoFalse) — Indica se o modelo deve ser enviado para o Hugging Face model hub após ser salvo. Você pode especificar o repositório de destino comrepo_id(por padrão, será usado o nome desave_directoryno seu namespace). - kwargs — Argumentos de palavra-chave adicionais passados ao método push_to_hub().
Salva os atributos deste processador (tokenizer…) no diretório especificado para que ele possa ser recarregado usando o método from_pretrained().
BarkModel
classe transformers.BarkModel
< source >( config: BarkConfig )
Parâmetros
- config (BarkConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Bark completo, um modelo de texto para fala composto por 4 submodelos:
- BarkSemanticModel (também chamado de modelo de “texto”): um modelo transformer auto-regressivo causal que recebe como entrada texto tokenizado e prevê tokens semânticos de texto que capturam o significado do texto.
- BarkCoarseModel (também chamado de modelo de “acústica grosseira”), também um transformer autoregressivo causal,
que recebe como entrada os resultados do modelo anterior. Ele visa regressar os dois primeiros codebooks de áudio necessários
para o
encodec. - BarkFineModel (o modelo de “acústica fina”), desta vez um transformer autoencoder não causal, que prevê iterativamente os últimos codebooks com base na soma dos embeddings dos codebooks anteriores.
- após prever todos os canais do codebook a partir do EncodecModel, o Bark o utiliza para decodificar o array de áudio de saída.
Deve-se observar que cada um dos três primeiros módulos pode suportar incorporações condicionais de falante para condicionar o som de saída de acordo com uma voz específica predefinida.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
generate
< source >( input_ids: typing.Optional[torch.Tensor] = Nonehistory_prompt: dict[str, torch.Tensor] | None = Nonereturn_output_lengths: bool | None = None**kwargs ) → By default
Parâmetros
- input_ids (
Optional[torch.Tensor]de forma (batch_size, seq_len), opcional) — Ids de entrada. Serão truncados até 256 tokens. Observe que os áudios de saída terão a mesma duração da geração mais longa do lote. - history_prompt (
Optional[dict[str,torch.Tensor]], opcional) — Prompt de locutorBarkopcional. Observe que, por enquanto, este modelo aceita apenas um prompt de locutor por lote. - kwargs (opcional) — Dicionário restante de argumentos por palavra-chave. Os argumentos por palavra-chave são de dois tipos:
- Sem um prefixo, eles serão inseridos como
**kwargspara o métodogeneratede cada submodelo. - Com os prefixos semantic_, coarse_ e fine_, eles serão usados como entrada para o método
generatedo semantic, coarse e fine, respectivamente. Têm prioridade sobre as palavras-chave sem prefixo.
Isso significa que você pode, por exemplo, especificar uma estratégia de geração para todos os submodelos, exceto um.
- Sem um prefixo, eles serão inseridos como
- return_output_lengths (
bool, opcional) — Indica se as comprimentos das formas de onda devem ser retornados. Útil ao processar em lotes.
Retorna
Por padrão
- audio_waveform (
torch.Tensorde forma (batch_size, seq_len)): Forma de onda de áudio gerada. Quandoreturn_output_lengths=True: Retorna uma tupla composta por: - audio_waveform (
torch.Tensorde forma (batch_size, seq_len)): Forma de onda de áudio gerada. - output_lengths (
torch.Tensorde forma (batch_size)): O comprimento de cada forma de onda no lote
Gera áudio a partir de um prompt de entrada e um prompt de falante Bark adicional opcional.
Exemplo:
>>> from transformers import AutoProcessor, BarkModel

>>> processor = AutoProcessor.from_pretrained("suno/bark-small")
>>> model = BarkModel.from_pretrained("suno/bark-small")

>>> # To add a voice preset, you can pass `voice_preset` to `BarkProcessor.__call__(...)`
>>> voice_preset = "v2/en_speaker_6"

>>> inputs = processor("Hello, my dog is cute, I need him in my life", voice_preset=voice_preset)

>>> audio_array = model.generate(**inputs, semantic_max_new_tokens=100)
>>> audio_array = audio_array.cpu().numpy().squeeze()
enable_cpu_offload
< source >( accelerator_id: int | None = 0**kwargs )
Desloca todos os submodelos para a CPU usando o accelerate, reduzindo o uso de memória com baixo impacto no desempenho. Este método move um submodelo inteiro por vez para o acelerador quando ele é utilizado, e o submodelo permanece no acelerador até que o próximo submodelo seja executado.
BarkSemanticModel
classe transformers.BarkSemanticModel
< source >( config: BarkSubModelConfig )
Parâmetros
- config (
BarkSubModelConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo semântico (ou de texto) do Bark. Ele compartilha a mesma arquitetura que o modelo de baixa resolução. É um modelo autoregressivo semelhante ao GPT-2, com uma cabeça de modelagem de linguagem no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → CausalLMOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[0, ..., config.vocab_size]ou ser -100 (veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size]. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
CausalLMOutputWithPast ou tuple(torch.Tensor)
Um CausalLMOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BarkConfig) e das entradas.
O método forward do BarkCausalModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
BarkCoarseModel
classe transformers.BarkCoarseModel
< source >( config: BarkSubModelConfig )
Parâmetros
- config (
BarkSubModelConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo de acústica bruta do Bark. Ele compartilha a mesma arquitetura do modelo semântico (ou de texto). Trata-se de um modelo autoregressivo semelhante ao GPT-2, com uma cabeça de modelagem de linguagem no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → CausalLMOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[0, ..., config.vocab_size]ou ser -100 (veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size]. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
CausalLMOutputWithPast ou tuple(torch.Tensor)
Um CausalLMOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BarkConfig) e das entradas.
O método forward do BarkCausalModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
BarkFineModel
classe transformers.BarkFineModel
< source >( config: BarkFineConfig )
Parâmetros
- config (BarkFineConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo de acústica fina do Bark. Trata-se de um modelo não causal semelhante a um GPT, com config.n_codes_total camadas de incorporação e cabeças de modelagem de linguagem, uma para cada codebook.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( codebook_idx: intinput_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskedLMOutput or tuple(torch.Tensor)
Parâmetros
- codebook_idx (
int) — Índice do codebook que será previsto. - input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — AINDA NÃO IMPLEMENTADO. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
MaskedLMOutput ou tuple(torch.Tensor)
Um MaskedLMOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BarkConfig) e das entradas.
O método forward do BarkFineModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem mascarada (MLM).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
BarkCausalModel
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → CausalLMOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[0, ..., config.vocab_size]ou ser -100 (veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size]. - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
CausalLMOutputWithPast ou tuple(torch.Tensor)
Um CausalLMOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (BarkConfig) e das entradas.
O método forward do BarkCausalModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
BarkCoarseConfig
classe transformers.BarkCoarseConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneblock_size: int = 1024input_vocab_size: int = 10048output_vocab_size: int = 10048num_layers: int = 12num_heads: int = 12hidden_size: int = 768dropout: float | int = 0.0bias: bool = Trueinitializer_range: float = 0.02use_cache: bool = True )
Parâmetros
- block_size (
int, opcional, padrão 1024) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. Normalmente, defina este valor para algo grande, apenas por precaução (por exemplo, 512, 1024 ou 2048). - input_vocab_size (
int, opcional, padrão 10_048) — Tamanho do vocabulário de um submodelo do Bark. Define o número de tokens diferentes que podem ser representados pelosinputs_idspassados ao chamar{model}. O padrão é 10_048, mas deve ser definido com cuidado em relação ao submodelo escolhido. - output_vocab_size (
int, opcional, padrão 10_048) — Tamanho do vocabulário de saída de um submodelo do Bark. Define o número de tokens diferentes que podem ser representados por:output_idsao passar um{model}para frente. O padrão é 10_048, mas deve ser pensado com cuidado em relação ao submodelo escolhido. - num_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - dropout (
Union[float, int], opcional, padrão0.0) — A proporção para todas as camadas de dropout. - bias (
bool, opcional, padrãoTrue) — Indica se deve ou não usar viés nas camadas lineares e nas camadas de normalização de camada - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador.
Esta é a classe de configuração para armazenar a configuração de um BarkModel. Ela é usada para instanciar um modelo Bark de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do suno/bark
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import BarkCoarseConfig, BarkCoarseModel

>>> # Initializing a Bark sub-module style configuration
>>> configuration = BarkCoarseConfig()

>>> # Initializing a model (with random weights) from the suno/bark style configuration
>>> model = BarkCoarseModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BarkFineConfig
classe transformers.BarkFineConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneblock_size: int = 1024input_vocab_size: int = 10048output_vocab_size: int = 10048num_layers: int = 12num_heads: int = 12hidden_size: int = 768dropout: float | int = 0.0bias: bool = Trueinitializer_range: float = 0.02use_cache: bool = Truetie_word_embeddings: bool = Truen_codes_total: int = 8n_codes_given: int = 1 )
Parâmetros
- block_size (
int, opcional, padrão 1024) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. Normalmente, defina este valor para algo grande, apenas por precaução (por exemplo, 512, 1024 ou 2048). - input_vocab_size (
int, opcional, padrão 10_048) — Tamanho do vocabulário de um submodelo do Bark. Define o número de tokens diferentes que podem ser representados pelosinputs_idspassados ao chamar{model}. O padrão é 10_048, mas deve ser definido com cuidado em relação ao submodelo escolhido. - output_vocab_size (
int, opcional, padrão 10_048) — Tamanho do vocabulário de saída de um submodelo do Bark. Define o número de tokens diferentes que podem ser representados por:output_idsao passar um{model}para frente. O padrão é 10_048, mas deve ser pensado com cuidado em relação ao submodelo escolhido. - num_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - dropout (
Union[float, int], opcional, padrão0.0) — A proporção para todas as camadas de dropout. - bias (
bool, opcional, padrãoTrue) — Indica se deve ou não usar viés nas camadas lineares e nas camadas de normalização de camada - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo. - n_codes_total (
int, opcional, padrão 8) — O número total de codebooks de áudio previstos. Usado no submodelo de acústica fina. - n_codes_given (
int, opcional, padrão 1) — O número de codebooks de áudio previstos no submodelo de acústica grossa. Usado nos submodelos de acústica.
Esta é a classe de configuração para armazenar a configuração de um BarkModel. Ela é usada para instanciar um modelo Bark de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do suno/bark
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import BarkFineConfig, BarkFineModel

>>> # Initializing a Bark sub-module style configuration
>>> configuration = BarkFineConfig()

>>> # Initializing a model (with random weights) from the suno/bark style configuration
>>> model = BarkFineModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
BarkSemanticConfig
classe transformers.BarkSemanticConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneblock_size: int = 1024input_vocab_size: int = 10048output_vocab_size: int = 10048num_layers: int = 12num_heads: int = 12hidden_size: int = 768dropout: float | int = 0.0bias: bool = Trueinitializer_range: float = 0.02use_cache: bool = True )
Parâmetros
- block_size (
int, opcional, padrão 1024) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. Normalmente, defina este valor para algo grande, apenas por precaução (por exemplo, 512, 1024 ou 2048). - input_vocab_size (
int, opcional, padrão 10_048) — Tamanho do vocabulário de um submodelo do Bark. Define o número de tokens diferentes que podem ser representados pelosinputs_idspassados ao chamar{model}. O padrão é 10_048, mas deve ser definido com cuidado em relação ao submodelo escolhido. - output_vocab_size (
int, opcional, padrão 10_048) — Tamanho do vocabulário de saída de um submodelo do Bark. Define o número de tokens diferentes que podem ser representados por:output_idsao passar um{model}para frente. O padrão é 10_048, mas deve ser pensado com cuidado em relação ao submodelo escolhido. - num_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - dropout (
Union[float, int], opcional, padrão0.0) — A proporção para todas as camadas de dropout. - bias (
bool, opcional, padrãoTrue) — Indica se deve ou não usar viés nas camadas lineares e nas camadas de normalização de camada - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador.
Esta é a classe de configuração para armazenar a configuração de um BarkModel. Ela é usada para instanciar um modelo Bark de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do suno/bark
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import BarkSemanticConfig, BarkSemanticModel

>>> # Initializing a Bark sub-module style configuration
>>> configuration = BarkSemanticConfig()

>>> # Initializing a model (with random weights) from the suno/bark style configuration
>>> model = BarkSemanticModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config