
Transformers documentation
Wav2Vec2
Este modelo foi publicado no HF papers em 2020-06-20 e contribuído para o Hugging Face Transformers em 2021-02-02.
Wav2Vec2


Visão geral
O modelo Wav2Vec2 foi proposto em wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations por Alexei Baevski, Henry Zhou, Abdelrahman Mohamed, Michael Auli.
O resumo do artigo é o seguinte:
Demonstramos pela primeira vez que aprender representações poderosas a partir apenas de áudio de fala, seguido de ajuste fino em fala transcrita, pode superar os melhores métodos semi-supervisionados, sendo ao mesmo tempo conceitualmente mais simples. O wav2vec 2.0 mascara a entrada de fala no espaço latente e resolve uma tarefa contrastiva definida sobre uma quantização das representações latentes, que são aprendidas conjuntamente. Experimentos utilizando todos os dados rotulados do Librispeech alcançam 1,8/3,3 WER nos conjuntos de teste limpo/outros. Ao reduzir a quantidade de dados rotulados para uma hora, o wav2vec 2.0 supera o estado da arte anterior no subconjunto de 100 horas, utilizando 100 vezes menos dados rotulados. Utilizando apenas dez minutos de dados rotulados e pré-treinamento em 53 mil horas de dados não rotulados, ainda se alcança 4,8/8,2 WER. Isso demonstra a viabilidade do reconhecimento de fala com quantidades limitadas de dados rotulados.
Este modelo foi contribuído por patrickvonplaten.
Nota: a Meta (FAIR) lançou uma nova versão do Wav2Vec2-BERT 2.0 - ela foi pré-treinada em 4,5 milhões de horas de áudio. Recomendamos especialmente o seu uso em tarefas de fine-tuning, por exemplo, conforme este guia.
Defina
use_kernels=Trueem from_pretrained() para substituir camadas compatíveis por kernels otimizados do Hub. Consulte Carregando kernels para saber mais.
Dicas de uso
- Wav2Vec2 é um modelo de fala que aceita um array de float correspondente à forma de onda bruta do sinal de fala.
- O modelo Wav2Vec2 foi treinado usando classificação temporal conexionista (CTC), portanto a saída do modelo precisa ser decodificada usando Wav2Vec2CTCTokenizer.
Usando Flash Attention 2
Flash Attention 2 é uma versão mais rápida e otimizada do modelo.
Instalação
Primeiro, verifique se o seu hardware é compatível com Flash Attention 2. A lista mais recente de hardware compatível pode ser encontrada na documentação oficial.
Em seguida, instale a versão mais recente do Flash Attention 2:
pip install -U flash-attn --no-build-isolation
Uso
Para carregar um modelo usando Flash Attention 2, podemos passar o argumento attn_implementation="flash_attention_2" para from_pretrained(). Também carregaremos o modelo em meia precisão (por exemplo, torch.float16), pois isso resulta em quase nenhuma degradação na qualidade do áudio, mas com uso de memória significativamente menor e inferência mais rápida:
from transformers import Wav2Vec2Model


model = Wav2Vec2Model.from_pretrained("facebook/wav2vec2-large-960h-lv60-self", attn_implementation="flash_attention_2", device_map="auto")
...
Acelerações esperadas
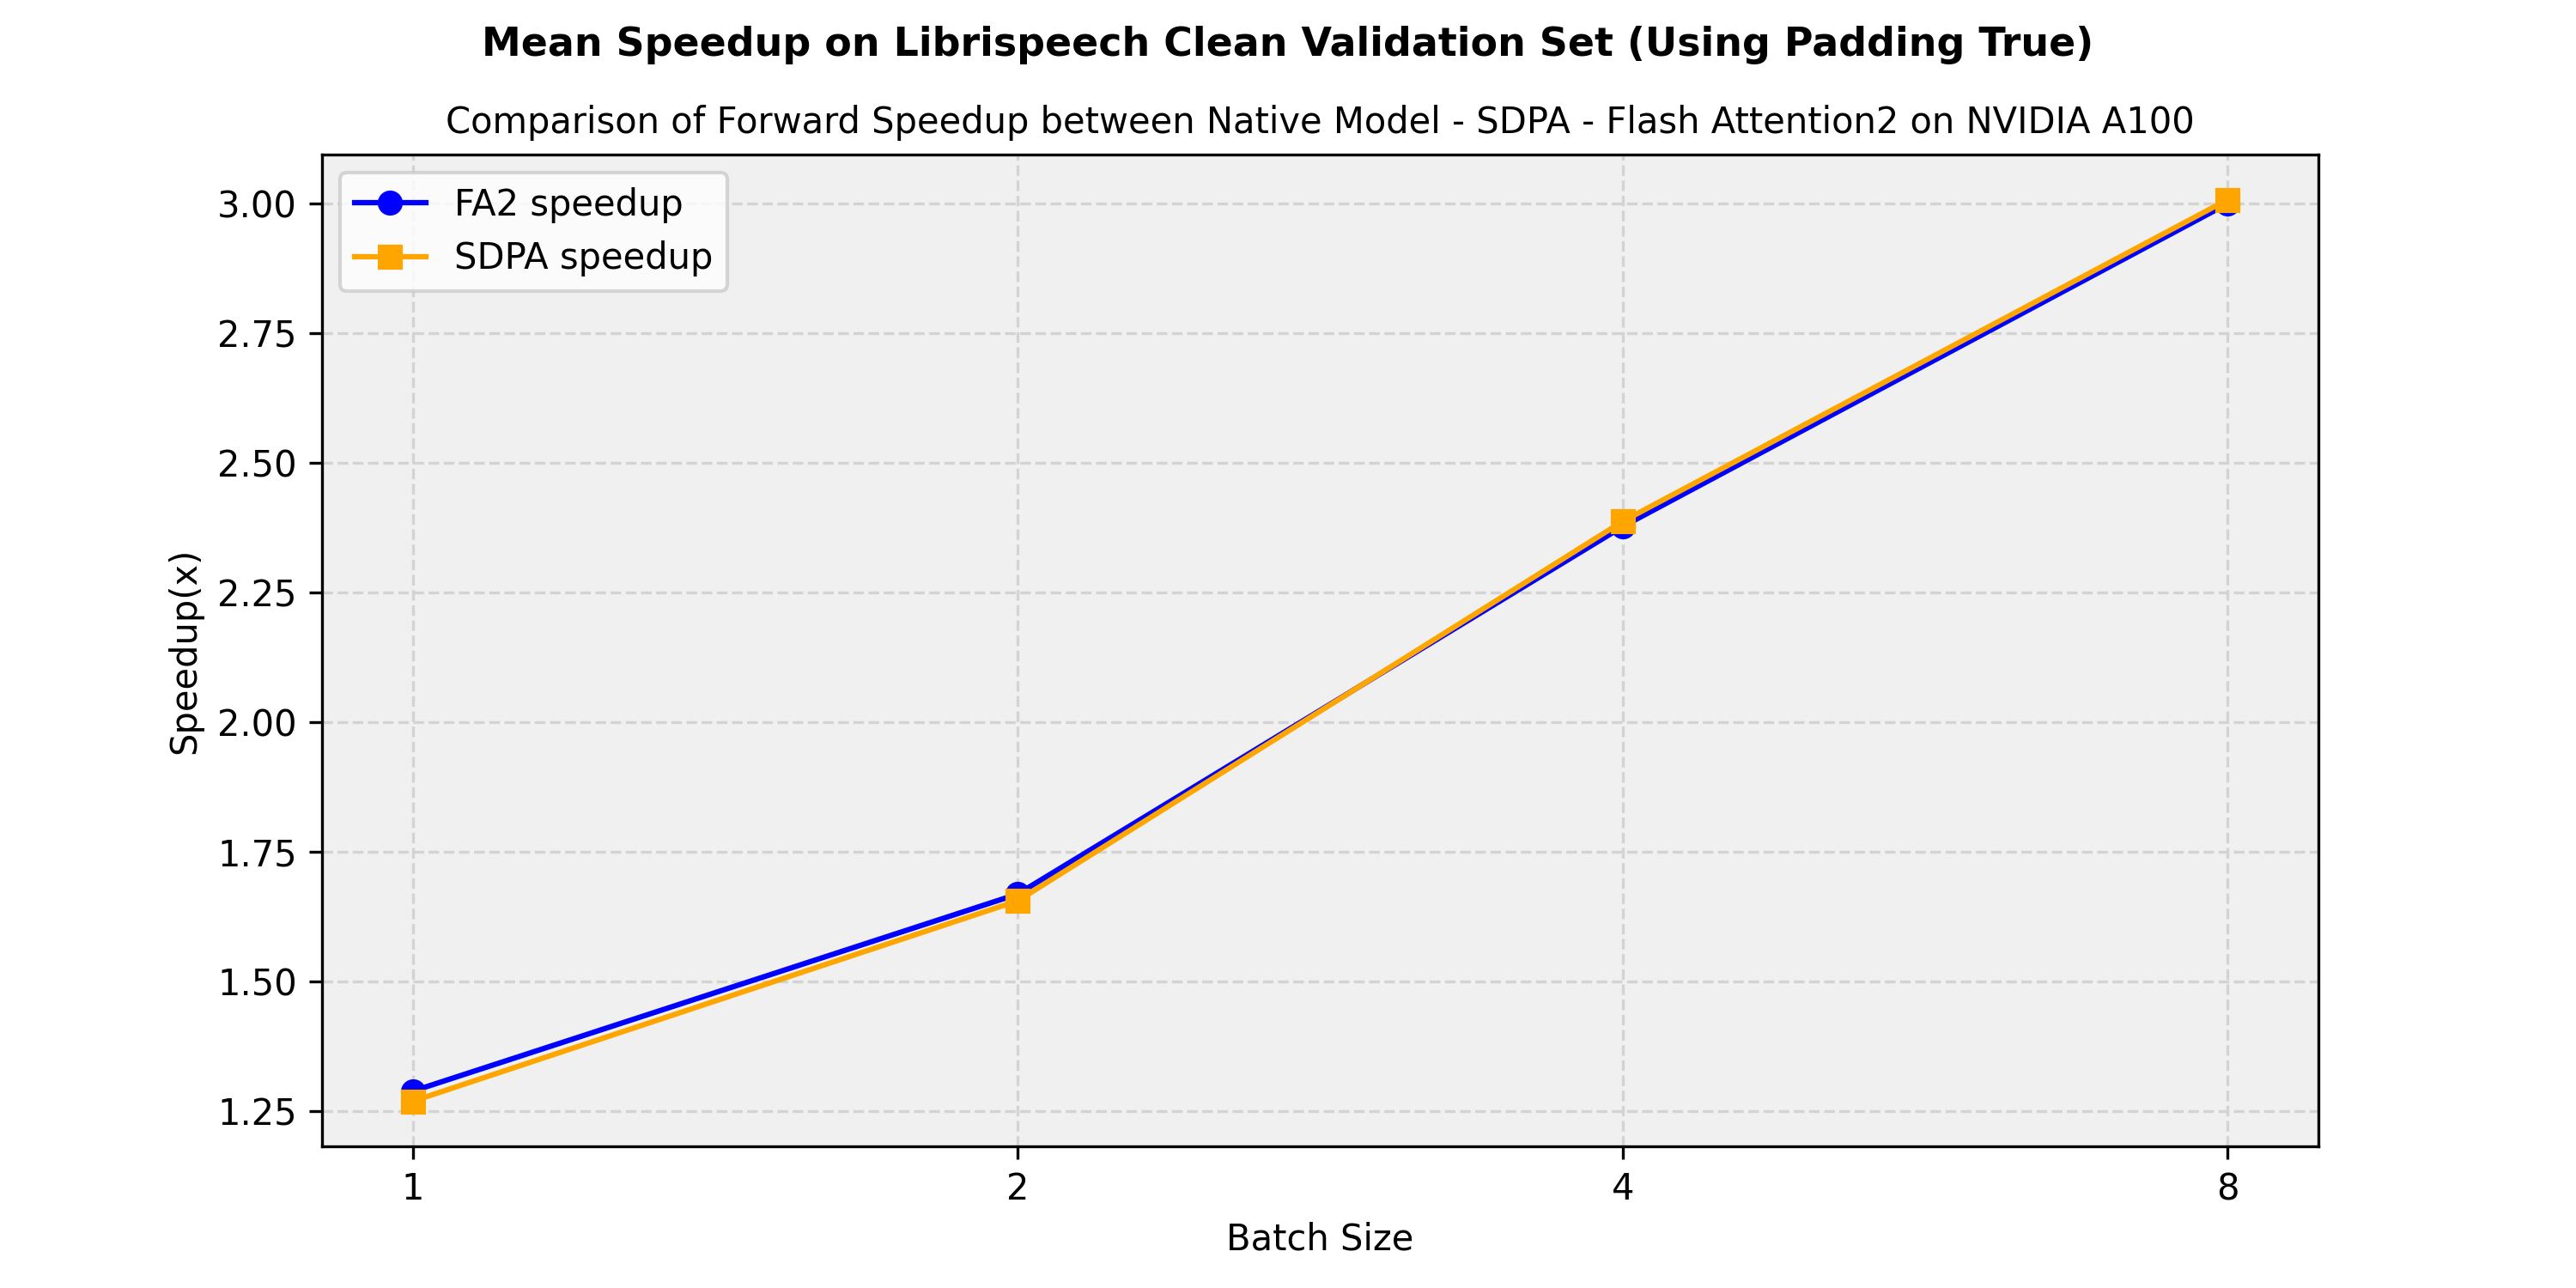
Abaixo, há um diagrama de aceleração esperada comparando o tempo de inferência puro entre a implementação nativa em transformers do modelo facebook/wav2vec2-large-960h-lv60-self e as versões flash-attention-2 e sdpa (scale-dot-product-attention). Mostramos a aceleração média obtida no split de validação librispeech_asr clean:
Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o Wav2Vec2. Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
- Um notebook sobre como utilizar um modelo Wav2Vec2 pré-treinado para classificação de emoções. 🌎
- Wav2Vec2ForCTC é suportado por este notebook.
- Guia da tarefa de classificação de áudio
- Um post de blog sobre potencializar o Wav2Vec2 com n-grams no 🤗 Transformers.
- Um post de blog sobre como ajustar o Wav2Vec2 para ASR em inglês com o 🤗 Transformers.
- Um post de blog sobre ajuste fino do XLS-R para ASR multilíngue com 🤗 Transformers.
- Um notebook sobre como criar legendas para o YouTube a partir de qualquer vídeo transcrevendo o áudio com Wav2Vec2. 🌎
- Wav2Vec2ForCTC é suportado por um notebook sobre como ajustar um modelo de reconhecimento de fala em inglês e como ajustar um modelo de reconhecimento de fala em qualquer idioma.
- Guia da tarefa de reconhecimento automático de fala
🚀 Implantação
- Um post de blog sobre como implantar o Wav2Vec2 para Reconhecimento Automático de Fala com Transformers da Hugging Face & Amazon SageMaker.
Wav2Vec2Config
classe transformers.Wav2Vec2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int | None = 32hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout: float | int = 0.1activation_dropout: float | int = 0.1attention_dropout: float | int = 0.1feat_proj_dropout: float | int = 0.0feat_quantizer_dropout: float | int = 0.0final_dropout: float | int = 0.1layerdrop: float | int = 0.1initializer_range: float = 0.02layer_norm_eps: float = 1e-05feat_extract_norm: str = 'group'feat_extract_activation: str = 'gelu'conv_dim: list[int] | tuple[int, ...] = (512, 512, 512, 512, 512, 512, 512)conv_stride: list[int] | tuple[int, ...] = (5, 2, 2, 2, 2, 2, 2)conv_kernel: list[int] | tuple[int, ...] = (10, 3, 3, 3, 3, 2, 2)conv_bias: bool = Falsenum_conv_pos_embeddings: int = 128num_conv_pos_embedding_groups: int = 16do_stable_layer_norm: bool = Falseapply_spec_augment: bool = Truemask_time_prob: float | int = 0.05mask_time_length: int = 10mask_time_min_masks: int = 2mask_feature_prob: float | int = 0.0mask_feature_length: int = 10mask_feature_min_masks: int = 0num_codevectors_per_group: int = 320num_codevector_groups: int = 2contrastive_logits_temperature: float = 0.1num_negatives: int = 100codevector_dim: int = 256proj_codevector_dim: int = 256diversity_loss_weight: float = 0.1ctc_loss_reduction: str = 'sum'ctc_zero_infinity: bool = Falseuse_weighted_layer_sum: bool = Falseclassifier_proj_size: int = 256tdnn_dim: list[int] | tuple[int, ...] = (512, 512, 512, 512, 1500)tdnn_kernel: list[int] | tuple[int, ...] = (5, 3, 3, 1, 1)tdnn_dilation: list[int] | tuple[int, ...] = (1, 2, 3, 1, 1)xvector_output_dim: int = 512pad_token_id: int | None = 0bos_token_id: int | None = 1eos_token_id: int | list[int] | None = 2add_adapter: bool = Falseadapter_kernel_size: int = 3adapter_stride: int = 2num_adapter_layers: int = 3output_hidden_size: int | None = Noneadapter_attn_dim: int | None = None )
Parâmetros
- vocab_size (
int, opcional, padrão32) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - intermediate_size (
int, opcional, padrão3072) — Dimensão das representações do MLP. - hidden_act (
str, opcional, padrãogelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - hidden_dropout (
Union[float, int], opcional, padrão0.1) — A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler. - activation_dropout (
Union[float, int], opcional, padrão0.1) — A taxa de dropout para as ativações dentro da camada totalmente conectada. - attention_dropout (
Union[float, int], opcional, padrão0.1) — A taxa de dropout para as probabilidades de atenção. - feat_proj_dropout (
float, opcional, padrão 0.0) — A probabilidade de dropout para a saída do codificador de recursos. - feat_quantizer_dropout (
float, opcional, padrão 0.0) — A probabilidade de dropout para a saída do codificador de recursos usado pelo quantizador. - final_dropout (
float, opcional, padrão 0.1) — A probabilidade de dropout para a camada de projeção final de Wav2Vec2ForCTC. - layerdrop (
Union[float, int], opcional, padrão0.1) — A probabilidade do LayerDrop. Consulte o [artigo do LayerDrop](veja https://huggingface.co/papers/1909.11556) para mais detalhes. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - feat_extract_norm (
str, opcional, padrão"group") — A normalização a ser aplicada às camadas convolucionais 1D no codificador de recursos. Pode ser"group"para normalização por grupo apenas da primeira camada convolucional 1D ou"layer"para normalização por camada de todas as camadas convolucionais 1D. - feat_extract_activation (
str,optional, defaults to“gelu”) -- The non-linear activation function (function or string) in the 1D convolutional layers of the feature extractor. If string,“gelu”,“relu”,“selu”and“gelu_new”` are supported. - conv_dim (
tuple[int]oulist[int], opcional, padrão(512, 512, 512, 512, 512, 512, 512)) — Uma tupla de inteiros que define o número de canais de entrada e saída de cada camada convolucional 1D no codificador de recursos. O comprimento de conv_dim define o número de camadas convolucionais 1D. - conv_stride (
tuple[int]oulist[int], opcional, padrão(5, 2, 2, 2, 2, 2, 2)) — Uma tupla de inteiros que define o stride de cada camada convolucional 1D no codificador de recursos. O comprimento de conv_stride define o número de camadas convolucionais e deve corresponder ao comprimento de conv_dim. - conv_kernel (
tuple[int]oulist[int], opcional, padrão(10, 3, 3, 3, 3, 3, 3)) — Uma tupla de inteiros que define o tamanho do kernel de cada camada convolucional 1D no codificador de recursos. O tamanho de conv_kernel define o número de camadas convolucionais e deve corresponder ao tamanho de conv_dim. - conv_bias (
bool, opcional, padrãoFalse) — Indica se as camadas de convolução 1D possuem viés. - num_conv_pos_embeddings (
int, opcional, padrão 128) — Número de embeddings posicionais convolucionais. Define o tamanho do kernel da camada de embeddings posicionais convolucionais 1D. - num_conv_pos_embedding_groups (
int, opcional, padrão 16) — Número de grupos da camada de embeddings posicionais convolucionais 1D. - do_stable_layer_norm (
bool, opcional, padrãoFalse) — Indica se deve aplicar a arquitetura de layer norm estável do codificador Transformer.do_stable_layer_norm is Truecorresponde à aplicação de layer norm antes da camada de atenção, enquantodo_stable_layer_norm is Falsecorresponde à aplicação de layer norm depois da camada de atenção. - apply_spec_augment (
bool, opcional, padrãoTrue) — Indica se a ampliação de dados SpecAugment deve ser aplicada às saídas do codificador de recursos. Para referência, consulte SpecAugment: A Simple Data Augmentation Method for Automatic Speech Recognition. - mask_time_prob (
float, optional, defaults to 0.05) — Percentage (between 0 and 1) of all feature vectors along the time axis which will be masked. The masking procedure generates ”mask_time_problen(time_axis)/mask_time_length” independent masks over the axis. If reasoning from the probability of each feature vector to be chosen as the start of the vector span to be masked, mask_time_prob should be `prob_vector_startmask_time_length. Note that overlap may decrease the actual percentage of masked vectors. This is only relevant ifapply_spec_augment is True`. - mask_time_length (
int, opcional, padrão 10) — Comprimento da extensão do vetor ao longo do eixo do tempo. - mask_time_min_masks (
int, opcional, padrão 2), — O número mínimo de máscaras de comprimentomask_feature_lengthgeradas ao longo do eixo do tempo, em cada passo de tempo, independentemente demask_feature_prob. Relevante apenas se ”mask_time_prob*len(time_axis)/mask_time_length < mask_time_min_masks” - mask_feature_prob (
float, optional, defaults to 0.0) — Percentage (between 0 and 1) of all feature vectors along the feature axis which will be masked. The masking procedure generates ”mask_feature_problen(feature_axis)/mask_time_length” independent masks over the axis. If reasoning from the probability of each feature vector to be chosen as the start of the vector span to be masked, mask_feature_prob should be `prob_vector_startmask_feature_length. Note that overlap may decrease the actual percentage of masked vectors. This is only relevant ifapply_spec_augment is True`. - mask_feature_prob (
Union[float, int], opcional, padrão0.0) — Porcentagem (entre 0 e 1) de todos os vetores de recursos ao longo do eixo de recursos que serão mascarados. O procedimento de mascaramento geramask_feature_prob*len(feature_axis)/mask_time_lengthmáscaras independentes sobre o eixo. Se o raciocínio for feito a partir da probabilidade de cada vetor de recurso ser escolhido como o início do espano de vetores a ser mascarado, mask_feature_prob deve serprob_vector_start*mask_feature_length. Observe que a sobreposição pode diminuir a porcentagem real de vetores mascarados. Isso é relevante apenas seapply_spec_augmentforTrue. - mask_feature_length (
int, opcional, padrão 10) — Comprimento da extensão do vetor ao longo do eixo de recursos. - mask_feature_min_masks (
int, opcional, padrão 0), — O número mínimo de máscaras de comprimentomask_feature_lengthgeradas ao longo do eixo de recursos, a cada passo de tempo, independentemente demask_feature_prob. Relevante apenas se ”mask_feature_prob*len(feature_axis)/mask_feature_length < mask_feature_min_masks” - num_codevectors_per_group (
int, opcional, padrão 320) — Número de entradas em cada livro de quantização (grupo). - num_codevectors_per_group (
int, opcional, padrão 320) — Número de entradas em cada livro de quantização (grupo). - num_codevector_groups (
int, opcional, padrão 2) — Número de grupos de codevector para quantização de codevector por produto. - contrastive_logits_temperature (
float, opcional, padrão 0.1) — A temperatura kappa na perda contrastiva. - num_negatives (
int, opcional, padrão 100) — Número de amostras negativas para a perda contrastiva. - codevector_dim (
int, opcional, padrão 256) — Dimensão dos vetores de recursos quantizados. - proj_codevector_dim (
int, opcional, padrão 256) — Dimensão da projeção final tanto das features quantizadas quanto das features do transformer. - diversity_loss_weight (
int, opcional, padrão 0.1) — O peso do componente de perda de diversidade do codebook. - ctc_loss_reduction (
str, opcional, padrão"sum") — Especifica a redução a ser aplicada à saída detorch.nn.CTCLoss. Relevante apenas ao treinar uma instância de Wav2Vec2ForCTC. - ctc_zero_infinity (
bool, opcional, padrãoFalse) — Se deve zerar perdas infinitas e os gradientes associados detorch.nn.CTCLoss. Perdas infinitas ocorrem principalmente quando as entradas são curtas demais para serem alinhadas aos alvos. Relevante apenas ao treinar uma instância de Wav2Vec2ForCTC. - use_weighted_layer_sum (
bool, opcional, padrãoFalse) — Se deve usar uma média ponderada das saídas das camadas com pesos aprendidos. Relevante apenas ao usar uma instância de Wav2Vec2ForSequenceClassification. - classifier_proj_size (
int, opcional, padrão 256) — Dimensão da projeção antes do token mean-pooling para classificação. - tdnn_dim (
tuple[int]oulist[int], opcional, padrão(512, 512, 512, 512, 1500)) — Uma tupla de inteiros que define o número de canais de saída de cada camada de convolução 1D no módulo TDNN do modelo XVector. O comprimento de tdnn_dim define o número de camadas TDNN. - tdnn_kernel (
tuple[int]oulist[int], opcional, padrão(5, 3, 3, 1, 1)) — Uma tupla de inteiros que define o tamanho do kernel de cada camada de convolução 1D no módulo TDNN do modelo XVector. O comprimento de tdnn_kernel deve corresponder ao comprimento de tdnn_dim. - tdnn_dilation (
tuple[int]oulist[int], opcional, padrão(1, 2, 3, 1, 1)) — Uma tupla de inteiros que define o fator de dilatação de cada camada de convolução 1D no módulo TDNN do modelo XVector. O comprimento de tdnn_dilation deve corresponder ao comprimento de tdnn_dim. - xvector_output_dim (
int, opcional, padrão 512) — Dimensão dos vetores de incorporação XVector. - pad_token_id (
int, opcional, padrão0) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão1) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão2) — ID do token usado para o fim do fluxo no vocabulário. - add_adapter (
bool, opcional, padrãoFalse) — Se uma rede convolucional deve ser empilhada sobre o Encoder do Wav2Vec2. Pode ser muito útil para iniciar o Wav2Vec2 para modelos SpeechEncoderDecoder. - adapter_kernel_size (
int, opcional, padrão 3) — Tamanho do kernel das camadas convolucionais na rede do adaptador. Relevante apenas seadd_adapter is True. - adapter_stride (
int, opcional, padrão 2) — Passo das camadas convolucionais na rede de adaptador. Relevante apenas seadd_adapter is True. - num_adapter_layers (
int, opcional, padrão 3) — Número de camadas convolucionais que devem ser usadas na rede de adaptador. Relevante apenas seadd_adapter is True. - output_hidden_size (
int, opcional) — Dimensão da camada de saída do codificador. Se não for definida, o valor padrão é hidden-size. Relevante apenas seadd_adapter is True. - adapter_attn_dim (
int, opcional) — Dimensão dos pesos do adaptador de atenção a serem usados em cada bloco de atenção. Um exemplo de modelo que usa adaptadores de atenção é facebook/mms-1b-all.
Esta é a classe de configuração para armazenar a configuração de um Wav2Vec2Model. Ela é usada para instanciar um modelo Wav2Vec2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do facebook/wav2vec2-base-960h
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import Wav2Vec2Config, Wav2Vec2Model

>>> # Initializing a Wav2Vec2 facebook/wav2vec2-base-960h style configuration
>>> configuration = Wav2Vec2Config()

>>> # Initializing a model (with random weights) from the facebook/wav2vec2-base-960h style configuration
>>> model = Wav2Vec2Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Wav2Vec2CTCTokenizer
classe transformers.Wav2Vec2CTCTokenizer
< source >( vocab_filebos_token = '<s>'eos_token = '</s>'unk_token = '<unk>'pad_token = '<pad>'word_delimiter_token = '|'replace_word_delimiter_char = ' 'do_lower_case = Falsetarget_lang = None**kwargs )
Parâmetros
- vocab_file (
str) — Arquivo contendo o vocabulário. - bos_token (
str, opcional, padrão"<s>") — O token de início de frase. - eos_token (
str, opcional, padrão"</s>") — O token de fim de frase. - unk_token (
str, opcional, padrão"<unk>") — O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso. - pad_token (
str, opcional, padrão"<pad>") — O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes. - word_delimiter_token (
str, opcional, padrão"|") — O token usado para definir o fim de uma palavra. - do_lower_case (
bool, opcional, padrãoFalse) — Indica se deve aceitar entrada em minúsculas e converter a saída para minúsculas durante a decodificação. - target_lang (
str, opcional) — Um idioma de destino que o tokenizer deve definir por padrão.target_langprecisa ser definido para vocabulários multilíngues aninhados, como facebook/mms-1b-all. - **kwargs — Argumentos de palavra-chave adicionais passados para PreTrainedTokenizer
Constrói um tokenizador Wav2Vec2CTC.
Este tokenizer herda de PreTrainedTokenizer, que contém alguns dos principais métodos. Os usuários devem consultar a superclasse para obter mais informações sobre esses métodos.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Parâmetros
- text (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se as sequências forem fornecidas como lista de strings (pré-tokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - text_pair (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se as sequências forem fornecidas como lista de strings (pré-tokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - text_target (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a serem codificadas como textos de destino. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - text_pair_target (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a ser codificada como textos de destino. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - tokenizer_kwargs (
dict[str, Any], opcional) — Kwargs adicionais para passar ao tokenizer. Eles serão mesclados com os parâmetros explícitos e outros kwargs, com os parâmetros explícitos tendo precedência. - add_special_tokens (
bool, opcional, padrãoTrue) — Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacentePretrainedTokenizerBase.build_inputs_with_special_tokens, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar tokensbosoueosautomaticamente. - padding (
bool,strou PaddingStrategy, opcional, padrão éFalse) — Ativa e controla o padding. Aceita os seguintes valores:Trueou'longest': Preenche até a sequência mais longa do lote (ou não aplica preenchimento se apenas uma sequência for fornecida).'max_length': Preenche até o comprimento máximo especificado com o argumentomax_lengthou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido.Falseou'do_not_pad'(padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
- truncation (
bool,strou TruncationStrategy, opcional, padrão éFalse) — Ativa e controla a truncagem. Aceita os seguintes valores:Trueou'longest_first': Trunca para um comprimento máximo especificado com o argumentomax_lengthou para o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido.'only_first': Trunca para o comprimento máximo especificado com o argumentomax_lengthou para o comprimento máximo aceitável de entrada do modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.'only_second': Trunca para um comprimento máximo especificado com o argumentomax_lengthou para o comprimento máximo aceitável de entrada do modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.Falseou'do_not_truncate'(padrão): Sem truncamento (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada aceitável pelo modelo).
- max_length (
int, opcional) — Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/preenchimento.Se não for definido ou for definido como
None, isso usará o comprimento máximo predefinido do modelo, caso um dos parâmetros de truncamento/preenchimento exija um comprimento máximo. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/preenchimento para um comprimento máximo será desativado. - stride (
int, opcional, padrão 0) — Se definido como um número junto commax_length, os tokens excedentes retornados quandoreturn_overflowing_tokens=Trueconterão alguns tokens do final da sequência truncada retornada para fornecer alguma sobreposição entre as sequências truncadas e excedentes. O valor deste argumento define o número de tokens sobrepostos. - is_split_into_words (
bool, opcional, padrãoFalse) — Indica se a entrada já está pré-tokenizada (por exemplo, dividida em palavras). Se definido comoTrue, o tokenizer assume que a entrada já foi dividida em palavras (por exemplo, separando por espaços em branco) e a tokeniza. Isso é útil para NER ou classificação de tokens. - pad_to_multiple_of (
int, opcional) — Se definido, a sequência será preenchida até um múltiplo do valor fornecido. Exige quepaddingesteja ativado. Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação>= 7.5(Volta). - padding_side (
str, opcional) — O lado em que o modelo deve ter o padding aplicado. Deve ser selecionado entre [‘right’, ‘left’]. O valor padrão é obtido do atributo de classe com o mesmo nome. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors em vez de uma lista de inteiros do Python. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo Numpy.
- return_token_type_ids (
bool, opcional) — Se deve retornar os IDs de tipo de token. Se mantido o valor padrão, retornará os IDs de tipo de token de acordo com o padrão do tokenizer específico, definido peloreturn_outputsatributo. - return_attention_mask (
bool, opcional) — Se deve retornar a attention mask. Se mantido o valor padrão, a attention mask será retornada de acordo com o padrão do tokenizer específico, definido pelo atributoreturn_outputs. - return_overflowing_tokens (
bool, opcional, padrãoFalse) — Indica se as sequências de tokens excedentes devem ser retornadas. Se um par de sequências de ids de entrada (ou um lote de pares) for fornecido comtruncation_strategy = longest_firstouTrue, um erro será lançado em vez de retornar os tokens excedentes. - return_special_tokens_mask (
bool, opcional, padrãoFalse) — Indica se a máscara de tokens especiais deve ser retornada. - return_offsets_mapping (
bool, opcional, padrão éFalse) — Se deve ou não retornar(char_start, char_end)para cada token.Isso está disponível apenas em tokenizadores rápidos que herdam de PreTrainedTokenizerFast; se estiver usando o tokenizador em Python, este método lançará
NotImplementedError. - return_length (
bool, opcional, padrãoFalse) — Indica se as comprimentos das entradas codificadas devem ser retornados. - verbose (
bool, opcional, padrãoTrue) — Se deve ou não exibir mais informações e avisos. - **kwargs — passados para o método
self.tokenize()
Retorna
Um BatchEncoding com os seguintes campos:
-
input_ids — Lista de ids de tokens a serem fornecidos a um modelo.
-
token_type_ids — Lista de ids de tipo de token a serem fornecidos a um modelo (quando
return_token_type_ids=Trueou se “token_type_ids” estiver emself.model_input_names). -
attention_mask — Lista de índices que especifica quais tokens devem ser considerados pelo modelo (quando
return_attention_mask=Trueou se “attention_mask” estiver emself.model_input_names). -
overflowing_tokens — Lista de sequências de tokens excedentes (quando um
max_lengthé especificado ereturn_overflowing_tokens=True). -
num_truncated_tokens — Número de tokens truncados (quando um
max_lengthé especificado ereturn_overflowing_tokens=True). -
special_tokens_mask — Lista de 0s e 1s, em que 1 especifica tokens especiais adicionados e 0 especifica tokens regulares da sequência (quando
add_special_tokens=Trueereturn_special_tokens_mask=True). -
length — O comprimento das entradas (quando
return_length=True)
Método principal para tokenizar e preparar uma ou várias sequências ou um ou vários pares de sequências para o modelo.
decode
< source >( token_ids: typing.Union[int, list[int], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = Noneoutput_char_offsets: bool = Falseoutput_word_offsets: bool = False**kwargs ) → str or Wav2Vec2CTCTokenizerOutput
Parâmetros
- token_ids (
Union[int, list[int], np.ndarray, torch.Tensor]) — Lista de ids de entrada tokenizados. Pode ser obtida usando o método__call__. - skip_special_tokens (
bool, opcional, padrãoFalse) — Indica se os tokens especiais devem ser removidos durante a decodificação. - clean_up_tokenization_spaces (
bool, opcional) — Indica se os espaços de tokenização devem ser limpos. - output_char_offsets (
bool, opcional, padrão éFalse) — Indica se os deslocamentos de caracteres devem ser retornados. Os deslocamentos de caracteres podem ser usados em conjunto com a taxa de amostragem e a taxa de subamostragem do modelo para calcular os carimbos de tempo dos caracteres transcritos.Dê uma olhada no exemplo abaixo para entender melhor como usar
output_char_offsets. - output_word_offsets (
bool, opcional, padrão éFalse) — Define se os deslocamentos de palavras (word offsets) devem ser incluídos na saída. Esses deslocamentos podem ser usados em conjunto com a taxa de amostragem e a taxa de downsampling do modelo para calcular os timestamps das palavras transcritas.Dê uma olhada no exemplo abaixo para entender melhor como usar
output_word_offsets. - kwargs (argumentos de palavra-chave adicionais, opcional) — Serão passados para o método de decodificação específico do modelo subjacente.
Retorna
str ou Wav2Vec2CTCTokenizerOutput
A lista de frases decodificadas. Será um Wav2Vec2CTCTokenizerOutput quando output_char_offsets == True ou output_word_offsets == True.
Converte uma sequência de ids em uma string, usando o tokenizer e o vocabulário, com opções para remover tokens especiais e limpar os espaços de tokenização.
Semelhante a executar self.convert_tokens_to_string(self.convert_ids_to_tokens(token_ids)).
Exemplo:
>>> # Let's see how to retrieve time steps for a model
>>> from transformers import AutoTokenizer, AutoFeatureExtractor, AutoModelForCTC
>>> from datasets import load_dataset
>>> import datasets
>>> import torch

>>> # import model, feature extractor, tokenizer
>>> model = AutoModelForCTC.from_pretrained("facebook/wav2vec2-base-960h")
>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")

>>> # load first sample of English common_voice
>>> dataset = load_dataset("mozilla-foundation/common_voice_11_0", "en", split="train", streaming=True)
>>> dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))
>>> dataset_iter = iter(dataset)
>>> sample = next(dataset_iter)

>>> # forward sample through model to get greedily predicted transcription ids
>>> input_values = feature_extractor(sample["audio"]["array"], return_tensors="pt").input_values
>>> logits = model(input_values).logits[0]
>>> pred_ids = torch.argmax(logits, axis=-1)

>>> # retrieve word stamps (analogous commands for `output_char_offsets`)
>>> outputs = tokenizer.decode(pred_ids, output_word_offsets=True)
>>> # compute `time_offset` in seconds as product of downsampling ratio and sampling_rate
>>> time_offset = model.config.inputs_to_logits_ratio / feature_extractor.sampling_rate

>>> word_offsets = [
...     {
...         "word": d["word"],
...         "start_time": round(d["start_offset"] * time_offset, 2),
...         "end_time": round(d["end_offset"] * time_offset, 2),
...     }
...     for d in outputs.word_offsets
... ]
>>> # compare word offsets with audio `en_train_0/common_voice_en_19121553.mp3` online on the dataset viewer:
>>> # https://huggingface.co/datasets/mozilla-foundation/common_voice_11_0/viewer/en
>>> word_offsets[:3]
[{'word': 'THE', 'start_time': 0.7, 'end_time': 0.78}, {'word': 'TRICK', 'start_time': 0.88, 'end_time': 1.08}, {'word': 'APPEARS', 'start_time': 1.2, 'end_time': 1.64}]
batch_decode
< source >( sequences: typing.Union[list[int], list[list[int]], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = Noneoutput_char_offsets: bool = Falseoutput_word_offsets: bool = False**kwargs ) → list[str] or Wav2Vec2CTCTokenizerOutput
Parâmetros
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Lista de ids de entrada tokenizados. Pode ser obtida usando o método__call__. - skip_special_tokens (
bool, opcional, padrãoFalse) — Indica se os tokens especiais devem ser removidos durante a decodificação. - clean_up_tokenization_spaces (
bool, opcional) — Indica se os espaços de tokenização devem ser limpos. - output_char_offsets (
bool, opcional, padrão éFalse) — Indica se os deslocamentos de caracteres devem ser incluídos na saída. Os deslocamentos de caracteres podem ser usados em conjunto com a taxa de amostragem e a taxa de subamostragem do modelo para calcular os carimbos de tempo dos caracteres transcritos.Dê uma olhada no Exemplo de decode() para entender melhor como fazer uso de
output_char_offsets. batch_decode() funciona da mesma forma com saída em lote. - output_word_offsets (
bool, opcional, padrão éFalse) — Indica se os deslocamentos de palavras devem ser incluídos na saída. Os deslocamentos de palavras podem ser usados em conjunto com a taxa de amostragem e a taxa de subamostragem do modelo para calcular os carimbos de tempo das palavras transcritas.Dê uma olhada no Exemplo de decode() para entender melhor como fazer uso de
output_word_offsets. batch_decode() funciona da mesma forma com saída em lote. - kwargs (argumentos de palavra-chave adicionais, opcional) — Serão passados para o método de decodificação específico do modelo subjacente.
Retorna
list[str] ou Wav2Vec2CTCTokenizerOutput
A lista de frases decodificadas. Será um Wav2Vec2CTCTokenizerOutput quando output_char_offsets == True ou output_word_offsets == True.
Converta uma lista de listas de ids de tokens em uma lista de strings chamando decode.
Defina o idioma de destino de um dicionário multilíngue aninhado
Wav2Vec2FeatureExtractor
classe transformers.Wav2Vec2FeatureExtractor
< source >( feature_size = 1sampling_rate = 16000padding_value = 0.0return_attention_mask = Falsedo_normalize = True**kwargs )
Parâmetros
- feature_size (
int, opcional, padrão 1) — A dimensão dos recursos das características extraídas. - sampling_rate (
int, opcional, padrão 16000) — A taxa de amostragem na qual os arquivos de áudio devem ser digitalizados, expressa em hertz (Hz). - padding_value (
float, opcional, padrão 0.0) — O valor usado para preencher os valores de padding. - do_normalize (
bool, opcional, padrãoTrue) — Indica se a entrada deve ser normalizada com média zero e variância unitária. A normalização pode ajudar a melhorar significativamente o desempenho de alguns modelos, por exemplo, wav2vec2-lv60. - return_attention_mask (
bool, opcional, padrão éFalse) — Se chamar() deve retornarattention_mask.Os modelos Wav2Vec2 que definiram
config.feat_extract_norm == "group", como o wav2vec2-base, não foram treinados usandoattention_mask. Para esses modelos,input_valuesdeve ser simplesmente preenchido com 0 e nenhumattention_maskdeve ser passado.Para modelos Wav2Vec2 que têm
config.feat_extract_norm == "layer"definido, como o wav2vec2-lv60, oattention_maskdeve ser passado para inferência em lote.
Constrói um extrator de recursos Wav2Vec2.
Este extrator de características herda de SequenceFeatureExtractor, que contém a maioria dos métodos principais. Os usuários devem consultar essa superclasse para obter mais informações sobre esses métodos.
__call__
< source >( raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]]padding: bool | str | transformers.utils.generic.PaddingStrategy = Falsemax_length: int | None = Nonetruncation: bool = Falsepad_to_multiple_of: int | None = Nonereturn_attention_mask: bool | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonesampling_rate: int | None = None**kwargs )
Parâmetros
- raw_speech (
np.ndarray,list[float],list[np.ndarray],list[list[float]]) — A sequência ou lote de sequências a serem preenchidas. Cada sequência pode ser um array numpy, uma lista de valores float, uma lista de arrays numpy ou uma lista de listas de valores float. Deve ser áudio mono, não estéreo, ou seja, um único float por timestep. - padding (
bool,strou PaddingStrategy, opcional, padrão éFalse) — Selecione uma estratégia para aplicar padding às sequências retornadas (de acordo com o lado de padding e o índice de padding do modelo) entre:Trueou'longest': Preenche até a sequência mais longa do lote (ou não aplica preenchimento se apenas uma sequência for fornecida).'max_length': Preenche até o comprimento máximo especificado com o argumentomax_lengthou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido.Falseou'do_not_pad'(padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
- max_length (
int, opcional) — Comprimento máximo da lista retornada e, opcionalmente, o comprimento do padding (veja acima). - truncation (
bool) — Ativa a truncagem para cortar sequências de entrada com comprimento maior que max_length para max_length. - pad_to_multiple_of (
int, opcional) — Se definido, a sequência será preenchida até um múltiplo do valor fornecido.Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação
>= 7.5(Volta), ou em TPUs, que se beneficiam de ter comprimentos de sequência que sejam múltiplos de 128. - return_attention_mask (
bool, opcional) — Se deve retornar a attention mask. Se mantido o valor padrão, a attention mask será retornada de acordo com o padrão do feature_extractor específico.O que são máscaras de atenção?
Modelos Wav2Vec2 que definiram
config.feat_extract_norm == "group", como o wav2vec2-base, não foram treinados usandoattention_mask. Para esses modelos,input_valuesdeve ser simplesmente preenchido com 0 e nenhumattention_maskdeve ser passado.Para modelos Wav2Vec2 que têm
config.feat_extract_norm == "layer"definido, como o wav2vec2-lv60,attention_maskdeve ser passado para inferência em lote. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors em vez de uma lista de inteiros do Python. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo Numpy.
- sampling_rate (
int, opcional) — A taxa de amostragem na qual a entradaraw_speechfoi amostrada. É fortemente recomendável passarsampling_ratena chamada de forward para evitar erros silenciosos. - padding_value (
float, opcional, padrão 0.0) —
Método principal para criar recursos e preparar uma ou várias sequências para o modelo.
Wav2Vec2Processor
classe transformers.Wav2Vec2Processor
< source >( feature_extractortokenizer )
Constrói um Wav2Vec2Processor que encapsula um extrator de recursos e um tokenizador em um único processador.
Wav2Vec2Processor oferece todas as funcionalidades de Wav2Vec2FeatureExtractor e Wav2Vec2CTCTokenizer. Consulte ~Wav2Vec2FeatureExtractor e ~Wav2Vec2CTCTokenizer para mais informações.
__call__
< source >( audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | None = None**kwargs: *<class 'transformers.models.wav2vec2.processing_wav2vec2.Wav2Vec2ProcessorKwargs'> )
Parâmetros
- audio (
Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]], opcional) — O áudio ou lote de áudios a ser preparado. Cada áudio pode ser um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada áudio deve ter a forma (C, T), onde C é o número de canais e T é o comprimento de amostras do áudio. - text (
Union[str, list[str]], opcional) — A sequência ou lote de sequências a serem codificadas. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se você passar uma entrada pré-tokenizada, definais_split_into_words=Truepara evitar ambiguidade com entradas em lote. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
- **kwargs (ProcessingKwargs, opcional) — Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
pad
< source >( *args**kwargs )
Parâmetros
- input_features —
Quando o primeiro argumento é um dicionário contendo um lote de tensores, ou quando o argumento
input_featuresestá presente, ele é passado para Wav2Vec2FeatureExtractor.pad(). - labels —
Quando o argumento
labelestá presente, ele é passado para PreTrainedTokenizer.pad().
Este método opera em lotes de recursos extraídos e/ou texto tokenizado. Ele encaminha todos os argumentos para Wav2Vec2FeatureExtractor.pad() e/ou PreTrainedTokenizer.pad(), dependendo da modalidade de entrada, e retorna suas saídas. Se ambas as modalidades forem passadas, Wav2Vec2FeatureExtractor.pad() e PreTrainedTokenizer.pad() serão chamados.
from_pretrained
< source >( pretrained_model_name_or_path: str | os.PathLikecache_dir: str | os.PathLike | None = Noneforce_download: bool = Falselocal_files_only: bool = Falsetoken: str | bool | None = Nonerevision: str = 'main'**kwargs )
Parâmetros
- pretrained_model_name_or_path (
strouos.PathLike) — Pode ser:- uma string, o model id de um feature_extractor pré-treinado hospedado em um repositório de modelos no huggingface.co.
- um caminho para um diretório contendo um arquivo de extrator de recursos salvo usando o método
save_pretrained(), por exemplo,
./my_model_directory/. - um caminho para um arquivo JSON de extrator de recursos salvo file, por exemplo,
./my_model_directory/preprocessor_config.json.
- **kwargs —
Argumentos de palavra-chave adicionais passados para
from_pretrained() e
~tokenization_utils_base.PreTrainedTokenizer.from_pretrained.
Instancie um processador associado a um modelo pré-treinado.
Este método de classe simplesmente chama o método from_pretrained() do extrator de recursos, o método ImageProcessingMixin do processador de imagem e o método
~tokenization_utils_base.PreTrainedTokenizer.from_pretraineddo tokenizador. Consulte as docstrings dos métodos acima para mais informações.
save_pretrained
< source >( save_directorypush_to_hub: bool = False**kwargs )
Parâmetros
- save_directory (
strouos.PathLike) — Diretório onde o arquivo JSON do extrator de recursos e os arquivos do tokenizer serão salvos (o diretório será criado se não existir). - push_to_hub (
bool, opcional, padrãoFalse) — Indica se o modelo deve ser enviado para o Hugging Face model hub após ser salvo. Você pode especificar o repositório de destino comrepo_id(por padrão, será usado o nome desave_directoryno seu namespace). - kwargs (
dict[str, Any], opcional) — Argumentos de palavra-chave adicionais passados ao método push_to_hub().
Salva os atributos deste processador (extrator de recursos, tokenizador…) no diretório especificado para que ele possa ser recarregado usando o método from_pretrained().
Este método de classe simplesmente chama save_pretrained() e save_pretrained(). Consulte as docstrings dos métodos acima para mais informações.
Este método encaminha todos os seus argumentos para o batch_decode() do PreTrainedTokenizer. Consulte a docstring deste método para obter mais informações.
Este método encaminha todos os seus argumentos para o decode() do PreTrainedTokenizer. Consulte a docstring deste método para obter mais informações.
Wav2Vec2ProcessorWithLM
classe transformers.Wav2Vec2ProcessorWithLM
< source >( feature_extractor: FeatureExtractionMixintokenizer: PreTrainedTokenizerBasedecoder: BeamSearchDecoderCTC )
Constrói um Wav2Vec2ProcessorWithLM que encapsula um extrator de recursos e um tokenizer em um único processador.
Wav2Vec2ProcessorWithLM oferece todas as funcionalidades de feature_extractor_class e tokenizer_class. Consulte ~feature_extractor_class e ~tokenizer_class para mais informações.
__call__
< source >( *args**kwargs )
Parâmetros
- return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
Quando usado no modo normal, este método encaminha todos os seus argumentos para o ~FeatureExtractionMixin.pad do extrator de recursos e retorna sua saída. Se usado no contexto ~Wav2Vec2ProcessorWithLM.as_target_processor, este método encaminha todos os seus argumentos para o pad() do Wav2Vec2CTCTokenizer. Consulte a docstring dos dois métodos acima para obter mais informações.
from_pretrained
< source >( pretrained_model_name_or_path**kwargs )
Parâmetros
- pretrained_model_name_or_path (
strouos.PathLike) — Pode ser:- uma string, o model id de um feature_extractor pré-treinado hospedado em um repositório de modelos no huggingface.co.
- um caminho para um diretório contendo um arquivo de extrator de recursos salvo usando o método
save_pretrained(), por exemplo,
./my_model_directory/. - um caminho para um arquivo JSON de extrator de recursos salvo file, por exemplo,
./my_model_directory/preprocessor_config.json.
- **kwargs — Argumentos de palavra-chave adicionais passados tanto para SequenceFeatureExtractor quanto para PreTrainedTokenizer
Instancie um Wav2Vec2ProcessorWithLM a partir de um processador Wav2Vec2 pré-treinado.
Este método de classe simplesmente chama o from_pretrained() do extrator de recursos, o from_pretrained() do Wav2Vec2CTCTokenizer e o
pyctcdecode.BeamSearchDecoderCTC.load_from_hf_hub.Consulte os docstrings dos métodos acima para obter mais informações.
batch_decode
< source >( logits: ndarraypool: multiprocessing.pool.Pool | None = Nonenum_processes: int | None = Nonebeam_width: int | None = Nonebeam_prune_logp: float | None = Nonetoken_min_logp: float | None = Nonehotwords: collections.abc.Iterable[str] | None = Nonehotword_weight: float | None = Nonealpha: float | None = Nonebeta: float | None = Noneunk_score_offset: float | None = Nonelm_score_boundary: bool | None = Noneoutput_word_offsets: bool = Falsen_best: int = 1 )
Parâmetros
- logits (
np.ndarray) — O vetor de saída de logits do modelo, representando as log probabilidades para cada token. - pool (
multiprocessing.Pool, opcional) — Um pool gerenciado pelo usuário, opcional. Se não for definido, um será criado e fechado automaticamente. O pool deve ser instanciado apósWav2Vec2ProcessorWithLM. Caso contrário, o LM não estará disponível para os subprocessos do pool.Atualmente, apenas pools criadas com um contexto ‘fork’ podem ser usadas. Se uma pool ‘spawn’ for passada, ela será ignorada e a decodificação sequencial será usada em vez disso.
- num_processes (
int, opcional) — Sepoolnão estiver definido, número de processos sobre os quais a função deve ser paralelizada. O valor padrão é o número de CPUs disponíveis. - beam_width (
int, opcional) — Número máximo de feixes em cada etapa da decodificação. O valor padrão é DEFAULT_BEAM_WIDTH do pyctcdecode. - beam_prune_logp (
int, opcional) — Beams muito piores que o melhor beam serão eliminados. O valor padrão é DEFAULT_PRUNE_LOGP do pyctcdecode. - token_min_logp (
int, opcional) — Tokens com logp abaixo deste valor são ignorados, a menos que sejam o argmax do frame. O valor padrão é DEFAULT_MIN_TOKEN_LOGP do pyctcdecode. - hotwords (
list[str], opcional) — Lista de palavras com importância extra, podem ser OOV para o LM - hotword_weight (
int, opcional) — Fator de peso para a importância das palavras-chave. O valor padrão é DEFAULT_HOTWORD_WEIGHT do pyctcdecode. - alpha (
float, opcional) — Peso para o modelo de linguagem durante a fusão rasa - beta (
float, opcional) — Peso para o ajuste da pontuação de comprimento durante a pontuação - unk_score_offset (
float, opcional) — Quantidade de deslocamento de log score para tokens desconhecidos - lm_score_boundary (
bool, opcional) — Se o kenlm deve respeitar fronteiras ao pontuar - output_word_offsets (
bool, opcional, padrãoFalse) — Indica se os deslocamentos das palavras devem ser exibidos na saída. Os deslocamentos das palavras podem ser usados em conjunto com a taxa de amostragem e a taxa de subamostragem do modelo para calcular os carimbos de tempo das palavras transcritas. - n_best (
int, opcional, padrão é1) — Número de melhores hipóteses a retornar. Sen_bestfor maior que 1, otextretornado será uma lista de listas de strings,logit_scoreserá uma lista de listas de floats elm_scoreserá uma lista de listas de floats, em que o comprimento da lista externa corresponderá ao tamanho do lote e o comprimento da lista interna corresponderá ao número de hipóteses retornadas. O valor deve ser >= 1.Dê uma olhada no Exemplo de decode() para entender melhor como utilizar
output_word_offsets. batch_decode() funciona da mesma forma com saída em lote.
Decodifique em lote os logits de saída para transcrição de áudio com suporte a modelo de linguagem.
Esta função utiliza o multiprocessing do Python. Atualmente, o multiprocessing está disponível apenas em sistemas Unix (veja esta questão).
Se você estiver decodificando vários lotes, considere criar um
Poole passá-lo parabatch_decode. Caso contrário,batch_decodeserá muito lento, pois criará umPoolnovo para cada chamada. Veja um exemplo de uso abaixo.
Exemplo: Veja Decodificação de múltiplos áudios.
decode
< source >( logits: ndarraybeam_width: int | None = Nonebeam_prune_logp: float | None = Nonetoken_min_logp: float | None = Nonehotwords: collections.abc.Iterable[str] | None = Nonehotword_weight: float | None = Nonealpha: float | None = Nonebeta: float | None = Noneunk_score_offset: float | None = Nonelm_score_boundary: bool | None = Noneoutput_word_offsets: bool = Falsen_best: int = 1 )
Parâmetros
- logits (
np.ndarray) — O vetor de saída de logits do modelo, representando as log probabilidades para cada token. - beam_width (
int, opcional) — Número máximo de feixes em cada etapa da decodificação. O valor padrão é DEFAULT_BEAM_WIDTH do pyctcdecode. - beam_prune_logp (
int, opcional) — Um limiar para podar feixes com log-probs menores que best_beam_logp + beam_prune_logp. O valor deve ser <= 0. O padrão é DEFAULT_PRUNE_LOGP do pyctcdecode. - token_min_logp (
int, opcional) — Tokens com log-probs abaixo de token_min_logp são ignorados, a menos que tenham o log-prob máximo para uma utterance. O valor padrão é DEFAULT_MIN_TOKEN_LOGP do pyctcdecode. - hotwords (
list[str], opcional) — Lista de palavras com importância extra que podem estar ausentas do vocabulário do LM, por exemplo, [“huggingface”] - hotword_weight (
int, opcional) — Multiplicador de peso que aumenta as pontuações das palavras-chave. O valor padrão é DEFAULT_HOTWORD_WEIGHT do pyctcdecode. - alpha (
float, opcional) — Peso para o modelo de linguagem durante a fusão rasa - beta (
float, opcional) — Peso para o ajuste da pontuação de comprimento durante a pontuação - unk_score_offset (
float, opcional) — Quantidade de deslocamento de log score para tokens desconhecidos - lm_score_boundary (
bool, opcional) — Se o kenlm deve respeitar fronteiras ao pontuar - output_word_offsets (
bool, opcional, padrãoFalse) — Indica se os deslocamentos das palavras devem ser exibidos na saída. Os deslocamentos das palavras podem ser usados em conjunto com a taxa de amostragem e a taxa de subamostragem do modelo para calcular os carimbos de tempo das palavras transcritas. - n_best (
int, opcional, padrão é1) — Número de melhores hipóteses a retornar. Sen_bestfor maior que 1, otextretornado será uma lista de strings,logit_scoreserá uma lista de floats elm_scoreserá uma lista de floats, em que o tamanho dessas listas corresponderá ao número de hipóteses retornadas. O valor deve ser >= 1.Dê uma olhada no exemplo abaixo para entender melhor como usar
output_word_offsets.
Decodifique os logits de saída para transcrição de áudio com suporte a modelos de linguagem.
Exemplo:
>>> # Let's see how to retrieve time steps for a model
>>> from transformers import AutoTokenizer, AutoProcessor, AutoModelForCTC
>>> from datasets import load_dataset
>>> import datasets
>>> import torch

>>> # import model, feature extractor, tokenizer
>>> model = AutoModelForCTC.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")
>>> processor = AutoProcessor.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")

>>> # load first sample of English common_voice
>>> dataset = load_dataset("mozilla-foundation/common_voice_11_0", "en", split="train", streaming=True)
>>> dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))
>>> dataset_iter = iter(dataset)
>>> sample = next(dataset_iter)

>>> # forward sample through model to get greedily predicted transcription ids
>>> input_values = processor(sample["audio"]["array"], return_tensors="pt").input_values
>>> with torch.no_grad():
...     logits = model(input_values).logits[0].cpu().numpy()

>>> # retrieve word stamps (analogous commands for `output_char_offsets`)
>>> outputs = processor.decode(logits, output_word_offsets=True)
>>> # compute `time_offset` in seconds as product of downsampling ratio and sampling_rate
>>> time_offset = model.config.inputs_to_logits_ratio / processor.feature_extractor.sampling_rate

>>> word_offsets = [
...     {
...         "word": d["word"],
...         "start_time": round(d["start_offset"] * time_offset, 2),
...         "end_time": round(d["end_offset"] * time_offset, 2),
...     }
...     for d in outputs.word_offsets
... ]
>>> # compare word offsets with audio `en_train_0/common_voice_en_19121553.mp3` online on the dataset viewer:
>>> # https://huggingface.co/datasets/mozilla-foundation/common_voice_11_0/viewer/en
>>> word_offsets[:4]
[{'word': 'THE', 'start_time': 0.68, 'end_time': 0.78}, {'word': 'TRACK', 'start_time': 0.88, 'end_time': 1.1}, {'word': 'APPEARS', 'start_time': 1.18, 'end_time': 1.66}, {'word': 'ON', 'start_time': 1.86, 'end_time': 1.92}]
Decodificação de vários áudios
Se você planeja decodificar vários lotes de áudios, considere usar batch_decode() e passar uma instância de multiprocessing.Pool.
Caso contrário, o desempenho de batch_decode() será mais lento do que chamar decode() para cada áudio individualmente, pois ele instancia internamente um novo Pool a cada chamada. Veja o exemplo abaixo:
# Let's see how to use a user-managed pool for batch decoding multiple audios
from multiprocessing import get_context

import datasets
import torch
from datasets import load_dataset

from transformers import AutoModelForCTC, AutoProcessor


# import model, feature extractor, tokenizer
model = AutoModelForCTC.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm", device_map="auto")
processor = AutoProcessor.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")

# load example dataset
dataset = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")
dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))


def map_to_array(example):
    example["speech"] = example["audio"]["array"]
    return example


# prepare speech data for batch inference
dataset = dataset.map(map_to_array, remove_columns=["audio"])


def map_to_pred(batch, pool):
    inputs = processor(batch["speech"], sampling_rate=16_000, padding=True, return_tensors="pt").to(model.device)
    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        logits = model(**inputs).logits

    transcription = processor.batch_decode(logits.cpu().numpy(), pool).text
    batch["transcription"] = transcription
    return batch


# note: pool should be instantiated *after* `Wav2Vec2ProcessorWithLM`.
#       otherwise, the LM won't be available to the pool's sub-processes
# select number of processes and batch_size based on number of CPU cores available and on dataset size
with get_context("fork").Pool(processes=2) as pool:
    result = dataset.map(
        map_to_pred, batched=True, batch_size=2, fn_kwargs={"pool": pool}, remove_columns=["speech"]
    )

result["transcription"][:2]
['MISTER QUILTER IS THE APOSTLE OF THE MIDDLE CLASSES AND WE ARE GLAD TO WELCOME HIS GOSPEL', "NOR IS MISTER COULTER'S MANNER LESS INTERESTING THAN HIS MATTER"]
Saídas específicas do Wav2Vec2
classe transformers.models.wav2vec2_with_lm.processing_wav2vec2_with_lm.Wav2Vec2DecoderWithLMOutput
< source >( text: list[list[str]] | list[str] | strlogit_score: list[list[float]] | list[float] | float = Nonelm_score: list[list[float]] | list[float] | float = Noneword_offsets: list[list[list[dict[str, int | str]]]] | list[list[dict[str, int | str]]] | list[dict[str, int | str]] = None )
Parâmetros
- text (lista de
stroustr) — Logits decodificados em texto. Geralmente, a transcrição da fala. - logit_score (lista de
floatoufloat) — Pontuação total de logit dos feixes associados ao texto gerado. - lm_score (lista de
float) — Fused lm_score dos feixes associados ao texto gerado. - word_offsets (lista de
list[dict[str, Union[int, str]]]oulist[dict[str, Union[int, str]]]) — Deslocamentos das palavras decodificadas. Em combinação com a taxa de amostragem e a taxa de subamostragem do modelo, os deslocamentos das palavras podem ser usados para calcular carimbos de tempo para cada palavra.
Tipo de saída de Wav2Vec2DecoderWithLM, com transcrição.
classe transformers.modeling_outputs.Wav2Vec2BaseModelOutput
< source >( last_hidden_state: typing.Optional[torch.Tensor] = Noneextract_features: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor, ...] | None = Noneattentions: tuple[torch.Tensor, ...] | None = None )
Parâmetros
- last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo. - extract_features (
torch.Tensorde forma(batch_size, sequence_length, conv_dim[-1])) — Sequência de vetores de características extraídos da última camada convolucional do modelo. - hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas do embedding inicial.
- attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Classe base para modelos que foram treinados com o objetivo de perda Wav2Vec2.
classe transformers.models.wav2vec2.modeling_wav2vec2.Wav2Vec2ForPreTrainingOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneprojected_states: typing.Optional[torch.Tensor] = Noneprojected_quantized_states: typing.Optional[torch.Tensor] = Nonecodevector_perplexity: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = Nonecontrastive_loss: typing.Optional[torch.Tensor] = Nonediversity_loss: typing.Optional[torch.Tensor] = None )
Parâmetros
- loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — Perda total como a soma da perda contrastiva (L_m) e da perda de diversidade (L_d), conforme descrito no artigo oficial. - projected_states (
torch.Tensorde forma(batch_size, sequence_length, config.proj_codevector_dim)) — Estados ocultos do modelo projetados para config.proj_codevector_dim que podem ser usados para prever os estados quantizados projetados mascarados. - projected_quantized_states (
torch.Tensorde forma(batch_size, sequence_length, config.proj_codevector_dim)) — Vetores de recursos extraídos quantizados projetados em config.proj_codevector_dim, representando os vetores-alvo positivos para a perda contrastiva. - codevector_perplexity (
torch.Tensorde forma(1,)) — A perplexidade da distribuição de codevector, usada para medir a diversidade do codebook. - hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
- contrastive_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The contrastive loss (L_m) as stated in the official paper. - diversity_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The diversity loss (L_d) as stated in the official paper.
Tipo de saída de Wav2Vec2ForPreTraining, com estados ocultos e atenções potenciais.
Wav2Vec2Model
classe transformers.Wav2Vec2Model
< source >( config: Wav2Vec2Config )
Parâmetros
- config (Wav2Vec2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Wav2Vec2 puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonemask_time_indices: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Wav2Vec2BaseModelOutput or tuple(torch.Tensor)
Parâmetros
- input_values (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Valores em ponto flutuante da forma de onda bruta de fala de entrada. Os valores podem ser obtidos carregando um arquivo de áudio.flacou.wavem um array do tipolist[float], umnumpy.ndarrayou umtorch.Tensor, por exemplo, por meio da biblioteca torchcodec (pip install torchcodec) ou da biblioteca soundfile (pip install soundfile). Para preparar o array parainput_values, o AutoProcessor deve ser usado para padding e conversão em um tensor do tipotorch.Tensor. Consulte Wav2Vec2Processor.call() para mais detalhes. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- mask_time_indices (
torch.BoolTensorde forma(batch_size, sequence_length), opcional) — Índices para mascarar os recursos extraídos para a perda contrastiva. Quando em modo de treinamento, o modelo aprende a prever os recursos extraídos mascarados no espaço config.proj_codevector_dim.
Retorna
Wav2Vec2BaseModelOutput ou tuple(torch.Tensor)
Um Wav2Vec2BaseModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Wav2Vec2Config) e das entradas.
O método forward do Wav2Vec2Model sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.extract_features (
torch.Tensorde forma(batch_size, sequence_length, conv_dim[-1])) — Sequência de vetores de características extraídos da última camada convolucional do modelo.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Wav2Vec2ForCTC
classe transformers.Wav2Vec2ForCTC
< source >( config: Wav2Vec2Configtarget_lang: str | None = None )
Parâmetros
- config (Wav2Vec2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
- target_lang (
str, opcional) — Idioma dos pesos do adaptador. Os pesos do adaptador são armazenados no formato adapter..safetensors ou adapter. .bin. Relevante apenas ao usar uma instância de Wav2Vec2ForCTC com adaptadores. Usa ‘eng’ por padrão.
Modelo Wav2Vec2 com uma cabeça de language modeling no topo para Connectionist Temporal Classification (CTC).
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CausalLMOutput or tuple(torch.Tensor)
Parâmetros
- input_values (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Valores em ponto flutuante da forma de onda bruta de fala de entrada. Os valores podem ser obtidos carregando um arquivo de áudio.flacou.wavem um array do tipolist[float], umnumpy.ndarrayou umtorch.Tensor, por exemplo, por meio da biblioteca torchcodec (pip install torchcodec) ou da biblioteca soundfile (pip install soundfile). Para preparar o array parainput_values, o AutoProcessor deve ser usado para padding e conversão em um tensor do tipotorch.Tensor. Consulte Wav2Vec2Processor.call() para mais detalhes. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- labels (
torch.LongTensorde forma(batch_size, target_length), opcional) — Rótulos para classificação temporal conexionista. Observe quetarget_lengthdeve ser menor ou igual ao comprimento da sequência dos logits de saída. Os índices são selecionados em[-100, 0, ..., config.vocab_size - 1]. Todos os rótulos definidos como-100são ignorados (mascarados); a perda é calculada apenas para rótulos em[0, ..., config.vocab_size - 1].
Retorna
CausalLMOutput ou tuple(torch.Tensor)
Um CausalLMOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Wav2Vec2Config) e das entradas.
O método forward do Wav2Vec2ForCTC substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from transformers import AutoProcessor, Wav2Vec2ForCTC
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> processor = AutoProcessor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForCTC.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = processor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
...     logits = model(**inputs).logits
>>> predicted_ids = torch.argmax(logits, dim=-1)

>>> # transcribe speech
>>> transcription = processor.batch_decode(predicted_ids)
>>> transcription[0]
...

>>> inputs["labels"] = processor(text=dataset[0]["text"], return_tensors="pt").input_ids

>>> # compute loss
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
load_adapter
< source >( target_lang: strforce_load = True**kwargs )
Parâmetros
- target_lang (
str) — Deve ser um id de idioma de um peso de adaptador existente. Os pesos de adaptador são armazenados no formato adapter..safetensors ou adapter. .bin - force_load (
bool, padrãoTrue) — Se os pesos devem ser carregados mesmo quetarget_langcorresponda aself.target_lang. - cache_dir (
Union[str, os.PathLike], opcional) — Caminho para um diretório em que a configuração de um modelo pré-treinado baixado deve ser armazenada em cache, caso o cache padrão não deva ser usado. - force_download (
bool, opcional, padrãoFalse) — Indica se deve forçar o (re)download dos pesos do modelo e dos arquivos de configuração, sobrescrevendo as versões em cache, caso existam. - proxies (
dict[str, str], opcional) — Um dicionário de servidores proxy a serem usados por protocolo ou endpoint, por exemplo,{'http': 'foo.bar:3128', 'http://hostname': 'foo.bar:4012'}. Os proxies são usados em cada solicitação. - local_files_only(
bool, opcional, padrãoFalse) — Indica se deve procurar apenas em arquivos locais (ou seja, não tentar baixar o modelo). - token (
stroubool, opcional) — O token a ser usado como autorização bearer HTTP para arquivos remotos. SeTrue, ou não especificado, usará o token gerado ao executarhf auth login(armazenado em~/.huggingface). - revision (
str, opcional, padrão é"main") — A versão específica do modelo a ser usada. Pode ser o nome de uma branch, o nome de uma tag ou um commit id, pois usamos um sistema baseado em git para armazenar modelos e outros artefatos no huggingface.co, portantorevisionpode ser qualquer identificador permitido pelo git.Para testar um pull request que você fez no Hub, você pode passar
revision="refs/pr/<pr_number>". - mirror (
str, opcional) — Espelho de origem para acelerar downloads na China. Se você está na China e tiver problemas de acessibilidade, pode definir esta opção para resolvê-los. Observe que não garantimos a atualidade nem a segurança. Consulte o site do espelho para mais informações.
Carregue um modelo de adaptador de linguagem a partir de um modelo de adaptador pré-treinado.
Ative o modo especial “offline-mode” para usar este método em um ambiente com firewall.
Exemplos:
>>> from transformers import Wav2Vec2ForCTC, AutoProcessor

>>> ckpt = "facebook/mms-1b-all"
>>> processor = AutoProcessor.from_pretrained(ckpt)
>>> model = Wav2Vec2ForCTC.from_pretrained(ckpt, target_lang="eng")
>>> # set specific language
>>> processor.tokenizer.set_target_lang("spa")
>>> model.load_adapter("spa")
Wav2Vec2ForSequenceClassification
classe transformers.Wav2Vec2ForSequenceClassification
< source >( config: Wav2Vec2Config )
Parâmetros
- config (Wav2Vec2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo Wav2Vec2 com uma cabeça de classificação de sequência no topo (uma camada linear sobre a saída agregada) para tarefas como SUPERB Keyword Spotting.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SequenceClassifierOutput or tuple(torch.Tensor)
Parâmetros
- input_values (
torch.Tensorde forma(batch_size, sequence_length)) — Valores em ponto flutuante da forma de onda bruta de fala de entrada. Os valores podem ser obtidos carregando um arquivo de áudio.flacou.wavem um array do tipolist[float], umnumpy.ndarrayou umtorch.Tensor, por exemplo, por meio da biblioteca torchcodec (pip install torchcodec) ou da biblioteca soundfile (pip install soundfile). Para preparar o array parainput_values, o AutoProcessor deve ser usado para padding e conversão em um tensor do tipotorch.Tensor. Consulte Wav2Vec2Processor.call() para mais detalhes. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- labels (
torch.LongTensorde forma(batch_size,), opcional) — Rótulos para o cálculo da perda de classificação/regressão de sequência. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels == 1, uma perda de regressão é calculada (perda de erro quadrático médio). Seconfig.num_labels > 1, uma perda de classificação é calculada (entropia cruzada).
Retorna
SequenceClassifierOutput ou tuple(torch.Tensor)
Um SequenceClassifierOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Wav2Vec2Config) e das entradas.
O método forward de Wav2Vec2ForSequenceClassification substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1).logits (
torch.Tensorde forma(batch_size, config.num_labels)) — Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo de classificação de rótulo único:
>>> import torch
>>> from transformers import AutoTokenizer, Wav2Vec2ForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h", num_labels=num_labels)

>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
Exemplo de classificação multirótulo:
>>> import torch
>>> from transformers import AutoTokenizer, Wav2Vec2ForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h", problem_type="multi_label_classification")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained(
...     "facebook/wav2vec2-base-960h", num_labels=num_labels, problem_type="multi_label_classification"
... )

>>> labels = torch.sum(
...     torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
Wav2Vec2ForAudioFrameClassification
classe transformers.Wav2Vec2ForAudioFrameClassification
< source >( config: Wav2Vec2Config )
Parâmetros
- config (Wav2Vec2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O Modelo Wav2Vec2 com uma cabeça de classificação de quadro no topo para tarefas como Diarização de Falantes.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → TokenClassifierOutput or tuple(torch.Tensor)
Parâmetros
- input_values (
torch.Tensorde forma(batch_size, sequence_length)) — Valores em ponto flutuante da forma de onda bruta de fala de entrada. Os valores podem ser obtidos carregando um arquivo de áudio.flacou.wavem um array do tipolist[float], umnumpy.ndarrayou umtorch.Tensor, por exemplo, por meio da biblioteca torchcodec (pip install torchcodec) ou da biblioteca soundfile (pip install soundfile). Para preparar o array parainput_values, o AutoProcessor deve ser usado para padding e conversão em um tensor do tipotorch.Tensor. Consulte Wav2Vec2Processor.call() para mais detalhes. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- labels (
torch.LongTensorde forma(batch_size,), opcional) — Rótulos para o cálculo da perda de classificação/regressão de sequência. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels == 1, uma perda de regressão é calculada (perda de erro quadrático médio). Seconfig.num_labels > 1, uma perda de classificação é calculada (entropia cruzada).
Retorna
TokenClassifierOutput ou tuple(torch.Tensor)
Um TokenClassifierOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Wav2Vec2Config) e das entradas.
O método forward de Wav2Vec2ForAudioFrameClassification sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação.logits (
torch.Tensorde forma(batch_size, sequence_length, config.num_labels)) — Pontuações de classificação (antes do SoftMax).hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForAudioFrameClassification
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForAudioFrameClassification.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], return_tensors="pt", sampling_rate=sampling_rate)
>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> probabilities = torch.sigmoid(logits[0])
>>> # labels is a one-hot array of shape (num_frames, num_speakers)
>>> labels = (probabilities > 0.5).long()
>>> labels[0].tolist()
...
Wav2Vec2ForXVector
classe transformers.Wav2Vec2ForXVector
< source >( config: Wav2Vec2Config )
Parâmetros
- config (Wav2Vec2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo Wav2Vec2 com uma cabeça de extração de recursos XVector no topo para tarefas como Verificação de Falante.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → XVectorOutput or tuple(torch.Tensor)
Parâmetros
- input_values (
torch.Tensorde forma(batch_size, sequence_length)) — Valores em ponto flutuante da forma de onda bruta de fala de entrada. Os valores podem ser obtidos carregando um arquivo de áudio.flacou.wavem um array do tipolist[float], umnumpy.ndarrayou umtorch.Tensor, por exemplo, por meio da biblioteca torchcodec (pip install torchcodec) ou da biblioteca soundfile (pip install soundfile). Para preparar o array parainput_values, o AutoProcessor deve ser usado para padding e conversão em um tensor do tipotorch.Tensor. Consulte Wav2Vec2Processor.call() para mais detalhes. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- labels (
torch.LongTensorde forma(batch_size,), opcional) — Rótulos para o cálculo da perda de classificação/regressão de sequência. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels == 1, uma perda de regressão é calculada (perda de erro quadrático médio). Seconfig.num_labels > 1, uma perda de classificação é calculada (entropia cruzada).
Retorna
XVectorOutput ou tuple(torch.Tensor)
Um XVectorOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Wav2Vec2Config) e das entradas.
O método forward de Wav2Vec2ForXVector substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação.logits (
torch.Tensorde forma(batch_size, config.xvector_output_dim)) — Estados ocultos de classificação antes do AMSoftmax.embeddings (
torch.Tensorde forma(batch_size, config.xvector_output_dim)) — Embeddings de fala usados para recuperação baseada em similaridade vetorial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForXVector
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForXVector.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(
...     [d["array"] for d in dataset[:2]["audio"]], sampling_rate=sampling_rate, return_tensors="pt", padding=True
... )
>>> with torch.no_grad():
...     embeddings = model(**inputs).embeddings

>>> embeddings = torch.nn.functional.normalize(embeddings, dim=-1).cpu()

>>> # the resulting embeddings can be used for cosine similarity-based retrieval
>>> cosine_sim = torch.nn.CosineSimilarity(dim=-1)
>>> similarity = cosine_sim(embeddings[0], embeddings[1])
>>> threshold = 0.7  # the optimal threshold is dataset-dependent
>>> if similarity < threshold:
...     print("Speakers are not the same!")
>>> round(similarity.item(), 2)
...
Wav2Vec2ForPreTraining
classe transformers.Wav2Vec2ForPreTraining
< source >( config: Wav2Vec2Config )
Parâmetros
- config (Wav2Vec2Config) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo Wav2Vec2 com um quantizador e um cabeçalho VQ no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonemask_time_indices: typing.Optional[torch.BoolTensor] = Nonesampled_negative_indices: typing.Optional[torch.BoolTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Wav2Vec2ForPreTrainingOutput or tuple(torch.Tensor)
Parâmetros
- input_values (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Valores em ponto flutuante da forma de onda bruta de fala de entrada. Os valores podem ser obtidos carregando um arquivo de áudio.flacou.wavem um array do tipolist[float], umnumpy.ndarrayou umtorch.Tensor, por exemplo, por meio da biblioteca torchcodec (pip install torchcodec) ou da biblioteca soundfile (pip install soundfile). Para preparar o array parainput_values, o AutoProcessor deve ser usado para padding e conversão em um tensor do tipotorch.Tensor. Consulte Wav2Vec2Processor.call() para mais detalhes. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- mask_time_indices (
torch.BoolTensorde forma(batch_size, sequence_length), opcional) — Índices para mascarar os recursos extraídos para a perda contrastiva. Quando em modo de treinamento, o modelo aprende a prever os recursos extraídos mascarados no espaço config.proj_codevector_dim. - sampled_negative_indices (
torch.BoolTensorde forma(batch_size, sequence_length, num_negatives), opcional) — Índices que indicam quais vetores de destino quantizados são usados como vetores negativos amostrados na perda contrastiva. Entrada obrigatória para o pré-treinamento.
Retorna
Wav2Vec2ForPreTrainingOutput ou tuple(torch.Tensor)
Um Wav2Vec2ForPreTrainingOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Wav2Vec2Config) e das entradas.
O método forward de Wav2Vec2ForPreTraining sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — Perda total como a soma da perda contrastiva (L_m) e da perda de diversidade (L_d), conforme descrito no artigo oficial.projected_states (
torch.Tensorde forma(batch_size, sequence_length, config.proj_codevector_dim)) — Hidden-states do modelo projetados para config.proj_codevector_dim que podem ser usados para prever os estados quantizados mascarados projetados.projected_quantized_states (
torch.Tensorde forma(batch_size, sequence_length, config.proj_codevector_dim)) — Vetores de características extraídas quantizados e projetados para config.proj_codevector_dim, representando os vetores-alvo positivos para a perda contrastiva.codevector_perplexity (
torch.Tensorde forma(1,)) — A perplexidade da distribuição de codevector, usada para medir a diversidade do codebook.hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
contrastive_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The contrastive loss (L_m) as stated in the official paper.diversity_loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — The diversity loss (L_d) as stated in the official paper.
Exemplo:
>>> import torch
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForPreTraining
>>> from transformers.models.wav2vec2.modeling_wav2vec2 import _compute_mask_indices, _sample_negative_indices
>>> from datasets import load_dataset

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base")
>>> model = Wav2Vec2ForPreTraining.from_pretrained("facebook/wav2vec2-base")

>>> ds = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")
>>> input_values = feature_extractor(ds[0]["audio"]["array"], return_tensors="pt").input_values  # Batch size 1

>>> # compute masked indices
>>> batch_size, raw_sequence_length = input_values.shape
>>> sequence_length = model._get_feat_extract_output_lengths(raw_sequence_length).item()
>>> mask_time_indices = _compute_mask_indices(
...     shape=(batch_size, sequence_length), mask_prob=0.2, mask_length=2
... )
>>> sampled_negative_indices = _sample_negative_indices(
...     features_shape=(batch_size, sequence_length),
...     num_negatives=model.config.num_negatives,
...     mask_time_indices=mask_time_indices,
... )
>>> mask_time_indices = torch.tensor(data=mask_time_indices, device=input_values.device, dtype=torch.long)
>>> sampled_negative_indices = torch.tensor(
...     data=sampled_negative_indices, device=input_values.device, dtype=torch.long
... )

>>> with torch.no_grad():
...     outputs = model(input_values, mask_time_indices=mask_time_indices)

>>> # compute cosine similarity between predicted (=projected_states) and target (=projected_quantized_states)
>>> cosine_sim = torch.cosine_similarity(outputs.projected_states, outputs.projected_quantized_states, dim=-1)

>>> # show that cosine similarity is much higher than random
>>> cosine_sim[mask_time_indices.to(torch.bool)].mean() > 0.5
tensor(True)

>>> # for contrastive loss training model should be put into train mode
>>> model = model.train()
>>> loss = model(
...     input_values, mask_time_indices=mask_time_indices, sampled_negative_indices=sampled_negative_indices
... ).loss