
Transformers documentation
FastSpeech2Conformer
Este modelo foi publicado em HF papers em 2020-10-26 e contribuído para Hugging Face Transformers em 2024-01-03.
FastSpeech2Conformer
Visão geral
O modelo FastSpeech2Conformer foi proposto no artigo Recent Developments On Espnet Toolkit Boosted By Conformer, de Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang e Yuekai Zhang.
O resumo do artigo original FastSpeech2 é o seguinte:
Modelos de texto para fala (TTS) não autoregressivos, como o FastSpeech (Ren et al., 2019), podem sintetizar fala significativamente mais rápido do que os modelos autoregressivos anteriores, com qualidade comparável. O treinamento do modelo FastSpeech depende de um modelo professor autoregressivo para a previsão de duração (para fornecer mais informações como entrada) e de destilação de conhecimento (para simplificar a distribuição de dados na saída), o que pode aliviar o problema de mapeamento um-para-muitos (ou seja, múltiplas variações de fala correspondem ao mesmo texto) no TTS. No entanto, o FastSpeech apresenta várias desvantagens: 1) o pipeline de destilação professor-aluno é complicado e demorado, 2) a duração extraída do modelo professor não é precisa o suficiente, e os mel-espectrogramas-alvo destilados do modelo professor sofrem com perda de informação devido à simplificação dos dados, ambos os fatores limitam a qualidade da voz. Neste artigo, propomos o FastSpeech 2, que aborda os problemas do FastSpeech e resolve melhor o problema de mapeamento um-para-muitos no TTS por meio de 1) o treinamento direto do modelo com o alvo verdadeiro, em vez da saída simplificada do professor, e 2) a introdução de mais informações de variação da fala (por exemplo, pitch, energia e duração mais precisa) como entradas condicionais. Especificamente, extraímos a duração, o pitch e a energia da forma de onda da fala e os utilizamos diretamente como entradas condicionais no treinamento, usando os valores previstos na inferência. Projetamos também o FastSpeech 2s, que é a primeira tentativa de gerar diretamente a forma de onda da fala a partir do texto em paralelo, aproveitando o benefício de uma inferência totalmente de ponta a ponta. Os resultados experimentais mostram que 1) o FastSpeech 2 alcança uma aceleração de 3x no treinamento em relação ao FastSpeech, e o FastSpeech 2s desfruta de uma velocidade de inferência ainda mais rápida; 2) o FastSpeech 2 e o 2s superam o FastSpeech em qualidade de voz, e o FastSpeech 2 pode até superar os modelos autoregressivos. Amostras de áudio estão disponíveis em https://speechresearch.github.io/fastspeech2/.
Este modelo foi contribuído por Connor Henderson. O código original pode ser encontrado aqui.
🤗 Arquitetura do Modelo
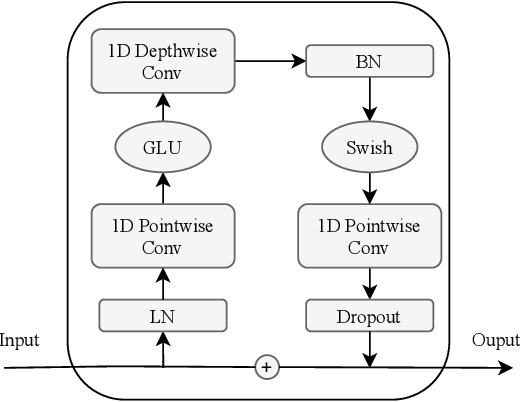
A estrutura geral do FastSpeech2 com um decodificador de Mel-espectrograma foi implementada, e os blocos de transformer tradicionais foram substituídos por blocos conformer, conforme feito na biblioteca ESPnet.
Arquitetura do Modelo FastSpeech2

Blocos Conformer

Módulo de Convolução
🤗 Uso do Transformers
Você pode executar o FastSpeech2Conformer localmente com a biblioteca 🤗 Transformers.
- Primeiro, instale a biblioteca 🤗 Transformers e o g2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Execute a inferência por meio do código de modelagem do Transformers com o modelo e o hifigan separadamente
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Execute a inferência por meio do código de modelagem do Transformers com o modelo e o hifigan combinados
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Execute inferência com um pipeline e especifique qual vocoder usar
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
classe transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
Parâmetros
- is_encoder_decoder (
bool, opcional, padrãoTrue) — Indica se o modelo é usado como encoder/decoder ou não. - hidden_size (
int, opcional, padrão384) — Dimensão das representações ocultas. - vocab_size (
int, opcional, padrão78) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - num_mel_bins (
int, opcional, padrão80) — Número de recursos mel usados por quadro de entrada. Deve corresponder ao valor usado na classeAutoFeatureExtractor. - encoder_num_attention_heads (
int, opcional, padrão 2) — O número de cabeças de atenção no encoder. - encoder_layers (
int, opcional, padrão4) — Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - encoder_linear_units (
int, opcional, padrão 1536) — O número de unidades na camada linear do codificador. - decoder_layers (
int, opcional, padrão4) — Número de camadas ocultas no decodificador do Transformer. Se não for definido, usará o mesmo valor denum_layers. - decoder_num_attention_heads (
int, opcional, padrão2) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - decoder_linear_units (
int, opcional, padrão 1536) — O número de unidades na camada linear do decodificador. - speech_decoder_postnet_layers (
int, opcional, padrão 5) — O número de camadas no post-net do decodificador de fala. - speech_decoder_postnet_units (
int, opcional, padrão 256) — O número de unidades nas camadas do post-net do decodificador de fala. - speech_decoder_postnet_kernel (
int, opcional, padrão 5) — O tamanho do kernel na pós-rede do decodificador de fala. - positionwise_conv_kernel_size (
int, opcional, padrão 3) — O tamanho do núcleo de convolução usado na camada posicional. - encoder_normalize_before (
bool, opcional, padrãoFalse) — Especifica se a normalização deve ser aplicada antes das camadas do codificador. - decoder_normalize_before (
bool, opcional, padrãoFalse) — Especifica se a normalização deve ser aplicada antes das camadas do decodificador. - encoder_concat_after (
bool, opcional, padrãoFalse) — Especifica se deve concatenar após as camadas do codificador. - decoder_concat_after (
bool, opcional, padrãoFalse) — Especifica se deve concatenar após as camadas do decodificador. - reduction_factor (
int, opcional, padrão 1) — O fator pelo qual a taxa de quadros de fala é reduzida. - speaking_speed (
float, opcional, padrão 1.0) — A velocidade da fala produzida. - use_macaron_style_in_conformer (
bool, opcional, padrãoTrue) — Especifica se deve usar o estilo macaron no conformer. - use_cnn_in_conformer (
bool, opcional, padrãoTrue) — Especifica se as redes neurais convolucionais devem ser usadas no conformer. - encoder_kernel_size (
int, opcional, padrão 7) — O tamanho do kernel usado no codificador. - decoder_kernel_size (
int, opcional, padrão 31) — O tamanho do kernel usado no decodificador. - duration_predictor_layers (
int, opcional, padrão 2) — O número de camadas no preditor de duração. - duration_predictor_channels (
int, opcional, padrão 256) — O número de canais no preditor de duração. - duration_predictor_kernel_size (
int, opcional, padrão 3) — O tamanho do kernel usado no preditor de duração. - energy_predictor_layers (
int, opcional, padrão 2) — O número de camadas no preditor de energia. - energy_predictor_channels (
int, opcional, padrão 256) — O número de canais no preditor de energia. - energy_predictor_kernel_size (
int, opcional, padrão 3) — O tamanho do kernel usado no preditor de energia. - energy_predictor_dropout (
float, opcional, padrão 0,5) — A taxa de dropout no preditor de energia. - energy_embed_kernel_size (
int, opcional, padrão 1) — O tamanho do kernel usado na camada de incorporação de energia. - energy_embed_dropout (
float, opcional, padrão 0.0) — A taxa de dropout na camada de incorporação de energia. - stop_gradient_from_energy_predictor (
bool, opcional, padrãoFalse) — Especifica se as gradientes devem ser interrompidas a partir do preditor de energia. - pitch_predictor_layers (
int, opcional, padrão 5) — O número de camadas no preditor de pitch. - pitch_predictor_channels (
int, opcional, padrão 256) — O número de canais no preditor de pitch. - pitch_predictor_kernel_size (
int, opcional, padrão 5) — O tamanho do kernel usado no preditor de pitch. - pitch_predictor_dropout (
float, opcional, padrão 0.5) — A taxa de dropout no preditor de pitch. - pitch_embed_kernel_size (
int, opcional, padrão 1) — O tamanho do kernel usado na camada de incorporação de pitch. - pitch_embed_dropout (
float, opcional, padrão 0.0) — A taxa de dropout na camada de incorporação de tom. - stop_gradient_from_pitch_predictor (
bool, opcional, padrãoTrue) — Especifica se as gradientes devem ser interrompidas a partir do preditor de pitch. - encoder_dropout_rate (
float, opcional, padrão 0,2) — A taxa de dropout no codificador. - encoder_positional_dropout_rate (
float, opcional, padrão 0.2) — A taxa de dropout posicional no encoder. - encoder_attention_dropout_rate (
float, opcional, padrão 0,2) — A taxa de dropout de atenção no codificador. - decoder_dropout_rate (
float, opcional, padrão 0.2) — A taxa de dropout no decodificador. - decoder_positional_dropout_rate (
float, opcional, padrão 0.2) — A taxa de dropout posicional no decoder. - decoder_attention_dropout_rate (
float, opcional, padrão 0.2) — A taxa de dropout de atenção no decodificador. - duration_predictor_dropout_rate (
float, opcional, padrão 0.2) — A taxa de dropout no preditor de duração. - speech_decoder_postnet_dropout (
float, opcional, padrão 0.5) — A taxa de dropout na postnet do decodificador de fala. - max_source_positions (
int, opcional, padrão 5000) — se forem usados embeddings de posição"relative", define as posições máximas de entrada da fonte. - use_masking (
bool, opcional, padrãoTrue) — Especifica se deve usar mascaramento no modelo. - use_weighted_masking (
bool, opcional, padrãoFalse) — Especifica se deve ser usado o mascaramento ponderado no modelo. - num_speakers (
int, opcional) — Número de falantes. Se definido como > 1, assume-se que os ids dos falantes serão fornecidos como entrada e usa-se a camada de incorporação de id do falante. - num_languages (
int, opcional) — Número de idiomas. Se definido como > 1, assume-se que os ids de idioma serão fornecidos como entrada e usa-se a camada de incorporação de id de idioma. - speaker_embed_dim (
int, opcional) — Dimensão do embedding de falante. Se definido para > 0, assume-se que speaker_embedding será fornecido como entrada. - convolution_bias (
bool, opcional, padrãoTrue) — Especifica se deve ser usado viés nas convoluções do módulo de convolução do conformer.
Esta é a classe de configuração para armazenar a configuração de um FastSpeech2ConformerModel. Ela é usada para instanciar um modelo Fastspeech2 Conformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do espnet/fastspeech2_conformer
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
classe transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
Parâmetros
- model_in_dim (
int, opcional, padrão 80) — O número de bins de frequência no espectrograma log-mel de entrada. - upsample_initial_channel (
int, opcional, padrão 512) — O número de canais de entrada para a rede de upsampling. - upsample_rates (
tuple[int]oulist[int], opcional, padrão[8, 8, 2, 2]) — Uma tupla de inteiros que define o stride de cada camada de convolução 1D na rede de upsampling. O tamanho de upsample_rates define o número de camadas de convolução e deve corresponder ao tamanho de upsample_kernel_sizes. - upsample_kernel_sizes (
tuple[int]oulist[int], opcional, padrão[16, 16, 4, 4]) — Uma tupla de inteiros que define o tamanho do kernel de cada camada convolucional 1D na rede de upsampling. O tamanho de upsample_kernel_sizes define o número de camadas convolucionais e deve corresponder ao tamanho de upsample_rates. - resblock_kernel_sizes (
tuple[int]oulist[int], opcional, padrão[3, 7, 11]) — Uma tupla de inteiros que define os tamanhos dos kernels das camadas convolucionais 1D no módulo de fusão de múltiplos campos receptivos (MRF). - resblock_dilation_sizes (
tuple[tuple[int]]oulist[list[int]], opcional, padrão[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — Uma tupla aninhada de inteiros que define as taxas de dilatação das camadas de convolução 1D dilataadas no módulo de fusão de múltiplos campos receptivos (MRF). - initializer_range (
float, opcional, padrão0.01) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - leaky_relu_slope (
float, opcional, padrão 0.1) — O ângulo da inclinação negativa usada pela função de ativação leaky ReLU. - normalize_before (
bool, opcional, padrãoTrue) — Indica se a espectrograma deve ser normalizada antes da vocodificação, utilizando a média e a variância aprendidas pelo vocoder.
Esta é a classe de configuração para armazenar a configuração de um FastSpeech2ConformerModel. Ela é usada para instanciar um modelo Fastspeech2 Conformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do espnet/fastspeech2_conformer_with_hifigan
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
classe transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Esta é a classe de configuração para armazenar a configuração de um FastSpeech2ConformerModel. Ela é usada para instanciar um modelo Fastspeech2 Conformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do espnet/fastspeech2_conformer_with_hifigan
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
classe transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
Parâmetros
- vocab_file (
str) — Caminho para o arquivo de vocabulário. - bos_token (
str, opcional, padrão"<sos/eos>") — O token de início de sequência. Observe que, para o FastSpeech2, ele é o mesmo que oeos_token. - eos_token (
str, opcional, padrão"<sos/eos>") — O token de fim de sequência. Observe que, para o FastSpeech2, ele é o mesmo que obos_token. - pad_token (
str, opcional, padrão"<blank>") — O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes. - unk_token (
str, opcional, padrão"<unk>") — O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso. - should_strip_spaces (
bool, opcional, padrãoFalse) — Se deve ou não remover os espaços da lista de tokens.
Construa um tokenizer FastSpeech2Conformer.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Parâmetros
- text (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se as sequências forem fornecidas como lista de strings (pré-tokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - text_pair (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pré-tokenizada). Se as sequências forem fornecidas como lista de strings (pré-tokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - text_target (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a serem codificadas como textos de destino. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - text_pair_target (
str,list[str],list[list[str]], opcional) — A sequência ou lote de sequências a ser codificada como textos de destino. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definiris_split_into_words=True(para eliminar a ambiguidade com um lote de sequências). - tokenizer_kwargs (
dict[str, Any], opcional) — Kwargs adicionais para passar ao tokenizer. Eles serão mesclados com os parâmetros explícitos e outros kwargs, com os parâmetros explícitos tendo precedência. - add_special_tokens (
bool, opcional, padrãoTrue) — Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacentePretrainedTokenizerBase.build_inputs_with_special_tokens, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar tokensbosoueosautomaticamente. - padding (
bool,strou PaddingStrategy, opcional, padrão éFalse) — Ativa e controla o padding. Aceita os seguintes valores:Trueou'longest': Preenche até a sequência mais longa do lote (ou não aplica preenchimento se apenas uma sequência for fornecida).'max_length': Preenche até o comprimento máximo especificado com o argumentomax_lengthou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido.Falseou'do_not_pad'(padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
- truncation (
bool,strou TruncationStrategy, opcional, padrão éFalse) — Ativa e controla a truncagem. Aceita os seguintes valores:Trueou'longest_first': Trunca para um comprimento máximo especificado com o argumentomax_lengthou para o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido.'only_first': Trunca para o comprimento máximo especificado com o argumentomax_lengthou para o comprimento máximo aceitável de entrada do modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.'only_second': Trunca para um comprimento máximo especificado com o argumentomax_lengthou para o comprimento máximo aceitável de entrada do modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.Falseou'do_not_truncate'(padrão): Sem truncamento (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada aceitável pelo modelo).
- max_length (
int, opcional) — Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/preenchimento.Se não for definido ou for definido como
None, isso usará o comprimento máximo predefinido do modelo, caso um dos parâmetros de truncamento/preenchimento exija um comprimento máximo. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/preenchimento para um comprimento máximo será desativado. - stride (
int, opcional, padrão 0) — Se definido como um número junto commax_length, os tokens excedentes retornados quandoreturn_overflowing_tokens=Trueconterão alguns tokens do final da sequência truncada retornada para fornecer alguma sobreposição entre as sequências truncadas e excedentes. O valor deste argumento define o número de tokens sobrepostos. - is_split_into_words (
bool, opcional, padrãoFalse) — Indica se a entrada já está pré-tokenizada (por exemplo, dividida em palavras). Se definido comoTrue, o tokenizer assume que a entrada já foi dividida em palavras (por exemplo, separando por espaços em branco) e a tokeniza. Isso é útil para NER ou classificação de tokens. - pad_to_multiple_of (
int, opcional) — Se definido, a sequência será preenchida até um múltiplo do valor fornecido. Exige quepaddingesteja ativado. Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação>= 7.5(Volta). - padding_side (
str, opcional) — O lado em que o modelo deve ter o padding aplicado. Deve ser selecionado entre [‘right’, ‘left’]. O valor padrão é obtido do atributo de classe com o mesmo nome. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors em vez de uma lista de inteiros do Python. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo Numpy.
- return_token_type_ids (
bool, opcional) — Se deve retornar os IDs de tipo de token. Se mantido o valor padrão, retornará os IDs de tipo de token de acordo com o padrão do tokenizer específico, definido peloreturn_outputsatributo. - return_attention_mask (
bool, opcional) — Se deve retornar a attention mask. Se mantido o valor padrão, a attention mask será retornada de acordo com o padrão do tokenizer específico, definido pelo atributoreturn_outputs. - return_overflowing_tokens (
bool, opcional, padrãoFalse) — Indica se as sequências de tokens excedentes devem ser retornadas. Se um par de sequências de ids de entrada (ou um lote de pares) for fornecido comtruncation_strategy = longest_firstouTrue, um erro será lançado em vez de retornar os tokens excedentes. - return_special_tokens_mask (
bool, opcional, padrãoFalse) — Indica se a máscara de tokens especiais deve ser retornada. - return_offsets_mapping (
bool, opcional, padrão éFalse) — Se deve ou não retornar(char_start, char_end)para cada token.Isso está disponível apenas em tokenizadores rápidos que herdam de PreTrainedTokenizerFast; se estiver usando o tokenizador em Python, este método lançará
NotImplementedError. - return_length (
bool, opcional, padrãoFalse) — Indica se as comprimentos das entradas codificadas devem ser retornados. - verbose (
bool, opcional, padrãoTrue) — Se deve ou não exibir mais informações e avisos. - **kwargs — passados para o método
self.tokenize()
Retorna
Um BatchEncoding com os seguintes campos:
-
input_ids — Lista de ids de tokens a serem fornecidos a um modelo.
-
token_type_ids — Lista de ids de tipo de token a serem fornecidos a um modelo (quando
return_token_type_ids=Trueou se “token_type_ids” estiver emself.model_input_names). -
attention_mask — Lista de índices que especifica quais tokens devem ser considerados pelo modelo (quando
return_attention_mask=Trueou se “attention_mask” estiver emself.model_input_names). -
overflowing_tokens — Lista de sequências de tokens excedentes (quando um
max_lengthé especificado ereturn_overflowing_tokens=True). -
num_truncated_tokens — Número de tokens truncados (quando um
max_lengthé especificado ereturn_overflowing_tokens=True). -
special_tokens_mask — Lista de 0s e 1s, em que 1 especifica tokens especiais adicionados e 0 especifica tokens regulares da sequência (quando
add_special_tokens=Trueereturn_special_tokens_mask=True). -
length — O comprimento das entradas (quando
return_length=True)
Método principal para tokenizar e preparar uma ou várias sequências ou um ou vários pares de sequências para o modelo.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
Salve o arquivo de vocabulário e tokens especiais em um diretório.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
Parâmetros
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Lista de ids de entrada tokenizados. Pode ser obtida usando o método__call__. - skip_special_tokens (
bool, opcional, padrãoFalse) — Indica se os tokens especiais devem ser removidos durante a decodificação. - clean_up_tokenization_spaces (
bool, opcional) — Indica se os espaços de tokenização devem ser limpos. Se forNone, o valor padrão seráself.clean_up_tokenization_spaces. - kwargs (argumentos de palavra-chave adicionais, opcional) — Serão passados para o método de decodificação específico do modelo subjacente.
Retorna
list[str]
A lista de frases decodificadas.
Converta uma lista de listas de ids de tokens em uma lista de strings chamando decode.
Este método é fornecido para compatibilidade reversa. O método decode agora processa entradas em lote nativamente,
então você pode usar decode diretamente em vez de batch_decode.
FastSpeech2ConformerModel
classe transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
Parâmetros
- config (FastSpeech2ConformerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo FastSpeech2Conformer.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length)) — Sequência de entrada de vetores de texto. - attention_mask (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- spectrogram_labels (
torch.Tensorde forma(batch_size, max_spectrogram_length, num_mel_bins), opcional, padrãoNone) — Lote de recursos de destino com preenchimento. - duration_labels (
torch.LongTensorde forma(batch_size, sequence_length + 1), opcional, padrãoNone) — Lote de durações com preenchimento. - pitch_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, padrãoNone) — Lote de pitch médio por token, com preenchimento. - energy_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, padrãoNone) — Lote de energia média por token, com preenchimento. - speaker_ids (
torch.LongTensorde forma(batch_size, 1), opcional, padrãoNone) — IDs de falante usados para condicionar os recursos da saída de fala pelo modelo. - lang_ids (
torch.LongTensorde forma(batch_size, 1), opcional, padrãoNone) — Ids de idioma usados para condicionar os recursos da saída de fala pelo modelo. - speaker_embedding (
torch.Tensorde forma(batch_size, embedding_dim), opcional, padrãoNone) — Embedding contendo sinais de condicionamento para os recursos da fala. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes.
Retorna
FastSpeech2ConformerModelOutput ou tuple(torch.Tensor)
Um FastSpeech2ConformerModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (FastSpeech2ConformerConfig) e das entradas.
O método forward do FastSpeech2ConformerModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de geração de espectrograma.espectrograma (
torch.Tensorde forma(batch_size, sequence_length, num_bins), opcional) — O espectrograma previsto.encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
encoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
decoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
decoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
duration_outputs (
torch.LongTensorde forma(batch_size, max_text_length + 1), opcional) — Saídas do preditor de duração.pitch_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Saídas do preditor de pitch.energy_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Saídas do preditor de energia.
Exemplo:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
classe transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
Parâmetros
- config (FastSpeech2ConformerHifiGanConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Vocoder HiFi-GAN.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
Parâmetros
- spectrogram (
torch.Tensor) — Tensor contendo os espectrogramas log-mel. Pode ser em lote, com forma(batch_size, sequence_length, config.model_in_dim), ou sem lote, com forma(sequence_length, config.model_in_dim).
Retorna
torch.Tensor
Tensor contendo a forma de onda da fala. Se o espectrograma de entrada estiver em lote, terá a forma (batch_size, num_frames,). Se não estiver em lote, terá a forma (num_frames,).
Converte um espectrograma log-mel em uma forma de onda de fala. Ao passar um lote de espectrogramas log-mel, retorna um lote de formas de onda de fala. Ao passar um único espectrograma log-mel, sem lote, retorna uma única forma de onda de fala, sem lote.
FastSpeech2ConformerWithHifiGan
classe transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
Parâmetros
- config (FastSpeech2ConformerWithHifiGanConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O FastSpeech2ConformerModel com uma cabeça de vocoder FastSpeech2ConformerHifiGan que executa a conversão de texto em fala (forma de onda).
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length)) — Sequência de entrada de vetores de texto. - attention_mask (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- spectrogram_labels (
torch.Tensorde forma(batch_size, max_spectrogram_length, num_mel_bins), opcional, padrãoNone) — Lote de recursos de destino com preenchimento. - duration_labels (
torch.LongTensorde forma(batch_size, sequence_length + 1), opcional, padrãoNone) — Lote de durações com preenchimento. - pitch_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, padrãoNone) — Lote de pitch médio por token, com preenchimento. - energy_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, padrãoNone) — Lote de energia média por token, com preenchimento. - speaker_ids (
torch.LongTensorde forma(batch_size, 1), opcional, padrãoNone) — IDs de falante usados para condicionar os recursos da saída de fala pelo modelo. - lang_ids (
torch.LongTensorde forma(batch_size, 1), opcional, padrãoNone) — Ids de idioma usados para condicionar os recursos da saída de fala pelo modelo. - speaker_embedding (
torch.Tensorde forma(batch_size, embedding_dim), opcional, padrãoNone) — Embedding contendo sinais de condicionamento para os recursos da fala. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes.
Retorna
FastSpeech2ConformerModelOutput ou tuple(torch.Tensor)
Um FastSpeech2ConformerModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (FastSpeech2ConformerConfig) e das entradas.
O método forward de FastSpeech2ConformerWithHifiGan substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de geração de espectrograma.espectrograma (
torch.Tensorde forma(batch_size, sequence_length, num_bins), opcional) — O espectrograma previsto.encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Sequência de estados ocultos na saída da última camada do codificador do modelo.encoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
encoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
decoder_hidden_states (
tuple[torch.Tensor], opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
decoder_attentions (
tuple[torch.Tensor], opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
duration_outputs (
torch.LongTensorde forma(batch_size, max_text_length + 1), opcional) — Saídas do preditor de duração.pitch_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Saídas do preditor de pitch.energy_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Saídas do preditor de energia.
Exemplo:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])