
Transformers documentation
Resposta a perguntas sobre documentos
Resposta a perguntas sobre documentos
Document Question Answering, também referido como Document Visual Question Answering, é uma tarefa que envolve fornecer respostas a perguntas feitas sobre imagens de documentos. A entrada para modelos que suportam essa tarefa é tipicamente uma combinação de uma imagem e uma pergunta, e a saída é uma resposta expressa em linguagem natural. Esses modelos utilizam múltiplas modalidades, incluindo texto, as posições das palavras (bounding boxes) e a própria imagem.
Este guia ilustra como:
- Ajuste fino de LayoutLMv2 no conjunto de dados DocVQA.
- Use seu modelo ajustado para inferência.
Para ver todas as arquiteturas e checkpoints compatíveis com esta tarefa, recomendamos consultar a página da tarefa
O LayoutLMv2 resolve a tarefa de question answering em documentos adicionando um cabeçalho de question answering sobre os estados ocultos finais dos tokens, para prever as posições dos tokens de início e fim da resposta. Em outras palavras, o problema é tratado como question answering extrativo: dado o contexto, extrai-se qual trecho de informação responde à pergunta. O contexto vem da saída de um mecanismo de OCR, aqui o Tesseract da Google.
Antes de começar, verifique se todas as bibliotecas necessárias estão instaladas. O LayoutLMv2 depende de detectron2, torchvision e tesseract.
pip install -q transformers datasets
pip install 'git+https://github.com/facebookresearch/detectron2.git'
pip install torchvisionsudo apt install tesseract-ocr
pip install -q pytesseractDepois de instalar todas as dependências, reinicie seu runtime.
Incentivamos você a compartilhar seu modelo com a comunidade. Faça login na sua conta do Hugging Face para enviá-lo ao 🤗 Hub. Quando solicitado, insira seu token para fazer login:
>>> from huggingface_hub import notebook_login

>>> notebook_login()
Vamos definir algumas variáveis globais.
>>> model_checkpoint = "microsoft/layoutlmv2-base-uncased"
>>> batch_size = 4
Carregar os dados
Neste guia, usamos uma pequena amostra do DocVQA pré-processado, que você pode encontrar no 🤗 Hub. Se você quiser usar o conjunto de dados completo do DocVQA, pode se registrar e baixá-lo na página inicial do DocVQA. Se fizer isso, para continuar com este guia, consulte como carregar arquivos em um conjunto de dados do 🤗.
>>> from datasets import load_dataset

>>> dataset = load_dataset("nielsr/docvqa_1200_examples")
>>> dataset
DatasetDict({
    train: Dataset({
        features: ['id', 'image', 'query', 'answers', 'words', 'bounding_boxes', 'answer'],
        num_rows: 1000
    })
    test: Dataset({
        features: ['id', 'image', 'query', 'answers', 'words', 'bounding_boxes', 'answer'],
        num_rows: 200
    })
})
Como você pode ver, o conjunto de dados já está dividido em conjuntos de treinamento e teste. Dê uma olhada em um exemplo aleatório para se familiarizar com os recursos.
>>> dataset["train"].featuresAqui está o que cada campo individual representa:
id: o id do exemploimage: um objeto PIL.Image.Image contendo a imagem do documentoquery: a string da pergunta - a pergunta feita em linguagem natural, em vários idiomasanswers: uma lista de respostas corretas fornecidas por anotadores humanoswordsebounding_boxes: os resultados do OCR, que não usaremos aquianswer: uma resposta correspondida por um modelo diferente, que não será usada aqui
Vamos deixar apenas as perguntas em inglês e descartar o recurso answer, que parece conter previsões de outro modelo.
Também vamos pegar a primeira das respostas do conjunto fornecido pelos anotadores. Alternativamente, você pode amostrá-la aleatoriamente.
>>> updated_dataset = dataset.map(lambda example: {"question": example["query"]["en"]}, remove_columns=["query"])
>>> updated_dataset = updated_dataset.map(
...     lambda example: {"answer": example["answers"][0]}, remove_columns=["answer", "answers"]
... )
Observe que o checkpoint do LayoutLMv2 utilizado neste guia foi treinado com max_position_embeddings = 512 (essa informação pode ser encontrada no arquivo config.json do checkpoint).
Podemos truncar os exemplos, mas para evitar a situação em que a resposta esteja no final de um documento grande e acabe sendo truncada,
aqui removeremos os poucos exemplos em que o embedding provavelmente ficará com mais de 512 tokens.
Se a maioria dos documentos no seu conjunto de dados for longa, você pode implementar uma estratégia de janela deslizante - confira este notebook para mais detalhes.
>>> updated_dataset = updated_dataset.filter(lambda x: len(x["words"]) + len(x["question"].split()) < 512)Neste ponto, vamos também remover os recursos de OCR deste conjunto de dados. Esses recursos são resultado de OCR para ajuste fino de um modelo diferente. Ainda exigiriam algum processamento se quiséssemos usá-los, pois não atendem aos requisitos de entrada do modelo utilizado neste guia. Em vez disso, podemos usar o LayoutLMv2Processor nos dados originais para ambos, OCR e tokenização. Dessa forma, obteremos as entradas que correspondem à entrada esperada pelo modelo. Se você quiser processar imagens manualmente, consulte a documentação do modelo LayoutLMv2 para saber qual formato de entrada o modelo espera.
>>> updated_dataset = updated_dataset.remove_columns("words")
>>> updated_dataset = updated_dataset.remove_columns("bounding_boxes")
Por fim, a exploração dos dados não estará completa se não formos dar uma olhada em um exemplo de imagem.
>>> updated_dataset["train"][11]["image"]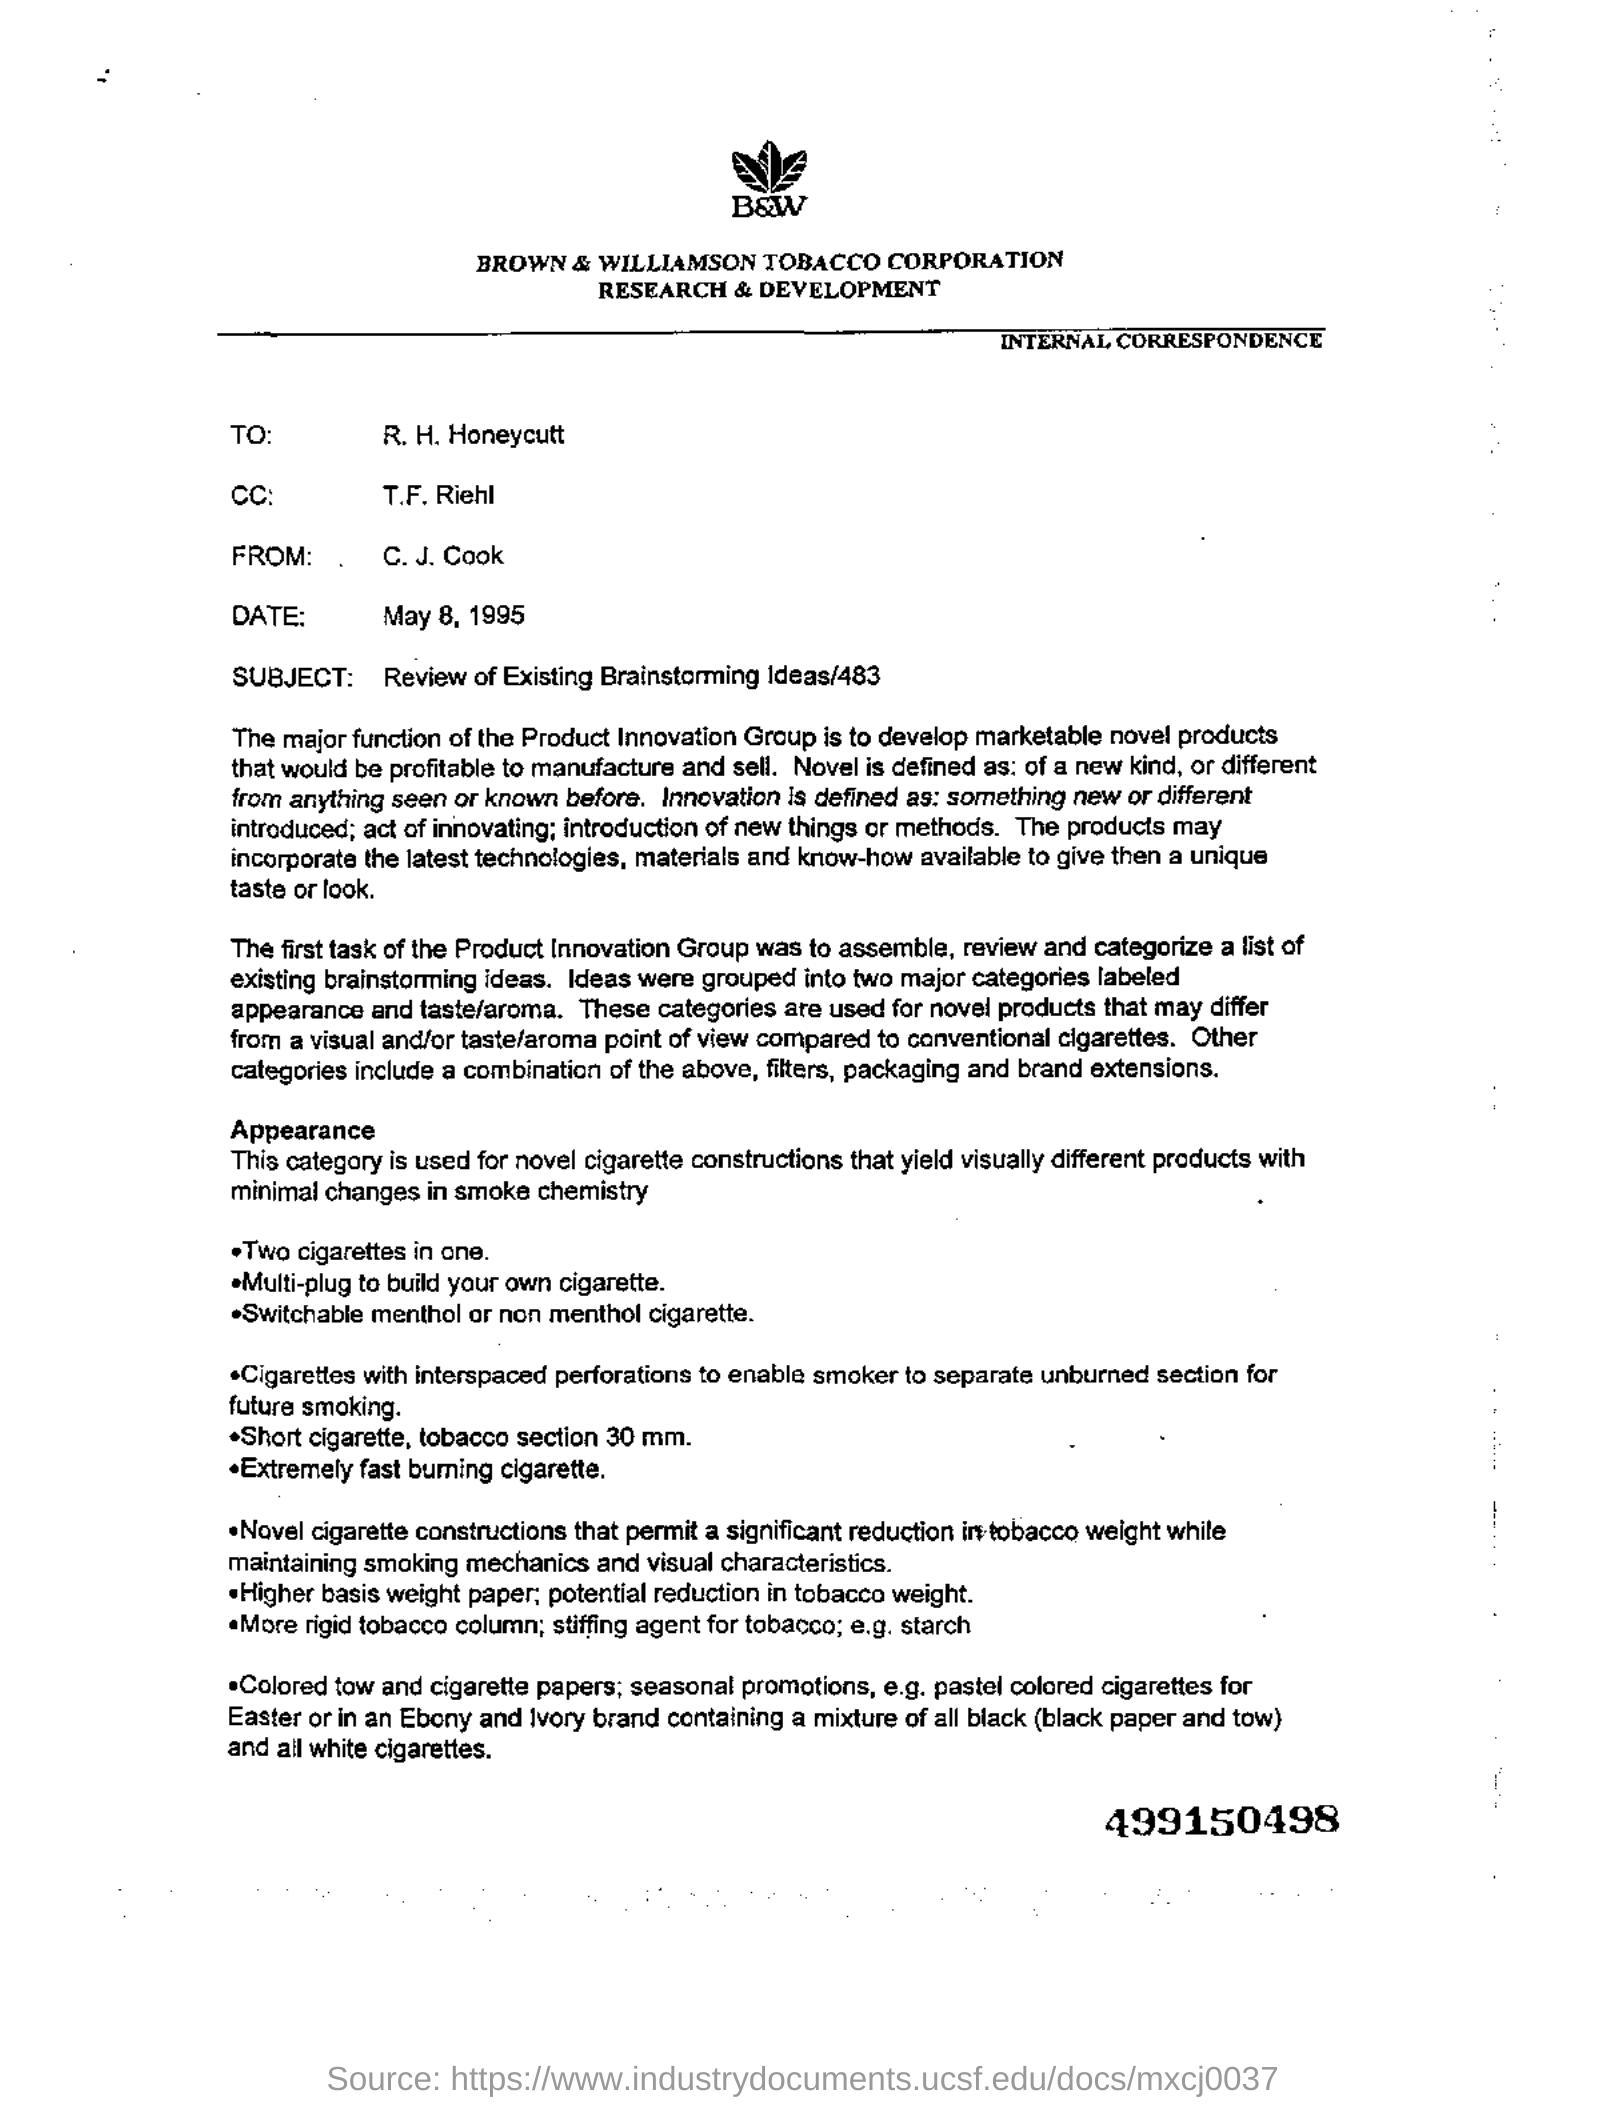
Pré-processar os dados
A tarefa de Document Question Answering é uma tarefa multimodal, e você precisa garantir que as entradas de cada modalidade sejam pré-processadas de acordo com as expectativas do modelo. Vamos começar carregando o LayoutLMv2Processor, que internamente combina um processador de imagens capaz de lidar com dados de imagem e um tokenizer capaz de codificar dados de texto.
>>> from transformers import AutoProcessor

>>> processor = AutoProcessor.from_pretrained(model_checkpoint)
Pré-processamento de imagens de documentos
Primeiro, vamos preparar as imagens dos documentos para o modelo com a ajuda do image_processor do processor.
Por padrão, o image processor redimensiona as imagens para 224x224, garante que elas tenham a ordem correta dos canais de cor,
aplica OCR com tesseract para obter palavras e caixas delimitadoras normalizadas. Neste tutorial, todos esses padrões são exatamente o que precisamos.
Escreva uma função que aplica o processamento de imagem padrão a um lote de imagens e retorna os resultados do OCR.
>>> image_processor = processor.image_processor


>>> def get_ocr_words_and_boxes(examples):
...     images = [image.convert("RGB") for image in examples["image"]]
...     encoded_inputs = image_processor(images)

...     examples["image"] = encoded_inputs.pixel_values
...     examples["words"] = encoded_inputs.words
...     examples["boxes"] = encoded_inputs.boxes

...     return examples
Para aplicar esse pré-processamento a todo o conjunto de dados de forma rápida, use map.
>>> dataset_with_ocr = updated_dataset.map(get_ocr_words_and_boxes, batched=True, batch_size=2)Pré-processamento de dados de texto
Depois de aplicar OCR às imagens, precisamos codificar a parte de texto do conjunto de dados para prepará-lo para o modelo.
Isso envolve converter as palavras e as caixas obtidas na etapa anterior em input_ids, attention_mask, token_type_ids e bbox no nível de tokens. Para o pré-processamento do texto, precisaremos do tokenizer do processador.
>>> tokenizer = processor.tokenizerAlém do pré-processamento mencionado acima, também precisamos adicionar os rótulos para o modelo. Para os modelos xxxForQuestionAnswering
no 🤗 Transformers, os rótulos consistem em start_positions e end_positions, indicando qual token está no
início e qual token está no fim da resposta.
Vamos começar por aí. Defina uma função auxiliar que pode encontrar uma sublista (a resposta dividida em palavras) em uma lista maior (a lista de palavras).
This function will take two lists as input, words_list and answer_list. It will then iterate over the words_list and check
if the current word in the words_list (words_list[i]) is equal to the first word of answer_list (answer_list[0]) and if
the sublist of words_list starting from the current word and of the same length as answer_list is equal to answer_list.
If this condition is true, it means that a match has been found, and the function will record the match, its starting index (idx),
and its ending index (idx + len(answer_list) - 1). If more than one match was found, the function will return only the first one.
If no match is found, the function returns (None, 0, and 0).
>>> def subfinder(words_list, answer_list):
...     matches = []
...     start_indices = []
...     end_indices = []
...     for idx, i in enumerate(range(len(words_list))):
...         if words_list[i] == answer_list[0] and words_list[i : i + len(answer_list)] == answer_list:
...             matches.append(answer_list)
...             start_indices.append(idx)
...             end_indices.append(idx + len(answer_list) - 1)
...     if matches:
...         return matches[0], start_indices[0], end_indices[0]
...     else:
...         return None, 0, 0
Para ilustrar como essa função encontra a posição da resposta, vamos usá-la em um exemplo:
>>> example = dataset_with_ocr["train"][1]
>>> words = [word.lower() for word in example["words"]]
>>> match, word_idx_start, word_idx_end = subfinder(words, example["answer"].lower().split())
>>> print("Question: ", example["question"])
>>> print("Words:", words)
>>> print("Answer: ", example["answer"])
>>> print("start_index", word_idx_start)
>>> print("end_index", word_idx_end)
Question:  Who is in  cc in this letter?
Words: ['wie', 'baw', 'brown', '&', 'williamson', 'tobacco', 'corporation', 'research', '&', 'development', 'internal', 'correspondence', 'to:', 'r.', 'h.', 'honeycutt', 'ce:', 't.f.', 'riehl', 'from:', '.', 'c.j.', 'cook', 'date:', 'may', '8,', '1995', 'subject:', 'review', 'of', 'existing', 'brainstorming', 'ideas/483', 'the', 'major', 'function', 'of', 'the', 'product', 'innovation', 'graup', 'is', 'to', 'develop', 'marketable', 'nove!', 'products', 'that', 'would', 'be', 'profitable', 'to', 'manufacture', 'and', 'sell.', 'novel', 'is', 'defined', 'as:', 'of', 'a', 'new', 'kind,', 'or', 'different', 'from', 'anything', 'seen', 'or', 'known', 'before.', 'innovation', 'is', 'defined', 'as:', 'something', 'new', 'or', 'different', 'introduced;', 'act', 'of', 'innovating;', 'introduction', 'of', 'new', 'things', 'or', 'methods.', 'the', 'products', 'may', 'incorporate', 'the', 'latest', 'technologies,', 'materials', 'and', 'know-how', 'available', 'to', 'give', 'then', 'a', 'unique', 'taste', 'or', 'look.', 'the', 'first', 'task', 'of', 'the', 'product', 'innovation', 'group', 'was', 'to', 'assemble,', 'review', 'and', 'categorize', 'a', 'list', 'of', 'existing', 'brainstorming', 'ideas.', 'ideas', 'were', 'grouped', 'into', 'two', 'major', 'categories', 'labeled', 'appearance', 'and', 'taste/aroma.', 'these', 'categories', 'are', 'used', 'for', 'novel', 'products', 'that', 'may', 'differ', 'from', 'a', 'visual', 'and/or', 'taste/aroma', 'point', 'of', 'view', 'compared', 'to', 'canventional', 'cigarettes.', 'other', 'categories', 'include', 'a', 'combination', 'of', 'the', 'above,', 'filters,', 'packaging', 'and', 'brand', 'extensions.', 'appearance', 'this', 'category', 'is', 'used', 'for', 'novel', 'cigarette', 'constructions', 'that', 'yield', 'visually', 'different', 'products', 'with', 'minimal', 'changes', 'in', 'smoke', 'chemistry', 'two', 'cigarettes', 'in', 'cne.', 'emulti-plug', 'te', 'build', 'yaur', 'awn', 'cigarette.', 'eswitchable', 'menthol', 'or', 'non', 'menthol', 'cigarette.', '*cigarettes', 'with', 'interspaced', 'perforations', 'to', 'enable', 'smoker', 'to', 'separate', 'unburned', 'section', 'for', 'future', 'smoking.', '«short', 'cigarette,', 'tobacco', 'section', '30', 'mm.', '«extremely', 'fast', 'buming', 'cigarette.', '«novel', 'cigarette', 'constructions', 'that', 'permit', 'a', 'significant', 'reduction', 'iretobacco', 'weight', 'while', 'maintaining', 'smoking', 'mechanics', 'and', 'visual', 'characteristics.', 'higher', 'basis', 'weight', 'paper:', 'potential', 'reduction', 'in', 'tobacco', 'weight.', '«more', 'rigid', 'tobacco', 'column;', 'stiffing', 'agent', 'for', 'tobacco;', 'e.g.', 'starch', '*colored', 'tow', 'and', 'cigarette', 'papers;', 'seasonal', 'promotions,', 'e.g.', 'pastel', 'colored', 'cigarettes', 'for', 'easter', 'or', 'in', 'an', 'ebony', 'and', 'ivory', 'brand', 'containing', 'a', 'mixture', 'of', 'all', 'black', '(black', 'paper', 'and', 'tow)', 'and', 'ail', 'white', 'cigarettes.', '499150498']
Answer:  T.F. Riehl
start_index 17
end_index 18
No entanto, uma vez que os exemplos são codificados, eles terão a seguinte aparência:
>>> encoding = tokenizer(example["question"], example["words"], example["boxes"])
>>> tokenizer.decode(encoding["input_ids"])
[CLS] who is in cc in this letter? [SEP] wie baw brown & williamson tobacco corporation research & development ...
Precisaremos encontrar a posição da resposta na entrada codificada.
token_type_idsnos informa quais tokens fazem parte da pergunta e quais fazem parte das palavras do documento.tokenizer.cls_token_idajudará a encontrar o token especial no início da entrada.word_idsajudará a corresponder a resposta encontrada nowordsoriginal à mesma resposta na entrada codificada completa e a determinar a posição de início/fim da resposta na entrada codificada.
Com isso em mente, vamos criar uma função para codificar um lote de exemplos no conjunto de dados:
>>> def encode_dataset(examples, max_length=512):
...     questions = examples["question"]
...     words = examples["words"]
...     boxes = examples["boxes"]
...     answers = examples["answer"]

...     # encode the batch of examples and initialize the start_positions and end_positions
...     encoding = tokenizer(questions, words, boxes, max_length=max_length, padding="max_length", truncation=True)
...     start_positions = []
...     end_positions = []

...     # loop through the examples in the batch
...     for i in range(len(questions)):
...         cls_index = encoding["input_ids"][i].index(tokenizer.cls_token_id)

...         # find the position of the answer in example's words
...         words_example = [word.lower() for word in words[i]]
...         answer = answers[i]
...         match, word_idx_start, word_idx_end = subfinder(words_example, answer.lower().split())

...         if match:
...             # if match is found, use `token_type_ids` to find where words start in the encoding
...             token_type_ids = encoding["token_type_ids"][i]
...             token_start_index = 0
...             while token_type_ids[token_start_index] != 1:
...                 token_start_index += 1

...             token_end_index = len(encoding["input_ids"][i]) - 1
...             while token_type_ids[token_end_index] != 1:
...                 token_end_index -= 1

...             word_ids = encoding.word_ids(i)[token_start_index : token_end_index + 1]
...             start_position = cls_index
...             end_position = cls_index

...             # loop over word_ids and increase `token_start_index` until it matches the answer position in words
...             # once it matches, save the `token_start_index` as the `start_position` of the answer in the encoding
...             for id in word_ids:
...                 if id == word_idx_start:
...                     start_position = token_start_index
...                 else:
...                     token_start_index += 1

...             # similarly loop over `word_ids` starting from the end to find the `end_position` of the answer
...             for id in word_ids[::-1]:
...                 if id == word_idx_end:
...                     end_position = token_end_index
...                 else:
...                     token_end_index -= 1

...             start_positions.append(start_position)
...             end_positions.append(end_position)

...         else:
...             start_positions.append(cls_index)
...             end_positions.append(cls_index)

...     encoding["image"] = examples["image"]
...     encoding["start_positions"] = start_positions
...     encoding["end_positions"] = end_positions

...     return encoding
Agora que temos essa função de pré-processamento, podemos codificar o conjunto de dados inteiro:
>>> encoded_train_dataset = dataset_with_ocr["train"].map(
...     encode_dataset, batched=True, batch_size=2, remove_columns=dataset_with_ocr["train"].column_names
... )
>>> encoded_test_dataset = dataset_with_ocr["test"].map(
...     encode_dataset, batched=True, batch_size=2, remove_columns=dataset_with_ocr["test"].column_names
... )
Vamos verificar como são as características do conjunto de dados codificado:
>>> encoded_train_dataset.features
{'image': Sequence(feature=Sequence(feature=Sequence(feature=Value(dtype='uint8', id=None), length=-1, id=None), length=-1, id=None), length=-1, id=None),
 'input_ids': Sequence(feature=Value(dtype='int32', id=None), length=-1, id=None),
 'token_type_ids': Sequence(feature=Value(dtype='int8', id=None), length=-1, id=None),
 'attention_mask': Sequence(feature=Value(dtype='int8', id=None), length=-1, id=None),
 'bbox': Sequence(feature=Sequence(feature=Value(dtype='int64', id=None), length=-1, id=None), length=-1, id=None),
 'start_positions': Value(dtype='int64', id=None),
 'end_positions': Value(dtype='int64', id=None)}
Avaliação
A avaliação para question answering de documentos requer uma quantidade significativa de pós-processamento. Para não tomar muito do seu tempo, este guia omite a etapa de avaliação. O Trainer ainda calcula a perda de avaliação durante o treinamento, para que você não fique completamente no escuro sobre o desempenho do seu modelo. O question answering extrativo é tipicamente avaliado usando F1/exact match. Se você quiser implementá-lo por conta própria, confira o capítulo de Question Answering do curso da Hugging Face para se inspirar.
Treinar
Parabéns! Você superou com sucesso a parte mais desafiadora deste guia e agora está pronto para treinar seu próprio modelo. O treinamento envolve as seguintes etapas:
- Carregue o modelo com AutoModelForDocumentQuestionAnswering usando o mesmo checkpoint do pré-processamento.
- Defina os hiperparâmetros de treinamento em TrainingArguments.
- Defina uma função para agrupar exemplos em lotes; aqui, o DefaultDataCollator será suficiente.
- Passe os argumentos de treinamento para o Trainer junto com o modelo, o conjunto de dados e o data collator.
- Chame train() para fazer o ajuste fino do seu modelo.
>>> from transformers import AutoModelForDocumentQuestionAnswering

>>> model = AutoModelForDocumentQuestionAnswering.from_pretrained(model_checkpoint)
No TrainingArguments, use output_dir para especificar onde salvar seu modelo e configure os hiperparâmetros conforme preferir.
Se você deseja compartilhar seu modelo com a comunidade, defina push_to_hub como True (você deve estar conectado ao Hugging Face para enviar seu modelo).
Nesse caso, o output_dir também será o nome do repositório para onde o checkpoint do seu modelo será enviado.
>>> from transformers import TrainingArguments

>>> # REPLACE THIS WITH YOUR REPO ID
>>> repo_id = "MariaK/layoutlmv2-base-uncased_finetuned_docvqa"

>>> training_args = TrainingArguments(
...     output_dir=repo_id,
...     per_device_train_batch_size=4,
...     num_train_epochs=20,
...     save_steps=200,
...     logging_steps=50,
...     eval_strategy="steps",
...     learning_rate=5e-5,
...     save_total_limit=2,
...     remove_unused_columns=False,
...     push_to_hub=True,
... )
Defina um data collator simples para agrupar exemplos em lotes.
>>> from transformers import DefaultDataCollator

>>> data_collator = DefaultDataCollator()
Por fim, junte tudo e chame train():
>>> from transformers import Trainer

>>> trainer = Trainer(
...     model=model,
...     args=training_args,
...     data_collator=data_collator,
...     train_dataset=encoded_train_dataset,
...     eval_dataset=encoded_test_dataset,
...     processing_class=processor,
... )

>>> trainer.train()
Para adicionar o modelo final ao 🤗 Hub, crie um cartão de modelo e chame push_to_hub:
>>> trainer.create_model_card()
>>> trainer.push_to_hub()
Inferência
Agora que você ajustou um modelo LayoutLMv2 e o enviou para o 🤗 Hub, você pode usá-lo para inferência. A maneira mais simples de testar seu modelo ajustado para inferência é usá-lo em um Pipeline.
Vamos a um exemplo:
>>> example = dataset["test"][2]
>>> question = example["query"]["en"]
>>> image = example["image"]
>>> print(question)
>>> print(example["answers"])
'Who is ‘presiding’ TRRF GENERAL SESSION (PART 1)?'
['TRRF Vice President', 'lee a. waller']
Em seguida, instancie um pipeline para question answering em documentos com seu modelo e passe a combinação de imagem + pergunta para ele.
>>> from transformers import pipeline

>>> qa_pipeline = pipeline("document-question-answering", model="MariaK/layoutlmv2-base-uncased_finetuned_docvqa")
>>> qa_pipeline(image, question)
[{'score': 0.9949808120727539,
  'answer': 'Lee A. Waller',
  'start': 55,
  'end': 57}]
Você também pode replicar manualmente os resultados do pipeline, se desejar:
- Pegue uma imagem e uma pergunta e prepare-as para o modelo usando o processor do seu modelo.
- Encaminhe o resultado ou o pré-processamento pelo modelo.
- O modelo retorna
start_logitseend_logits, que indicam qual token está no início da resposta e qual token está no fim da resposta. Ambos têm a forma (batch_size, sequence_length). - Aplique um argmax na última dimensão tanto dos
start_logitsquanto dosend_logitspara obter ostart_idxe oend_idxprevistos. - Decodifique a resposta com o tokenizer.
>>> import torch
>>> from transformers import AutoProcessor
>>> from transformers import AutoModelForDocumentQuestionAnswering

>>> processor = AutoProcessor.from_pretrained("MariaK/layoutlmv2-base-uncased_finetuned_docvqa")
>>> model = AutoModelForDocumentQuestionAnswering.from_pretrained("MariaK/layoutlmv2-base-uncased_finetuned_docvqa")

>>> with torch.no_grad():
...     encoding = processor(image.convert("RGB"), question, return_tensors="pt")
...     outputs = model(**encoding)
...     start_logits = outputs.start_logits
...     end_logits = outputs.end_logits
...     predicted_start_idx = start_logits.argmax(-1).item()
...     predicted_end_idx = end_logits.argmax(-1).item()

>>> processor.tokenizer.decode(encoding.input_ids.squeeze()[predicted_start_idx : predicted_end_idx + 1])
'lee a. waller'