
Transformers documentation
Imagem-texto-para-texto
Imagem-texto-para-texto
Modelos de imagem-texto-para-texto, também conhecidos como modelos de linguagem visual (VLMs), são modelos de linguagem que recebem uma imagem como entrada. Esses modelos podem lidar com diversas tarefas, desde a resposta a perguntas visuais até a segmentação de imagens. Essa tarefa apresenta muitas semelhanças com a de imagem-para-texto, mas possui alguns casos de uso sobrepostos, como a legenda de imagens. Modelos de imagem-para-texto aceitam apenas entradas de imagem e frequentemente realizam uma tarefa específica, enquanto os VLMs aceitam entradas de texto e imagem abertas e são modelos mais generalistas.
Neste guia, fornecemos uma visão geral breve dos VLMs e mostramos como usá-los com o Transformers para inferência.
Para começar, existem vários tipos de VLMs:
- modelos base usados para ajuste fino
- modelos de chat ajustados finamente para conversação
- modelos ajustados finamente por instrução
Este guia foca na inferência com um modelo ajustado por instruções.
Vamos começar a instalar as dependências.
pip install -q transformers accelerate
pip install flash-attn --no-build-isolation
Vamos inicializar o modelo e o processador.
from transformers import AutoProcessor, AutoModelForImageTextToText
from accelerate import Accelerator
import torch

device = Accelerator().device
model = AutoModelForImageTextToText.from_pretrained(
    "Qwen/Qwen3-VL-4B-Instruct",
    dtype=torch.bfloat16,
    attn_implementation="flash_attention_2",
).to(device)
Modelos de resolução dinâmica, como Qwen3-VL e Qwen3.5, usam por padrão um
longest_edgede ~16MP, o que pode gerar mais de 10.000 tokens visuais por imagem e travar a inferência ou causar OOM em GPUs de consumo. Definamin_pixelsemax_pixelsao carregar o processador para limitar isso.
processor = AutoProcessor.from_pretrained(
    "Qwen/Qwen3-VL-4B-Instruct",
    min_pixels=224 * 224,
    max_pixels=1024 * 1024,
)
Este modelo possui um chat template que ajuda o usuário a interpretar as saídas do chat. Além disso, o modelo também pode aceitar múltiplas imagens como entrada em uma única conversa ou mensagem. Agora, prepararemos as entradas.
As entradas de imagem têm o seguinte formato.

Estruture sua conversa conforme mostrado abaixo para um único prompt com entradas de imagem e texto.
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    }
]
Alterne entre o papel user e o papel assistant para fundamentar o modelo com o contexto anterior e gerar respostas melhores.
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    },
    {
        "role": "assistant",
        "content": [
            {"type": "text", "text": "In this image we can see two cats on the nets."},
        ]
    },
    {
        "role": "user",
        "content": [
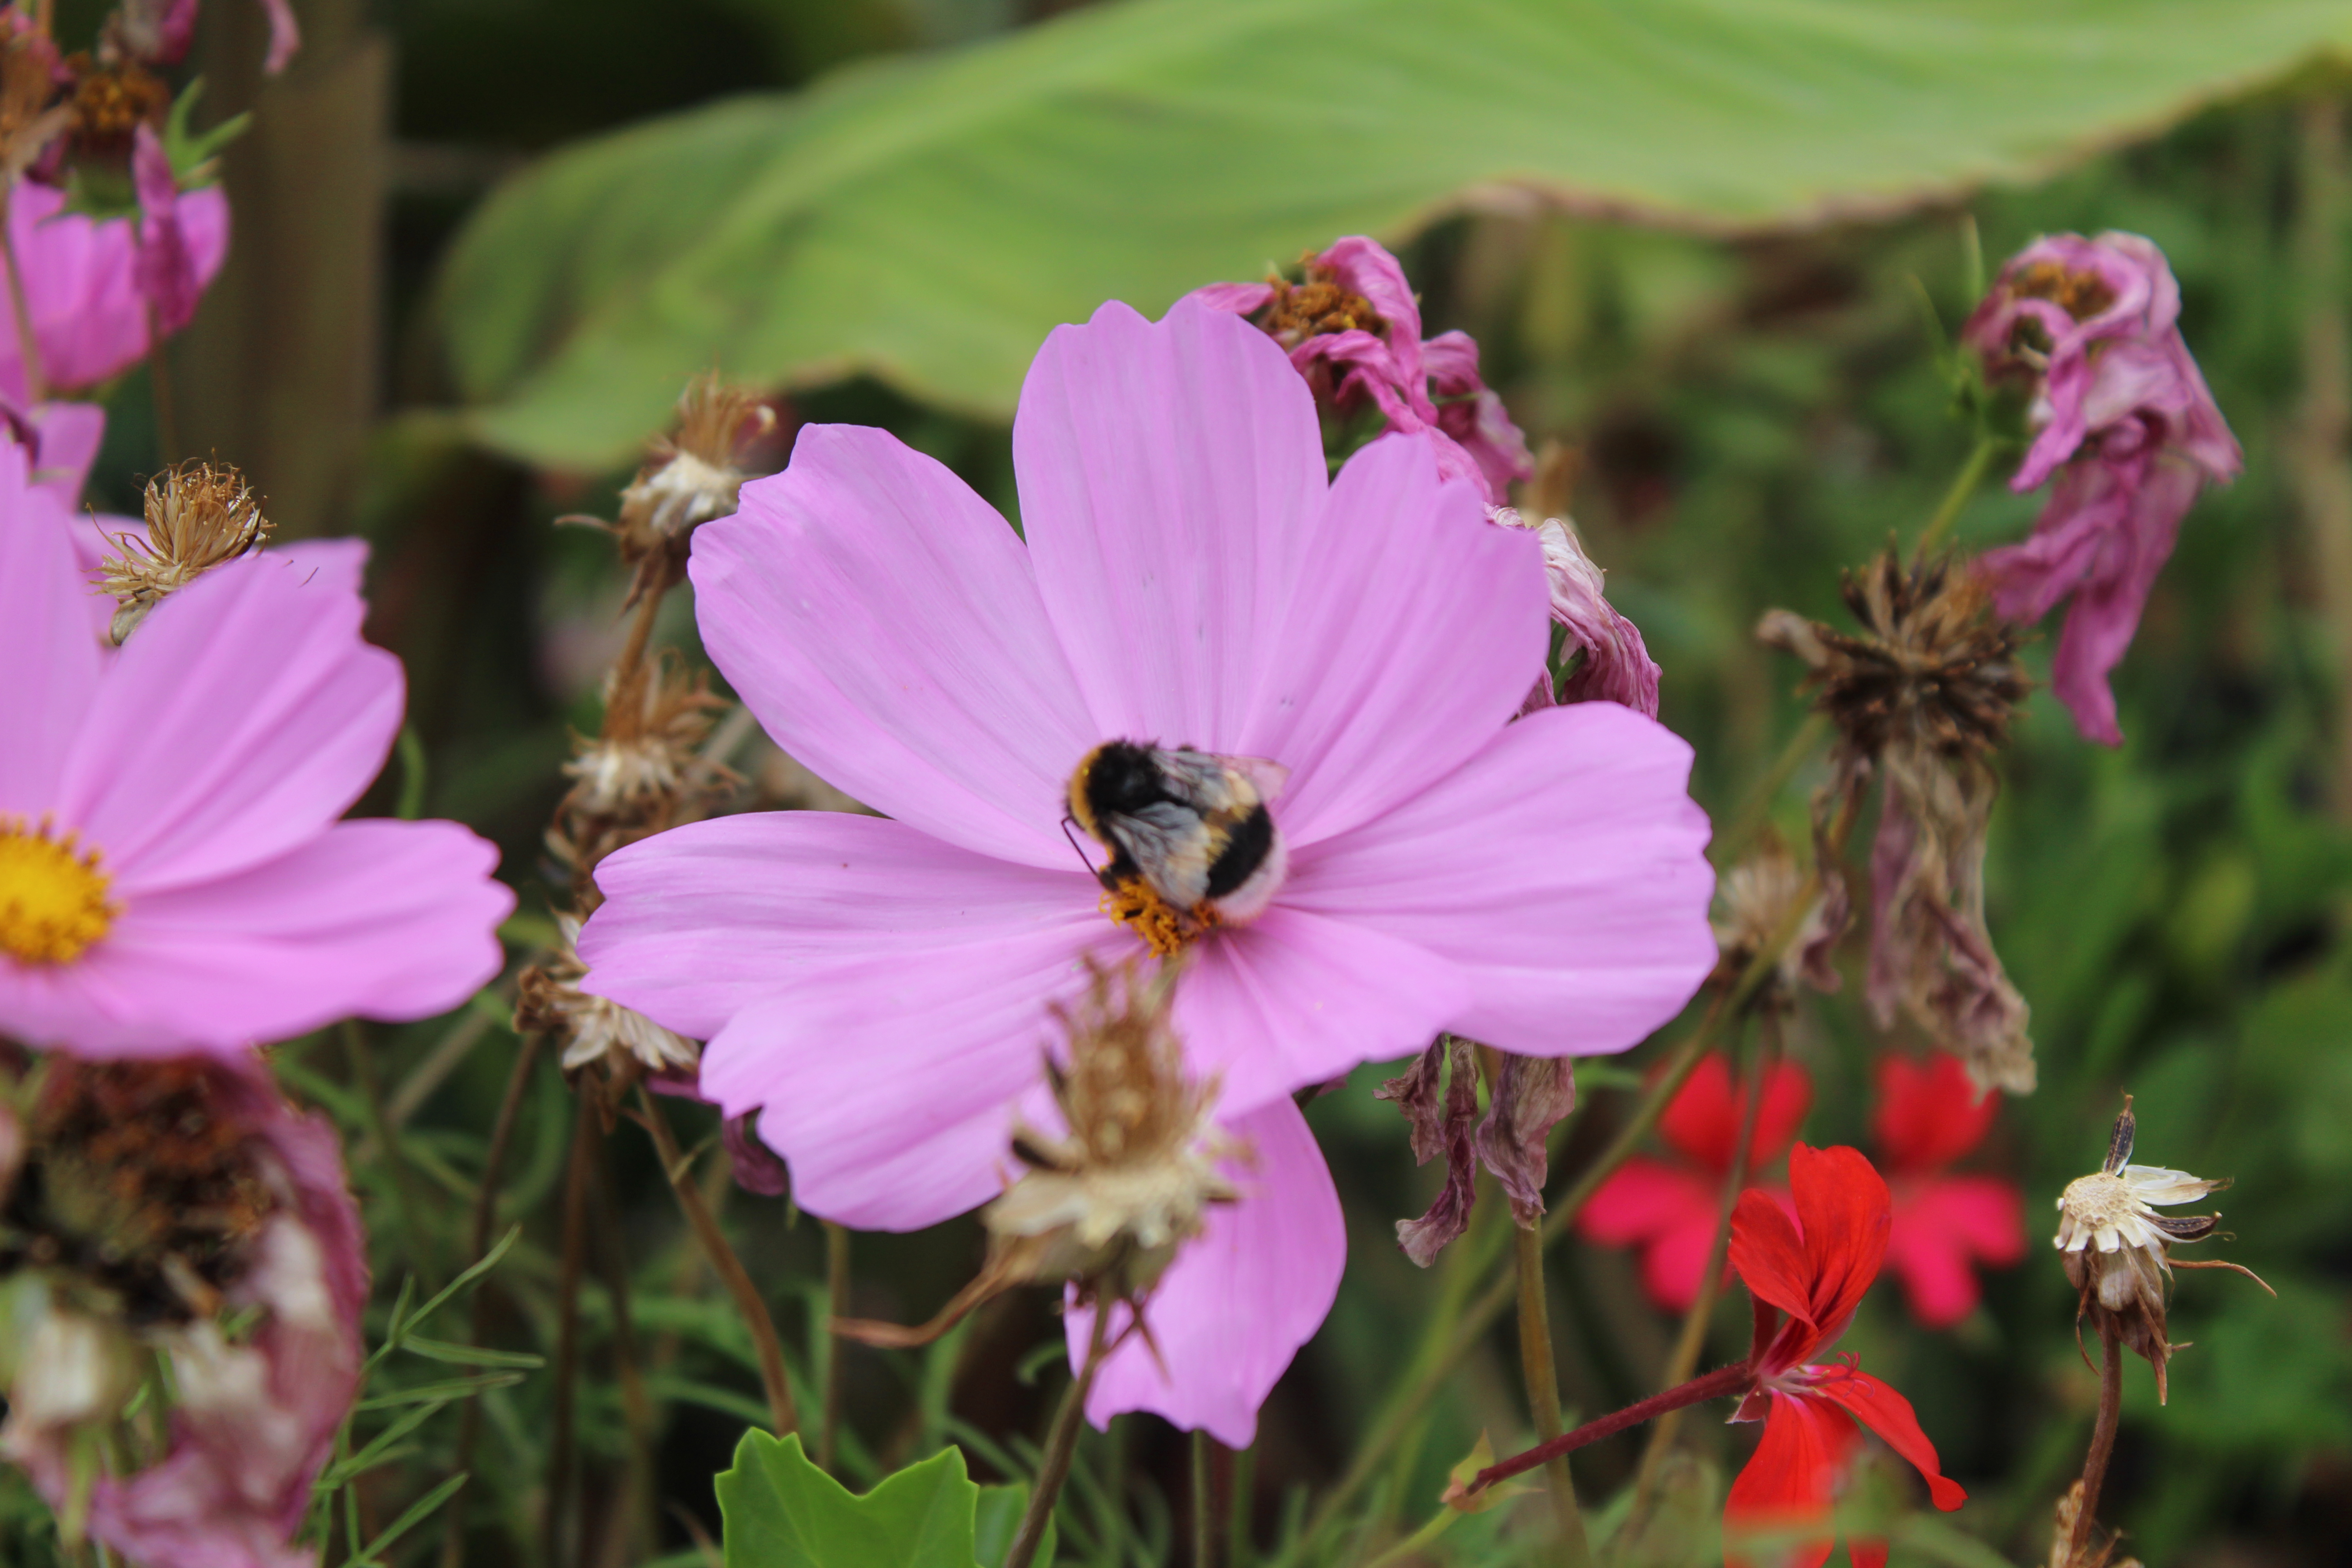
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "And how about this image?"},
        ]
    },
]
Agora, chamaremos o método apply_chat_template() dos processadores para pré-processar sua saída junto com as entradas de imagem.
inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(device)Agora podemos passar as entradas pré-processadas para o modelo.
input_len = len(inputs.input_ids[0])

with torch.no_grad():
    generated_ids = model.generate(**inputs, max_new_tokens=200)
generated_texts = processor.batch_decode(generated_ids[:, input_len:], skip_special_tokens=True)

print(generated_texts)
## ['In this image we can see flowers, plants and insect.']
Pipeline
A maneira mais rápida de começar é usar a API Pipeline. Especifique a tarefa "image-text-to-text" e o modelo que deseja usar.
from transformers import pipeline
pipe = pipeline("image-text-to-text", model="llava-hf/llava-interleave-qwen-0.5b-hf")
O exemplo abaixo usa modelos de chat para formatar as entradas de texto.
messages = [
     {
         "role": "user",
         "content": [
             {
                 "type": "image",
                 "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg",
             },
             {"type": "text", "text": "Describe this image."},
         ],
     },
     {
         "role": "assistant",
         "content": [
             {"type": "text", "text": "There's a pink flower"},
         ],
     },
 ]
Passe o texto formatado com o chat template e a imagem para o Pipeline e defina return_full_text=False para remover a entrada da saída gerada.
outputs = pipe(text=messages, max_new_tokens=20, return_full_text=False)
outputs[0]["generated_text"]
#  with a yellow center in the foreground. The flower is surrounded by red and white flowers with green stems
Se preferir, você também pode carregar as imagens separadamente e passá-las para o pipeline da seguinte forma:
import requests
from PIL import Image
from transformers import pipeline

pipe = pipeline("image-text-to-text", model="HuggingFaceTB/SmolVLM-256M-Instruct")

img_urls = [
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png",
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg",
]
images = [
    Image.open(requests.get(img_urls[0], stream=True).raw),
    Image.open(requests.get(img_urls[1], stream=True).raw),
]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "image"},
            {"type": "text", "text": "What do you see in these images?"},
        ],
    }
]
outputs = pipe(text=messages, images=images, max_new_tokens=50, return_full_text=False)
outputs[0]["generated_text"]
" In the first image, there are two cats sitting on a plant. In the second image, there are flowers with a pinkish hue."
As imagens ainda serão incluídas no campo "input_text" da saída:
outputs[0]['input_text']
"""
[{'role': 'user',
  'content': [{'type': 'image',
    'image': <PIL.PngImagePlugin.PngImageFile image mode=RGBA size=622x412>},
   {'type': 'image',
    'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=5184x3456>},
   {'type': 'text', 'text': 'What do you see in these images?'}]}]
"""
Streaming
Podemos usar streaming de texto para uma melhor experiência de geração. O Transformers suporta streaming com as classes TextStreamer ou TextIteratorStreamer. Usaremos o TextIteratorStreamer com o IDEFICS-8B.
Suponha que temos uma aplicação que mantém o histórico do chat e recebe a nova entrada do usuário. Vamos pré-processar as entradas como de costume e inicializar o TextIteratorStreamer para lidar com a geração em uma thread separada. Isso permite transmitir os tokens de texto gerados em tempo real. Quaisquer argumentos de geração podem ser passados para o TextIteratorStreamer.
import time
from transformers import TextIteratorStreamer
from threading import Thread

def model_inference(
    user_prompt,
    chat_history,
    max_new_tokens,
    images
):
    user_prompt = {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": user_prompt},
        ]
    }
    chat_history.append(user_prompt)
    streamer = TextIteratorStreamer(
        processor.tokenizer,
        skip_prompt=True,
        timeout=5.0,
    )

    generation_args = {
        "max_new_tokens": max_new_tokens,
        "streamer": streamer,
        "do_sample": False
    }

    # add_generation_prompt=True makes model generate bot response
    prompt = processor.apply_chat_template(chat_history, add_generation_prompt=True)
    inputs = processor(
        text=prompt,
        images=images,
        return_tensors="pt",
    ).to(device)
    generation_args.update(inputs)

    thread = Thread(
        target=model.generate,
        kwargs=generation_args,
    )
    thread.start()

    acc_text = ""
    for text_token in streamer:
        time.sleep(0.04)
        acc_text += text_token
        if acc_text.endswith("<end_of_utterance>"):
            acc_text = acc_text[:-18]
        yield acc_text

    thread.join()
Agora, vamos chamar a função model_inference que criamos e transmitir os valores.
generator = model_inference(
    user_prompt="And what is in this image?",
    chat_history=messages[:2],
    max_new_tokens=100,
    images=images
)

for value in generator:
  print(value)

# In
# In this
# In this image ...
Ajuste modelos em hardware menor
VLMs costumam ser grandes e precisam ser otimizadas para caber em hardware menor. O Transformers suporta diversas bibliotecas de quantização de modelos, e aqui mostraremos apenas a quantização int8 com Quanto. A quantização int8 oferece melhorias de memória de até 75 por cento (se todos os pesos forem quantizados). No entanto, não é uma solução sem custos, pois 8 bits não é uma precisão nativa de CUDA, e os pesos são quantizados e desquantizados em tempo real, o que aumenta a latência.
Primeiro, instale as dependências.
pip install -U optimum-quanto bitsandbytes
Para quantizar um modelo durante o carregamento, é necessário primeiro criar um QuantoConfig. Em seguida, carregue o modelo como de costume, mas passe quantization_config durante a inicialização do modelo.
from transformers import AutoModelForImageTextToText, QuantoConfig

model_id = "Qwen/Qwen3-VL-4B-Instruct"
quantization_config = QuantoConfig(weights="int8")
quantized_model = AutoModelForImageTextToText.from_pretrained(
    model_id, device_map="auto", quantization_config=quantization_config
)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    },
]
inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(quantized_model.device)
input_len = len(inputs.input_ids[0])

with torch.no_grad():
    generated_ids = quantized_model.generate(**inputs, cache_implementation="static", max_new_tokens=100)
generated_texts = processor.batch_decode(generated_ids[:, input_len:], skip_special_tokens=True)

print(generated_texts[0])
## ['In this image, we see two tabby cats resting on a large, tangled pile of fishing nets. The nets are a mix of brown, orange, and red colors, with some blue and green ropes visible in the background. The cats appear relaxed and comfortable, nestled into the fibers of the nets. One cat is in the foreground, looking slightly to the side, while the other is positioned further back, looking directly at the camera. The scene suggests a coastal or fishing-related setting, possibly near']
E é isso, podemos usar o modelo da mesma forma, sem alterações.
Conversa iterativa com cache
Se você está construindo agentes de chat multimodais, provavelmente está passando as mesmas imagens ou áudios entre as rodadas. O cache permite reutilizar suas representações codificadas em vez de reprocessá-los a cada vez, reduzindo o cálculo redundante.
Assim como os modelos apenas de texto, os modelos multimodais acompanham o histórico do diálogo com um chat template. A principal diferença é que ele aplica o chat template apenas no formato "text" e processa o novo conteúdo multimodal separadamente. Se você aplicar o template com processamento, toda a conversa é reprocessada a cada turno, pois o Jinja não consegue distinguir entradas previamente codificadas de novas.
O exemplo abaixo demonstra esse padrão. Para modelos apenas de texto, consulte o guia de geração iterativa.
Aqui está um exemplo simples em Python que demonstra esse padrão. Para um exemplo com modelos apenas de texto, consulte este guia.
import torch
from transformers import AutoProcessor, Gemma4ForConditionalGeneration, TextStreamer
from transformers.cache_utils import DynamicCache
from transformers.image_utils import load_image
from transformers.audio_utils import load_audio

model_id = 'google/gemma-4-E2B-it'
processor = AutoProcessor.from_pretrained(model_id)
model = Gemma4ForConditionalGeneration.from_pretrained(model_id, dtype=torch.float32, device_map='cpu')

past_key_values = DynamicCache()
streamer = TextStreamer(processor.tokenizer, skip_prompt=True, skip_special_tokens=True)

## Turn 1: multimodal input (text + image + audio)
audio = load_audio("https://huggingface.co/datasets/Xenova/transformers.js-docs/resolve/main/jfk.wav")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg")
messages = [
    {
        "role": "user",
        "content": [
            {"type": "text", "text": "In detail, describe the following audio and image."},
            {"type": "audio"},
            {"type": "image"},
        ],
    },
]
input_string = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
inputs = processor(text=input_string, images=[image], audio=[audio], return_tensors='pt')
output = model.generate(**inputs, past_key_values=past_key_values, max_new_tokens=1024, do_sample=False, streamer=streamer)
first_response = processor.decode(output[0][inputs['input_ids'].shape[1]:], skip_special_tokens=True)

## Turn 2: text-only follow-up (reuses KV cache, no new media)
messages.append({"role": "assistant", "content": [{"type": "text", "text": first_response}]})
cached_string = processor.apply_chat_template(messages, tokenize=False)
messages.append({"role": "user", "content": [{"type": "text", "text": "Summarize the previous descriptions in one sentence."}]})
full_string = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
new_string = full_string[len(cached_string):]

new_input_ids = processor.tokenizer(new_string, add_special_tokens=False, return_tensors='pt')['input_ids']
# Build and pass an attention mask only if batched input or there is padding
# attention_mask = torch.ones(1, past_key_values.get_seq_length() + new_input_ids.shape[1], dtype=torch.long)

output2 = model.generate(input_ids=new_input_ids, past_key_values=past_key_values, max_new_tokens=1024, do_sample=False, streamer=streamer)
second_response = processor.decode(output2[0][new_input_ids.shape[1]:], skip_special_tokens=True)

## Turn 3: new image (must go through processor for image token expansion + encoding)
image2 = load_image("https://huggingface.co/datasets/Xenova/transformers.js-docs/resolve/main/artemis.jpeg")
messages.append({"role": "assistant", "content": [{"type": "text", "text": second_response}]})
cached_string2 = processor.apply_chat_template(messages, tokenize=False)
messages.append({"role": "user", "content": [{"type": "text", "text": "Describe this image."}, {"type": "image"}]})
full_string2 = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
new_string2 = full_string2[len(cached_string2):]

new_inputs2 = processor(text=new_string2, images=[image2], add_special_tokens=False, return_tensors='pt')
# new_inputs2['attention_mask'] = torch.ones(1, past_key_values.get_seq_length() + new_inputs2['input_ids'].shape[1], dtype=torch.long)
new_inputs2['past_key_values'] = past_key_values

output3 = model.generate(**new_inputs2, max_new_tokens=1024, do_sample=False, streamer=streamer)
Leituras adicionais
Aqui estão mais alguns recursos para a tarefa de imagem-texto-para-texto.
- A página da tarefa de imagem e texto para texto abrange tipos de modelos, casos de uso, conjuntos de dados e muito mais.
- Modelos de Linguagem e Visão Explicados é um post de blog que aborda tudo sobre modelos de linguagem e visão e o ajuste fino supervisionado usando TRL.
- Aprenda como fazer o ajuste fino de modelos de linguagem visual usando o TRL