
Transformers documentation
Legendação de imagens
Legendação de imagens
A legendação de imagens é a tarefa de prever uma legenda para uma imagem dada. Aplicações comuns do mundo real incluem auxiliar pessoas com deficiência visual, o que pode ajudá-las a navegar por diferentes situações. Portanto, a legendação de imagens ajuda a melhorar a acessibilidade do conteúdo para as pessoas, descrevendo as imagens para elas.
Este guia mostrará como:
- Ajuste fino de um modelo de legendagem de imagens.
- Use o modelo ajustado para inferência.
Antes de começar, verifique se você tem todas as bibliotecas necessárias instaladas:
pip install transformers datasets evaluate -q
pip install jiwer -q
Recomendamos que você faça login na sua conta do Hugging Face para que possa enviar e compartilhar seu modelo com a comunidade. Quando solicitado, insira seu token para fazer login:
from huggingface_hub import notebook_login

notebook_login()
Carregue o conjunto de dados de legendas BLIP de Pokémon
Use a biblioteca 🤗 Dataset para carregar um dataset que consiste em pares {image-caption}. Para criar seu próprio dataset de legendagem de imagens em PyTorch, você pode seguir este notebook.
from datasets import load_dataset

ds = load_dataset("lambdalabs/pokemon-blip-captions")
dsDatasetDict({
train: Dataset({
features: ['image', 'text'],
num_rows: 833
})
})O conjunto de dados possui duas características, image e text.
Muitos conjuntos de dados de legendagem de imagens contêm várias legendas por imagem. Nesses casos, uma estratégia comum é amostrar aleatoriamente uma legenda entre as disponíveis durante o treinamento.
Divida o conjunto de treinamento do dataset em um conjunto de treinamento e um conjunto de teste com o método train_test_split:
ds = ds["train"].train_test_split(test_size=0.1)
train_ds = ds["train"]
test_ds = ds["test"]
Vamos visualizar alguns exemplos do conjunto de treinamento.
from textwrap import wrap
import matplotlib.pyplot as plt
import numpy as np


def plot_images(images, captions):
    plt.figure(figsize=(20, 20))
    for i in range(len(images)):
        ax = plt.subplot(1, len(images), i + 1)
        caption = captions[i]
        caption = "\n".join(wrap(caption, 12))
        plt.title(caption)
        plt.imshow(images[i])
        plt.axis("off")


sample_images_to_visualize = [np.array(train_ds[i]["image"]) for i in range(5)]
sample_captions = [train_ds[i]["text"] for i in range(5)]
plot_images(sample_images_to_visualize, sample_captions)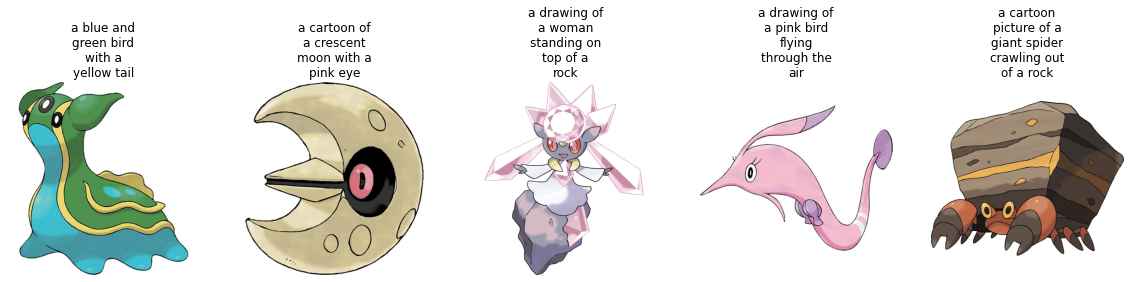
Pré-processar o conjunto de dados
Como o conjunto de dados possui duas modalidades (imagem e texto), o pipeline de pré-processamento irá pré-processar as imagens e as legendas.
Para isso, carregue a classe de processador associada ao modelo que você está prestes a ajustar finamente.
from transformers import AutoProcessor

checkpoint = "microsoft/git-base"
processor = AutoProcessor.from_pretrained(checkpoint)
O processador pré-processará a imagem internamente (o que inclui redimensionamento e escalonamento de pixels) e tokenizará a legenda.
def transforms(example_batch):
    images = [x for x in example_batch["image"]]
    captions = [x for x in example_batch["text"]]
    inputs = processor(images=images, text=captions, padding="max_length")
    inputs.update({"labels": inputs["input_ids"]})
    return inputs


train_ds.set_transform(transforms)
test_ds.set_transform(transforms)
Com o conjunto de dados pronto, você agora pode configurar o modelo para o ajuste fino.
Carregar um modelo base
Carregue o “microsoft/git-base” em um objeto AutoModelForCausalLM.
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(checkpoint)
Avaliar
Os modelos de legendagem de imagens são tipicamente avaliados com o Rouge Score ou o Word Error Rate. Neste guia, você usará o Word Error Rate (WER).
Usamos a biblioteca 🤗 Evaluate para isso. Para possíveis limitações e outras armadilhas do WER, consulte este guia.
from evaluate import load
import torch

wer = load("wer")


def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predicted = logits.argmax(-1)
    decoded_labels = processor.batch_decode(labels, skip_special_tokens=True)
    decoded_predictions = processor.batch_decode(predicted, skip_special_tokens=True)
    wer_score = wer.compute(predictions=decoded_predictions, references=decoded_labels)
    return {"wer_score": wer_score}
Treinar
Agora, você está pronto para começar o ajuste fino do modelo. Você usará o 🤗 Trainer para isso.
Primeiro, defina os argumentos de treinamento usando TrainingArguments.
from transformers import TrainingArguments, Trainer

model_name = checkpoint.split("/")[1]

training_args = TrainingArguments(
    output_dir=f"{model_name}-pokemon",
    learning_rate=5e-5,
    num_train_epochs=50,
    fp16=True,
    per_device_train_batch_size=32,
    per_device_eval_batch_size=32,
    gradient_accumulation_steps=2,
    save_total_limit=3,
    eval_strategy="steps",
    eval_steps=50,
    save_strategy="steps",
    save_steps=50,
    logging_steps=50,
    remove_unused_columns=False,
    push_to_hub=True,
    label_names=["labels"],
    load_best_model_at_end=True,
)
Em seguida, passe-os, junto com os conjuntos de dados e o modelo, para o 🤗 Trainer.
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_ds,
    eval_dataset=test_ds,
    compute_metrics=compute_metrics,
)
Para iniciar o treinamento, basta chamar train() no objeto Trainer.
trainer.train()
Você deve observar que a perda de treinamento diminui de forma suave à medida que o treinamento avança.
Quando o treinamento for concluído, compartilhe seu modelo no Hub com o método push_to_hub() para que todos possam usá-lo:
trainer.push_to_hub()
Inferência
Pegue uma imagem de exemplo de test_ds para testar o modelo.
from PIL import Image
import requests

url = "https://huggingface.co/datasets/sayakpaul/sample-datasets/resolve/main/pokemon.png"
image = Image.open(requests.get(url, stream=True).raw)
image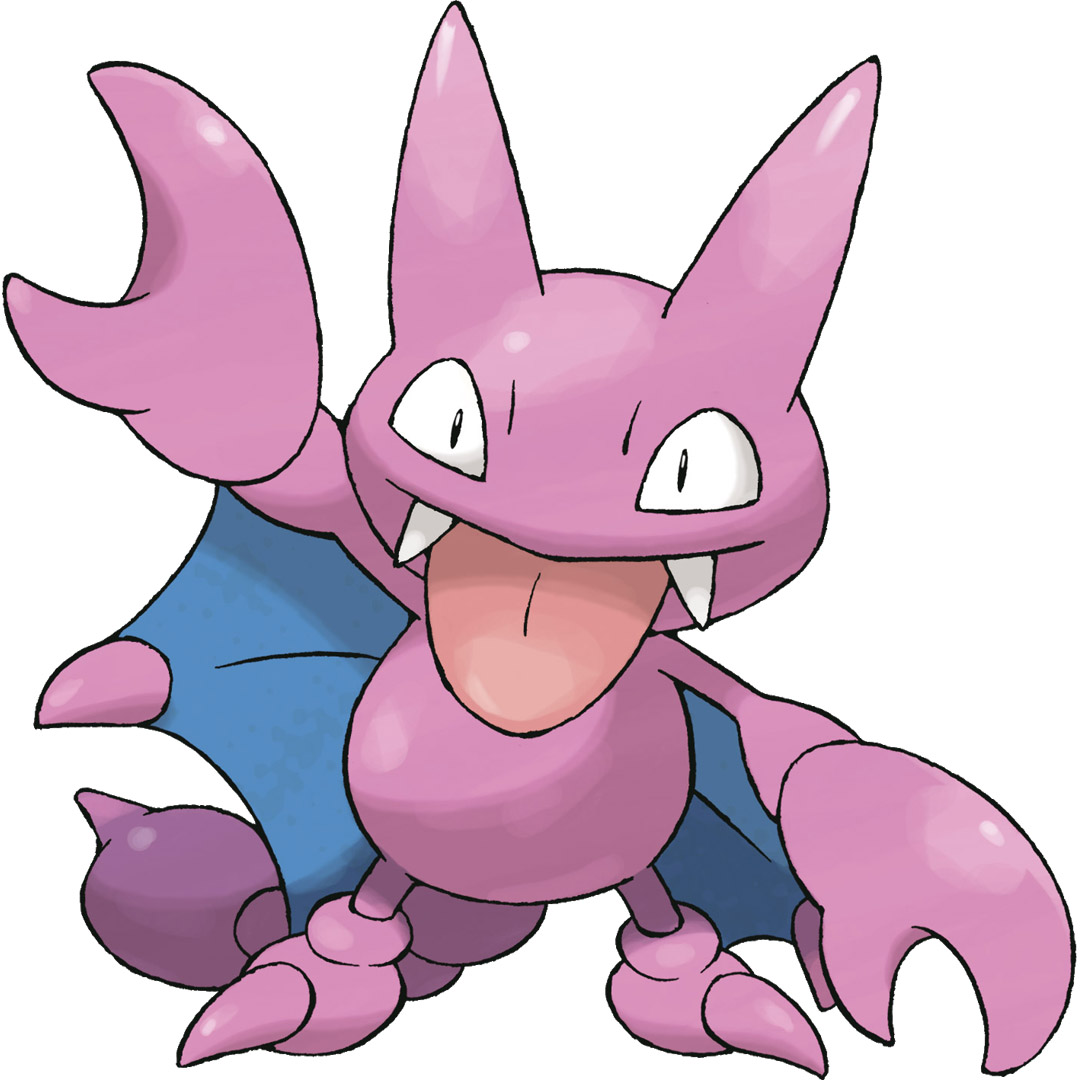
Prepare a imagem para o modelo.
from accelerate import Accelerator

device = Accelerator().device
inputs = processor(images=image, return_tensors="pt").to(device)
pixel_values = inputs.pixel_values
Chame generate e decodifique as previsões.
generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
generated_caption = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_caption)a drawing of a pink and blue pokemon
Parece que o modelo ajustado gerou uma legenda bastante boa!
Update on GitHub