
Transformers documentation
Detecção de Pontos-Chave
Detecção de Pontos-Chave
A detecção de pontos-chave identifica e localiza pontos de interesse específicos em uma imagem. Esses pontos-chave, também conhecidos como marcos, representam características significativas dos objetos, como traços faciais ou partes de objetos. Esses modelos recebem uma imagem como entrada e retornam as seguintes saídas:
- Pontos-chave e Pontuações: Pontos de interesse e suas pontuações de confiança.
- Descritores: Uma representação da região da imagem ao redor de cada ponto-chave, capturando sua textura, gradiente, orientação e outras propriedades.
Neste guia, mostraremos como extrair pontos-chave de imagens.
Para este tutorial, usaremos o SuperPoint, um modelo de base para detecção de pontos-chave.
from transformers import AutoImageProcessor, SuperPointForKeypointDetection
processor = AutoImageProcessor.from_pretrained("magic-leap-community/superpoint")
model = SuperPointForKeypointDetection.from_pretrained("magic-leap-community/superpoint")
Vamos testar o modelo nas imagens abaixo.
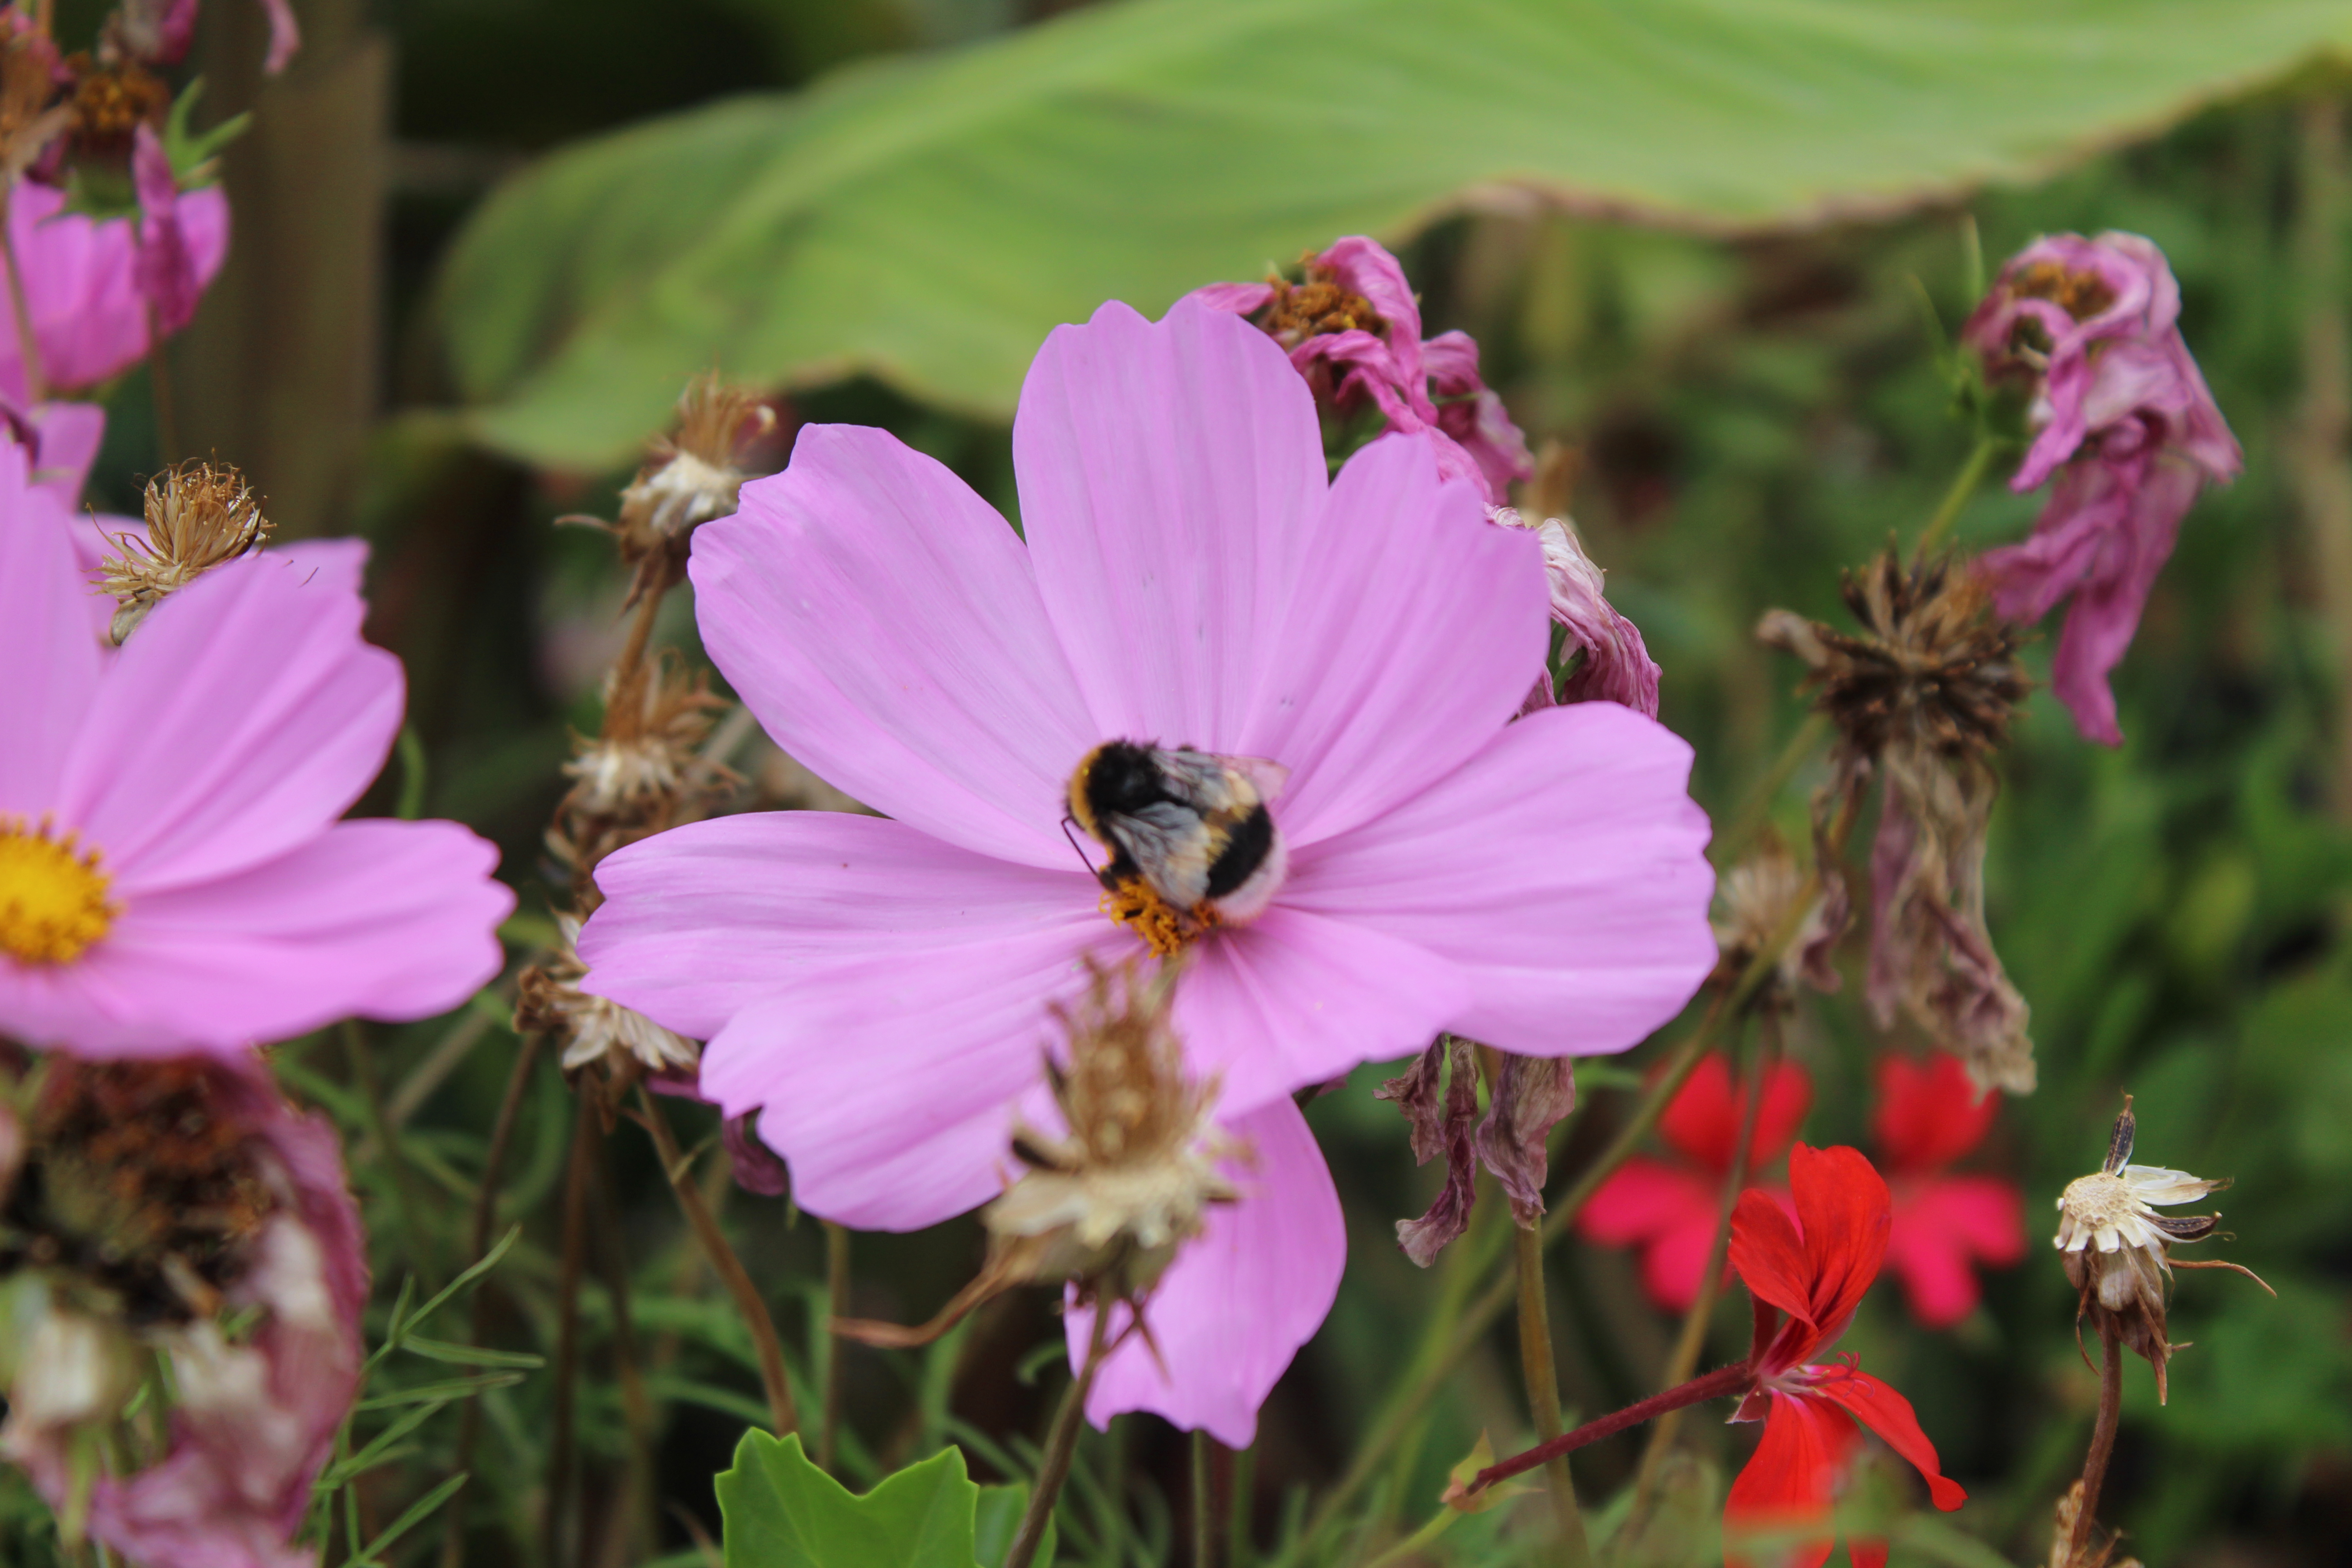

import torch
from PIL import Image
import requests
import cv2


url_image_1 = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"
image_1 = Image.open(requests.get(url_image_1, stream=True).raw)
url_image_2 = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"
image_2 = Image.open(requests.get(url_image_2, stream=True).raw)

images = [image_1, image_2]
Agora podemos processar nossas entradas e inferir.
inputs = processor(images,return_tensors="pt").to(model.device, model.dtype)
outputs = model(**inputs)
A saída do modelo possui pontos-chave relativos, descritores, máscaras e pontuações para cada item do lote. A máscara destaca as áreas da imagem em que há pontos-chave.
SuperPointKeypointDescriptionOutput(loss=None, keypoints=tensor([[[0.0437, 0.0167],
         [0.0688, 0.0167],
         [0.0172, 0.0188],
         ...,
         [0.5984, 0.9812],
         [0.6953, 0.9812]]]),
         scores=tensor([[0.0056, 0.0053, 0.0079,  ..., 0.0125, 0.0539, 0.0377],
        [0.0206, 0.0058, 0.0065,  ..., 0.0000, 0.0000, 0.0000]],
       grad_fn=<CopySlices>), descriptors=tensor([[[-0.0807,  0.0114, -0.1210,  ..., -0.1122,  0.0899,  0.0357],
         [-0.0807,  0.0114, -0.1210,  ..., -0.1122,  0.0899,  0.0357],
         [-0.0807,  0.0114, -0.1210,  ..., -0.1122,  0.0899,  0.0357],
         ...],
       grad_fn=<CopySlices>), mask=tensor([[1, 1, 1,  ..., 1, 1, 1],
        [1, 1, 1,  ..., 0, 0, 0]], dtype=torch.int32), hidden_states=None)
Para plotar os keypoints reais na imagem, precisamos pós-processar a saída. Para isso, devemos passar os tamanhos reais da imagem para post_process_keypoint_detection junto com as saídas.
image_sizes = [(image.size[1], image.size[0]) for image in images]
outputs = processor.post_process_keypoint_detection(outputs, image_sizes)
As saídas agora são uma lista de dicionários em que cada dicionário é uma saída processada de keypoints, scores e descriptors.
[{'keypoints': tensor([[ 226,   57],
          [ 356,   57],
          [  89,   64],
          ...,
          [3604, 3391]], dtype=torch.int32),
  'scores': tensor([0.0056, 0.0053, ...], grad_fn=<IndexBackward0>),
  'descriptors': tensor([[-0.0807,  0.0114, -0.1210,  ..., -0.1122,  0.0899,  0.0357],
          [-0.0807,  0.0114, -0.1210,  ..., -0.1122,  0.0899,  0.0357]],
         grad_fn=<IndexBackward0>)},
    {'keypoints': tensor([[ 46,   6],
          [ 78,   6],
          [422,   6],
          [206, 404]], dtype=torch.int32),
  'scores': tensor([0.0206, 0.0058, 0.0065, 0.0053, 0.0070, ...,grad_fn=<IndexBackward0>),
  'descriptors': tensor([[-0.0525,  0.0726,  0.0270,  ...,  0.0389, -0.0189, -0.0211],
          [-0.0525,  0.0726,  0.0270,  ...,  0.0389, -0.0189, -0.0211]}]
Podemos usá-los para plotar os pontos-chave.
import matplotlib.pyplot as plt
import torch

for i in range(len(images)):
  keypoints = outputs[i]["keypoints"]
  scores = outputs[i]["scores"]
  descriptors = outputs[i]["descriptors"]
  keypoints = outputs[i]["keypoints"].detach().numpy()
  scores = outputs[i]["scores"].detach().numpy()
  image = images[i]
  image_width, image_height = image.size

  plt.axis('off')
  plt.imshow(image)
  plt.scatter(
      keypoints[:, 0],
      keypoints[:, 1],
      s=scores * 100,
      c='cyan',
      alpha=0.4
  )
  plt.show()
Abaixo, você pode ver as saídas.

