
Transformers documentation
Geração de máscaras
Geração de máscaras
A geração de máscaras é a tarefa de gerar máscaras semanticamente significativas para uma imagem. Essa tarefa é muito semelhante à segmentação de imagem, mas existem muitas diferenças. Os modelos de segmentação de imagem são treinados em conjuntos de dados rotulados e são limitados às classes que viram durante o treinamento; eles retornam um conjunto de máscaras e as classes correspondentes, dada uma imagem.
Os modelos de geração de máscaras são treinados com grandes quantidades de dados e operam em dois modos.
- Modo de prompt: neste modo, o modelo recebe uma imagem e um prompt, em que o prompt pode ser uma localização de ponto 2D (coordenadas XY) na imagem dentro de um objeto ou uma caixa delimitadora (bounding box) ao redor de um objeto. No modo de prompt, o modelo retorna apenas a máscara sobre o objeto que o prompt está indicando.
- Modo Segment Everything: no segment everything, dado uma imagem, o modelo gera todas as máscaras presentes na imagem. Para isso, uma grade de pontos é gerada e sobreposta à imagem para a inferência.
- Inferência de vídeo: o modelo aceita um vídeo e um prompt de ponto ou caixa em um frame do vídeo, que é rastreado ao longo de todo o vídeo. Você pode obter mais informações sobre como realizar a inferência de vídeo seguindo a documentação do SAM 2.
A tarefa de geração de máscaras é suportada por Segment Anything Model (SAM) e Segment Anything Model 2 (SAM2), enquanto a inferência de vídeo é suportada por Segment Anything Model 2 (SAM2). O SAM é um modelo poderoso que consiste em um codificador de imagem baseado em Vision Transformer, um codificador de prompts e um decodificador de máscaras com transformador bidirecional. As imagens e os prompts são codificados, e o decodificador recebe esses embeddings e gera máscaras válidas. Enquanto isso, o SAM 2 estende o SAM adicionando um módulo de memória para rastrear as máscaras.
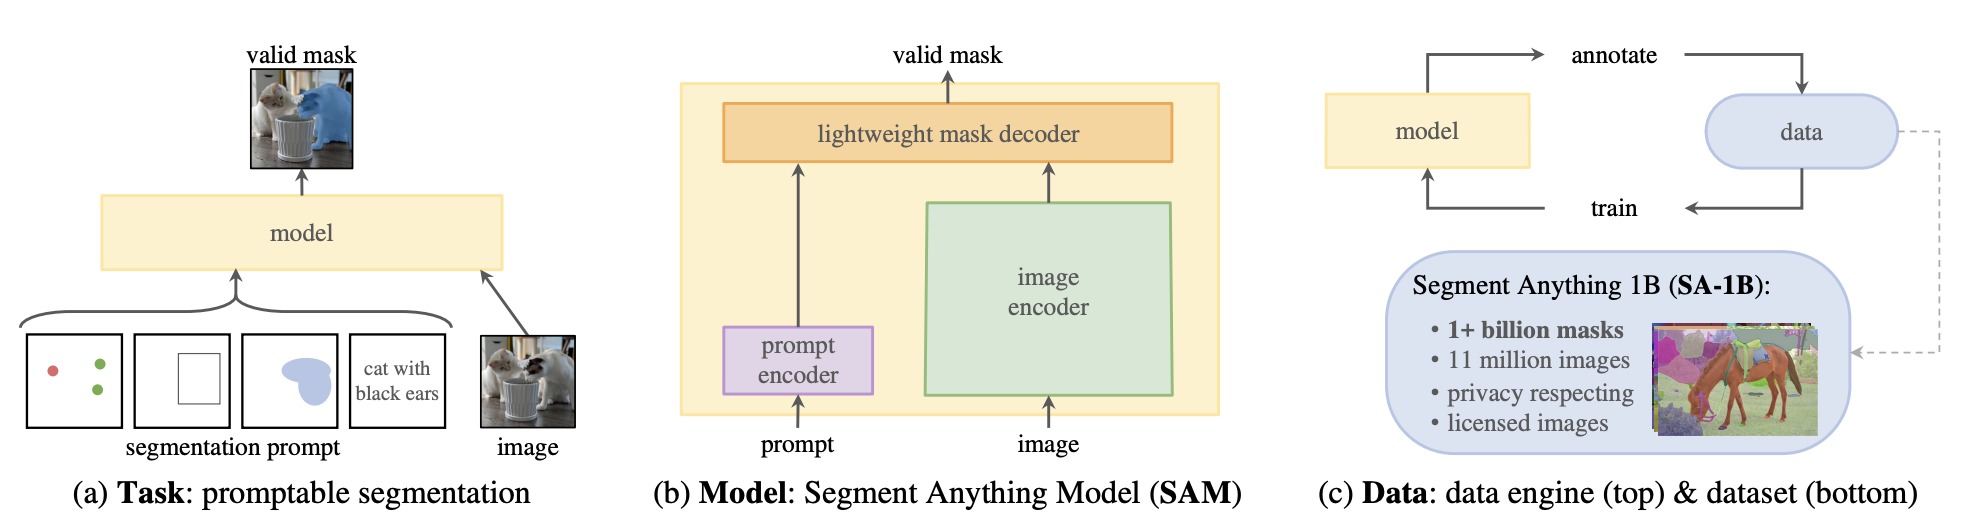
O SAM funciona como um modelo de fundação poderoso para segmentação, pois possui uma ampla cobertura de dados. Ele é treinado no SA-1B, um conjunto de dados com 1 milhão de imagens e 1,1 bilhão de máscaras.
Neste guia, você aprenderá como:
- Faça inferência no modo segmentar tudo com loteamento,
- Infira no modo de prompt de ponto,
- Infira no modo de prompt em caixa.
Primeiro, vamos instalar o transformers:
pip install -q transformers
Pipeline de Geração de Máscaras
A maneira mais fácil de inferir modelos de geração de máscaras é usar o pipeline mask-generation.
>>> from transformers import pipeline

>>> checkpoint = "facebook/sam2-hiera-base-plus"
>>> mask_generator = pipeline(model=checkpoint, task="mask-generation")
Vamos ver a imagem.
from PIL import Image
import requests

img_url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"
image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")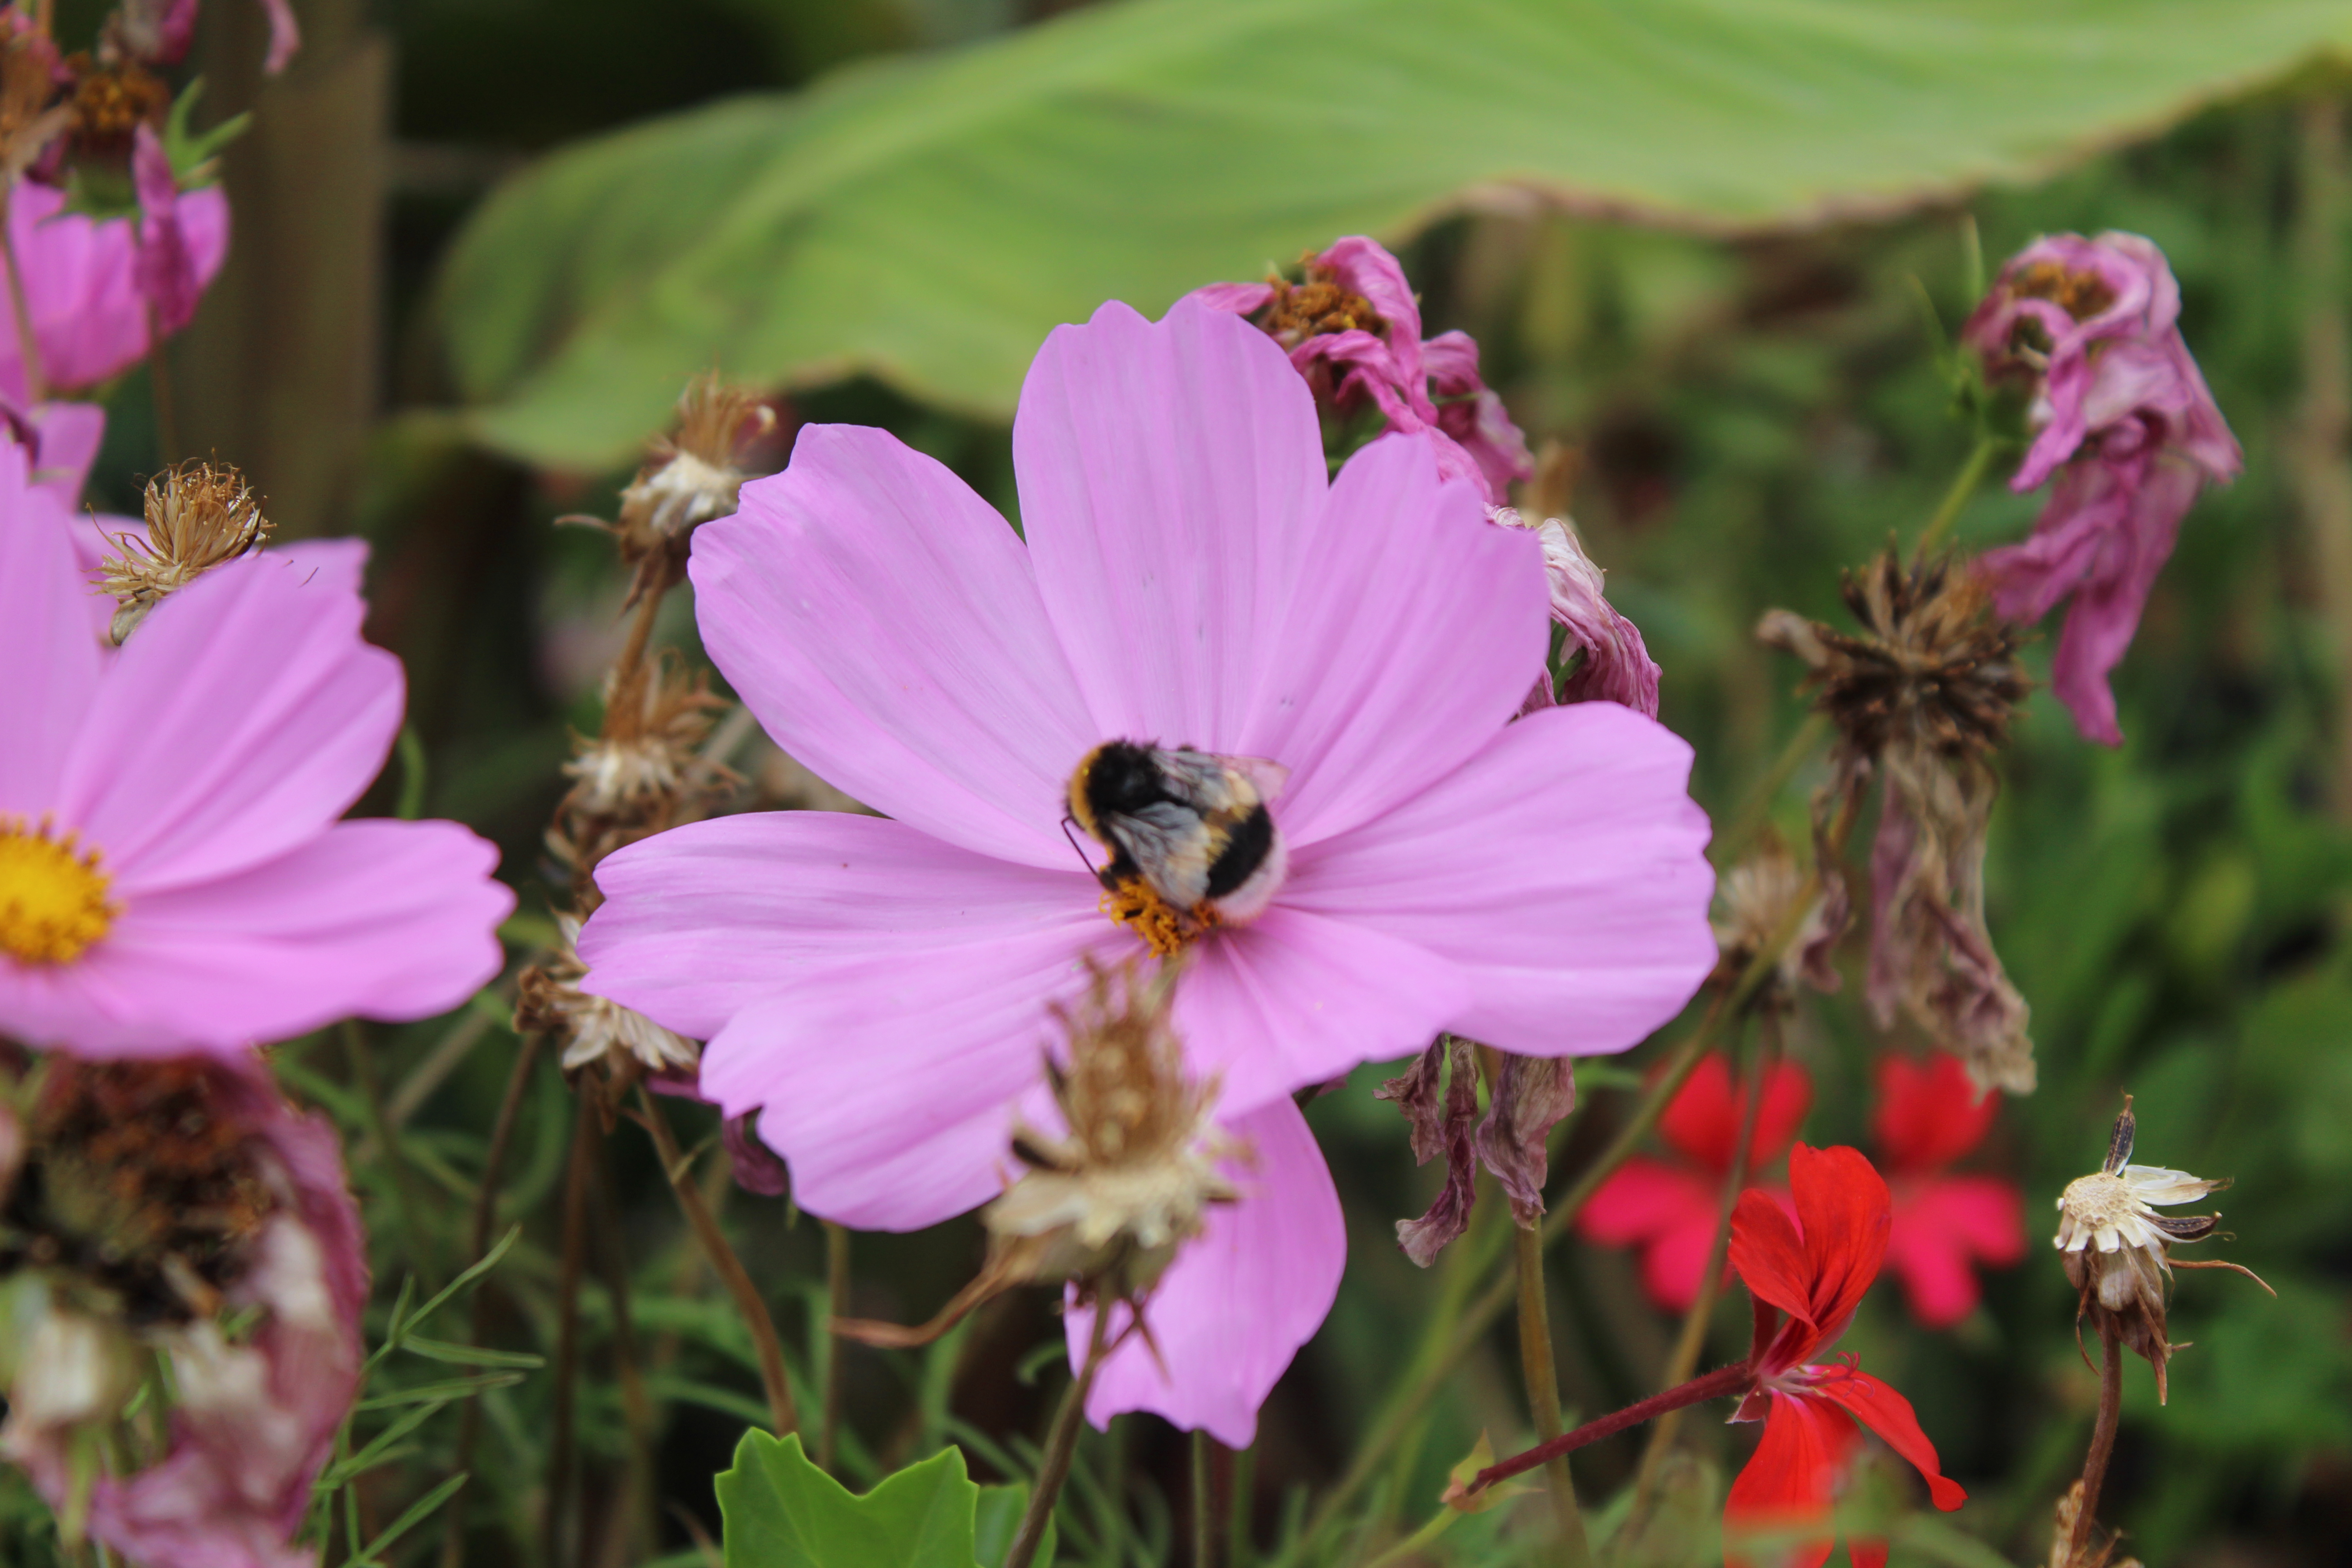
Vamos segmentar tudo. points-per-batch permite a inferência paralela de pontos no modo segment everything. Isso permite uma inferência mais rápida, mas consome mais memória. Além disso, o SAM só permite batching sobre os pontos e não sobre as imagens. pred_iou_thresh é o limiar de confiança de IoU, no qual apenas as máscaras acima desse determinado limiar são retornadas.
masks = mask_generator(image, points_per_batch=128, pred_iou_thresh=0.88)As masks têm o seguinte formato:
{'masks': [tensor([[False, False, False,  ...,  True,  True,  True],
          [False, False, False,  ...,  True,  True,  True],
          [False, False, False,  ...,  True,  True,  True],
          ...,
          [False, False, False,  ..., False, False, False], ..
 'scores': tensor([0.9874, 0.9793, 0.9780, 0.9776, ... 0.9016])}
Podemos visualizá-los da seguinte forma:
import matplotlib.pyplot as plt

plt.imshow(image, cmap='gray')

for i, mask in enumerate(masks["masks"]):
    plt.imshow(mask, cmap='viridis', alpha=0.1, vmin=0, vmax=1)

plt.axis('off')
plt.show()
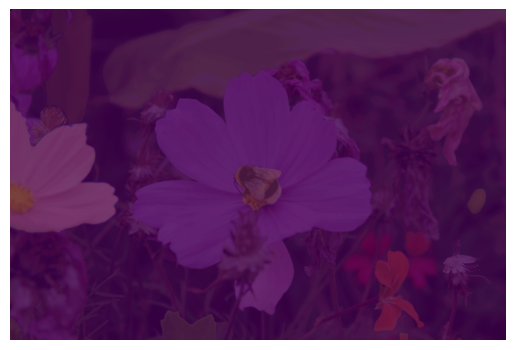
Abaixo está a imagem original em escala de cinza com mapas coloridos sobrepostos. Muito impressionante.
Inferência de Modelo
Prompting de Pontos
Você também pode usar o modelo sem o pipeline. Para isso, inicialize o modelo e o processador.
from transformers import SamModel, SamProcessor
from accelerate import Accelerator
import torch
device = Accelerator().device
model = SamModel.from_pretrained("facebook/sam-vit-base").to(device)
processor = SamProcessor.from_pretrained("facebook/sam-vit-base")
Para fazer point prompting, passe o ponto de entrada para o processor, em seguida, pegue a saída do processor e passe-a para o modelo para inferência. Para pós-processar a saída do modelo, passe as saídas e original_sizes são obtidos da saída inicial do processor. Precisamos passar esses valores porque o processor redimensiona a imagem e a saída precisa ser extrapolada.
input_points = [[[2592, 1728]]] # point location of the bee

inputs = processor(image, input_points=input_points, return_tensors="pt").to(device)
with torch.no_grad():
    outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"].cpu())
Podemos visualizar as três máscaras na saída masks.
import matplotlib.pyplot as plt
import numpy as np

fig, axes = plt.subplots(1, 4, figsize=(15, 5))

axes[0].imshow(image)
axes[0].set_title('Original Image')
mask_list = [masks[0][0][0].numpy(), masks[0][0][1].numpy(), masks[0][0][2].numpy()]

for i, mask in enumerate(mask_list, start=1):
    overlayed_image = np.array(image).copy()

    overlayed_image[:,:,0] = np.where(mask == 1, 255, overlayed_image[:,:,0])
    overlayed_image[:,:,1] = np.where(mask == 1, 0, overlayed_image[:,:,1])
    overlayed_image[:,:,2] = np.where(mask == 1, 0, overlayed_image[:,:,2])

    axes[i].imshow(overlayed_image)
    axes[i].set_title(f'Mask {i}')
for ax in axes:
    ax.axis('off')

plt.show()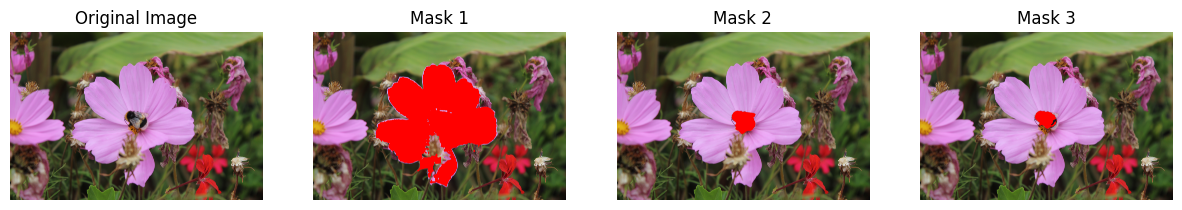
Box Prompting
Você também pode fazer box prompting de forma semelhante ao point prompting. Basta passar a caixa de entrada no formato de lista [x_min, y_min, x_max, y_max] junto com a imagem para o processor. Pegue a saída do processor e passe-a diretamente para o modelo, depois faça o pós-processamento da saída novamente.
# bounding box around the bee
box = [2350, 1600, 2850, 2100]

inputs = processor(
        image,
        input_boxes=[[[box]]],
        return_tensors="pt"
    ).to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

mask = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(),
    inputs["original_sizes"].cpu(),
)[0][0][0].numpy()
Você pode visualizar a caixa delimitadora ao redor da abelha, conforme mostrado abaixo.
import matplotlib.patches as patches

fig, ax = plt.subplots()
ax.imshow(image)

rectangle = patches.Rectangle((2350, 1600), 500, 500, linewidth=2, edgecolor='r', facecolor='none')
ax.add_patch(rectangle)
ax.axis("off")
plt.show()
Você pode ver a saída de inferência abaixo.
fig, ax = plt.subplots()
ax.imshow(image)
ax.imshow(mask, cmap='viridis', alpha=0.4)

ax.axis("off")
plt.show()
Fine-tuning para geração de máscaras
Vamos fazer o fine-tuning do SAM2.1 em uma pequena parte do conjunto de dados MicroMat para matting de imagem. Precisamos instalar a biblioteca monai para usar a perda DICE e o trackio para registrar as máscaras durante o treinamento.
pip install -q datasets monai trackio
```
We can now load our dataset and take a look.

```python
from datasets import load_dataset

dataset = load_dataset("merve/MicroMat-mini", split="train")
dataset
# Dataset({
#    features: ['image', 'mask', 'prompt', 'image_id', 'object_id', 'sample_idx', 'granularity',
# 'image_path', 'mask_path', 'prompt_path'],  num_rows: 94
#})
Precisamos das colunas de imagem, máscara e prompt. Fazemos a divisão para treino e teste.
dataset = dataset.train_test_split(test_size=0.1)
train_ds = dataset["train"]
val_ds = dataset["test"]
Vamos dar uma olhada em uma amostra.
train_ds[0] {'image': <PIL.PngImagePlugin.PngImageFile image mode=RGB size=2040x1356>,
'mask': <PIL.PngImagePlugin.PngImageFile image mode=L size=2040x1356>,
'prompt': '{"point": [[137, 1165, 1], [77, 1273, 0], [58, 1351, 0]], "bbox": [0, 701, 251, 1356]}',
'image_id': '0034',
'object_id': '34',
'sample_idx': 1,
'granularity': 'fine',
'image_path': '/content/MicroMat-mini/img/0034.png',
'mask_path': '/content/MicroMat-mini/mask/0034_34.png',
'prompt_path': '/content/MicroMat-mini/prompt/0034_34.json'}Prompts são strings de dicionários, portanto, você pode obter as bounding boxes conforme mostrado abaixo.
import json

json.loads(train_ds["prompt"][0])["bbox"]
# [0, 701, 251, 1356]
Visualize uma imagem de exemplo, um prompt e uma máscara.
import matplotlib.pyplot as plt
import numpy as np

def show_mask(mask, ax):
    color = np.array([0.12, 0.56, 1.0, 0.6])
    mask = np.array(mask)
    h, w = mask.shape
    mask_image = mask.reshape(h, w, 1) * color.reshape(1, 1, 4)
    ax.imshow(mask_image)
    x0, y0, x1, y1 = eval(train_ds["prompt"][0])["bbox"]
    ax.add_patch(
        plt.Rectangle((x0, y0), x1 - x0, y1 - y0,
                      fill=False, edgecolor="lime", linewidth=2))

example = train_ds[0]
image = np.array(example["image"])
ground_truth_mask = np.array(example["mask"])

fig, ax = plt.subplots()
ax.imshow(image)
show_mask(ground_truth_mask, ax)
ax.set_title("Ground truth mask")
ax.set_axis_off()

plt.show()
Agora podemos definir nosso dataset para carregar os dados. O SAMDataset encapsula nosso dataset e formata cada amostra da maneira que o processador do SAM espera. Assim, em vez de imagens e máscaras brutas, você obtém imagens processadas, bounding boxes e máscaras de ground-truth prontas para o treinamento.
Por padrão, o processor redimensiona as imagens, portanto, além das imagens e máscaras, ele também retorna os tamanhos originais. Também precisamos binarizar a máscara, pois ela possui valores [0, 255].
from torch.utils.data import Dataset
import torch

class SAMDataset(Dataset):
  def __init__(self, dataset, processor):
    self.dataset = dataset
    self.processor = processor

  def __len__(self):
    return len(self.dataset)

  def __getitem__(self, idx):
    item = self.dataset[idx]
    image = item["image"]
    prompt = eval(item["prompt"])["bbox"]
    inputs = self.processor(image, input_boxes=[[prompt]], return_tensors="pt")
    inputs["ground_truth_mask"] = (np.array(item["mask"]) > 0).astype(np.float32)
    inputs["original_image_size"] = torch.tensor(image.size[::-1])


    return inputs
Podemos inicializar o processador e o conjunto de dados com ele.
from transformers import Sam2Processor

processor = Sam2Processor.from_pretrained("facebook/sam2.1-hiera-small")
train_dataset = SAMDataset(dataset=train_ds, processor=processor)
```

We need to define a data collator that will turn varying size of ground truth masks to batches of reshaped masks in same shape. We reshape them using nearest neighbor interpolation. We also make batched tensors for rest of the elements in the batch. If your masks are all of same size, feel free to skip this step.

```python
import torch.nn.functional as F

def collate_fn(batch, target_hw=(256, 256)):

    pixel_values = torch.cat([item["pixel_values"] for item in batch], dim=0)
    original_sizes = torch.stack([item["original_sizes"] for item in batch])
    input_boxes = torch.cat([item["input_boxes"] for item in batch], dim=0)
    ground_truth_masks = torch.cat([
        F.interpolate(
            torch.as_tensor(x["ground_truth_mask"]).unsqueeze(0).unsqueeze(0).float(),
            size=(256, 256),
            mode="nearest"
        )
        for x in batch
    ], dim=0).long()

    return {
        "pixel_values": pixel_values,
        "original_sizes": original_sizes,
        "input_boxes": input_boxes,
        "ground_truth_mask": ground_truth_masks,
        "original_image_size": torch.stack([item["original_image_size"] for item in batch]),
    }

from torch.utils.data import DataLoader
train_dataloader = DataLoader(
    train_dataset,
    batch_size=4,
    shuffle=True,
    collate_fn=collate_fn,
)
Vamos dar uma olhada no que o data loader produz.
batch = next(iter(train_dataloader))
for k,v in batch.items():
  print(k,v.shape)

# pixel_values torch.Size([4, 3, 1024, 1024])
# original_sizes torch.Size([4, 1, 2])
# input_boxes torch.Size([4, 1, 4])
# ground_truth_mask torch.Size([4, 1, 256, 256])
#original_image_size torch.Size([4, 2])
Agora, carregaremos o modelo e congelaremos o codificador de visão e o codificador de prompt para treinar apenas o decodificador de máscara.
from transformers import Sam2Model

model = Sam2Model.from_pretrained("facebook/sam2.1-hiera-small")

for name, param in model.named_parameters():
  if name.startswith("vision_encoder") or name.startswith("prompt_encoder"):
    param.requires_grad_(False)
```

We can now define the optimizer and the loss function.
```python
from torch.optim import Adam
import monai

optimizer = Adam(model.mask_decoder.parameters(), lr=1e-5, weight_decay=0)
seg_loss = monai.losses.DiceCELoss(sigmoid=True, squared_pred=True, reduction='mean')
Vamos ver como o modelo se comporta antes do treinamento.
import matplotlib.pyplot as plt

item = val_ds[1]
img = item["image"]
bbox = json.loads(item["prompt"])["bbox"]
inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

with torch.no_grad():
  outputs = model(**inputs)

masks = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]
preds = masks.squeeze(0)
mask = (preds[0] > 0).cpu().numpy()

overlay = np.asarray(img, dtype=np.uint8).copy()
overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)

plt.imshow(overlay)
plt.axis("off")
plt.show()
Precisamos registrar nossas previsões no trackio para que possamos monitorar a melhoria do modelo no meio do treinamento.
from PIL import Image
import trackio
import json


@torch.no_grad()
def predict_fn(img, bbox):

  inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

  with torch.no_grad():
      outputs = model(**inputs)

  masks = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]
  return masks

def log_eval_masks_trackio(dataset, indices, step, predict_fn,  project=None, sample_cap=8):
    logs = {"eval/step": int(step)}
    for idx in indices[:sample_cap]:
        item = dataset[idx]
        img = item["image"]
        bbox = json.loads(item["prompt"])["bbox"]
        preds = predict_fn(img, bbox)
        preds = preds.squeeze(0)
        mask = (preds[0] > 0).cpu().numpy()

        overlay = np.asarray(img, dtype=np.uint8).copy()
        overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)
        logs[f"{idx}/overlay"] = trackio.Image(overlay, caption="overlay")

    trackio.log(logs)
Agora podemos escrever nosso loop de treinamento e treinar!
Observe como registramos nossa perda e as máscaras de avaliação com trackio.
from tqdm import tqdm
from statistics import mean
import trackio
import torch

num_epochs = 30

device = torch.accelerator.current_accelerator().type if torch.accelerator.is_available() else "cpu"
model.to(device)

model.train()
trackio.init(project="mask-eval")
for epoch in range(num_epochs):
    epoch_losses = []
    for batch in tqdm(train_dataloader):
      outputs = model(pixel_values=batch["pixel_values"].to(device),
                      input_boxes=batch["input_boxes"].to(device),
                      multimask_output=False)

      predicted_masks = outputs.pred_masks.squeeze(1)
      ground_truth_masks = batch["ground_truth_mask"].float().to(device)
      loss = seg_loss(predicted_masks, ground_truth_masks)

      optimizer.zero_grad()
      loss.backward()

      optimizer.step()
      epoch_losses.append(loss.item())

    log_eval_masks_trackio(dataset=val_ds, indices=[0, 3, 6, 9], step=epoch, predict_fn=predict_fn, project="mask-eval")
    print(f'Epoch: {epoch}')
    print(f'Mean loss: {mean(epoch_losses)}')
    trackio.log({"loss": mean(epoch_losses)})

trackio.finish()
Vamos colocar o modelo treinado à prova.
import matplotlib.pyplot as plt

item = val_ds[1]
img = item["image"]
bbox = json.loads(item["prompt"])["bbox"]

inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

with torch.no_grad():
  outputs = model(**inputs)

preds = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]

preds = preds.squeeze(0)
mask = (preds[0] > 0).cpu().numpy()

overlay = np.asarray(img, dtype=np.uint8).copy()
overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)

plt.imshow(overlay)
plt.axis("off")
plt.show()
Melhora significativa após apenas 20 épocas de treinamento em um pequeno conjunto de dados!
