
Transformers documentation
Estimativa de profundidade monocular
Estimativa de profundidade monocular
A estimativa de profundidade monocular é uma tarefa de visão computacional que envolve prever as informações de profundidade de uma cena a partir de uma única imagem. Em outras palavras, é o processo de estimar a distância dos objetos em uma cena a partir de um único ponto de vista de câmera.
A estimativa de profundidade monocular tem diversas aplicações, incluindo reconstrução 3D, realidade aumentada, direção autônoma e robótica. Trata-se de uma tarefa desafiadora, pois exige que o modelo compreenda as relações complexas entre os objetos na cena e as informações de profundidade correspondentes, que podem ser afetadas por fatores como condições de iluminação, oclusão e textura.
Existem duas principais categorias de estimativa de profundidade:
Estimação de profundidade absoluta: Essa variante de tarefa visa fornecer medições exatas de profundidade a partir da câmera. O termo é usado de forma intercambiável com a estimativa de profundidade métrica, na qual a profundidade é fornecida em medições precisas em metros ou pés. Os modelos de estimativa de profundidade absoluta geram mapas de profundidade com valores numéricos que representam distâncias do mundo real.
Estimativa de profundidade relativa: A estimativa de profundidade relativa visa prever a ordem de profundidade dos objetos ou pontos em uma cena sem fornecer medições precisas. Esses modelos geram um mapa de profundidade que indica quais partes da cena estão mais próximas ou mais distantes em relação umas às outras, sem as distâncias reais entre A e B.
Neste guia, veremos como realizar inferência com Depth Anything V2, um modelo de estado da arte para estimativa relativa de profundidade zero-shot, e ZoeDepth, um modelo de estimativa absoluta de profundidade.
Consulte a página da tarefa Depth Estimation para ver todas as arquiteturas e checkpoints compatíveis.
Antes de começarmos, precisamos instalar a versão mais recente do Transformers:
pip install -q -U transformers
Pipeline de estimativa de profundidade
A maneira mais simples de testar a inferência com um modelo que suporta estimativa de profundidade é usar o pipeline() correspondente. Instancie um pipeline a partir de um checkpoint no Hugging Face Hub:
>>> from transformers import pipeline
from accelerate import Accelerator
>>> import torch
>>> device = Accelerator().device
>>> checkpoint = "depth-anything/Depth-Anything-V2-base-hf"
>>> pipe = pipeline("depth-estimation", model=checkpoint, device=device)
Em seguida, escolha uma imagem para analisar:
>>> from PIL import Image
>>> import requests

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image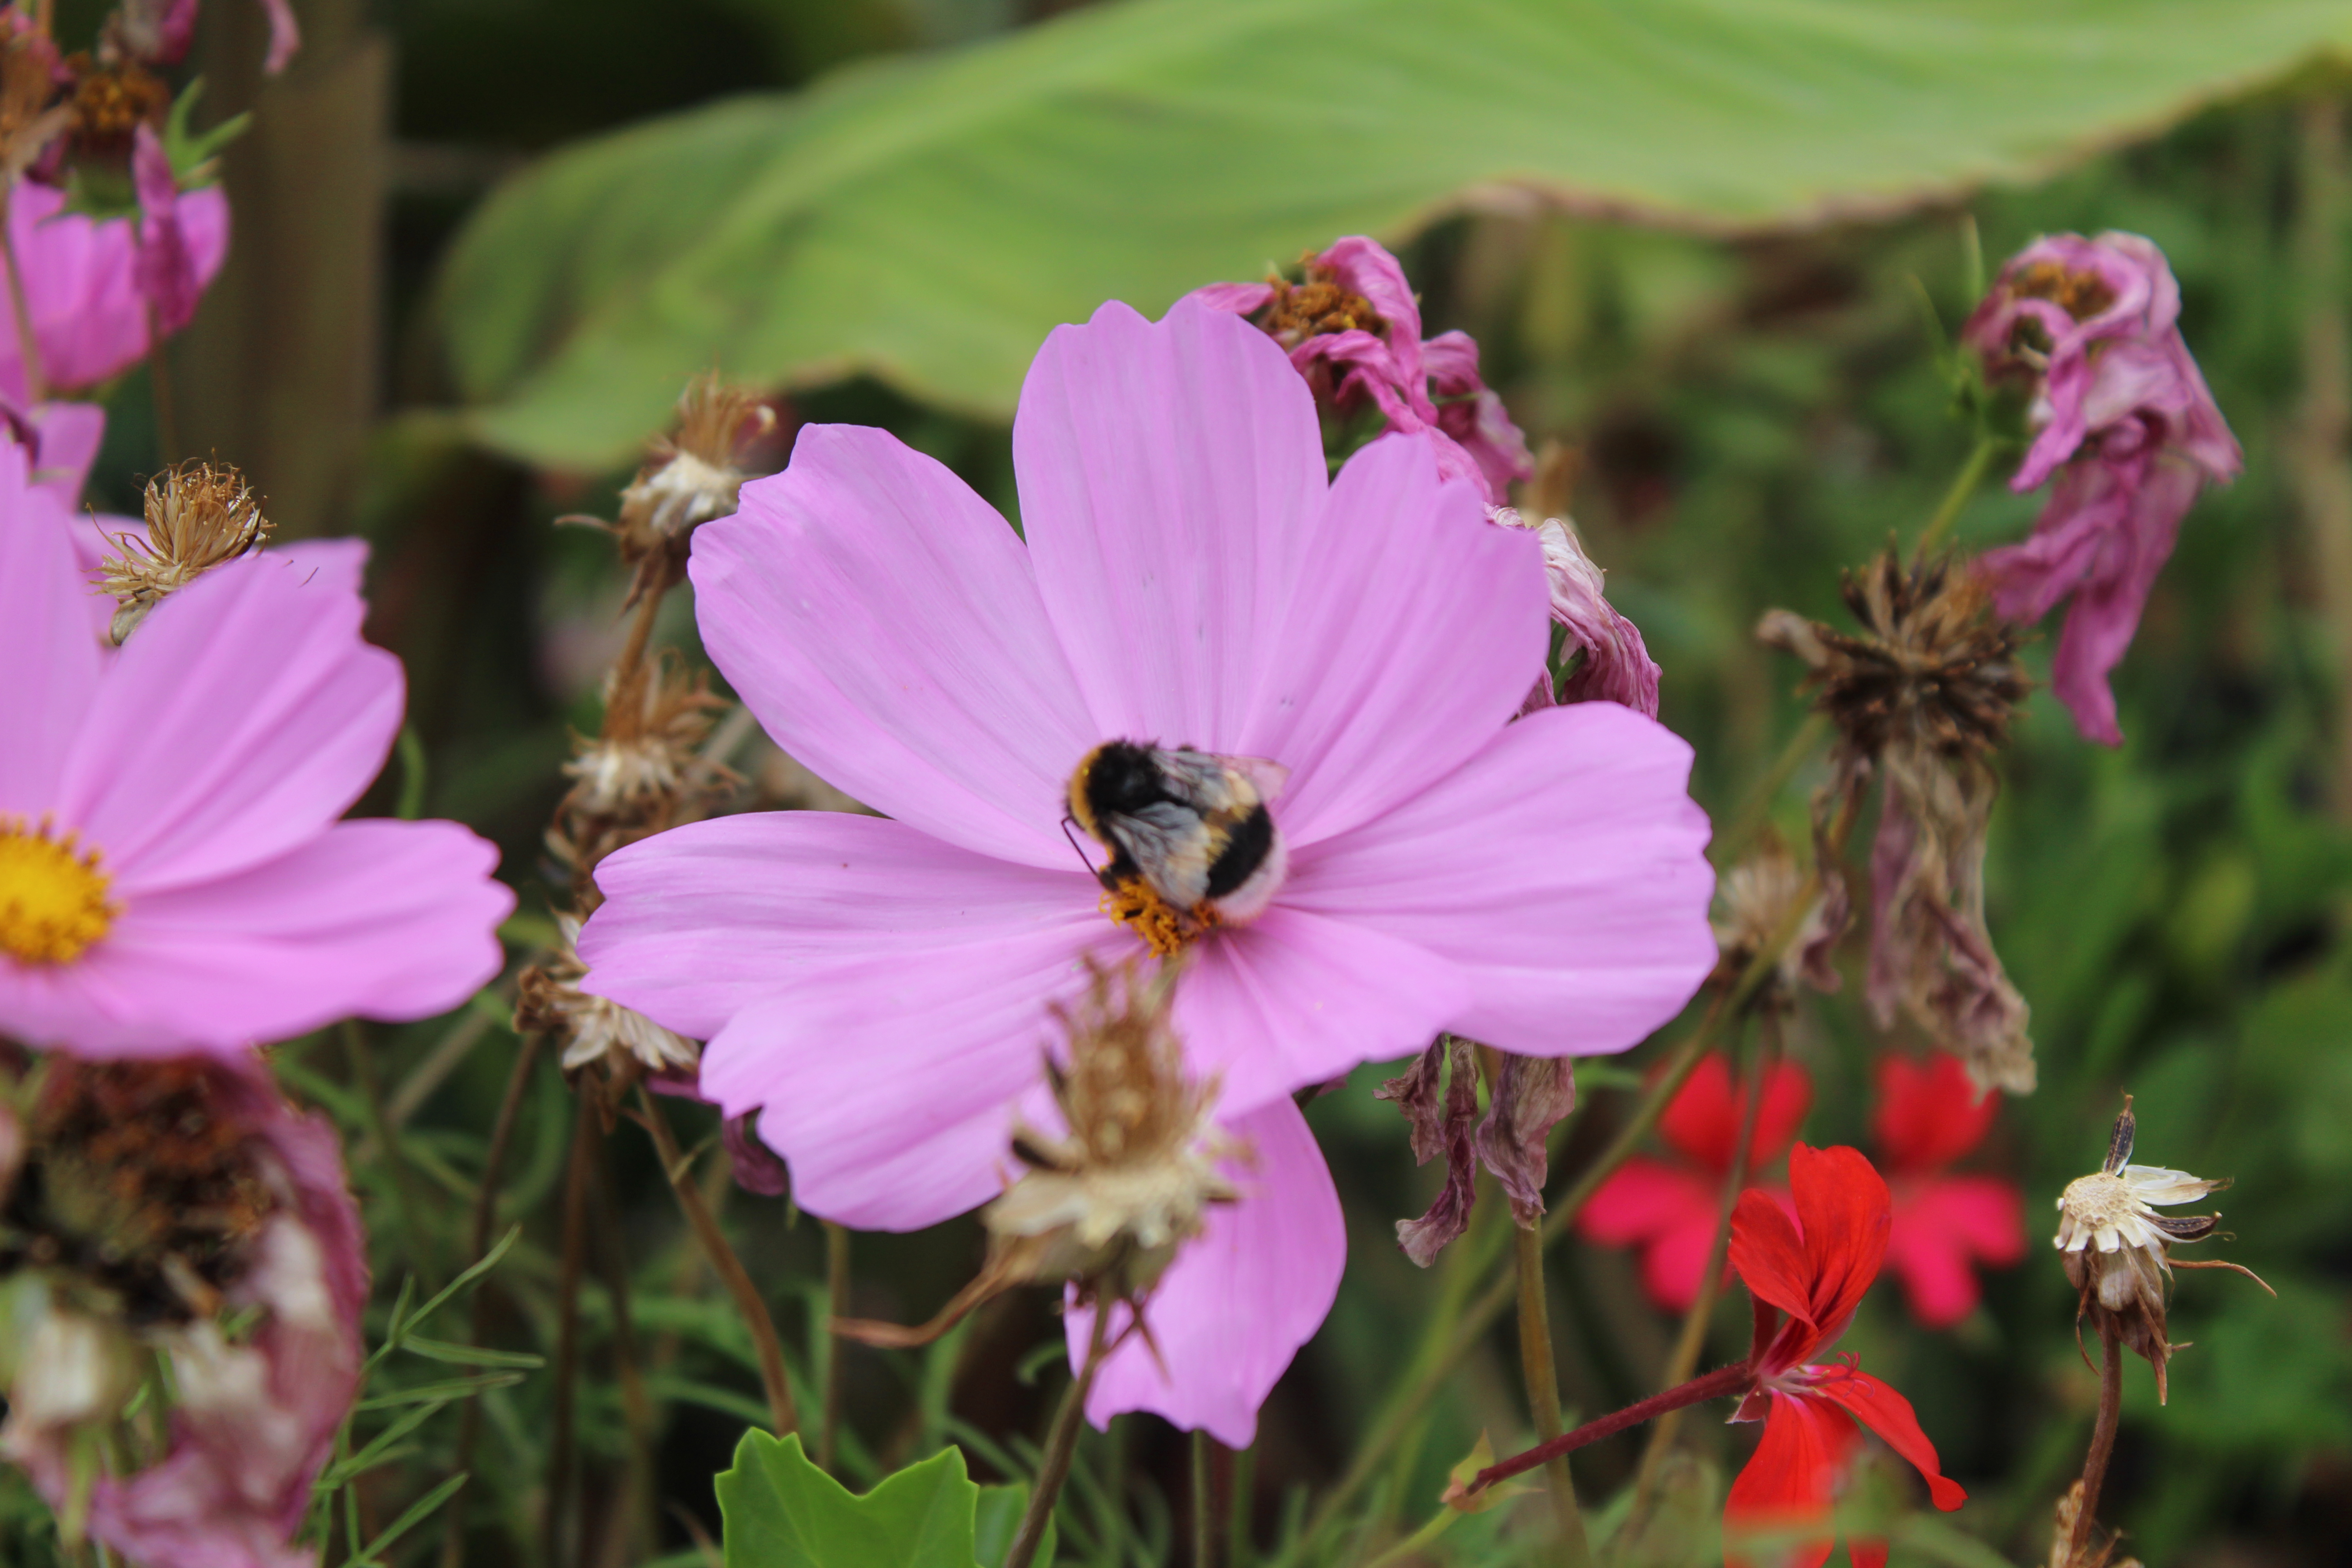
Passe a imagem para o pipeline.
>>> predictions = pipe(image)O pipeline retorna um dicionário com duas entradas. A primeira, chamada predicted_depth, é um tensor cujos valores representam a profundidade expressa em metros para cada pixel.
A segunda, depth, é uma imagem PIL que visualiza o resultado da estimativa de profundidade.
Vamos dar uma olhada no resultado visualizado:
>>> predictions["depth"]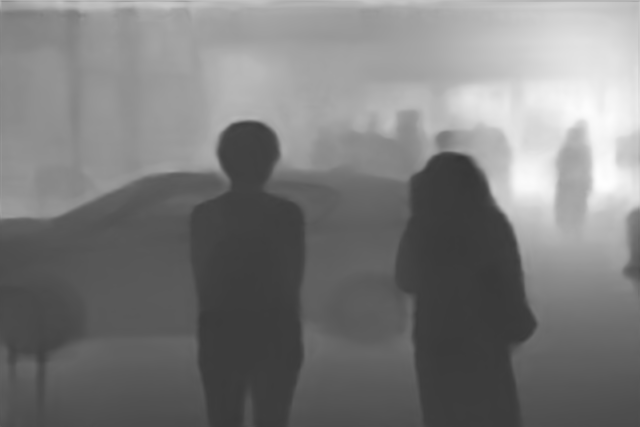
Inferência de estimativa de profundidade manualmente
Agora que você viu como usar o pipeline de estimativa de profundidade, vamos ver como podemos replicar o mesmo resultado manualmente.
Comece carregando o modelo e o processador associado de um checkpoint no Hugging Face Hub. Aqui, usaremos o mesmo checkpoint de antes:
>>> from transformers import AutoImageProcessor, AutoModelForDepthEstimation

>>> checkpoint = "Intel/zoedepth-nyu-kitti"

>>> image_processor = AutoImageProcessor.from_pretrained(checkpoint)
>>> model = AutoModelForDepthEstimation.from_pretrained(checkpoint).to(device)
Prepare a entrada de imagem para o modelo usando o image_processor, que cuidará das transformações de imagem necessárias, como redimensionamento e normalização:
>>> pixel_values = image_processor(image, return_tensors="pt").pixel_values.to(device)Passe os dados de entrada preparados pelo modelo:
>>> import torch

>>> with torch.no_grad():
...     outputs = model(pixel_values)
Vamos fazer o pós-processamento dos resultados para remover qualquer padding e redimensionar o mapa de profundidade para corresponder ao tamanho da imagem original. O post_process_depth_estimation retorna uma lista de dicionários contendo o "predicted_depth".
>>> # ZoeDepth dynamically pads the input image. Thus we pass the original image size as argument
>>> # to `post_process_depth_estimation` to remove the padding and resize to original dimensions.
>>> post_processed_output = image_processor.post_process_depth_estimation(
...     outputs,
...     source_sizes=[(image.height, image.width)],
... )

>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = (predicted_depth - predicted_depth.min()) / (predicted_depth.max() - predicted_depth.min())
>>> depth = depth.detach().cpu().numpy() * 255
>>> depth = Image.fromarray(depth.astype("uint8"))
Na implementação original, o modelo ZoeDepth executa a inferência tanto na imagem original quanto na imagem invertida e calcula a média dos resultados. A função
post_process_depth_estimationpode lidar com isso para nós, passando as saídas invertidas para o argumento opcionaloutputs_flipped:>>> with torch.no_grad(): ... outputs = model(pixel_values) ... outputs_flipped = model(pixel_values=torch.flip(inputs.pixel_values, dims=[3])) >>> post_processed_output = image_processor.post_process_depth_estimation( ... outputs, ... source_sizes=[(image.height, image.width)], ... outputs_flipped=outputs_flipped, ... )
