
Transformers documentation
Texto para fala
Texto para fala
Text-to-speech (TTS) é a tarefa de criar fala com aparência natural a partir de texto, na qual a fala pode ser gerada em vários idiomas e para vários falantes. Vários modelos de text-to-speech estão atualmente disponíveis no 🤗 Transformers, como Dia, CSM, Bark, MMS, VITS e SpeechT5.
Você pode gerar áudio facilmente usando o pipeline "text-to-audio" (ou seu alias - "text-to-speech").
Aqui está um exemplo de como usar o pipeline "text-to-speech" com CSM:
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-audio", model="sesame/csm-1b")
>>> output = pipe("Hello from Sesame.")
Aqui está um trecho de código que você pode usar para ouvir o áudio resultante em um notebook:
>>> from IPython.display import Audio
>>> Audio(output["audio"], rate=output["sampling_rate"])
Por padrão, o CSM usa uma voz aleatória. Você pode fazer clonagem de voz fornecendo um áudio de referência como parte de um dicionário de modelo de chat:
>>> import soundfile as sf
>>> import torch
>>> from datasets import Audio, load_dataset
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-audio", model="sesame/csm-1b")

>>> ds = load_dataset("hf-internal-testing/dailytalk-dummy", split="train")
>>> ds = ds.cast_column("audio", Audio(sampling_rate=24000))
>>> conversation = [
...     {
...         "role": "0",
...         "content": [
...             {"type": "text", "text": "What are you working on?"},
...             {"type": "audio", "path": ds[0]["audio"]["array"]},
...         ],
...     },
...     {"role": "0", "content": [{"type": "text", "text": "How much money can you spend?"}]},
... ]
>>> output = pipe(conversation)
Alguns modelos, como o Dia, também podem ser condicionados para gerar comunicações não verbais, como risos, suspiros e choro, ou até mesmo adicionar música. Abaixo está um exemplo:
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-speech", model="nari-labs/Dia-1.6B-0626")
>>> text = "[S1] (clears throat) Hello! How are you? [S2] I'm good, thanks! How about you?"
>>> output = pipe(text)
Observe que o Dia também aceita tags de falante, como [S1] e [S2], para gerar uma conversa entre vozes únicas.
Para mais exemplos do que o CSM e outros modelos de TTS pré-treinados podem fazer, consulte nosso curso de áudio.
Se você deseja fazer o ajuste fino de um modelo de TTS, os únicos modelos de texto para fala atualmente disponíveis no 🤗 Transformers são SpeechT5, FastSpeech2Conformer, Dia e CSM, embora mais sejam adicionados no futuro. O SpeechT5 é pré-treinado em uma combinação de dados de fala para texto e texto para fala, permitindo que ele aprenda um espaço unificado de representações ocultas compartilhadas por texto e fala. Isso significa que o mesmo modelo pré-treinado pode ser ajustado para diferentes tarefas. Além disso, o SpeechT5 suporta múltiplos falantes por meio de incorporações de falante x-vector.
O restante deste guia ilustra como:
- Ajuste finamente o SpeechT5, originalmente treinado em fala em inglês, no subconjunto em holandês (
nl) do conjunto de dados VoxPopuli. - Use seu modelo refinado para inferência de uma das duas formas: usando um pipeline ou diretamente.
Antes de começar, verifique se você tem todas as bibliotecas necessárias instaladas:
pip install transformers datasets soundfile librosa torchcodec speechbrain accelerate
Instale o 🤗Transformers a partir do código-fonte, pois nem todos os recursos do SpeechT5 foram incorporados a uma versão oficial:
pip install git+https://github.com/huggingface/transformers.git
Para seguir este guia, você precisará de uma GPU. Se estiver trabalhando em um notebook, execute a linha a seguir para verificar se uma GPU está disponível:
!nvidia-smiou, alternativamente, para GPUs AMD:
!rocm-smi
Recomendamos que você faça login na sua conta do Hugging Face para enviar e compartilhar seu modelo com a comunidade. Quando solicitado, insira seu token para fazer login:
>>> from huggingface_hub import notebook_login

>>> notebook_login()
Carregue o conjunto de dados
VoxPopuli é um corpus de fala multilíngue em larga escala, composto por dados extraídos de gravações de eventos do Parlamento Europeu entre 2009 e 2020. Ele contém dados de áudio e transcrição rotulados para 15 idiomas europeus. Neste guia, utilizamos o subconjunto em holandês, mas você é livre para escolher outro subconjunto.
Observe que o VoxPopuli ou qualquer outro conjunto de dados de reconhecimento automático de fala (ASR) pode não ser a opção mais adequada para o treinamento de modelos de TTS. As características que o tornam benéfico para ASR, como o excesso de ruído de fundo, são geralmente indesejáveis em TTS. No entanto, encontrar conjuntos de dados de TTS de alta qualidade, multilíngues e com múltiplos falantes pode ser bastante desafiador.
Vamos carregar os dados:
>>> from datasets import load_dataset, Audio

>>> dataset = load_dataset("qmeeus/voxpopuli", "nl", split="train")
>>> len(dataset)
20968
20968 exemplos devem ser suficientes para o fine-tuning. O SpeechT5 espera que os dados de áudio tenham uma taxa de amostragem de 16 kHz, portanto, verifique se os exemplos no dataset atendem a esse requisito:
dataset = dataset.cast_column("audio", Audio(sampling_rate=16000))Pré-processar os dados
Vamos começar definindo o checkpoint do modelo a ser usado e carregando o processador apropriado:
>>> from transformers import SpeechT5Processor

>>> checkpoint = "microsoft/speecht5_tts"
>>> processor = SpeechT5Processor.from_pretrained(checkpoint)
Limpeza de texto para a tokenização do SpeechT5
Comece limpando os dados de texto. Você precisará da parte de tokenizer do processor para processar o texto:
>>> tokenizer = processor.tokenizerOs exemplos do conjunto de dados contêm um recurso text com a transcrição. Observe que o tokenizer do SpeechT5 não possui tokens para números, portanto, quaisquer números no texto serão convertidos em tokens <unk>. Se o seu conjunto de dados contiver números, considere normalizá-los para a forma escrita.
Como o SpeechT5 foi treinado no idioma inglês, ele pode não reconhecer certos caracteres no conjunto de dados em holandês. Se
deixados como estão, esses caracteres serão convertidos em tokens <unk>. No entanto, em holandês, certos caracteres como à são
usados para marcar a sílaba tônica. Para preservar o significado do texto, podemos substituir esse caractere por um a regular.
Para identificar tokens não suportados, extraia todos os caracteres únicos no conjunto de dados usando o SpeechT5Tokenizer, que
trabalha com caracteres como tokens. Para isso, escreva a função de mapeamento extract_all_chars que concatena
as transcrições de todos os exemplos em uma única string e a converte em um conjunto de caracteres.
Certifique-se de definir batched=True e batch_size=-1 em dataset.map() para que todas as transcrições estejam disponíveis de uma vez para
a função de mapeamento.
>>> def extract_all_chars(batch):
...     all_text = " ".join(batch["text"])
...     vocab = list(set(all_text))
...     return {"vocab": [vocab], "all_text": [all_text]}


>>> vocabs = dataset.map(
...     extract_all_chars,
...     batched=True,
...     batch_size=-1,
...     keep_in_memory=True,
...     remove_columns=dataset.column_names,
... )

>>> dataset_vocab = set(vocabs["vocab"][0])
>>> tokenizer_vocab = {k for k, _ in tokenizer.get_vocab().items()}
Agora você tem dois conjuntos de caracteres: um com o vocabulário do conjunto de dados e outro com o vocabulário do tokenizer. Para identificar quaisquer caracteres não suportados no conjunto de dados, você pode calcular a diferença entre esses dois conjuntos. O conjunto resultante conterá os caracteres que estão no conjunto de dados, mas não no tokenizer.
>>> dataset_vocab - tokenizer_vocab
{' ', 'à', 'ç', 'è', 'ë', 'í', 'ï', 'ö', 'ü'}
Para lidar com os caracteres não suportados identificados na etapa anterior, defina uma função que mapeie esses caracteres para
tokens válidos. Observe que os espaços já são substituídos por ▁ no tokenizer e não precisam ser tratados separadamente.
>>> replacements = [
...     ("à", "a"),
...     ("ç", "c"),
...     ("è", "e"),
...     ("ë", "e"),
...     ("í", "i"),
...     ("ï", "i"),
...     ("ö", "o"),
...     ("ü", "u"),
... ]


>>> def cleanup_text(inputs):
...     for src, dst in replacements:
...         inputs["text"] = inputs["text"].replace(src, dst)
...     return inputs


>>> dataset = dataset.map(cleanup_text)
Agora que você lidou com caracteres especiais no texto, é hora de mudar o foco para os dados de áudio.
Palestrantes
O conjunto de dados VoxPopuli inclui fala de múltiplos falantes, mas quantos falantes estão representados no conjunto de dados? Para determinar isso, podemos contar o número de falantes únicos e o número de exemplos que cada falante contribui para o conjunto de dados. Com um total de 20.968 exemplos no conjunto de dados, essas informações nos darão uma melhor compreensão da distribuição de falantes e exemplos nos dados.
>>> from collections import defaultdict

>>> speaker_counts = defaultdict(int)

>>> for speaker_id in dataset["speaker_id"]:
...     speaker_counts[speaker_id] += 1
Ao plotar um histograma, você pode ter uma noção de quanta dados há para cada falante.
>>> import matplotlib.pyplot as plt

>>> plt.figure()
>>> plt.hist(speaker_counts.values(), bins=20)
>>> plt.ylabel("Speakers")
>>> plt.xlabel("Examples")
>>> plt.show()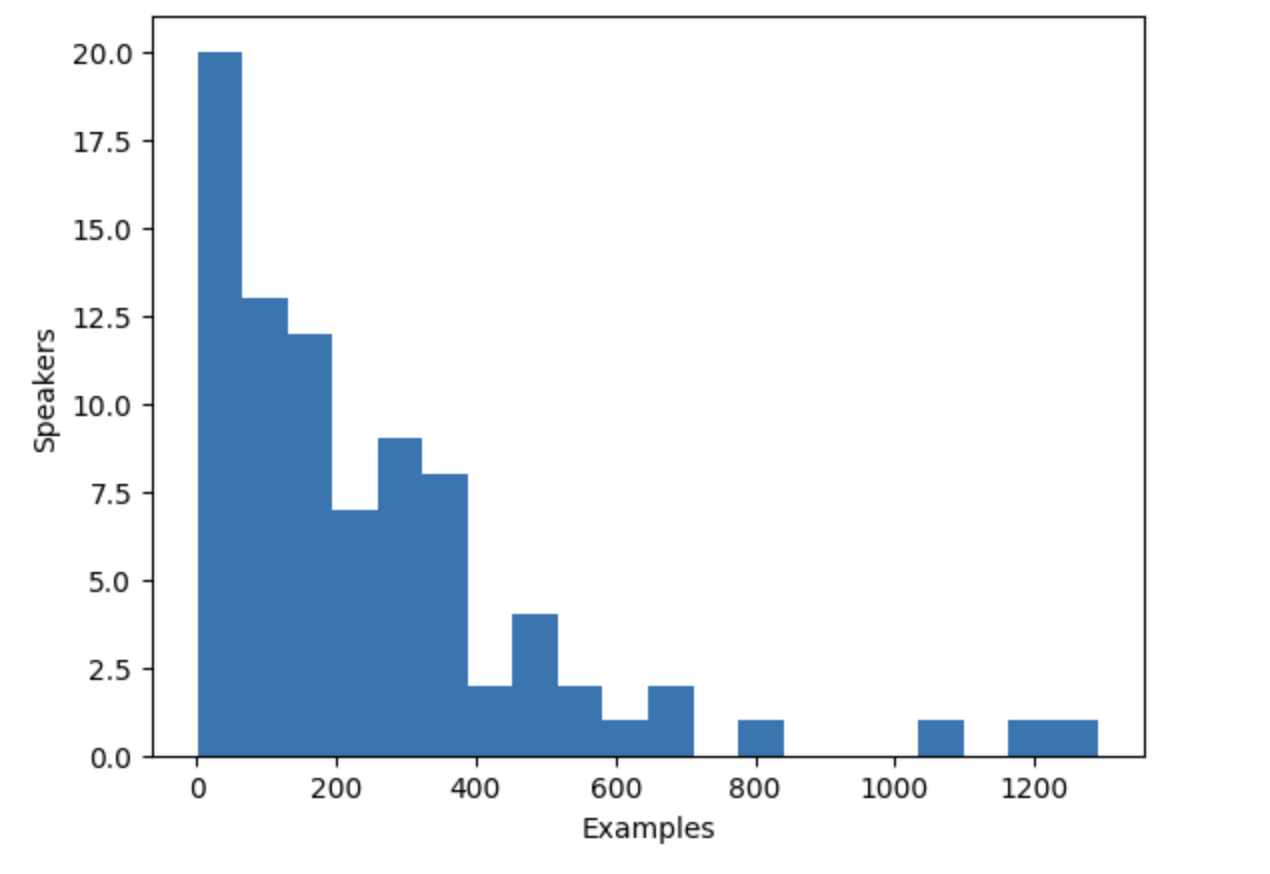
O histograma revela que aproximadamente um terço dos falantes no conjunto de dados possui menos de 100 exemplos, enquanto cerca de dez falantes têm mais de 500 exemplos. Para melhorar a eficiência do treinamento e equilibrar o conjunto de dados, podemos limitar os dados a falantes com entre 100 e 400 exemplos.
>>> def select_speaker(speaker_id):
...     return 100 <= speaker_counts[speaker_id] <= 400


>>> dataset = dataset.filter(select_speaker, input_columns=["speaker_id"])
Vamos verificar quantos falantes restam:
>>> len(set(dataset["speaker_id"]))
42
Vamos ver quantos exemplos restam:
>>> len(dataset)
9973
Você fica com pouco menos de 10.000 exemplos de aproximadamente 40 falantes únicos, o que deve ser suficiente.
Observe que alguns falantes com poucos exemplos podem, na verdade, ter mais áudio disponível caso os exemplos sejam longos. No entanto, determinar a quantidade total de áudio para cada falante exige varrer o conjunto de dados inteiro, o que é um processo demorado que envolve carregar e decodificar cada arquivo de áudio. Por isso, optamos por pular essa etapa aqui.
Incorporações de falante
Para permitir que o modelo de TTS diferencie entre vários falantes, você precisará criar um embedding de falante para cada exemplo. O embedding de falante é uma entrada adicional para o modelo que captura as características vocais de um falante específico. Para gerar esses embeddings de falante, use o modelo pré-treinado spkrec-xvect-voxceleb do SpeechBrain.
Crie uma função create_speaker_embedding() que recebe uma forma de onda de áudio de entrada e retorna um vetor de 512 elementos contendo o embedding correspondente do falante.
>>> import os
>>> import torch
>>> from speechbrain.inference.classifiers import EncoderClassifier
>>> from accelerate import Accelerator

>>> spk_model_name = "speechbrain/spkrec-xvect-voxceleb"
>>> device = Accelerator().device
>>> speaker_model = EncoderClassifier.from_hparams(
...     source=spk_model_name,
...     run_opts={"device": device},
...     savedir=os.path.join("/tmp", spk_model_name),
... )


>>> def create_speaker_embedding(waveform):
...     with torch.no_grad():
...         speaker_embeddings = speaker_model.encode_batch(torch.tensor(waveform))
...         speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2)
...         speaker_embeddings = speaker_embeddings.squeeze().cpu().numpy()
...     return speaker_embeddings
É importante observar que o modelo speechbrain/spkrec-xvect-voxceleb foi treinado com fala em inglês do conjunto de dados VoxCeleb, enquanto os exemplos de treinamento neste guia estão em holandês. Embora acreditemos que este modelo ainda gerará incorporações de falante razoáveis para nosso conjunto de dados em holandês, essa premissa pode não se sustentar em todos os casos.
Para obter os melhores resultados, recomendamos treinar um modelo X-vector no discurso de destino primeiro. Isso garantirá que o modelo seja mais capaz de capturar as características vocais únicas presentes no idioma holandês.
Processando o conjunto de dados
Por fim, vamos processar os dados no formato esperado pelo modelo. Crie uma função prepare_dataset que recebe um único exemplo e usa o objeto SpeechT5Processor para tokenizar o texto de entrada e carregar o áudio de destino em um espectrograma log-mel. Ela também deve adicionar os embeddings de falante como uma entrada adicional.
>>> def prepare_dataset(example):
...     audio = example["audio"]

...     example = processor(
...         text=example["text"],
...         audio_target=audio["array"],
...         sampling_rate=audio["sampling_rate"],
...         return_attention_mask=False,
...     )

...     # strip off the batch dimension
...     example["labels"] = example["labels"][0]

...     # use SpeechBrain to obtain x-vector
...     example["speaker_embeddings"] = create_speaker_embedding(audio["array"])

...     return example
Verifique se o processamento está correto analisando um único exemplo:
>>> processed_example = prepare_dataset(dataset[0])
>>> list(processed_example.keys())
['input_ids', 'labels', 'stop_labels', 'speaker_embeddings']
Os embeddings de falante devem ser um vetor de 512 elementos:
>>> processed_example["speaker_embeddings"].shape
(512,)
Os rótulos devem ser um espectrograma log-mel com 80 bins mel.
>>> import matplotlib.pyplot as plt

>>> plt.figure()
>>> plt.imshow(processed_example["labels"].T)
>>> plt.show()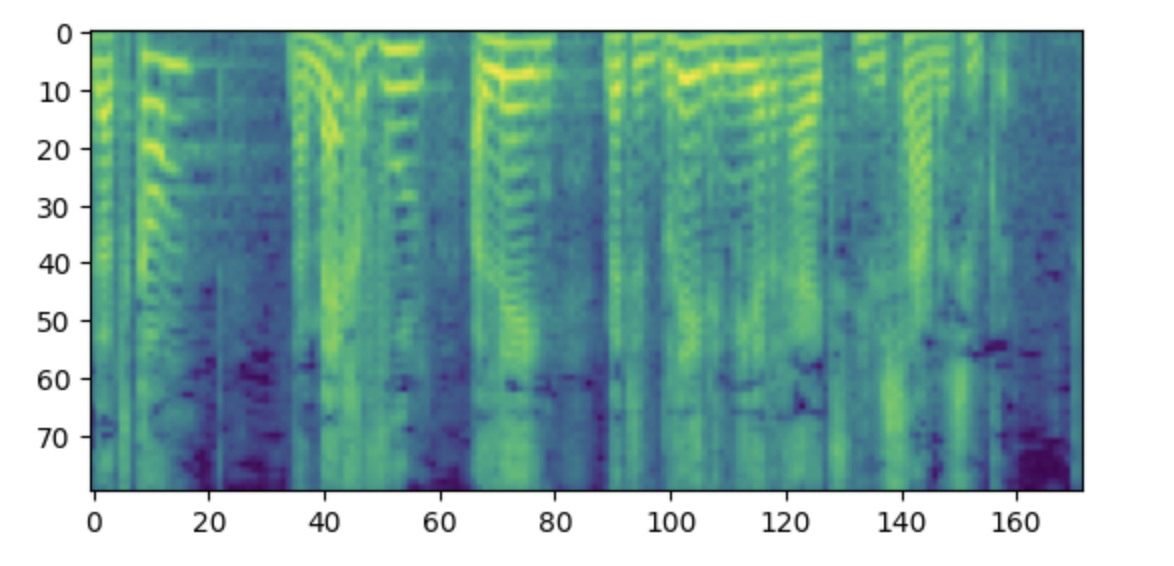
Observação: Se você encontrar este espectrograma confuso, isso pode se dever à sua familiaridade com a convenção de posicionar as frequências baixas na parte inferior e as frequências altas na parte superior de um gráfico. No entanto, ao plotar espectrogramas como uma imagem usando a biblioteca matplotlib, o eixo y é invertido e os espectrogramas aparecem de cabeça para baixo.
Agora, aplique a função de processamento a todo o conjunto de dados. Isso levará entre 5 e 10 minutos.
>>> dataset = dataset.map(prepare_dataset, remove_columns=dataset.column_names)Você verá um aviso informando que alguns exemplos no conjunto de dados são mais longos que o comprimento máximo de entrada que o modelo pode processar (600 tokens). Remova esses exemplos do conjunto de dados. Aqui, vamos ainda mais longe e, para permitir tamanhos de lote maiores, removemos tudo que exceder 200 tokens.
>>> def is_not_too_long(input_ids):
...     input_length = len(input_ids)
...     return input_length < 200


>>> dataset = dataset.filter(is_not_too_long, input_columns=["input_ids"])
>>> len(dataset)
8259
Em seguida, crie uma divisão básica de treino/teste:
>>> dataset = dataset.train_test_split(test_size=0.1)Colaborador de dados
Para combinar múltiplos exemplos em um lote, é necessário definir um data collator personalizado. Este collator irá preencher sequências mais curtas com tokens de padding, garantindo que todos os exemplos tenham o mesmo comprimento. Para os rótulos do espectrograma, as porções preenchidas são substituídas pelo valor especial -100. Esse valor especial instrui o modelo a ignorar aquela parte do espectrograma ao calcular a perda do espectrograma.
>>> from dataclasses import dataclass
>>> from typing import Any, Dict, List, Union


>>> @dataclass
... class TTSDataCollatorWithPadding:
...     processor: Any

...     def __call__(self, features: list[dict[str, Union[list[int], torch.Tensor]]]) -> dict[str, torch.Tensor]:
...         input_ids = [{"input_ids": feature["input_ids"]} for feature in features]
...         label_features = [{"input_values": feature["labels"]} for feature in features]
...         speaker_features = [feature["speaker_embeddings"] for feature in features]

...         # collate the inputs and targets into a batch
...         batch = processor.pad(input_ids=input_ids, labels=label_features, return_tensors="pt")

...         # replace padding with -100 to ignore loss correctly
...         batch["labels"] = batch["labels"].masked_fill(batch.decoder_attention_mask.unsqueeze(-1).ne(1), -100)

...         # not used during fine-tuning
...         del batch["decoder_attention_mask"]

...         # round down target lengths to multiple of reduction factor
...         if model.config.reduction_factor > 1:
...             target_lengths = torch.tensor([len(feature["input_values"]) for feature in label_features])
...             target_lengths = target_lengths.new(
...                 [length - length % model.config.reduction_factor for length in target_lengths]
...             )
...             max_length = max(target_lengths)
...             batch["labels"] = batch["labels"][:, :max_length]

...         # also add in the speaker embeddings
...         batch["speaker_embeddings"] = torch.tensor(speaker_features)

...         return batch
No SpeechT5, a entrada para a parte decodificadora do modelo é reduzida por um fator 2. Em outras palavras, ela descarta cada timestep alternado da sequência de destino. A decodificadora então prevê uma sequência que é duas vezes mais longa. Como o comprimento da sequência de destino original pode ser ímpar, o data collator garante que o comprimento máximo do batch seja arredondado para baixo para ser um múltiplo de 2.
>>> data_collator = TTSDataCollatorWithPadding(processor=processor)Treinar o modelo
Carregue o modelo pré-treinado a partir do mesmo checkpoint que você usou para carregar o processador:
>>> from transformers import SpeechT5ForTextToSpeech

>>> model = SpeechT5ForTextToSpeech.from_pretrained(checkpoint)
A opção use_cache=True é incompatível com gradient checkpointing. Desative-a para o treinamento.
>>> model.config.use_cache = FalseDefina os argumentos de treinamento. Aqui, não estamos calculando nenhuma métrica de avaliação durante o processo de treinamento. Em vez disso, observaremos apenas a perda:
>>> from transformers import Seq2SeqTrainingArguments

>>> training_args = Seq2SeqTrainingArguments(
...     output_dir="speecht5_finetuned_voxpopuli_nl",  # change to a repo name of your choice
...     per_device_train_batch_size=4,
...     gradient_accumulation_steps=8,
...     learning_rate=1e-5,
...     warmup_steps=500,
...     max_steps=4000,
...     gradient_checkpointing=True,
...     fp16=True,
...     eval_strategy="steps",
...     per_device_eval_batch_size=2,
...     save_steps=1000,
...     eval_steps=1000,
...     logging_steps=25,
...     report_to="trackio",
...     load_best_model_at_end=True,
...     greater_is_better=False,
...     label_names=["labels"],
...     push_to_hub=True,
... )
Instancie o objeto Trainer e passe o modelo, o conjunto de dados e o data collator para ele.
>>> from transformers import Seq2SeqTrainer

>>> trainer = Seq2SeqTrainer(
...     args=training_args,
...     model=model,
...     train_dataset=dataset["train"],
...     eval_dataset=dataset["test"],
...     data_collator=data_collator,
...     processing_class=processor,
... )
E com isso, você está pronto para começar o treinamento! O treinamento levará várias horas. Dependendo da sua GPU,
é possível que você encontre um erro de "out-of-memory" do CUDA ao iniciar o treinamento. Nesse caso, você pode reduzir
o per_device_train_batch_size incrementalmente por fatores de 2 e aumentar gradient_accumulation_steps em 2x para compensar.
>>> trainer.train()Para poder usar seu checkpoint com um pipeline, certifique-se de salvar o processador junto com o checkpoint:
>>> processor.save_pretrained("YOUR_ACCOUNT_NAME/speecht5_finetuned_voxpopuli_nl")Envie o modelo final para o 🤗 Hub:
>>> trainer.push_to_hub()Inferência
Inferência com um pipeline
Ótimo, agora que você ajustou um modelo, pode usá-lo para inferência!
Primeiro, vamos ver como você pode usá-lo com um pipeline correspondente. Vamos criar um pipeline "text-to-speech" com seu
checkpoint:
>>> from transformers import pipeline

>>> pipe = pipeline("text-to-speech", model="YOUR_ACCOUNT_NAME/speecht5_finetuned_voxpopuli_nl")
Escolha um trecho de texto em holandês que você deseja narrar, por exemplo:
>>> text = "hallo allemaal, ik praat nederlands. groetjes aan iedereen!"Para usar o SpeechT5 com o pipeline, você precisará de um speaker embedding. Vamos obtê-lo de um exemplo no conjunto de dados de teste:
>>> example = dataset["test"][304]
>>> speaker_embeddings = torch.tensor(example["speaker_embeddings"]).unsqueeze(0)
Agora você pode passar os embeddings de texto e de falante para o pipeline, e ele cuidará do resto:
>>> forward_params = {"speaker_embeddings": speaker_embeddings}
>>> output = pipe(text, forward_params=forward_params)
>>> output
{'audio': array([-6.82714235e-05, -4.26525949e-04,  1.06134125e-04, ...,
        -1.22392643e-03, -7.76011671e-04,  3.29112721e-04], dtype=float32),
 'sampling_rate': 16000}
Em seguida, você pode ouvir o resultado:
>>> from IPython.display import Audio
>>> Audio(output['audio'], rate=output['sampling_rate'])
Execute a inferência manualmente
Você pode obter os mesmos resultados de inferência sem usar o pipeline, no entanto, mais etapas serão necessárias.
Carregue o modelo do 🤗 Hub:
>>> model = SpeechT5ForTextToSpeech.from_pretrained("YOUR_ACCOUNT/speecht5_finetuned_voxpopuli_nl")Escolha um exemplo do conjunto de dados de teste e obtenha um embedding de falante.
>>> example = dataset["test"][304]
>>> speaker_embeddings = torch.tensor(example["speaker_embeddings"]).unsqueeze(0)
Defina o texto de entrada e faça o tokenização.
>>> text = "hallo allemaal, ik praat nederlands. groetjes aan iedereen!"
>>> inputs = processor(text=text, return_tensors="pt")
Crie um espectrograma com seu modelo:
>>> spectrogram = model.generate_speech(inputs["input_ids"], speaker_embeddings)Visualize o espectrograma, se desejar:
>>> plt.figure()
>>> plt.imshow(spectrogram.T)
>>> plt.show()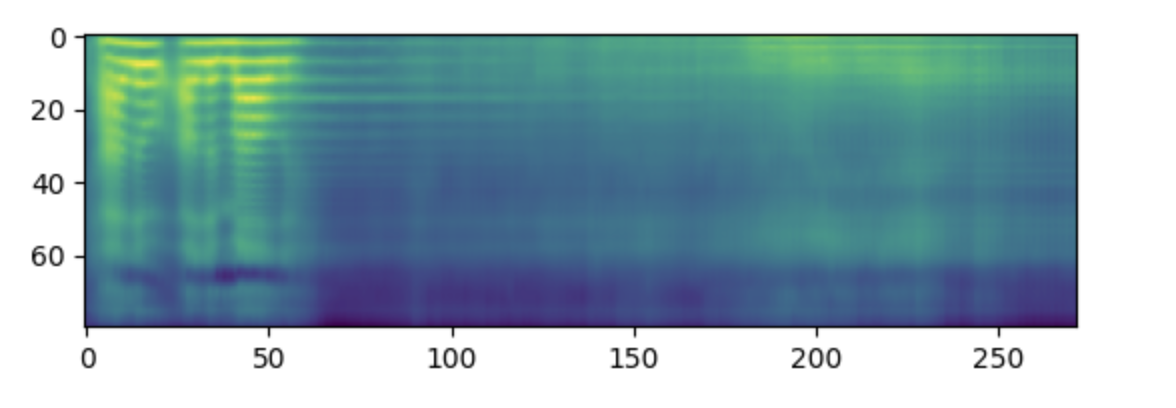
Por fim, use o vocoder para converter o espectrograma em som.
>>> with torch.no_grad():
...     speech = vocoder(spectrogram)

>>> from IPython.display import Audio

>>> Audio(speech.numpy(), rate=16000)
Na nossa experiência, obter resultados satisfatórios com este modelo pode ser desafiador. A qualidade dos embeddings de falante parece ser um fator significativo. Como o SpeechT5 foi pré-treinado com x-vectors em inglês, ele apresenta o melhor desempenho ao usar embeddings de falante em inglês. Se a fala sintetizada soar de baixa qualidade, tente usar um embedding de falante diferente.
Aumentar a duração do treinamento também deve melhorar a qualidade dos resultados. Ainda assim, a fala claramente é em holandês, em vez de inglês, e ela captura as características vocais do falante (compare com o áudio original no exemplo).
Outra coisa para experimentar é a configuração do modelo. Por exemplo, tente usar config.reduction_factor = 1 para
ver se isso melhora os resultados.
Por fim, é essencial considerar as questões éticas. Embora a tecnologia de TTS tenha inúmeras aplicações úteis, ela também pode ser usada para fins maliciosos, como imitar a voz de alguém sem seu conhecimento ou consentimento. Use o TTS com moderação e responsabilidade.
Update on GitHub