
Diffusers documentation
PixArt-α
PixArt-α
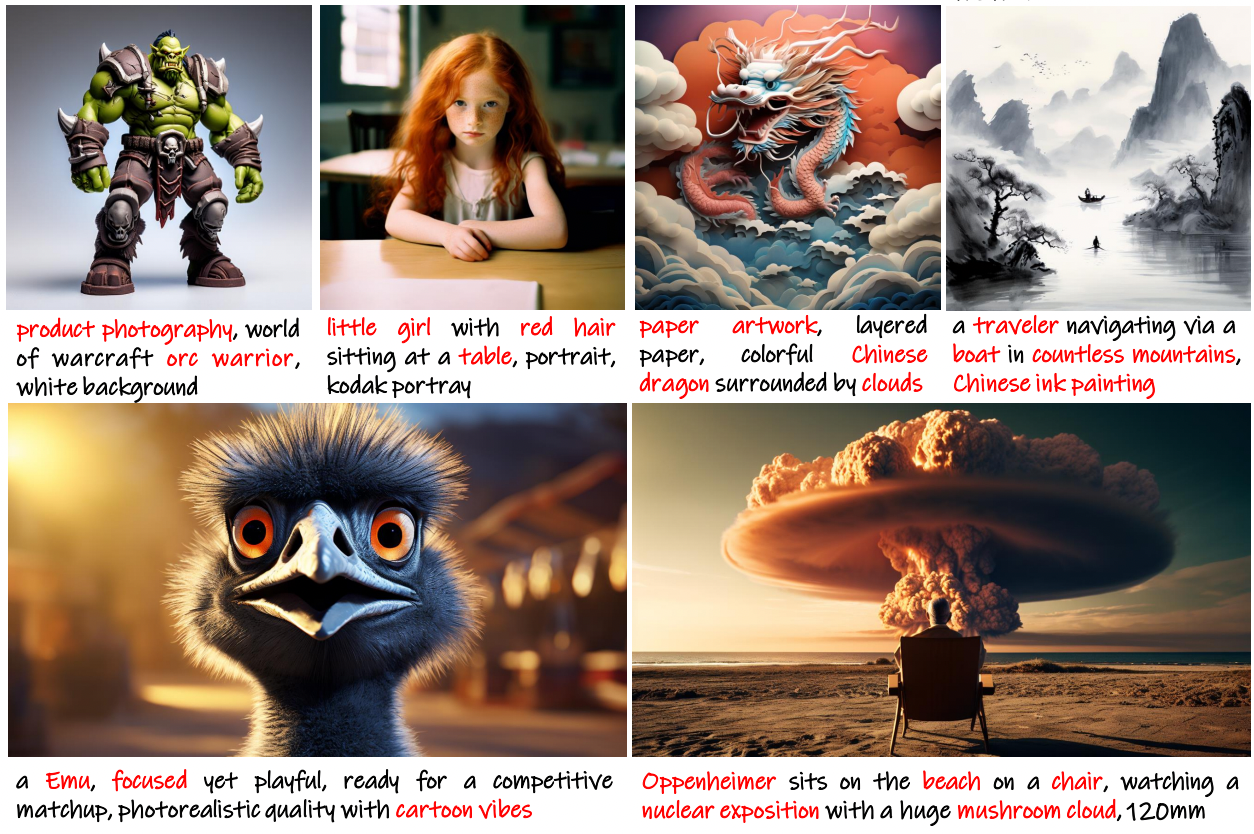
PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis는 Junsong Chen, Jincheng Yu, Chongjian Ge, Lewei Yao, Enze Xie, Yue Wu, Zhongdao Wang, James Kwok, Ping Luo, Huchuan Lu, Zhenguo Li가 작성한 논문입니다.
해당 논문의 초록은 다음과 같습니다:
최고 수준의 텍스트-이미지(T2I) 모델은 상당한 학습 비용(예: 수백만 GPU 시간)이 필요하며, 이는 AIGC 커뮤니티의 근본적인 혁신을 심각하게 저해하는 동시에 CO2 배출량을 증가시킵니다. 이 논문은 PIXART-α를 소개합니다. PIXART-α는 Transformer 기반의 T2I diffusion 모델로, 최첨단 이미지 생성기(예: Imagen, SDXL, 심지어 Midjourney)와 경쟁할 수 있는 이미지 생성 품질을 갖추고 있으며, 상업적 응용에 근접한 기준을 달성합니다. 또한, 그림 1과 2에 제시된 바와 같이, 낮은 학습 비용으로 최대 1024px 해상도의 고해상도 이미지 합성을 지원합니다. 이 목표를 달성하기 위해 세 가지 핵심 설계가 제안됩니다: (1) 학습 전략 분해: 픽셀 의존성, 텍스트-이미지 정렬, 이미지 미적 품질을 각각 최적화하는 세 가지 독립적인 학습 단계를 설계했습니다; (2) 효율적인 T2I Transformer: Diffusion Transformer(DiT)에 cross-attention 모듈을 통합하여 텍스트 조건을 주입하고, 계산 집약적인 class-condition 분기를 간소화했습니다; (3) 고정보량 데이터: 텍스트-이미지 쌍의 개념 밀도의 중요성을 강조하고, 대규모 Vision-Language 모델을 활용하여 정밀한 의사 캡션을 자동 라벨링하여 텍스트-이미지 정렬 학습을 지원합니다. 그 결과, PIXART-α의 학습 속도는 기존 대규모 T2I 모델보다 현저히 빠릅니다. 예를 들어, PIXART-α는 Stable Diffusion v1.5의 학습 시간의 10.8%만 소요됩니다(675 vs. 6,250 A100 GPU days). 이는 약 300,000달러($26,000 vs. $320,000)를 절감하고 CO2 배출량을 90% 줄이는 효과를 냅니다. 또한, 더 큰 SOTA 모델인 RAPHAEL과 비교할 때, 우리의 학습 비용은 불과 1%에 불과합니다. 광범위한 실험은 PIXART-α가 이미지 품질, 예술성, 의미적 제어에서 뛰어난 성능을 발휘함을 보여줍니다. PIXART-α가 AIGC 커뮤니티와 스타트업에 새로운 통찰을 제공하여, 고품질이지만 저비용의 생성 모델을 처음부터 구축하는 과정을 가속화하기를 바랍니다.
원본 코드베이스는 PixArt-alpha/PixArt-alpha에서, 사용 가능한 모든 체크포인트는 PixArt-alpha에서 찾을 수 있습니다.
이 파이프라인에 대한 몇 가지 참고 사항:
- 디노이징을 위해 UNet 대신 Transformer 백본을 사용합니다. 따라서 DiT와 유사한 아키텍처를 가집니다.
- T5에서 계산된 텍스트 조건을 사용하여 학습되었습니다. 이 특징 덕분에 복잡한 세부 사항이 포함된 텍스트 프롬프트를 더 잘 따를 수 있습니다.
- 다양한 종횡비로 고해상도 이미지를 생성하는 데 뛰어납니다. 최적의 결과를 얻으려면 저자들이 권장하는 몇 가지 크기 범위를 여기에서 확인할 수 있습니다.
- Stable Diffusion XL, Imagen, DALL-E 2와 같은 최첨단 텍스트-이미지 생성 시스템(본 문서 작성 시점 기준)과 동등한 품질을 갖추면서도, 이들보다 효율적입니다.
Scheduler의 가이드를 확인하여 스케줄러의 속도와 품질 사이의 트레이드오프를 탐색하는 방법을 배우고, 파이프라인 간 구성 요소 재사용 섹션을 확인하여 동일한 구성 요소를 여러 파이프라인에 효율적으로 로드하는 방법을 배워보세요.
VRAM 8GB 미만의 GPU로 추론
8GB 미만의 GPU VRAM에서 텍스트 인코더를 8비트 정밀도로 로드하여 PixArtAlphaPipeline을 실행하는 방법을 살펴보겠습니다. 전체 예제를 단계별로 살펴볼 것입니다.
먼저 bitsandbytes 라이브러리를 설치합니다:
pip install -U bitsandbytes
그 다음 텍스트 인코더를 8비트로 로드합니다:
from transformers import T5EncoderModel
from diffusers import PixArtAlphaPipeline
import torch

text_encoder = T5EncoderModel.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    subfolder="text_encoder",
    load_in_8bit=True,
    device_map="auto",

)
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=text_encoder,
    transformer=None,
    device_map="auto"
)
이제 pipe를 사용하여 프롬프트를 인코딩합니다:
with torch.no_grad():
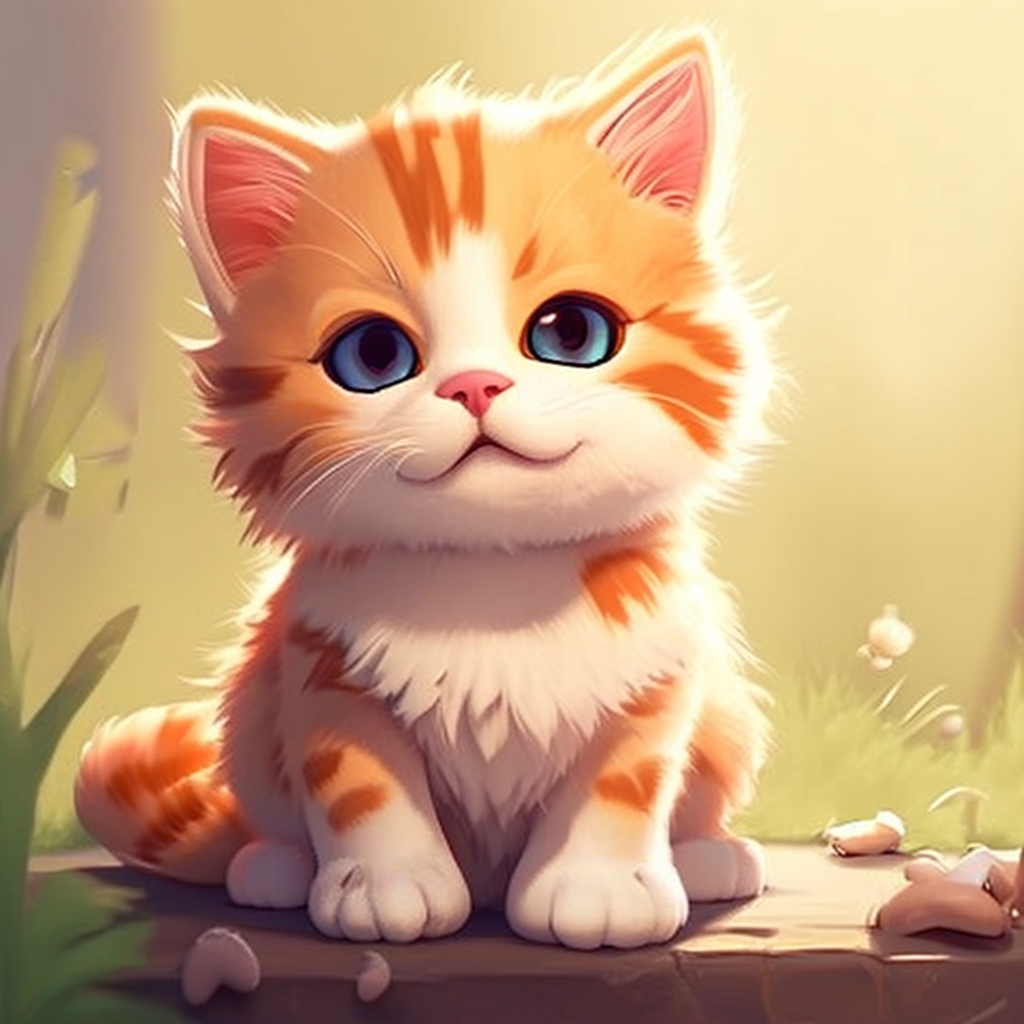
    prompt = "cute cat"
    prompt_embeds, prompt_attention_mask, negative_embeds, negative_prompt_attention_mask = pipe.encode_prompt(prompt)
텍스트 임베딩이 계산되었으므로 text_encoder와 pipe를 메모리에서 제거하고 GPU VRAM을 일부 해제합니다:
import gc

def flush():
    gc.collect()
    torch.cuda.empty_cache()

del text_encoder
del pipe
flush()
그런 다음 프롬프트 임베딩을 입력으로 사용하여 latents를 계산합니다:
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=None,
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"

latents = pipe(
    negative_prompt=None,
    prompt_embeds=prompt_embeds,
    negative_prompt_embeds=negative_embeds,
    prompt_attention_mask=prompt_attention_mask,
    negative_prompt_attention_mask=negative_prompt_attention_mask,
    num_images_per_prompt=1,
    output_type="latent",
).images

del pipe.transformer
flush()
pipe를 초기화할 때text_encoder를None으로 설정하여 로드되지 않도록 하는 점에 유의하세요.
latents가 계산되면, 이를 VAE에 전달하여 실제 이미지로 디코딩합니다:
with torch.no_grad():
    image = pipe.vae.decode(latents / pipe.vae.config.scaling_factor, return_dict=False)[0]
image = pipe.image_processor.postprocess(image, output_type="pil")[0]
image.save("cat.png")
사용하지 않는 구성 요소를 삭제하고 GPU VRAM을 정리하면, 8GB 미만의 GPU VRAM으로 PixArtAlphaPipeline을 실행할 수 있습니다.
메모리 사용량 보고서를 원하시면 이 스크립트를 실행하세요.
8-bit으로 계산된 텍스트 임베딩은 정밀도가 낮아진 표현 공간에서 발생하는 정보 손실로 인해 생성된 이미지의 품질에 영향을 미칠 수 있습니다. 8-bit를 적용한 경우와 적용하지 않은 경우의 출력을 비교하는 것이 권장됩니다.
text_encoder를 로드할 때 load_in_8bit를 True로 설정했습니다. load_in_4bit를 지정하면 메모리 요구량을 7GB 미만으로 더 낮출 수도 있습니다.
PixArtAlphaPipeline
클래스 diffusers.PixArtAlphaPipeline
< source >( tokenizer: T5Tokenizertext_encoder: T5EncoderModelvae: AutoencoderKLtransformer: PixArtTransformer2DModelscheduler: DPMSolverMultistepScheduler )
매개변수
- vae (AutoencoderKL) — 이미지를 잠재 표현으로 인코딩하고 디코딩하는 Variational Auto-Encoder (VAE) 모델.
- text_encoder (
T5EncoderModel) — 동결된 텍스트 인코더입니다. PixArt-Alpha는 T5, 구체적으로 t5-v1_1-xxl 변형을 사용합니다. - tokenizer (
T5Tokenizer) — T5Tokenizer 클래스의 토크나이저. - transformer (PixArtTransformer2DModel) —
인코딩된 이미지 latents의 노이즈를 제거하기 위한 텍스트 조건부
PixArtTransformer2DModel입니다. config에는Transformer2DModel로 처음 게시되었지만, 이 불일치는 무시할 수 있습니다. - scheduler (SchedulerMixin) —
transformer와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러.
PixArt-Alpha를 사용한 텍스트-이미지 생성을 위한 Pipeline입니다.
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str] = Nonenegative_prompt: str = ''num_inference_steps: int = 20timesteps: list = Nonesigmas: list = Noneguidance_scale: float = 4.5num_images_per_prompt: int | None = 1height: int | None = Nonewidth: int | None = Noneeta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1clean_caption: bool = Trueuse_resolution_binning: bool = Truemax_sequence_length: int = 120**kwargs ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내할 프롬프트입니다. 정의되지 않은 경우prompt_embeds를 대신 전달해야 합니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우negative_prompt_embeds를 대신 전달해야 합니다. 가이던스를 사용하지 않을 때 무시됩니다(즉,guidance_scale이1보다 작으면 무시됩니다). - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - timesteps (
list[int], 선택 사항) —timesteps인수를 지원하는 스케줄러의set_timesteps메서드에서 디노이징 과정에 사용할 커스텀 timesteps입니다. 정의되지 않은 경우,num_inference_steps가 전달될 때의 기본 동작이 사용됩니다. 내림차순으로 정렬되어 있어야 합니다. - sigmas (
list[float], 선택 사항) —set_timesteps메서드에sigmas인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 시그마입니다. 정의되지 않은 경우,num_inference_steps가 전달될 때의 기본 동작이 사용됩니다. - guidance_scale (
float, 선택 사항, 기본값 4.5) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - height (
int, 선택 사항, 기본값 self.unet.config.sample_size) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 self.unet.config.sample_size) — 생성된 이미지의 픽셀 단위 너비입니다. - eta (
float, 선택 사항, 기본값 0.0) — DDIM 논문에서 파라미터 eta (η)에 해당합니다: https://huggingface.co/papers/2010.02502. schedulers.DDIMScheduler에만 적용되며, 다른 경우 무시됩니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - prompt_embeds (
torch.Tensor, 선택) — 미리 생성된 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, 예를 들어 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면prompt입력 인자로부터 텍스트 임베딩이 생성됩니다. - prompt_attention_mask (
torch.Tensor, 선택 사항) — 텍스트 임베딩을 위한 사전 생성된 어텐션 마스크입니다. - negative_prompt_embeds (
torch.Tensor, 선택) — 미리 생성된 부정 텍스트 임베딩입니다. PixArt-Alpha의 경우 이 negative prompt는 ""여야 합니다. 제공되지 않으면negative_prompt입력 인수에서 negative_prompt_embeds가 생성됩니다. - negative_prompt_attention_mask (
torch.Tensor, 선택 사항) — 음성 텍스트 임베딩에 사용할 사전 생성된 어텐션 마스크입니다. - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. PIL:PIL.Image.Image또는np.array중 하나를 선택합니다. - return_dict (
bool, 선택 사항, 기본값True) —~pipelines.stable_diffusion.IFPipelineOutput을 반환할지, 아니면 일반 튜플을 반환할지를 결정합니다. - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 callback은 모든 단계에서 호출됩니다. - clean_caption (
bool, 선택 사항, 기본값True) — 임베딩을 생성하기 전에 캡션을 정리할지 여부입니다.beautifulsoup4와ftfy가 설치되어 있어야 합니다. 의존성이 설치되지 않은 경우, 임베딩은 원본 프롬프트에서 생성됩니다. - use_resolution_binning (
bool, 기본값True) —True로 설정하면, 요청된 높이와 너비가 먼저ASPECT_RATIO_1024_BIN을 사용하여 가장 가까운 해상도로 매핑됩니다. 생성된 latents가 이미지로 디코딩된 후, 요청된 해상도로 다시 리사이즈됩니다. 정사각형이 아닌 이미지를 생성하는 데 유용합니다. - max_sequence_length (
int, 기본값 120) —prompt에 사용할 최대 시퀀스 길이입니다.
반환값
ImagePipelineOutput 또는 tuple
return_dict가 True인 경우 ImagePipelineOutput가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 이미지의 목록인 tuple이 반환됩니다.
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
>>> import torch
>>> from diffusers import PixArtAlphaPipeline

>>> # You can replace the checkpoint id with "PixArt-alpha/PixArt-XL-2-512x512" too.
>>> pipe = PixArtAlphaPipeline.from_pretrained("PixArt-alpha/PixArt-XL-2-1024-MS", torch_dtype=torch.float16)
>>> # Enable memory optimizations.
>>> pipe.enable_model_cpu_offload()

>>> prompt = "A small cactus with a happy face in the Sahara desert."
>>> image = pipe(prompt).images[0]
encode_prompt
< source >( prompt: str | list[str]do_classifier_free_guidance: bool = Truenegative_prompt: str = ''num_images_per_prompt: int = 1device: typing.Optional[torch.device] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneclean_caption: bool = Falsemax_sequence_length: int = 120**kwargs )
매개변수
- prompt (
str또는list[str], 선택 사항) — 인코딩할 프롬프트 - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 유도하지 않을 프롬프트입니다. 정의되지 않은 경우 대신negative_prompt_embeds를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됨). PixArt-Alpha의 경우 ""여야 합니다. - do_classifier_free_guidance (
bool, 선택 사항, 기본값True) — classifier free guidance를 사용할지 여부 - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지 수 - device — (
torch.device, 선택 사항): 결과 임베딩을 배치할 torch device - prompt_embeds (
torch.Tensor, 선택) — 미리 생성된 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, 예를 들어 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면prompt입력 인자로부터 텍스트 임베딩이 생성됩니다. - negative_prompt_embeds (
torch.Tensor, 선택) — 미리 생성된 부정 텍스트 임베딩입니다. PixArt-Alpha의 경우 "" 문자열의 임베딩이어야 합니다. - clean_caption (
bool, 기본값False) —True인 경우, 인코딩 전에 제공된 캡션을 전처리하고 정리합니다. - max_sequence_length (
int, 기본값 120) — 프롬프트에 사용할 최대 시퀀스 길이입니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.