
Diffusers documentation
Shap-E
Shap-E
Shap-E 모델은 OpenAI의 Alex Nichol과 Heewoo Jun이 Shap-E: Generating Conditional 3D Implicit Functions에서 제안했습니다.
해당 논문의 초록은 다음과 같습니다:
Shap-E는 3D 에셋을 위한 조건부 생성 모델입니다. 단일 출력 표현을 생성하는 최근의 3D 생성 모델 연구와 달리, Shap-E는 텍스처가 적용된 메시와 뉴럴 래디언스 필드로 모두 렌더링할 수 있는 임PLICIT 함수의 매개변수를 직접 생성합니다. Shap-E는 두 단계로 학습됩니다. 먼저, 3D 에셋을 임PLICIT 함수의 매개변수로 결정적으로 매핑하는 인코더를 학습하고, 두 번째로 인코더의 출력에 대해 조건부 확산 모델을 학습합니다. 3D 데이터와 텍스트 데이터가 쌍을 이루는 대규모 데이터셋으로 학습하면, 최종 모델은 몇 초 만에 복잡하고 다양한 3D 에셋을 생성할 수 있습니다. 포인트 클라우드에 대한 명시적 생성 모델인 Point-E와 비교했을 때, Shap-E는 더 높은 차원의 다중 표현 출력 공간을 모델링함에도 불구하고 더 빠르게 수렴하며 동등하거나 더 나은 샘플 품질을 달성합니다.
원본 코드베이스는 openai/shap-e에서 찾을 수 있습니다.
파이프라인 간 구성 요소 재사용 섹션을 참고하여 동일한 구성 요소를 여러 파이프라인에 효율적으로 로드하는 방법을 확인하세요.
다음 라이브러리가 설치되어 있는지 확인하세요.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate trimesh
텍스트-3D
3D 오브젝트의 gif를 생성하려면 텍스트 프롬프트를 ShapEPipeline에 전달합니다. 파이프라인은 3D 오브젝트를 생성하는 데 사용되는 이미지 프레임 목록을 생성합니다.
import torch
from diffusers import ShapEPipeline

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

pipe = ShapEPipeline.from_pretrained("openai/shap-e", dtype=torch.float16, variant="fp16")
pipe = pipe.to(device)

guidance_scale = 15.0
prompt = ["A firecracker", "A birthday cupcake"]

images = pipe(
    prompt,
    guidance_scale=guidance_scale,
    num_inference_steps=64,
    frame_size=256,
).images
이제 export_to_gif() 함수를 사용하여 이미지 프레임 목록을 3D 객체의 gif로 변환합니다.
from diffusers.utils import export_to_gif

export_to_gif(images[0], "firecracker_3d.gif")
export_to_gif(images[1], "cake_3d.gif")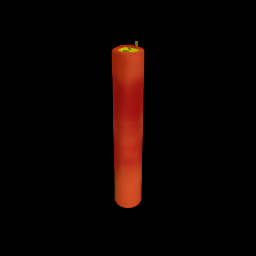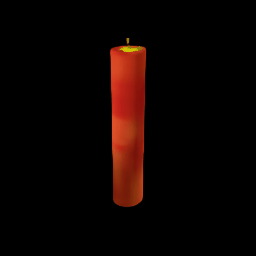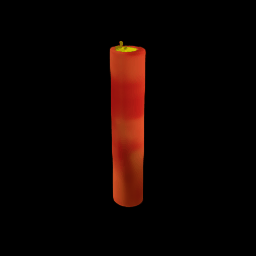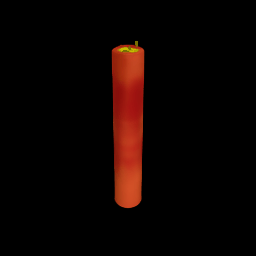
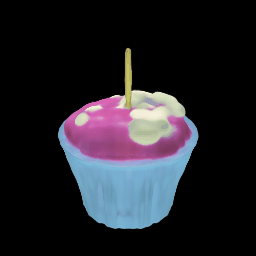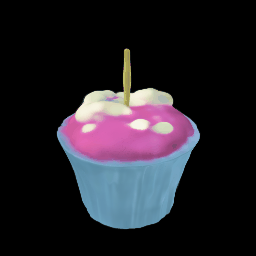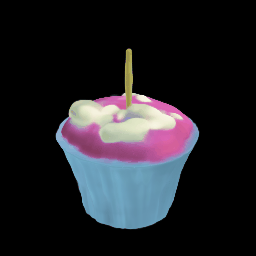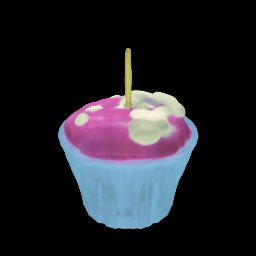
이미지에서 3D
다른 이미지에서 3D 객체를 생성하려면 ShapEImg2ImgPipeline을 사용합니다. 기존 이미지를 사용하거나 완전히 새로운 이미지를 생성할 수 있습니다. Kandinsky 2.1 모델을 사용하여 새로운 이미지를 생성해 보겠습니다.
from diffusers import DiffusionPipeline
import torch

prior_pipeline = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")

prompt = "A cheeseburger, white background"

image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
image = pipeline(
    prompt,
    image_embeds=image_embeds,
    negative_image_embeds=negative_image_embeds,
).images[0]

image.save("burger.png")
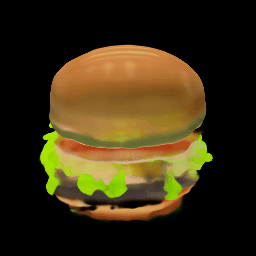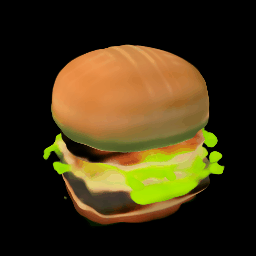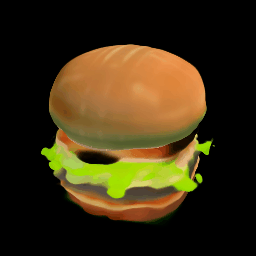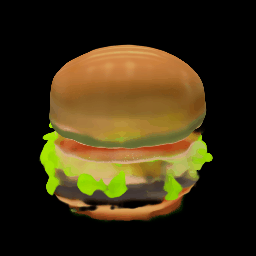
치즈버거를 ShapEImg2ImgPipeline에 전달하여 3D 표현을 생성합니다.
from PIL import Image
from diffusers import ShapEImg2ImgPipeline
from diffusers.utils import export_to_gif

pipe = ShapEImg2ImgPipeline.from_pretrained("openai/shap-e-img2img", dtype=torch.float16, variant="fp16").to("cuda")  # or "mps", "xpu", "cpu"

guidance_scale = 3.0
image = Image.open("burger.png").resize((256, 256))

images = pipe(
    image,
    guidance_scale=guidance_scale,
    num_inference_steps=64,
    frame_size=256,
).images

gif_path = export_to_gif(images[0], "burger_3d.gif")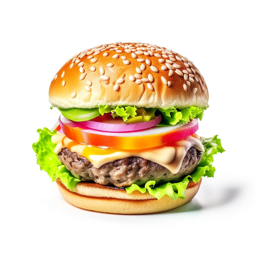
Generate mesh
Shap-E는 하위 애플리케이션에서 렌더링할 수 있는 텍스처가 적용된 메시(mesh) 출력을 생성할 수도 있는 유연한 모델입니다. 이 예제에서는 🤗 Datasets 라이브러리가 Dataset viewer로 렌더링할 수 있는 glb 파일의 메시 시각화를 지원하기 때문에, 출력을 glb 파일로 변환합니다.
output_type 매개변수를 "mesh"로 지정하여 ShapEPipeline과 ShapEImg2ImgPipeline 모두에서 메시 출력을 생성할 수 있습니다:
import torch
from diffusers import ShapEPipeline

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

pipe = ShapEPipeline.from_pretrained("openai/shap-e", dtype=torch.float16, variant="fp16")
pipe = pipe.to(device)

guidance_scale = 15.0
prompt = "A birthday cupcake"

images = pipe(prompt, guidance_scale=guidance_scale, num_inference_steps=64, frame_size=256, output_type="mesh").images
export_to_ply() 함수를 사용하여 메시 출력을 ply 파일로 저장합니다:
export_to_obj()함수를 사용하여 메시 출력을obj파일로 선택적으로 저장할 수 있습니다. 다양한 형식으로 메시 출력을 저장할 수 있어 하위 작업에서 더 유연하게 활용할 수 있습니다!
from diffusers.utils import export_to_ply

ply_path = export_to_ply(images[0], "3d_cake.ply")
print(f"Saved to folder: {ply_path}")
그 후 trimesh 라이브러리를 사용하여 ply 파일을 glb 파일로 변환할 수 있습니다:
import trimesh

mesh = trimesh.load("3d_cake.ply")
mesh_export = mesh.export("3d_cake.glb", file_type="glb")
기본적으로 메시 출력은 하단 시점에 초점이 맞춰져 있지만, 회전 변환을 적용하여 기본 시점을 변경할 수 있습니다:
import trimesh
import numpy as np

mesh = trimesh.load("3d_cake.ply")
rot = trimesh.transformations.rotation_matrix(-np.pi / 2, [1, 0, 0])
mesh = mesh.apply_transform(rot)
mesh_export = mesh.export("3d_cake.glb", file_type="glb")
Dataset viewer로 시각화하려면 메시 파일을 데이터셋 저장소에 업로드하세요!

ShapEPipeline
클래스 diffusers.ShapEPipeline
< source >( prior: PriorTransformertext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: HeunDiscreteSchedulershap_e_renderer: ShapERenderer )
매개변수
- prior (PriorTransformer) — 텍스트 임베딩에서 이미지 임베딩을 근사하기 위한 unCLIP의 표준 prior입니다.
- text_encoder (CLIPTextModelWithProjection) — 동결된 텍스트 인코더.
- tokenizer (CLIPTokenizer) —
텍스트를 토큰화하기 위한
CLIPTokenizer입니다. - scheduler (HeunDiscreteScheduler) —
prior모델과 함께 사용하여 이미지 임베딩을 생성하는 데 사용되는 스케줄러입니다. - shap_e_renderer (
ShapERenderer) — Shap-E 렌더러는 생성된 latents를 MLP의 매개변수로 투영하여 NeRF 렌더링 방식으로 3D 객체를 생성합니다.
3D 에셋의 잠재 표현을 생성하고 NeRF 방법으로 렌더링하는 파이프라인.
이 모델은 DiffusionPipeline에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: strnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0frame_size: int = 64output_type: str | None = 'pil'return_dict: bool = True ) → ShapEPipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 25) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한torch.Generator. - latents (
torch.Tensor, 선택 사항) — 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents로, 이미지 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서를 생성합니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트prompt와 밀접하게 연결된 이미지를 생성하도록 유도됩니다.guidance_scale > 1일 때 guidance scale이 활성화됩니다. - frame_size (
int, 선택 사항, 기본값 64) — 생성된 3D 출력의 각 이미지 프레임의 너비와 높이입니다. - output_type (
str, 선택 사항, 기본값"pil") — 생성된 이미지의 출력 형식입니다."pil"(PIL.Image.Image),"np"(np.array),"latent"(torch.Tensor) 또는 mesh (MeshDecoderOutput) 중 하나를 선택할 수 있습니다. - return_dict (
bool, 선택 사항, 기본값True) — 단순 tuple 대신 ShapEPipelineOutput를 반환할지 여부.
반환값
ShapEPipelineOutput 또는 tuple
return_dict가 True인 경우 ShapEPipelineOutput가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 이미지의 목록인 tuple이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
>>> import torch
>>> from diffusers import DiffusionPipeline
>>> from diffusers.utils import export_to_gif

>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

>>> repo = "openai/shap-e"
>>> pipe = DiffusionPipeline.from_pretrained(repo, torch_dtype=torch.float16)
>>> pipe = pipe.to(device)

>>> guidance_scale = 15.0
>>> prompt = "a shark"

>>> images = pipe(
...     prompt,
...     guidance_scale=guidance_scale,
...     num_inference_steps=64,
...     frame_size=256,
... ).images

>>> gif_path = export_to_gif(images[0], "shark_3d.gif")
ShapEImg2ImgPipeline
class diffusers.ShapEImg2ImgPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelimage_processor: CLIPImageProcessorPilscheduler: HeunDiscreteSchedulershap_e_renderer: ShapERenderer )
매개변수
- prior (PriorTransformer) — 텍스트 임베딩에서 이미지 임베딩을 근사하기 위한 unCLIP의 표준 prior입니다.
- image_encoder (CLIPVisionModel) — 동결된 이미지 인코더.
- image_processor (CLIPImageProcessor) —
이미지를 처리하기 위한
CLIPImageProcessor. - scheduler (HeunDiscreteScheduler) —
prior모델과 함께 사용하여 이미지 임베딩을 생성하는 데 사용되는 스케줄러입니다. - shap_e_renderer (
ShapERenderer) — Shap-E 렌더러는 생성된 latents를 MLP의 매개변수로 투영하여 NeRF 렌더링 방식으로 3D 객체를 생성합니다.
이미지에서 3D 에셋의 잠재 표현을 생성하고 NeRF 방법으로 렌더링하는 파이프라인
이 모델은 DiffusionPipeline에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( image: PIL.Image.Image | list[PIL.Image.Image]num_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0frame_size: int = 64output_type: str | None = 'pil'return_dict: bool = True ) → ShapEPipelineOutput or tuple
매개변수
- image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]또는list[np.ndarray]) — 시작점으로 사용할 이미지 배치의Image또는 텐서를 나타냅니다. 이미지 대신 이미지 레이턴츠를 image로 전달할 수도 있으며, 레이턴츠를 직접 전달하는 경우 다시 인코딩되지 않습니다. - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 25) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한torch.Generator. - latents (
torch.Tensor, 선택 사항) — 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents로, 이미지 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서를 생성합니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트prompt와 밀접하게 연결된 이미지를 생성하도록 유도됩니다.guidance_scale > 1일 때 guidance scale이 활성화됩니다. - frame_size (
int, 선택 사항, 기본값 64) — 생성된 3D 출력의 각 이미지 프레임의 너비와 높이입니다. - output_type (
str, 선택 사항, 기본값"pil") — 생성된 이미지의 출력 형식입니다."pil"(PIL.Image.Image),"np"(np.array),"latent"(torch.Tensor) 또는 mesh (MeshDecoderOutput) 중 하나를 선택할 수 있습니다. - return_dict (
bool, 선택 사항, 기본값True) — 단순 tuple 대신 ShapEPipelineOutput를 반환할지 여부.
반환값
ShapEPipelineOutput 또는 tuple
return_dict가 True인 경우 ShapEPipelineOutput가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 이미지의 목록인 tuple이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
>>> from PIL import Image
>>> import torch
>>> from diffusers import DiffusionPipeline
>>> from diffusers.utils import export_to_gif, load_image

>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

>>> repo = "openai/shap-e-img2img"
>>> pipe = DiffusionPipeline.from_pretrained(repo, torch_dtype=torch.float16)
>>> pipe = pipe.to(device)

>>> guidance_scale = 3.0
>>> image_url = "https://hf.co/datasets/diffusers/docs-images/resolve/main/shap-e/corgi.png"
>>> image = load_image(image_url).convert("RGB")

>>> images = pipe(
...     image,
...     guidance_scale=guidance_scale,
...     num_inference_steps=64,
...     frame_size=256,
... ).images

>>> gif_path = export_to_gif(images[0], "corgi_3d.gif")
ShapEPipelineOutput
클래스 diffusers.pipelines.shap_e.pipeline_shap_e.ShapEPipelineOutput
< source >( images: list[list[PIL.Image.Image]] | list[list[numpy.ndarray]] )
ShapEPipeline와 ShapEImg2ImgPipeline의 출력 클래스입니다.