
Diffusers documentation
Stable Diffusion iş akışları
Stable Diffusion iş akışları

Stable Diffusion, CompVis, Stability AI ve LAION araştırmacıları ve mühendisleri tarafından geliştirilen bir metinden görüntüye latent difüzyon modelidir. Latent difüzyon, bellek ve hesaplama karmaşıklığını azaltmak için difüzyon sürecini daha düşük boyutlu bir latent uzayda uygular. Bu spesifik difüzyon modeli türü, Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser ve Björn Ommer tarafından High-Resolution Image Synthesis with Latent Diffusion Models makalesinde önerilmiştir.
Stable Diffusion, LAION-5B veri setinin bir alt kümesindeki 512x512 boyutundaki görseller üzerinde eğitilmiştir. Bu model, metin istemlerine göre koşullandırmak için dondurulmuş bir CLIP ViT-L/14 metin kodlayıcı kullanır. 860M parametreli UNet ve 123M parametreli metin kodlayıcısıyla model nispeten hafiftir ve tüketici sınıfı GPU'larda çalıştırılabilir.
Stable Diffusion'un nasıl çalıştığı ve temel latent difüzyon modelinden nasıl farklılaştığına dair daha fazla ayrıntı için Stability AI'nin düzenlemesini ve daha teknik ayrıntılar için kendi blog yazımızı inceleyin.
Stable Diffusion v1.0'ın orijinal kod tabanını CompVis/stable-diffusion adresinde, Stable Diffusion v2.0'ınkini ise Stability-AI/stablediffusion adresinde ve çeşitli görevler için orijinal betiklerini bulabilirsiniz. Farklı Stable Diffusion sürümleri ve görevleri için ek resmi kontrol noktaları, CompVis ve Stability AI Hub kuruluşlarında yer almaktadır. Kullanım senaryonuza en uygun kontrol noktasını bulmak için bu kuruluşları keşfedin!
Aşağıdaki tablo, mevcut Stable Diffusion hatlarını, desteklenen görevlerini ve etkileşimli bir demosunu özetlemektedir:
| Pipeline | Desteklenen görevler | 🤗 Alan |
|---|---|---|
| StableDiffusion | metinden görüntüye |  |
| StableDiffusionImg2Img | görselden görseli | |
| StableDiffusionInpaint | inpainting | |
| StableDiffusionDepth2Img | derinlikten görüntüye | |
| StableDiffusionImageVariation | görsel çeşitliliği | |
| StableDiffusionPipelineSafe (kullanımdan kaldırıldı; doküman sayfası yok) | filtrelenmiş metinden görüntüye | |
| StableDiffusion2 | metinden görüntüye, inpainting, derinlikten görüntüye, süper çözünürlük | |
| StableDiffusionXL | metinden görüntüye, görüntüden görüntüye | |
| StableDiffusionLatentUpscale | super-resolution | |
| StableDiffusionUpscale | super-resolution | |
| StableDiffusionLDM3D | metinden-renge, metinden-derinliğe, metinden-panoramaya | |
| StableDiffusionUpscaleLDM3D | ldm3d süper çözünürlük |
İpuçları
Stable Diffusion pipeline'lerinden en iyi verimi almanıza yardımcı olmak için, performans ve kullanılabilirliği artırmaya yönelik birkaç ipucu aşağıda verilmiştir. Bu ipuçları tüm Stable Diffusion pipeline'ları için geçerlidir.
Hız ve kalite arasındaki ödünleşimi keşfedin
StableDiffusionPipeline varsayılan olarak PNDMScheduler kullanır ancak 🤗 Diffusers, uyumlu birçok başka zamanlayıcı (bunlardan bazıları daha hızlıdır veya daha iyi kalitede çıktı üretir) sunar. Örneğin, varsayılan yerine EulerDiscreteScheduler kullanmak istiyorsanız:
from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler

pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config)

# or
euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler)
Bellek tasarrufu için pipeline bileşenlerini yeniden kullanın
Belleği tasarruflu kullanmak ve aynı bileşenleri birden çok iş akışında kullanmak için, ağırlıkların RAM'e birden fazla kez yüklenmesini önlemek amacıyla .components yöntemini kullanın.
from diffusers import (
    StableDiffusionPipeline,
    StableDiffusionImg2ImgPipeline,
    StableDiffusionInpaintPipeline,
)

text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
img2img = StableDiffusionImg2ImgPipeline(**text2img.components)
inpaint = StableDiffusionInpaintPipeline(**text2img.components)

# now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline
gradio kullanarak web demoları oluşturun
Stable Diffusion pipeline'leri, web üzerinde güzel ve kullanıcı dostu makine öğrenmesi uygulamaları oluşturmayı kolaylaştıran Gradio kütüphanesinde otomatik olarak desteklenir. Öncelikle Gradio'nun yüklü olduğundan emin olun:
pip install -U gradio
Ardından, herhangi bir Stable Diffusion tabanlı bir pipeline etrafında bir web demosu oluşturun. Örneğin, Gradio'nun Interface.from_pipeline işleviyle tek satır kodda bir görüntü oluşturma pipeline'ı oluşturabilirsiniz:
from diffusers import StableDiffusionPipeline
import gradio as gr

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")

gr.Interface.from_pipeline(pipe).launch()
tarayıcınızda sezgisel bir sürükle-bırak arayüzü açar:
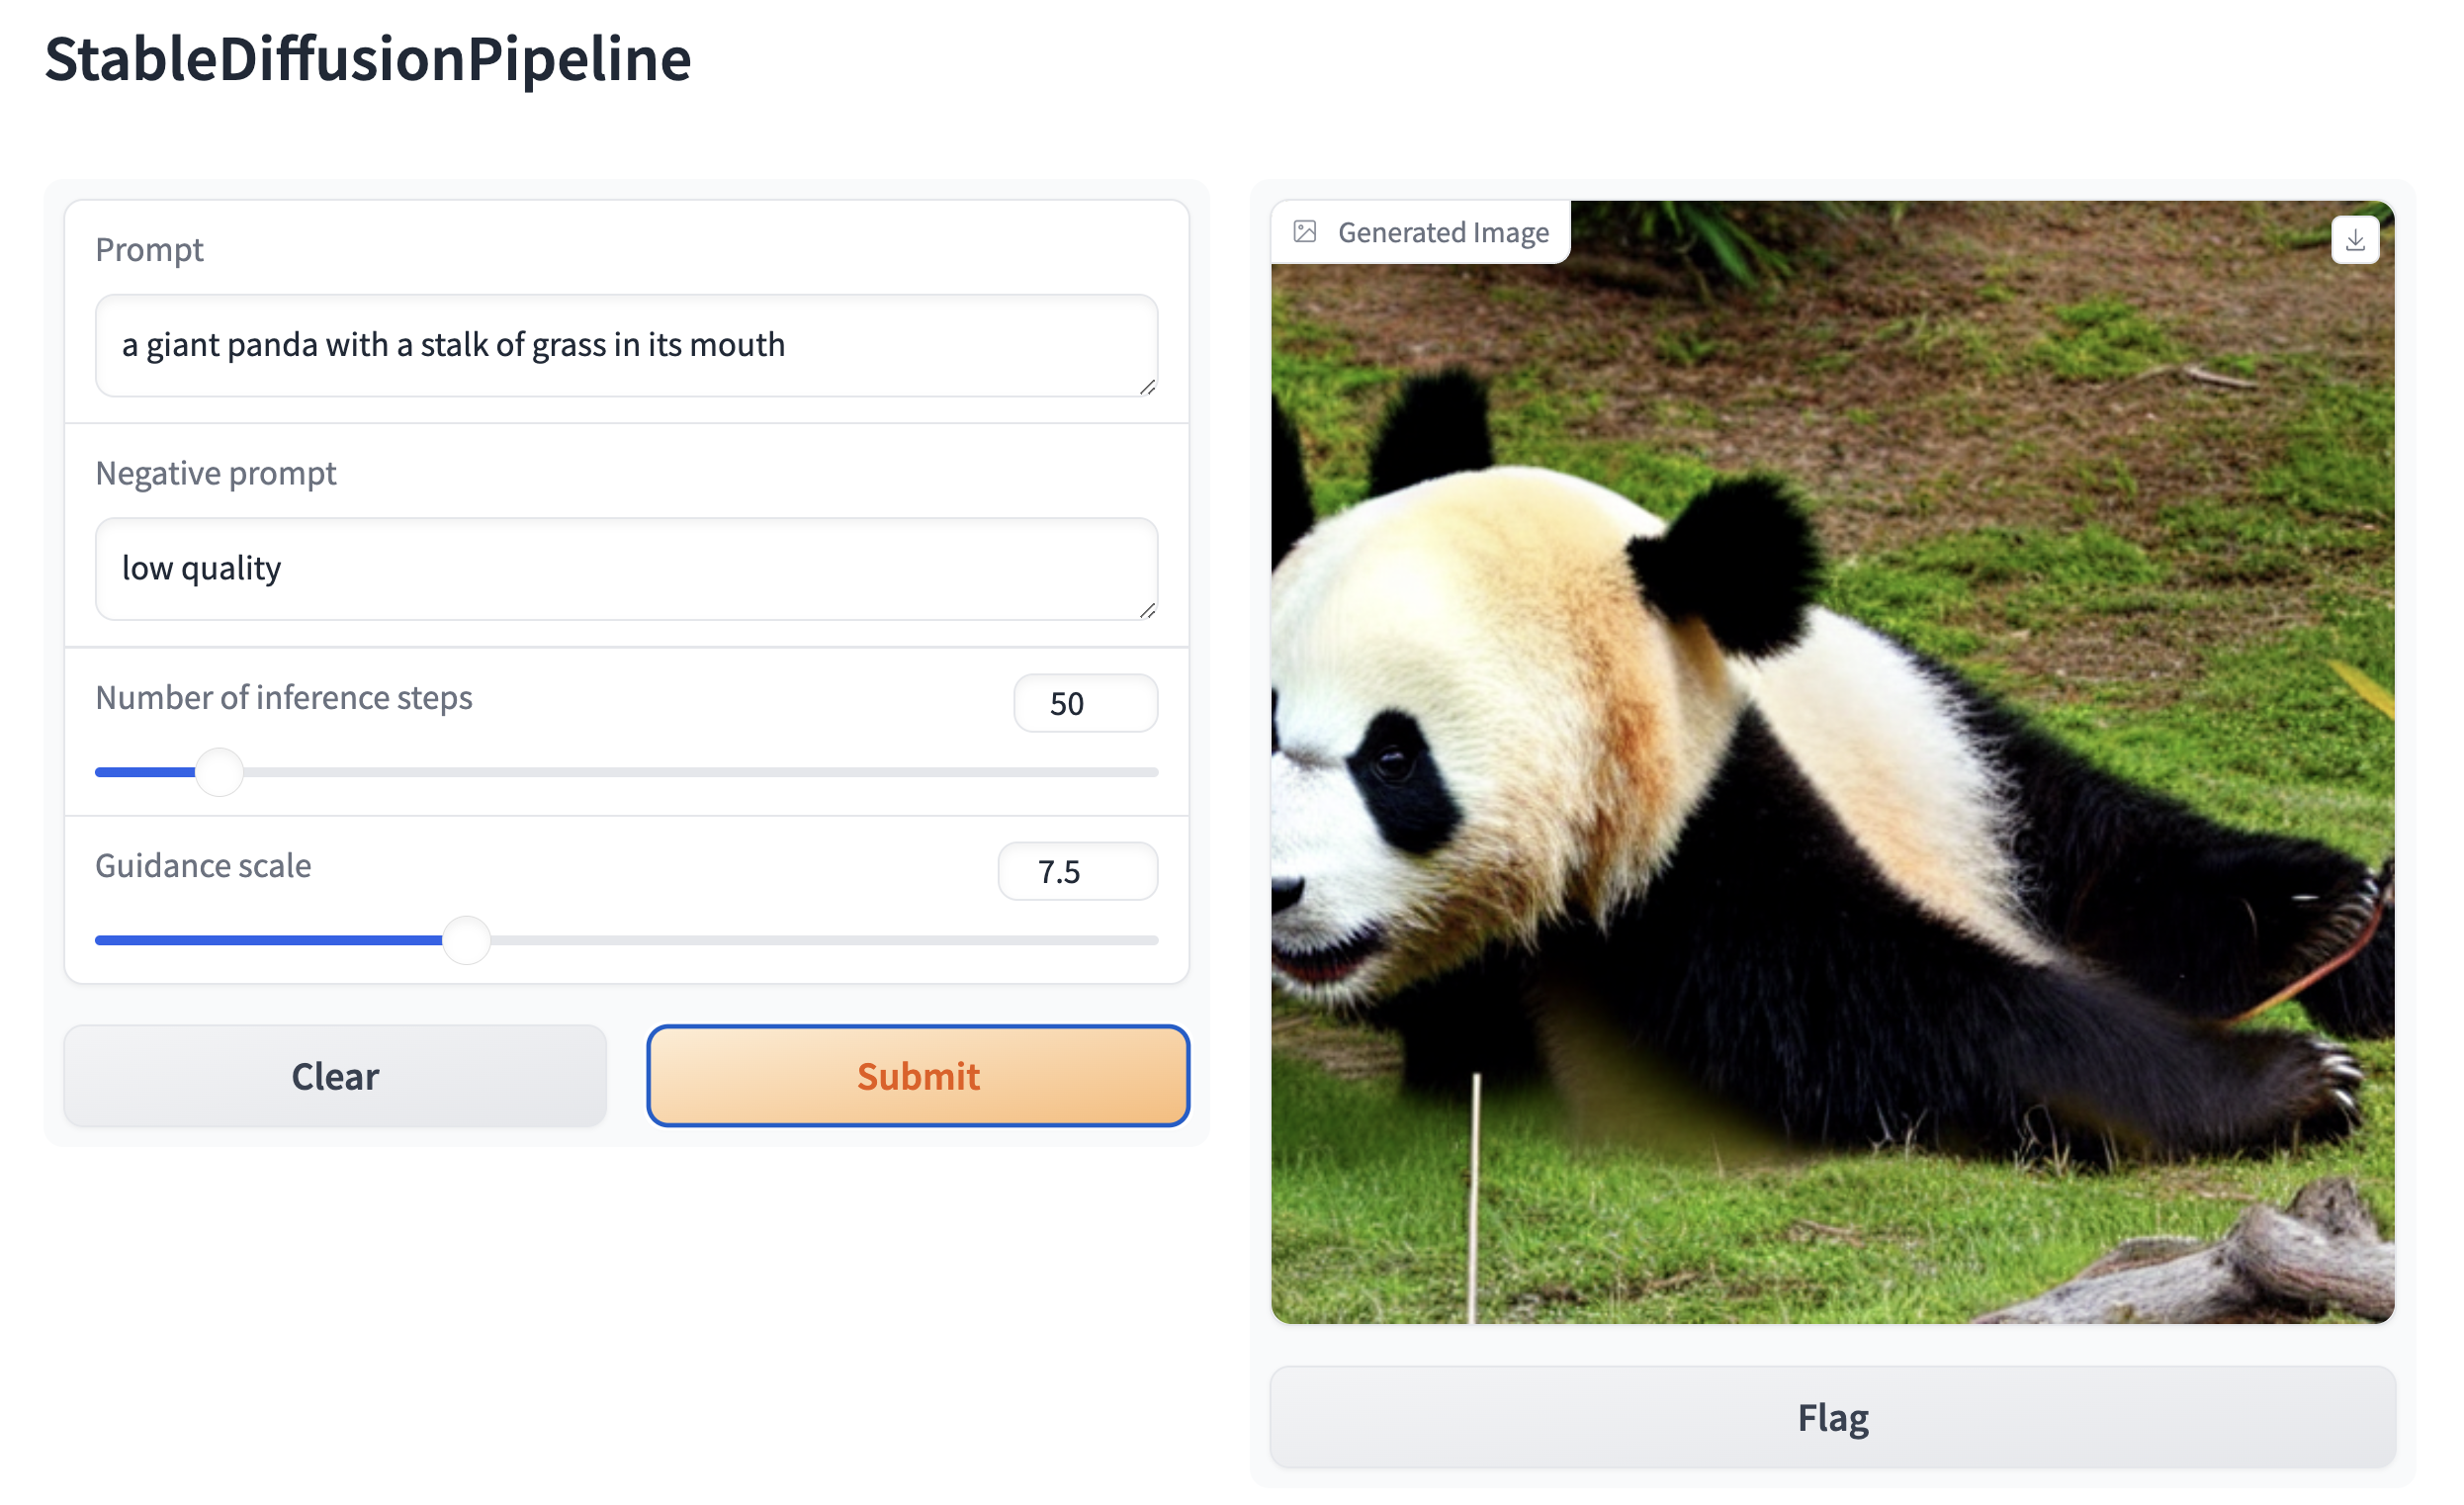
Benzer şekilde, bir görüntüden görüntüye hattı için bir demo oluşturabilirsiniz:
from diffusers import StableDiffusionImg2ImgPipeline
import gradio as gr


pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5")

gr.Interface.from_pipeline(pipe).launch()
Varsayılan olarak web demosu yerel bir sunucuda çalışır. Bunu başkalarıyla paylaşmak isterseniz, launch() içinde share=True ayarlayarak geçici bir herkese açık bağlantı oluşturabilirsiniz. Ya da demosunuzu kalıcı bir bağlantı için Hugging Face Spaceshttps://huggingface.co/spaces üzerinde barındırabilirsiniz.