
Diffusers documentation
SDXL Turbo
SDXL Turbo
Stable Diffusion XL (SDXL) Turbo, Axel Sauer, Dominik Lorenz, Andreas Blattmann ve Robin Rombach tarafından Adversarial Diffusion Distillation makalesinde önerilmiştir.
Makalenin özeti şudur:
Adversarial Diffusion Distillation (ADD) adlı yeni bir eğitim yaklaşımı tanıtıyoruz. Bu yaklaşım, yüksek görüntü kalitesini koruyarak büyük ölçekli temel görüntü difüzyon modellerini yalnızca 1–4 adımda verimli bir şekilde örnekler. Yüksek görüntü sadakatini, bir veya iki örneklem adımı gibi düşük adım rejiminde bile sağlamak için, büyük ölçekli hazır görüntü difüzyon modellerini öğretmen sinyali olarak kullanmak üzere skor distilasyonunu, adversarial kayıp ile birleştirerek kullanıyoruz. Analizlerimiz, modelimizin tek adımda mevcut az-adımlı yöntemleri (GANs, Latent Consistency Models) açık bir şekilde geride bıraktığını ve yalnızca dört adımda son teknoloji difüzyon modellerinin (SDXL) performansına ulaştığını göstermektedir. ADD, temel modellerle tek adımlı, gerçek zamanlı görüntü sentezini mümkün kılan ilk yöntemdir.
İpuçları
- SDXL Turbo, SDXL ile tamamen aynı mimariyi kullanır; bu da aynı API'ye sahip olduğu anlamına gelir. Daha fazla ayrıntı için SDXL API referansına bakın.
- SDXL Turbo,
guidance_scale=0.0olarak ayarlayarak rehberlik ölçeğini devre dışı bırakmalıdır. - SDXL Turbo, zamanlayıcı için
timestep_spacing='trailing'kullanmalı ve 1 ile 4 adım arasında çalışmalıdır. - SDXL Turbo, 512x512 boyutunda görüntüler üretmek üzere eğitilmiştir.
- SDXL Turbo açık erişimlidir, ancak açık kaynak değildir; bu nedenle ticari uygulamalarda kullanmak için bir model lisansı satın almak gerekebilir. Daha fazla bilgi edinmek için resmi model kartını okuduğunuzdan emin olun.
Resmi temel ve rafine model kontrol noktaları için Stability AI Hub kuruluşuna göz atın!
Aşağıdaki kütüphanelerin yüklü olduğundan emin olun.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Model kontrol noktalarını yükle
Model ağırlıkları Hub'da veya yerel olarak ayrı alt klasörlerde saklanabilir; bu durumda from_pretrained() metodunu kullanmalısınız:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
Ayrıca, Hub'dan veya yerel olarak tek dosya biçiminde (.ckpt veya .safetensors) saklanan bir model kontrol noktasını yüklemek için from_single_file() yöntemini de kullanabilirsiniz. Bu yükleme yöntemi için timestep_spacing="trailing" değerini ayarlamanız gerekir (daha iyi sonuçlar almak için diğer zamanlayıcı yapılandırma değerleriyle deney yapmaktan çekinmeyin):
from diffusers import StableDiffusionXLPipeline, EulerAncestralDiscreteScheduler
import torch

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/sdxl-turbo/blob/main/sd_xl_turbo_1.0_fp16.safetensors",
    dtype=torch.float16, variant="fp16")
pipeline = pipeline.to("cuda")  # or "mps", "xpu", "cpu"
pipeline.scheduler = EulerAncestralDiscreteScheduler.from_config(pipeline.scheduler.config, timestep_spacing="trailing")
Metinden görüntüye
Metinden görüntüye için bir metin istemi geçirin. Varsayılan olarak SDXL Turbo 512x512 boyutunda bir görüntü üretir ve bu çözünürlük en iyi sonuçları verir. height ve width parametrelerini 768x768 veya 1024x1024 olarak ayarlamayı deneyebilirsiniz, ancak bunu yaptığınızda kalite düşüşleri beklemelisiniz.
Model, bu parametre olmadan eğitildiğinden devre dışı bırakmak için guidance_scale değerini 0.0 olarak aydığınızdan emin olun. Yüksek kaliteli görüntüler üretmek için tek bir çıkarım adımı yeterlidir.
Adım sayısını 2, 3 veya 4'e artırmak görüntü kalitesini iyileştirmelidir.
from diffusers import AutoPipelineForText2Image
import torch

pipeline_text2image = AutoPipelineForText2Image.from_pretrained("stabilityai/sdxl-turbo", dtype=torch.float16, variant="fp16")
pipeline_text2image = pipeline_text2image.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "A cinematic shot of a baby racoon wearing an intricate italian priest robe."

image = pipeline_text2image(prompt=prompt, guidance_scale=0.0, num_inference_steps=1).images[0]
image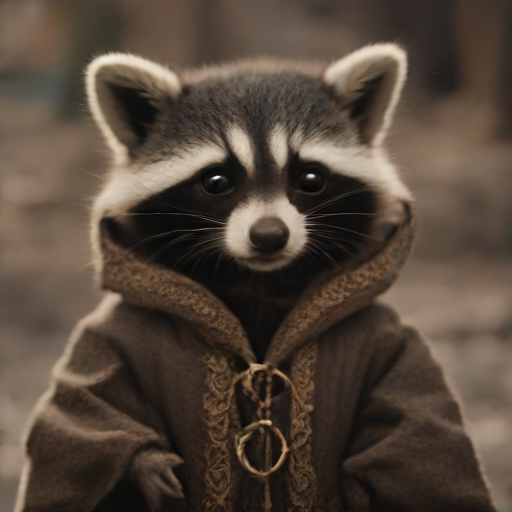
Görselden görseli
Görselden görsel üretim için num_inference_steps * strength'in 1'den büyük veya eşit olduğundan emin olun.
Görselden görsel hattı int(num_inference_steps * strength) adım çalışacak, örneğin aşağıdaki örneğimizde 0.5 * 2.0 = 1 adım.
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image, make_image_grid

# use from_pipe to avoid consuming additional memory when loading a checkpoint
pipeline_image2image = AutoPipelineForImage2Image.from_pipe(pipeline_text2image).to("cuda")  # or "mps", "xpu", "cpu"

init_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/cat.png")
init_image = init_image.resize((512, 512))

prompt = "cat wizard, gandalf, lord of the rings, detailed, fantasy, cute, adorable, Pixar, Disney, 8k"

image = pipeline_image2image(prompt, image=init_image, strength=0.5, guidance_scale=0.0, num_inference_steps=2).images[0]
make_image_grid([init_image, image], rows=1, cols=2)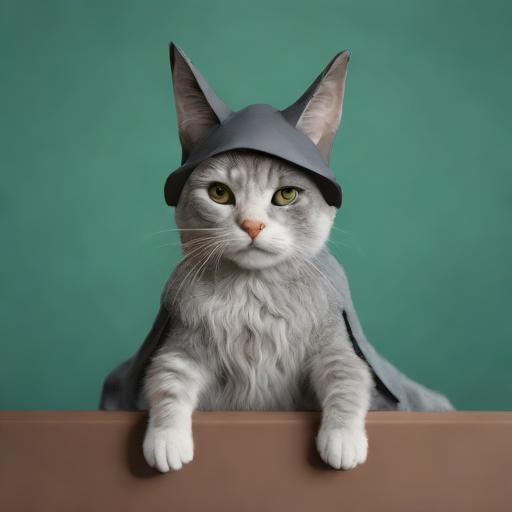
SDXL Turbo'yu daha da hızlandırın
- PyTorch sürümü 2.0 veya üzeri kullanıyorsanız UNet'i derleyin. İlk çıkarım çalışması çok yavaş olacak, ancak sonraki çalışmalarda çok daha hızlı olacaktır.
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)- Varsayılan VAE kullanıldığında, her üretimden önce ve sonra maliyetli
dtypedönüşümlerinden kaçınmak için onufloat32olarak tutun. Bunu yalnızca ilk üretimden önce bir kez yapmanız gerekir:
pipe.upcast_vae()
Alternatif olarak, float32'ye dönüştürülmesi gerekmeyen, topluluk üyesi @madebyollin tarafından oluşturulan bir 16-bit VAE de kullanabilirsiniz.