
Diffusers documentation
Stable Diffusion XL
Stable Diffusion XL


Stable Diffusion XL (SDXL), Dustin Podell, Zion English, Kyle Lacey, Andreas Blattmann, Tim Dockhorn, Jonas Müller, Joe Penna ve Robin Rombach tarafından SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis makalesinde önerilmiştir.
Makalenin özeti şudur:
Metinden görüntüye sentez için bir latent difüzyon modeli olan SDXL'yi sunuyoruz. Stable Diffusion'ın önceki sürümlerine kıyasla SDXL, üç kat daha büyük bir UNet omurgasından yararlanmaktadır: Model parametrelerindeki artış, SDXL ikinci bir metin kodlayıcı kullandığı için, esas olarak daha fazla dikkat bloğu ve daha büyük bir çapraz-dikkat bağlamından kaynaklanmaktadır. Birden fazla yeni koşullandırma şeması tasarladık ve SDXL'i birden çok en-boy oranında eğittik. Ayrıca, SDXL tarafından üretilen örneklerin görsel sadakatini, sonradan görüntüden görüntüye bir teknik kullanarak iyileştirmek için kullanılan bir rafine etme modeli tanıttık. SDXL'in, Stable Diffusion'ın önceki sürümlerine kıyasla performansının dramatik şekilde iyileştiğini ve siyah kutu, en son teknoloji görüntü üreticilerinin sonuçlarıyla rekabet edebilir sonuçlar elde ettiğini gösteriyoruz.
İpuçları
- SDXL'in 50 adımdan az bir süre için DPM++ zamanlayıcısıyla kullanıldığında görsel artefaktlar oluşturduğu bilinmektedir, çünkü çözücü sayısal olarak kararsız hale gelir. Bu sorunu düzeltmek için bu PR göz atın; ODE/SDE çözücüler için şunları önermektedir:
- Görsel kalitesini iyileştirmek için
use_karras_sigmas=Trueveyalu_lambdas=Trueolarak ayarlayın - DPM++2M veya DPM++2M SDE gibi eşit adım boyutlarına sahip bir çözücü kullanıyorsanız
euler_at_final=Trueolarak ayarlayın
- Görsel kalitesini iyileştirmek için
- Çoğu SDXL checkpoint, 1024x1024 görüntü boyutuyla en iyi sonucu verir. 768x768 ve 512x512 görüntü boyutları da desteklenir ancak sonuçlar o kadar iyi değildir. 512x512'nin altındaki boyutlar önerilmez ve stabilityai/stable-diffusion-xl-base-1.0 gibi varsayılan checkpoint'ler için muhtemelen önerilmeyecektir.
- SDXL, eğitiminde kullanılan her metin kodlayıcı için farklı bir istem (prompt) iletebilir. Hatta aynı istemin farklı bölümlerini metin kodlayıcılara iletebiliriz.
- SDXL çıktı görüntüleri, görüntüden görüntüye ayarında bir rafine etme modeli kullanılarak iyileştirilebilir.
- SDXL, modelin görüntü çözünürlüğü ve kırpma parametrelerine negatif olarak koşulmasını sağlamak için
negative_original_size,negative_crops_coords_top_leftvenegative_target_sizeparametrelerini sunar.
Resmi temel ve rafine model kontrol noktaları için Stability AI Hub kuruluşuna göz atın!
Aşağıdaki kütüphanelerin yüklü olduğundan emin olun.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate invisible-watermark>=0.2.0
Üretilen görselleri tanımlamaya yardımcı olmak için invisible-watermark kütüphanesinin yüklenmesini öneririz. invisible-watermark kütüphanesi yüklüyse, varsayılan olarak kullanılır. Filigranı devre dışı bırakmak için:
pipeline = StableDiffusionXLPipeline.from_pretrained(..., add_watermarker=False)
Model kontrol noktalarını yükle
Model ağırlıkları Hub'da veya yerel olarak ayrı alt klasörlerde saklanabilir; bu durumda from_pretrained() metodunu kullanmalısınız:
from diffusers import StableDiffusionXLPipeline, StableDiffusionXLImg2ImgPipeline
import torch

pipeline = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0", dtype=torch.float16, use_safetensors=True, variant="fp16"
).to("cuda")
Ayrıca, Hub'dan veya yerel olarak tek dosya biçiminde (.ckpt veya .safetensors) saklanan bir model kontrol noktasını yüklemek için from_single_file() yöntemini de kullanabilirsiniz:
from diffusers import StableDiffusionXLPipeline, StableDiffusionXLImg2ImgPipeline
import torch

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0/blob/main/sd_xl_base_1.0.safetensors",
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

refiner = StableDiffusionXLImg2ImgPipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-xl-refiner-1.0/blob/main/sd_xl_refiner_1.0.safetensors", dtype=torch.float16
).to("cuda")
Metinden görüntüye
Metinden görüntüye için bir metin istemi geçirin. Varsayılan olarak SDXL, en iyi sonuçlar için 1024x1024 boyutunda bir görüntü üretir. height ve width parametrelerini 768x768 veya 512x512 olarak ayarlamayı deneyebilirsiniz ancak 512x512'nin altındaki boyutların çalışması olası değildir.
from diffusers import AutoPipelineForText2Image
import torch

pipeline_text2image = AutoPipelineForText2Image.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Astronaut in a jungle, cold color palette, muted colors, detailed, 8k"
image = pipeline_text2image(prompt=prompt).images[0]
image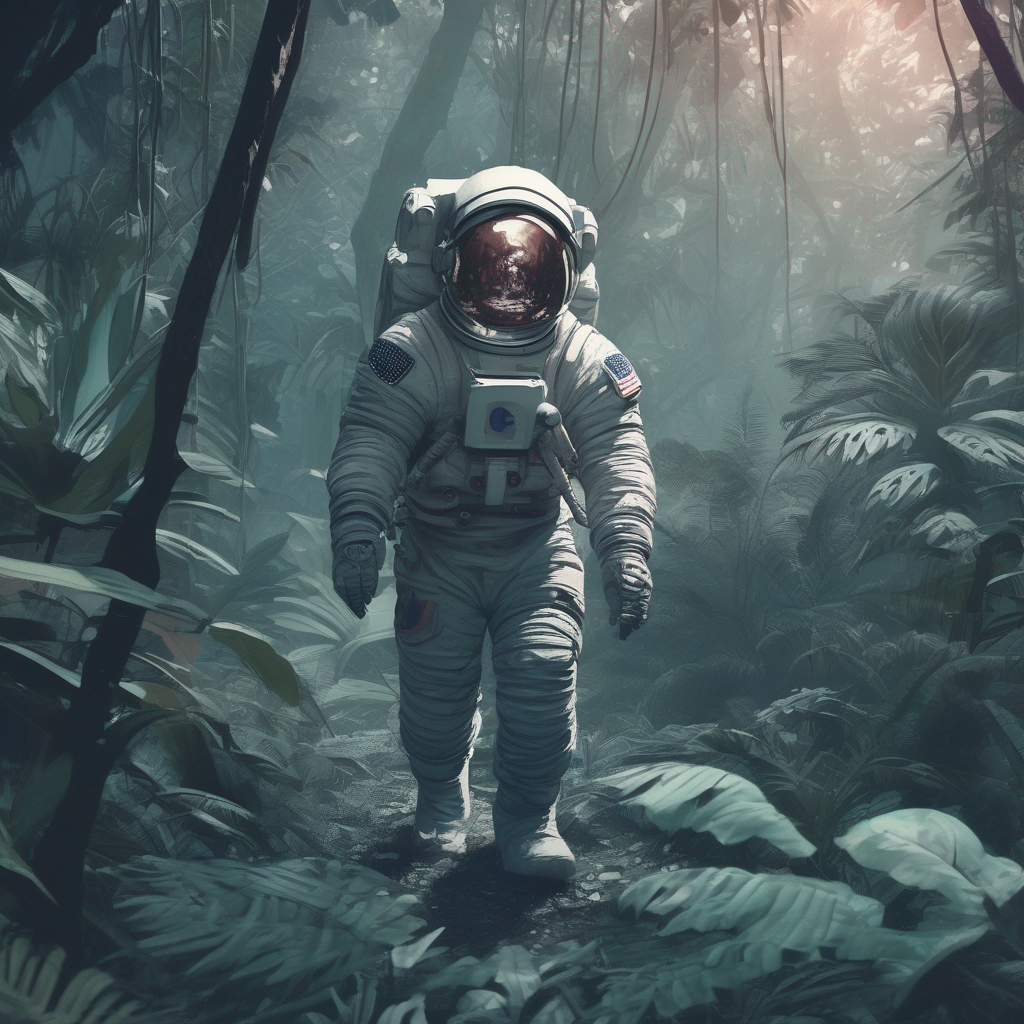
Görselden görseli
Görselden görseli için SDXL, 768x768 ile 1024x1024 arasındaki görsel boyutlarında özellikle iyi çalışır. Başlangıç görselini ve görseli koşullandırmak için bir metin komutunu şu şekilde iletin:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image, make_image_grid

# use from_pipe to avoid consuming additional memory when loading a checkpoint
pipeline = AutoPipelineForImage2Image.from_pipe(pipeline_text2image).to("cuda")  # or "mps", "xpu", "cpu"

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/sdxl-text2img.png"
init_image = load_image(url)
prompt = "a dog catching a frisbee in the jungle"
image = pipeline(prompt, image=init_image, strength=0.8, guidance_scale=10.5).images[0]
make_image_grid([init_image, image], rows=1, cols=2)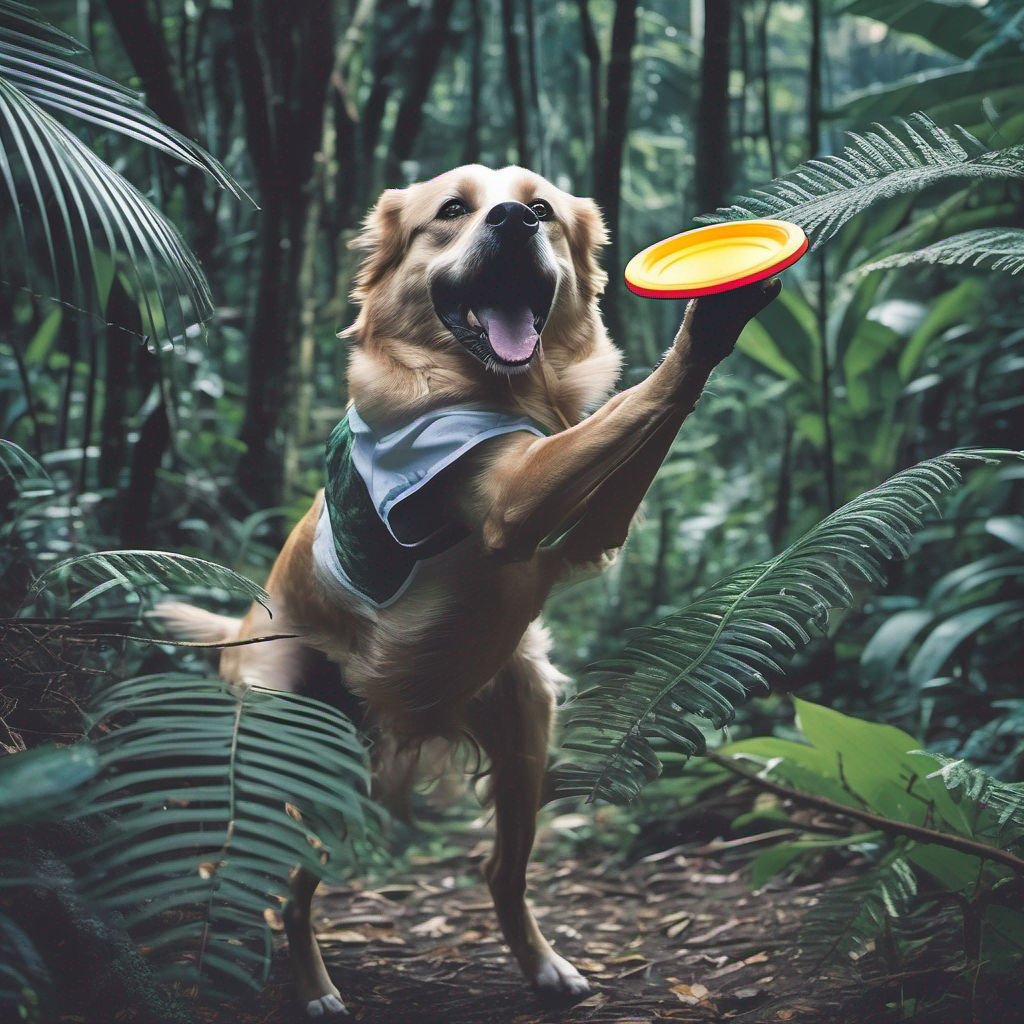
Inpainting
Inpainting için, orijinal görüntüyü ve orijinal görüntüde değiştirmek istediğiniz bölgenin maskesini kullanmanız gerekir. Maskelenmiş alanın neyle değiştirileceğini açıklayan bir prompt oluşturun.
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

# use from_pipe to avoid consuming additional memory when loading a checkpoint
pipeline = AutoPipelineForInpainting.from_pipe(pipeline_text2image).to("cuda")  # or "mps", "xpu", "cpu"

img_url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/sdxl-text2img.png"
mask_url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/sdxl-inpaint-mask.png"

init_image = load_image(img_url)
mask_image = load_image(mask_url)

prompt = "A deep sea diver floating"
image = pipeline(prompt=prompt, image=init_image, mask_image=mask_image, strength=0.85, guidance_scale=12.5).images[0]
make_image_grid([init_image, mask_image, image], rows=1, cols=3)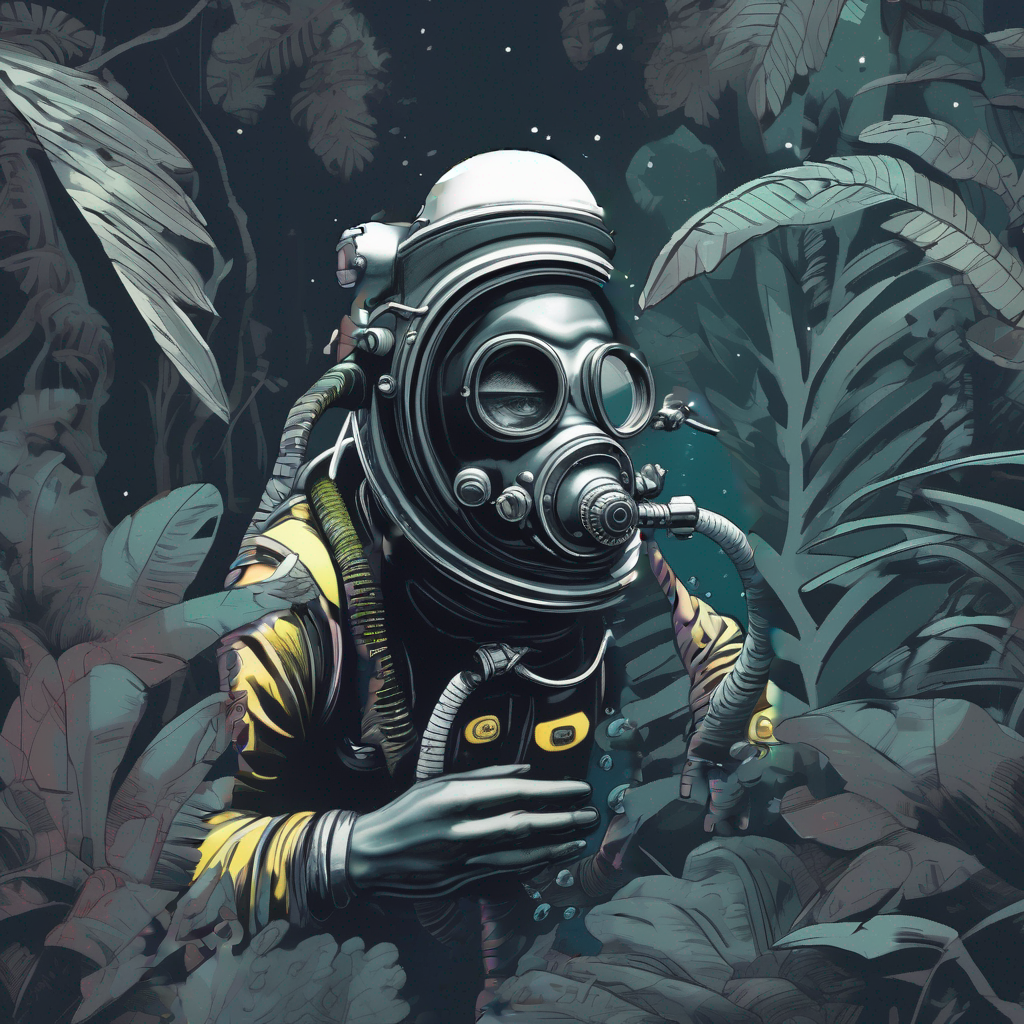
Görsel kalitesini iyileştirin
SDXL, taban modelden daha yüksek kaliteli görüntüler üretmek için düşük gürültü aşamasındaki görüntülerdeki gürültüyü azaltmaya (denoising) özel bir refiner model içerir. Refiner'ı kullanmanın iki yolu vardır:
- ince bir görüntü üretmek için temel ve rafine etme modellerini birlikte kullanın
- baz model kullanarak bir görüntü üretin ve ardından refiner modelini kullanarak görüntüye daha fazla ayrıntı ekleyin (SDXL'nin orijinal olarak eğitildiği yöntem budur)
Temel + iyileştirici model
Taban ve rafine etme modellerini birlikte kullanarak bir görüntü oluşturduğunuzda buna uzman gürültü azaltıcılar topluluğu denir. Uzman gürültü azaltıcılar topluluğu yaklaşımı, taban modelinin çıktısını rafine etme modeline aktarmaya kıyasla daha az genel gürültü azaltma adımı gerektirdiğinden, çalıştırılması önemli ölçüde daha hızlı olmalıdır. Ancak, taban modelinin çıktısını inceleyemezsiniz çünkü hâlâ büyük miktarda gürültü içerir.
Uzman gürültü azaltıcıların bir ansambli olarak, temel model yüksek gürültülü difüzyon aşamasında uzman olarak görev yaparken, rafine edici model düşük gürültülü difüzyon aşamasında uzman olarak görev yapar. Temel ve rafine edici modelleri yükleyin:
from diffusers import DiffusionPipeline
import torch

base = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    text_encoder_2=base.text_encoder_2,
    vae=base.vae,
    dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
).to("cuda")
Bu yaklaşımı kullanmak için, her modelin kendi aşamalarından geçmesi gereken timestep sayısını tanımlamanız gerekir. Temel model için bu, denoising_end parametresiyle; refiner modeli için ise denoising_start parametresiyle kontrol edilir.
denoising_endvedenoising_startparametreleri 0 ile 1 arasında bir float olmalıdır. Bu parametreler, zamanlayıcı tarafından tanımlanan ayrık zaman adımlarının bir oranı olarak temsil edilir.strengthparametresini de kullanıyorsanız, gürültü giderme adımlarının sayısı, modelin eğitildiği ayrık zaman adımları ve bildirilen kesirli kesme noktası tarafından belirlendiği için bu parametre yok sayılır.
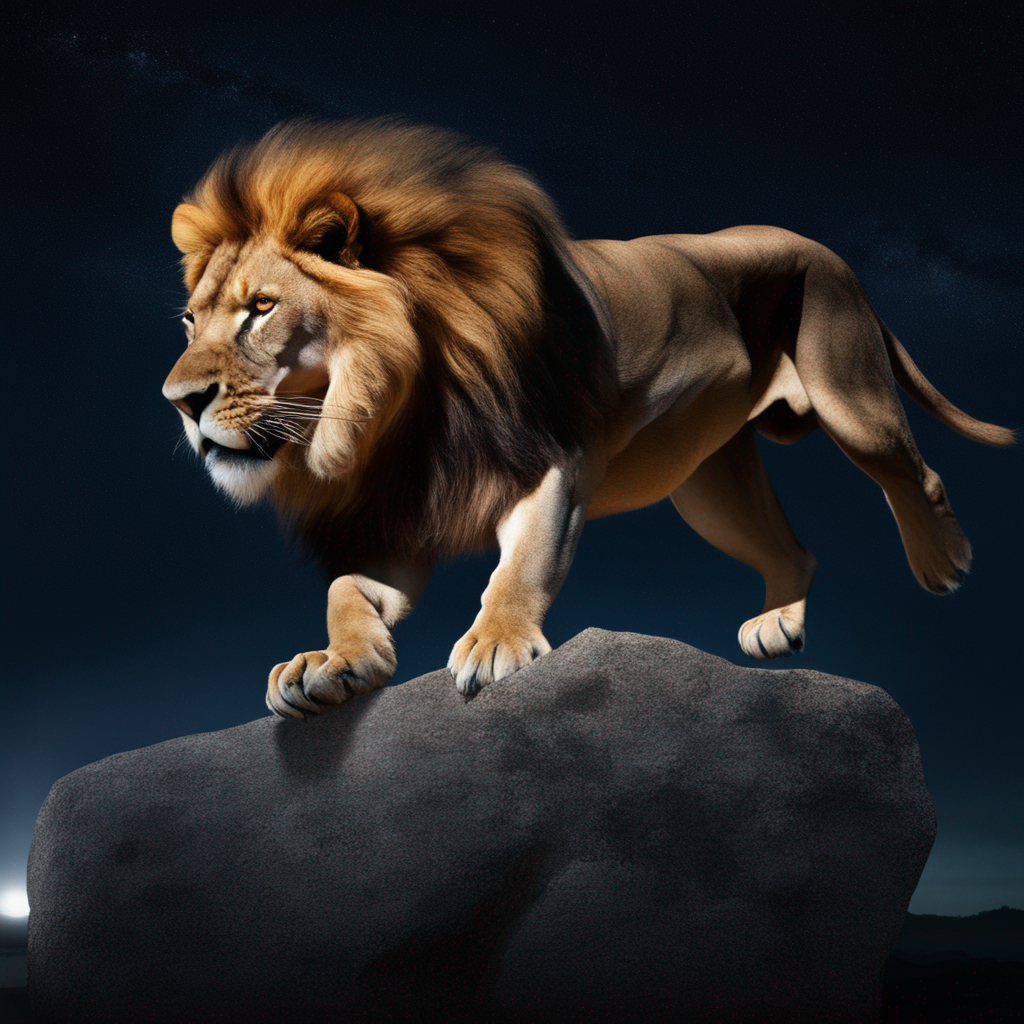
Baz modelin ilk %80’ini, yani yüksek gürültülü zaman adımlarındaki gürültü azaltmayı yapması için denoising_end=0.8 değerini ayarlayalım ve rafine etme modelinin son %20’sini, yani düşük gürültülü zaman adımlarındaki gürültü azaltmayı yapması için denoising_start=0.8 değerini ayarlayalım. Baz modelin çıktısı bir PIL görüntüsü yerine latent uzayında olmalıdır.
prompt = "A majestic lion jumping from a big stone at night"

image = base(
    prompt=prompt,
    num_inference_steps=40,
    denoising_end=0.8,
    output_type="latent",
).images
image = refiner(
    prompt=prompt,
    num_inference_steps=40,
    denoising_start=0.8,
    image=image,
).images[0]
image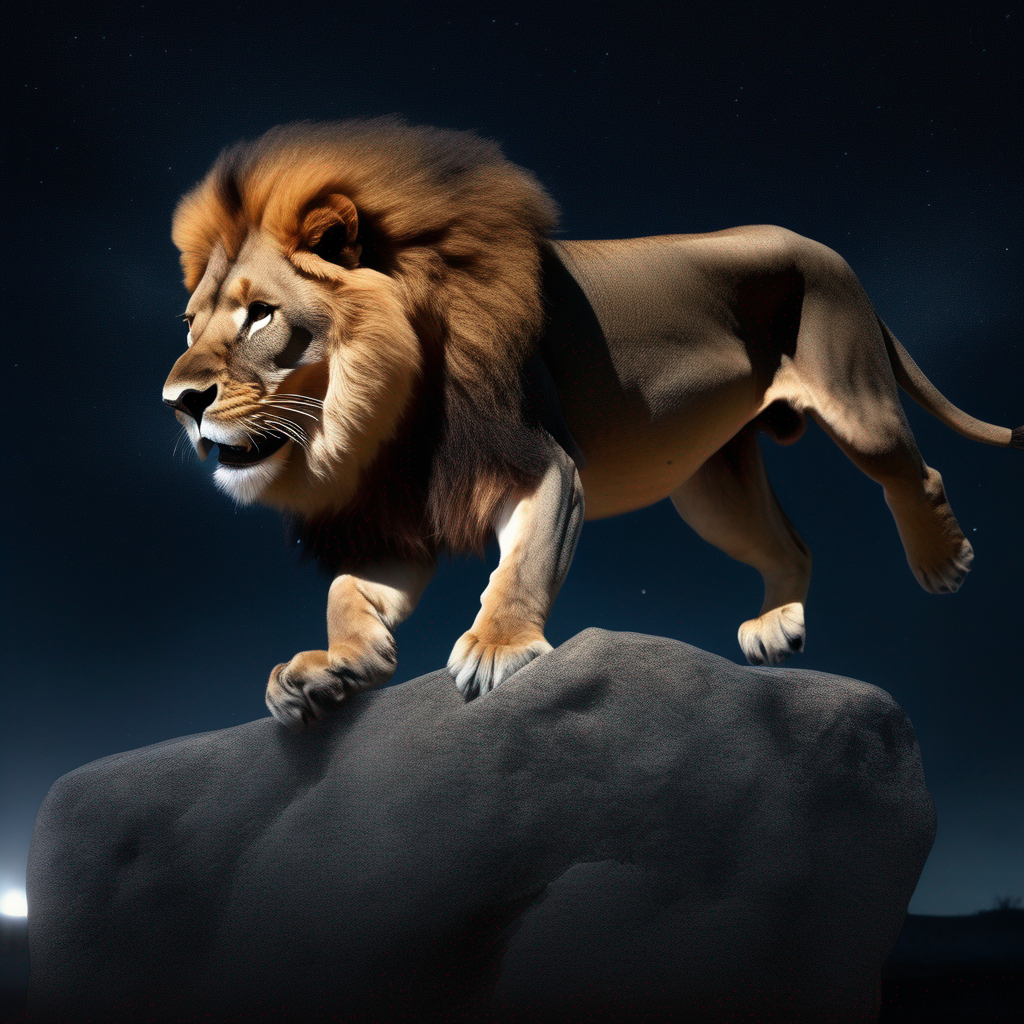
Refiner modeli, StableDiffusionXLInpaintPipeline içinde inpainting için de kullanılabilir:
from diffusers import StableDiffusionXLInpaintPipeline
from diffusers.utils import load_image, make_image_grid
import torch

base = StableDiffusionXLInpaintPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

refiner = StableDiffusionXLInpaintPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    text_encoder_2=base.text_encoder_2,
    vae=base.vae,
    dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
).to("cuda")

img_url = "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo.png"
mask_url = "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo_mask.png"

init_image = load_image(img_url)
mask_image = load_image(mask_url)

prompt = "A majestic tiger sitting on a bench"
num_inference_steps = 75
high_noise_frac = 0.7

image = base(
    prompt=prompt,
    image=init_image,
    mask_image=mask_image,
    num_inference_steps=num_inference_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images
image = refiner(
    prompt=prompt,
    image=image,
    mask_image=mask_image,
    num_inference_steps=num_inference_steps,
    denoising_start=high_noise_frac,
).images[0]
make_image_grid([init_image, mask_image, image.resize((512, 512))], rows=1, cols=3)
Bu uzman gürültü azaltıcılar topluluğu yöntemi, mevcut tüm zamanlayıcılar için iyi çalışır!
Temel modelden rafine edici modele
SDXL, taban modelden tamamen gürültüden arındırılmış görüntüye ek yüksek kaliteli detaylar eklemek için görüntüden görüntüye ayarında refiner modelini kullanarak görüntü kalitesinde bir artış elde eder.
Taban ve rafine etme modellerini yükleyin:
from diffusers import DiffusionPipeline
import torch

base = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    text_encoder_2=base.text_encoder_2,
    vae=base.vae,
    dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
).to("cuda")
SDXL refiner'ı farklı bir taban modelle kullanabilirsiniz. Örneğin, daha iyi istem uyumuyla görsel üretmek için Hunyuan-DiT veya PixArt-Sigma hatlarını kullanabilirsiniz. Bir görsel ürettikten sonra, nihai üretim kalitesini artırmak için bu görseli SDXL refiner modeline iletebilirsiniz.
Taban modelden bir görüntü oluşturun ve model çıktısını latent uzayına ayarlayın:
prompt = "Astronaut in a jungle, cold color palette, muted colors, detailed, 8k"

image = base(prompt=prompt, output_type="latent").images[0]
Oluşturulan görüntüyü refiner modeline iletin:
image = refiner(prompt=prompt, image=image[None, :]).images[0]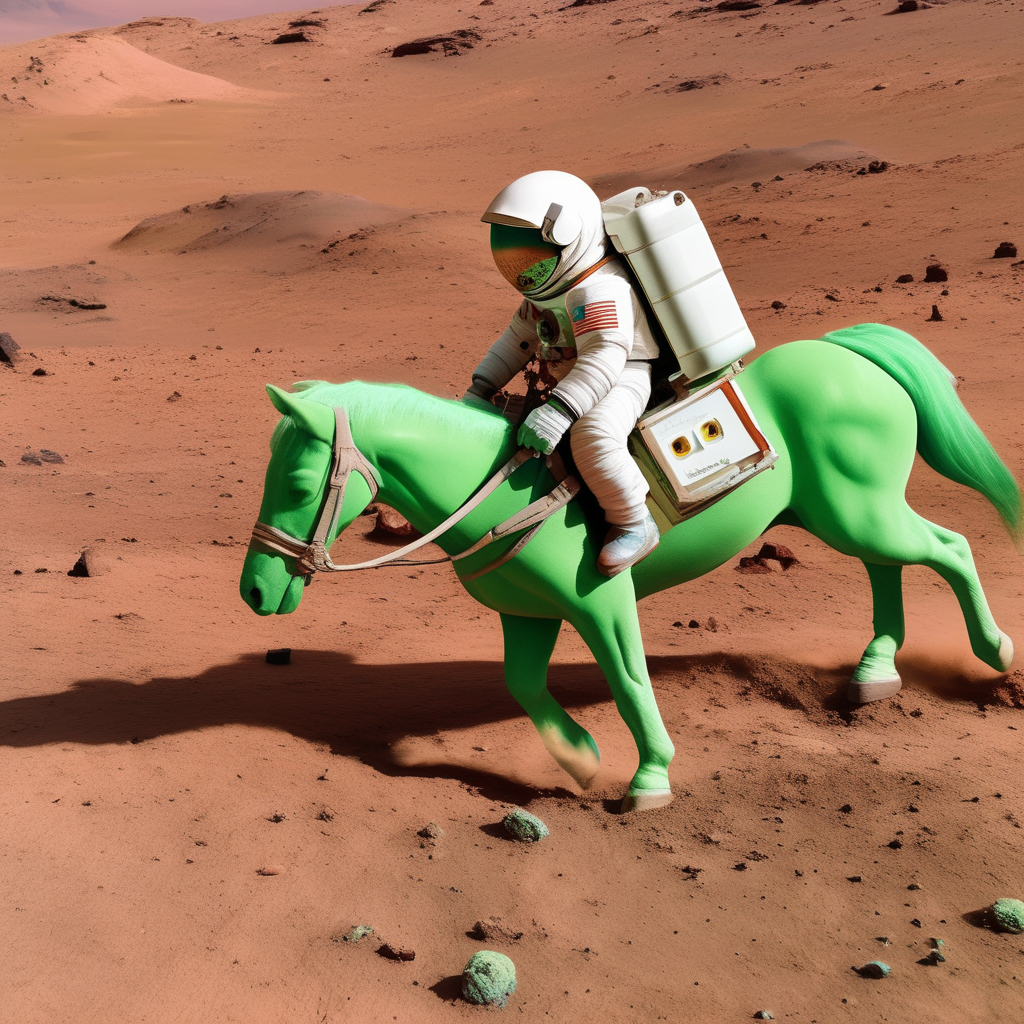
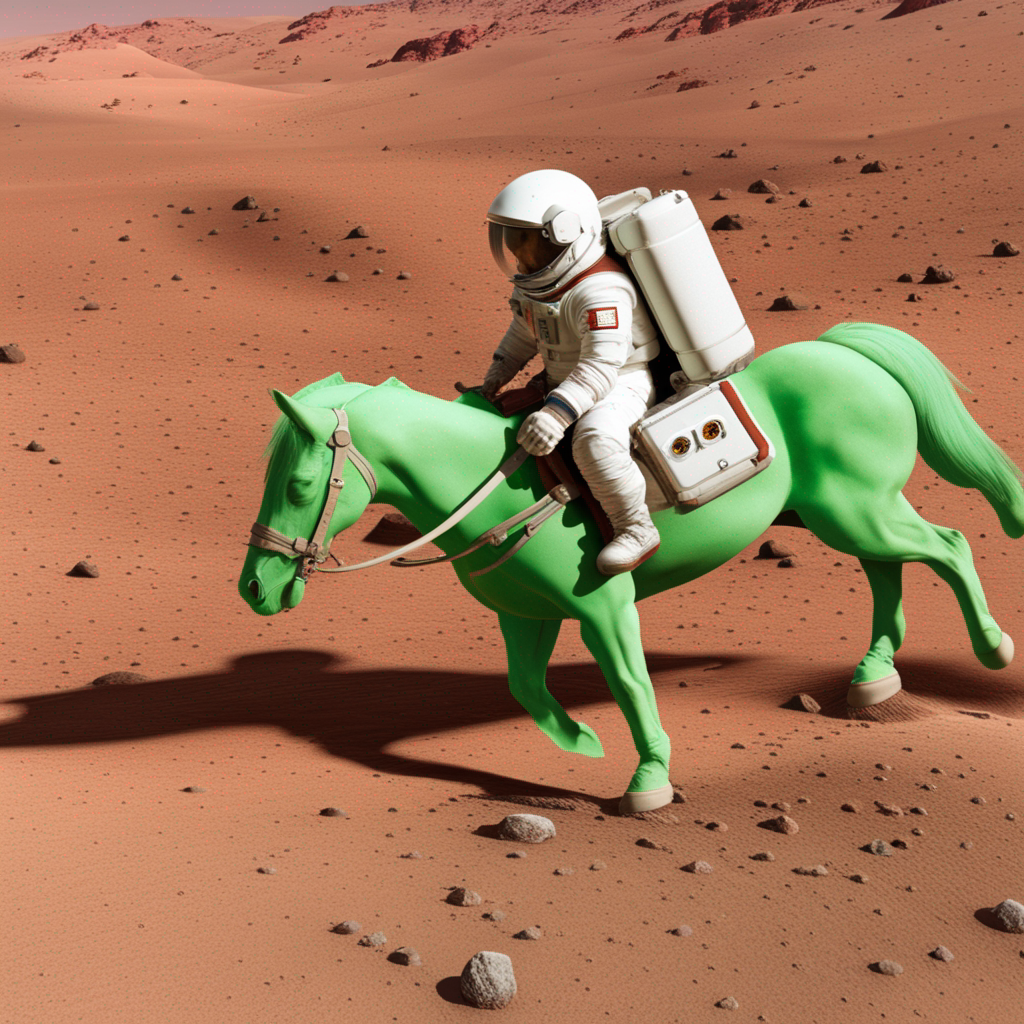
Inpainting için, temel ve iyileştirici modelleri StableDiffusionXLInpaintPipeline içinde yükleyin, denoising_end ve denoising_start parametrelerini kaldırın ve iyileştirici için daha küçük bir çıkarım adımı sayısı seçin.
Mikro-konumlama
SDXL eğitimi, mikro-konumlama olarak adlandırılan çeşitli ek koşullandırma tekniklerini içerir. Bunlar arasında orijinal görüntü boyutu, hedef görüntü boyutu ve kırpma parametreleri yer alır. Mikro-konumlama, çıkarım sırasında yüksek kaliteli ve ortalanmış görüntüler oluşturmak için kullanılabilir.
Sınıflandırıcı-ücretsiz yönlendirme sayesinde hem mikro-konumlama hem de negatif mikro-konumlama parametrelerini kullanabilirsiniz. Bunlar StableDiffusionXLPipeline, StableDiffusionXLImg2ImgPipeline, StableDiffusionXLInpaintPipeline ve StableDiffusionXLControlNetPipeline içinde kullanılabilir.
Boyut koşullandırma
İki tür boyut koşullandırması vardır:
original_sizekoşullandırması, eğitim grubundaki büyütülmüş (upscale) görüntülerden gelir (toplam eğitim verisinin neredeyse %40'ını oluşturan daha küçük görüntülerin atılması israf olacağı için). Bu sayede SDXL, yüksek çözünürlüklü görüntülerde büyütme artefaktlarının bulunmaması gerektiğini öğrenir. Çıkarım sırasında, orijinal görüntü çözünürlüğünü belirtmek içinoriginal_sizeparametresini kullanabilirsiniz.(1024, 1024)varsayılan değerini kullanmak, veri setindeki 1024x1024 görüntülere benzeyen, daha yüksek kaliteli görüntüler üretir. Daha düşük bir çözünürlük, örneğin(256, 256)seçerseniz, model yine 1024x1024 görüntüler üretir ancak bunlar veri setindeki düşük çözünürlüklü görüntülere (daha basit desenler, bulanıklık) benzer.target_sizekoşullandırması, SDXL'in farklı görüntü en-boy oranlarını destekleyecek şekilde ince ayarlanmasından kaynaklanır. Çıkarım sırasında(1024, 1024)varsayılan değerini kullanırsanız, veri setindeki kare görüntülerin kompozisyonuna benzeyen bir görüntü elde edersiniz.target_sizeveoriginal_sizeiçin aynı değeri kullanmanızı öneririz, ancak diğer seçeneklerle deney yapmaktan çekinmeyin!
🤗 Diffusers, belirli görüntü çözünürlüklerinden kaçınmak için görüntü boyutuyla ilgili negatif koşullar belirtmenize de olanak tanır:
from diffusers import StableDiffusionXLPipeline
import torch

pipe = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Astronaut in a jungle, cold color palette, muted colors, detailed, 8k"
image = pipe(
    prompt=prompt,
    negative_original_size=(512, 512),
    negative_target_size=(1024, 1024),
).images[0]
Kırpma koşullandırma
Önceki Stable Diffusion modelleri tarafından üretilen görüntüler bazen kırpılmış gibi görünebilir. Bunun nedeni, bir batch'teki tüm görüntülerin aynı boyutta olması için eğitim sırasında görüntülerin gerçekten kırpılmasıdır. SDXL, kırpma koordinatlarına koşullanarak, kırpma yapılmadığını - koordinatlar (0, 0) - genellikle ortalanmış konularla ve tam yüzlerle korelasyon gösterdiğini öğrenir (bu, 🤗 Diffusers'ta varsayılan değerdir). Ortalaması olmayan kompozisyonlar üretmek isterseniz farklı koordinatlarla deney yapabilirsiniz!
from diffusers import StableDiffusionXLPipeline
import torch

pipeline = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Astronaut in a jungle, cold color palette, muted colors, detailed, 8k"
image = pipeline(prompt=prompt, crops_coords_top_left=(256, 0)).images[0]
image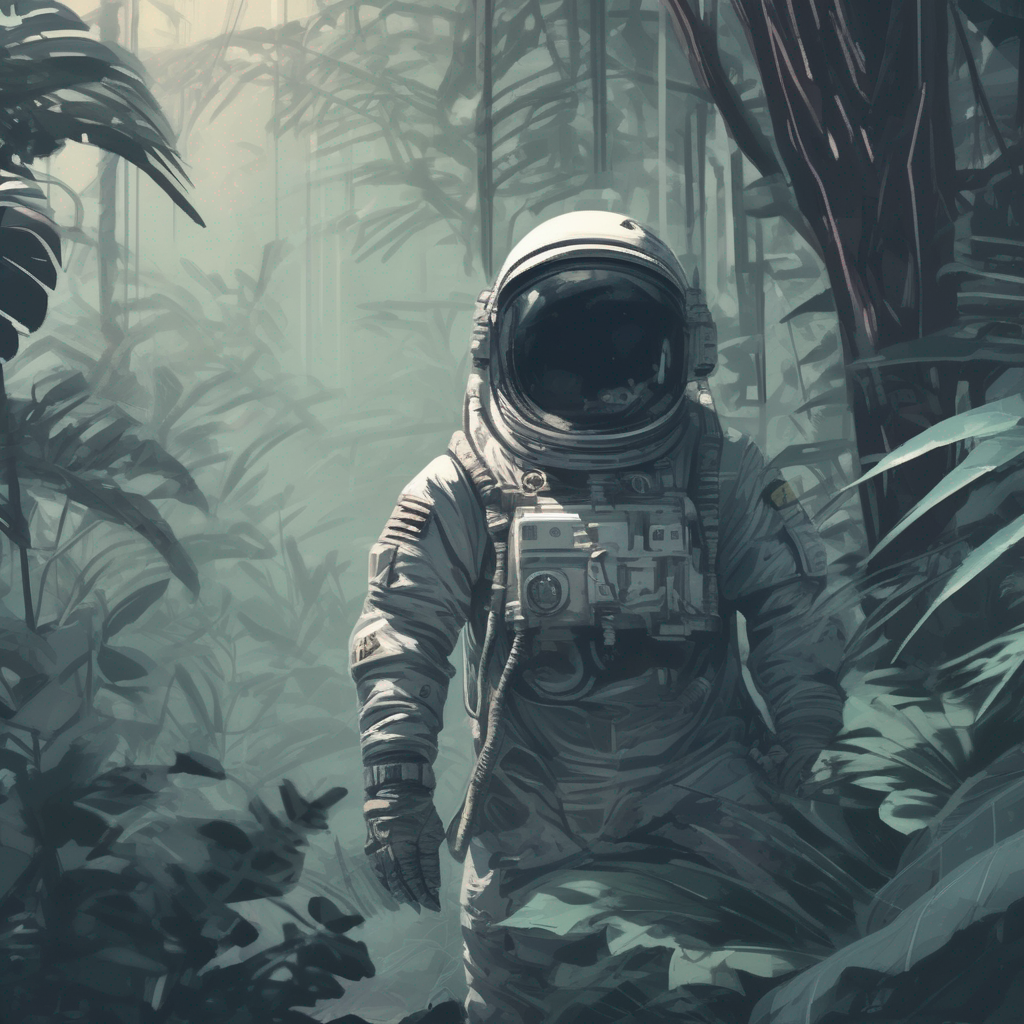
Belirli kırpma parametrelerinden üretimden uzaklaşmak için negatif kırpma koordinatları da belirleyebilirsiniz:
from diffusers import StableDiffusionXLPipeline
import torch

pipe = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Astronaut in a jungle, cold color palette, muted colors, detailed, 8k"
image = pipe(
    prompt=prompt,
    negative_original_size=(512, 512),
    negative_crops_coords_top_left=(0, 0),
    negative_target_size=(1024, 1024),
).images[0]
image
Her metin kodlayıcı için farklı bir istem kullanın
SDXL iki metin kodlayıcı kullandığı için her bir metin kodlayıcıya farklı bir istem (prompt) iletilebilir ve bu kaliteyi artırabilir. Orijinal isteminizi prompt parametresine, ikinci istemi ise prompt_2 parametresine iletin (negatif istemler kullanıyorsanız negative_prompt ve negative_prompt_2 parametrelerini kullanın):
from diffusers import StableDiffusionXLPipeline
import torch

pipeline = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", dtype=torch.float16, variant="fp16", use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

# prompt is passed to OAI CLIP-ViT/L-14
prompt = "Astronaut in a jungle, cold color palette, muted colors, detailed, 8k"
# prompt_2 is passed to OpenCLIP-ViT/bigG-14
prompt_2 = "Van Gogh painting"
image = pipeline(prompt=prompt, prompt_2=prompt_2).images[0]
image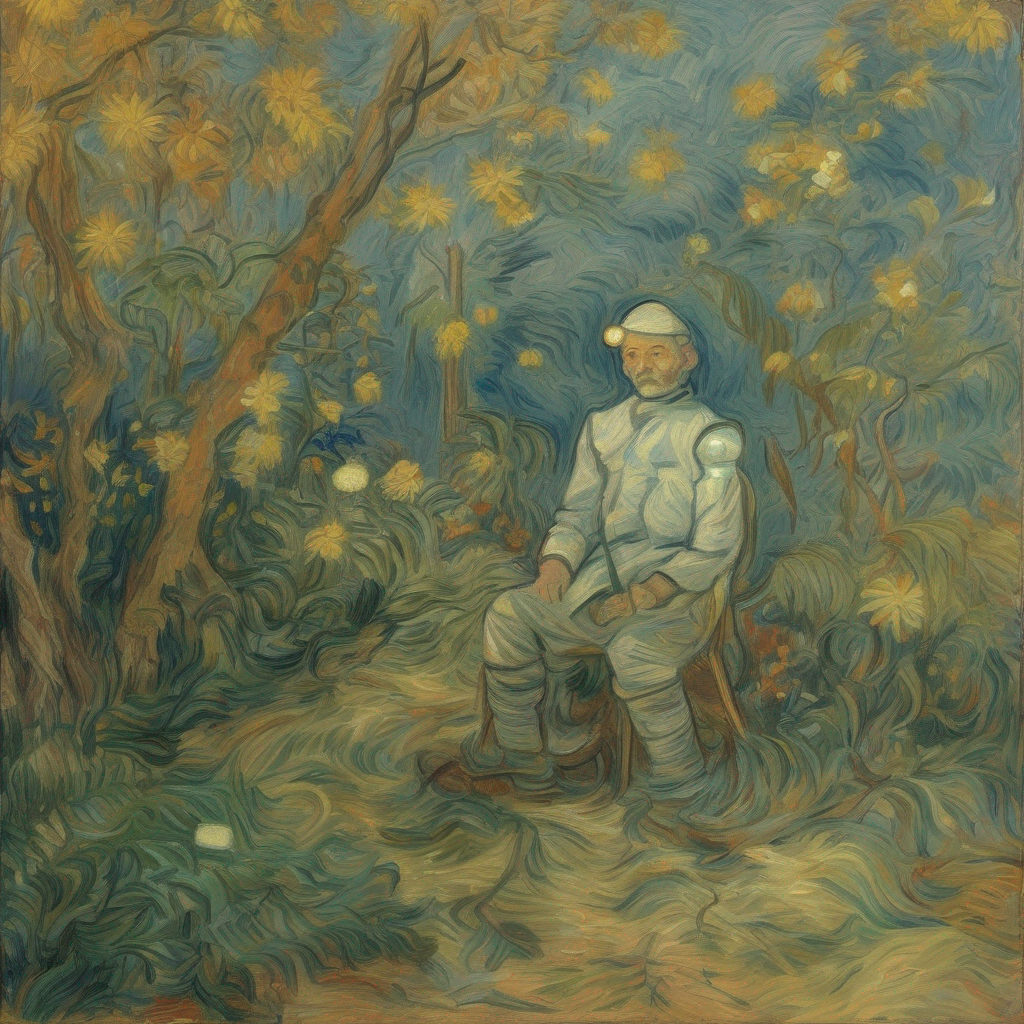
Çift metin kodlayıcılar, metinsel ters çevirme kılavuzunda açıklandığı gibi ayrı olarak yüklenmesi gereken metinsel ters çevirme gömme değerlerini de destekler.
Optimizasyonlar
SDXL büyük bir modeldir ve donanımınızda çalıştırabilmek için belleği optimize etmeniz gerekebilir. Bellek tasarrufu yapmanın ve çıkarımı hızlandırmanın bazı ipuçları aşağıda verilmiştir.
- Bellek dışı (out-of-memory) hataları için modeli enable_model_cpu_offload() ile CPU'ya taşıyın:
- base.to("cuda")  # or "mps", "xpu", "cpu"
- refiner.to("cuda")
+ base.enable_model_cpu_offload()
+ refiner.enable_model_cpu_offload()- ~%20 hızlanma için
torch.compilekullanın (torch>=2.0gereklidir):
+ base.unet = torch.compile(base.unet, mode="reduce-overhead", fullgraph=True)
+ refiner.unet = torch.compile(refiner.unet, mode="reduce-overhead", fullgraph=True)torch<2.0ise SDXL'i çalıştırmak için xFormers'ı etkinleştirin:
+ base.enable_xformers_memory_efficient_attention()
+ refiner.enable_xformers_memory_efficient_attention()
Kaynaklar
SDXL'de kullanılan UNet2DConditionModel'in minimal bir versiyonuyla deneyler yapmak ilginizi çekiyorsa, PyTorch ile yazılmış ve 🤗 Diffusers ile doğrudan uyumlu olan minSDXL uygulamasına göz atın.
StableDiffusionXLPipeline
sınıf diffusers.StableDiffusionXLPipeline
< source >( vae: AutoencoderKLtext_encoder: CLIPTextModeltext_encoder_2: CLIPTextModelWithProjectiontokenizer: CLIPTokenizertokenizer_2: CLIPTokenizerunet: UNet2DConditionModelscheduler: KarrasDiffusionSchedulersimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = Noneforce_zeros_for_empty_prompt: bool = Trueadd_watermarker: bool | None = None )
Parametreler
- vae (AutoencoderKL) — Görselleri latent temsillere kodlamak ve bu temsillerden çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) Modeli.
- text_encoder (
CLIPTextModel) — Donmuş metin kodlayıcı. Stable Diffusion XL, CLIP'in metin bölümünü, özellikle clip-vit-large-patch14 varyantını kullanır. - text_encoder_2 (
CLIPTextModelWithProjection) — İkinci dondurulmuş metin kodlayıcı. Stable Diffusion XL, CLIP'in metin ve havuz (pool) bölümünü kullanır, özellikle laion/CLIP-ViT-bigG-14-laion2B-39B-b160k değişkenini. - tokenizer (
CLIPTokenizer) — CLIPTokenizer sınıfının tokenization aracı. - tokenizer_2 (
CLIPTokenizer) — CLIPTokenizer sınıfının ikinci Tokenizer'ı. - unet (UNet2DConditionModel) — Kodlanmış görüntü latentlerini gürültüden arındırmak için koşullu U-Net mimarisi.
- scheduler (SchedulerMixin) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için
unetile birlikte kullanılacak bir zamanlayıcı. DDIMScheduler, LMSDiscreteScheduler veya PNDMScheduler olabilir. - force_zeros_for_empty_prompt (
bool, isteğe bağlı, varsayılan"True") — Negatif istek gömme değerlerinin her zaman 0 olarak ayarlanıp ayarlanmayacağı. Ayrıcastabilityai/stable-diffusion-xl-base-1-0yapılandırmasına da bakın. - add_watermarker (
bool, isteğe bağlı) — Çıktı görsellerine filigran eklemek için invisible_watermark kütüphanesinin kullanılıp kullanılmayacağını belirtir. Tanımlanmamışsa, paket yüklüyse varsayılan olarak True olur, aksi halde filigran kullanılmaz.
Stable Diffusion XL kullanılarak metinden görüntüye üretim için Pipeline.
Bu model DiffusionPipeline sınıfından devralır. Kütüphanenin tüm pipeline'lar için uyguladığı genel yöntemler (indirme veya kaydetme, belirli bir cihazda çalıştırma vb.) için üst sınıf belgelendirmesine bakın.
Pipeline ayrıca aşağıdaki yükleme yöntemlerini devralır:
- Metinsel tersine çevirme gömme yüklemek için load_textual_inversion()
.ckptdosyalarını yüklemek için from_single_file()- LoRA ağırlıklarını yüklemek için load_lora_weights()
- LoRA ağırlıklarını kaydetmek için save_lora_weights()
- IP Adapter'ları yüklemek için load_ip_adapter()
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 50timesteps: list = Nonesigmas: list = Nonedenoising_end: float | None = Noneguidance_scale: float = 5.0negative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenum_images_per_prompt: int | None = 1eta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonepooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecross_attention_kwargs: dict[str, typing.Any] | None = Noneguidance_rescale: float = 0.0original_size: tuple[int, int] | None = Nonecrops_coords_top_left: tuple = (0, 0)target_size: tuple[int, int] | None = Nonenegative_original_size: tuple[int, int] | None = Nonenegative_crops_coords_top_left: tuple = (0, 0)negative_target_size: tuple[int, int] | None = Noneclip_skip: int | None = Nonecallback_on_step_end: typing.Union[typing.Callable[[int, int], NoneType], diffusers.callbacks.PipelineCallback, diffusers.callbacks.MultiPipelineCallbacks, NoneType] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']**kwargs ) → ~pipelines.stable_diffusion_xl.StableDiffusionXLPipelineOutput or tuple
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimi yönlendirmek için istem veya istemler. Tanımlanmadıysa bunun yerineprompt_embedsgeçirilmelidir. - prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'e gönderilecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıdapromptkullanılır - height (
int, isteğe bağlı, varsayılan: self.unet.config.sample_size * self.vae_scale_factor) — Oluşturulan görüntünün piksel cinsinden yüksekliği. En iyi sonuçlar için varsayılan olarak 1024 olarak ayarlanır. 512 pikselin altındaki değerler, düşük çözünürlükler üzerinde özellikle ince ayar yapılmamış stabilityai/stable-diffusion-xl-base-1.0 ve kontrol noktaları için iyi çalışmaz. - width (
int, isteğe bağlı, varsayılan: self.unet.config.sample_size * self.vae_scale_factor) — Oluşturulan görüntünün piksel cinsinden genişliği. En iyi sonuçlar için varsayılan olarak 1024 olarak ayarlanır. 512 pikselin altındaki değerler, düşük çözünürlükler üzerinde özellikle ince ayar yapılmamış stabilityai/stable-diffusion-xl-base-1.0 ve kontrol noktaları için iyi çalışmaz. - num_inference_steps (
int, isteğe bağlı, varsayılan 50) — Gürültü azaltma adım sayısı. Daha fazla gürültü azaltma adımı genellikle daha yavaş çıkarım pahasına daha yüksek kaliteli bir görüntüye yol açar. - timesteps (
list[int], isteğe bağlı) —timestepsargümanını destekleyen zamanlayıcılarla gürültü azaltma süreci için kullanılacak özel zaman adımları.set_timestepsyönteminde. Tanımlanmamışsa,num_inference_stepsgeçirildiğinde varsayılan davranış kullanılacaktır. Azalan sırada olmalıdır. - sigmas (
list[float], isteğe bağlı) —set_timestepsyöntemlerindesigmasargümanını destekleyen zamanlayıcılarla gürültü azaltma sürecinde kullanılacak özel sigmalar. Tanımlanmamışsa,num_inference_stepsgeçirildiğinde varsayılan davranış kullanılır. - denoising_end (
float, isteğe bağlı) — Belirtilirse, gürültü azaltma sürecinin tamamının, kasıtlı olarak erken sonlandırılmadan önce tamamlanacak oranını (0.0 ile 1.0 arasında) belirler. Sonuç olarak, zamanlayıcı tarafından seçilen ayrık zaman adımları tarafından belirlenen önemli miktarda gürültüyü koruyan bir örnek döndürülür. Görüntü Çıktısını İnce Ayarlama bölümünde ayrıntılı olarak açıklanan “Mixture of Denoisers” çoklu hattı kurulumunun bir parçası olarak bu hat kullanıldığında, denoising_end parametresinin ideal olarak kullanılması önerilir. - guidance_scale (
float, isteğe bağlı, varsayılan 5.0) — Classifier-Free Diffusion Guidance makalesinde tanımlandığı gibi yönlendirme ölçeği.guidance_scale, Imagen Paper'daki 2. denklemindekiwolarak tanımlanır. Yönlendirme ölçeği,guidance_scale > 1olarak ayarlanarak etkinleştirilir. Daha yüksek yönlendirme ölçeği,promptile yakından ilişkili görsellerin üretilmesini teşvik eder, genellikle bu da daha düşük görsel kalitesi pahasına olur. - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - negative_prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'ye gönderilecek, görsel üretimi yönlendirmeyecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıda danegative_promptkullanılır. - num_images_per_prompt (
int, isteğe bağlı, varsayılan 1) — Her istem için oluşturulacak görsel sayısı. - eta (
float, isteğe bağlı, varsayılan 0.0) — DDIM makalesindeki eta (η) parametresine karşılık gelir: https://huggingface.co/papers/2010.02502. Yalnızca schedulers.DDIMScheduler için geçerlidir, diğerlerinde yok sayılır. - generator (
torch.Generatorveyalist[torch.Generator], isteğe bağlı) — Üretimi deterministik hale getirmek için bir veya torch üreteci listesi. - latents (
torch.Tensor, isteğe bağlı) — Gaussian dağılımdan örneklenmiş, gürültülü ve önceden oluşturulmuş latents; görüntü üretimi için girdi olarak kullanılabilir. Farklı istemlerle aynı üretimi ayarlamak için kullanılabilir. Sağlanmazsa, sağlanan rastgelegeneratorkullanılarak örneklemeye dayalı bir latents tensörü oluşturulur. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - ip_adapter_image — (
PipelineImageInput, isteğe bağlı): IP Adapter'larla çalışmak için isteğe bağlı görüntü girdisi. - ip_adapter_image_embeds (
list[torch.Tensor], isteğe bağlı) — IP-Adapter için önceden oluşturulmuş gömme (embedding) değerleri. IP-adapter sayısı ile aynı uzunlukta bir liste olmalıdır. Her öğe,(batch_size, num_images, emb_dim)biçiminde bir tensör olmalıdır.do_classifier_free_guidanceTrueolarak ayarlandıysa, negatif gömme değerini içermelidir. Sağlanmazsa, gömme değerleriip_adapter_imagegirdi argümanından hesaplanır. - output_type (
str, isteğe bağlı, varsayılan"pil") — Görsel oluşturma çıktısının biçimi. Şunlardan birini seçin: PIL:PIL.Image.Imageveyanp.array. - return_dict (
bool, isteğe bağlı, varsayılanTrue) — Düz bir tuple yerine~pipelines.stable_diffusion_xl.StableDiffusionXLPipelineOutputdöndürülüp döndürülmemesi. - cross_attention_kwargs (
dict, isteğe bağlı) — Belirtilirse, diffusers.models.attention_processor içindekiself.processoraltında tanımlananAttentionProcessor'a iletilen bir kwargs sözlüğü. - guidance_rescale (
float, isteğe bağlı, varsayılan 0.0) — Common Diffusion Noise Schedules and Sample Steps are Flawed makalesinde önerilen guidance rescale faktörü.guidance_scale, Common Diffusion Noise Schedules and Sample Steps are Flawed makalesindeki 16. denklemdeφolarak tanımlanmıştır. Guidance rescale faktörü, zero terminal SNR kullanılırken aşırı pozlamayı düzeltmelidir. - original_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) —original_size,target_sizeile aynı değilse görüntü küçültülmüş veya büyütülmüş gibi görünür. Belirtilmediyseoriginal_sizevarsayılan olarak(height, width)değerini alır. SDXL’in mikro-konumlama (micro-conditioning) bileşenidir; bunun açıklaması https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde yer alır. - crops_coords_top_left (
tuple[int], isteğe bağlı, varsayılan (0, 0)) —crops_coords_top_left,crops_coords_top_leftkonumundan aşağıya doğru “kırpılmış” gibi görünen bir görüntü oluşturmak için kullanılabilir. Genellikle iyi merkezlenmiş, uygun görüntülercrops_coords_top_leftparametresini (0, 0) olarak ayarlayarak elde edilir. https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - target_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Çoğu durumda,target_sizeüretilen görüntünün istenen yükseklik ve genişliğine ayarlanmalıdır. Belirtilmezse varsayılan olarak(height, width)olur. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - negative_original_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Belirli bir görüntü çözünürlüğüne dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklandığı üzere SDXL’in mikro-konşullandırmasının bir parçasıdır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - negative_crops_coords_top_left (
tuple[int], isteğe bağlı, varsayılan (0, 0)) — Belirli bir kırpma koordinatına dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. SDXL’in mikro-koşullandırmasının bir parçasıdır; https://huggingface.co/papers/2307.01952 makalesinin 2.2 bölümünde açıklanmıştır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - negative_target_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Hedef bir görüntü çözünürlüğüne dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. Çoğu durumdatarget_sizeile aynı olmalıdır. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklanan SDXL mikro-konşullandırmasının bir parçasıdır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir. - callback_on_step_end (
Callable,PipelineCallback,MultiPipelineCallbacks, isteğe bağlı) — Çıkarım sırasında her gürültü azaltma adımının sonunda çağrılan, aşağıdaki argümanlara sahip bir fonksiyon veyaPipelineCallback/MultiPipelineCallbacksalt sınıfı:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargs,callback_on_step_end_tensor_inputstarafından belirtilen tüm tensörlerin listesini içerecektir. - callback_on_step_end_tensor_inputs (
list, isteğe bağlı) —callback_on_step_endişlevi için girdi tensörlerinin listesi. Listede belirtilen tensörler,callback_kwargsargümanı olarak geçirilir. Yalnızca pipeline sınıfınızın._callback_tensor_inputsözniteliğinde listelenen değişkenleri dahil edebilirsiniz.
Dönüş değeri
~pipelines.stable_diffusion_xl.StableDiffusionXLPipelineOutput veya tuple
return_dict True ise ~pipelines.stable_diffusion_xl.StableDiffusionXLPipelineOutput, aksi halde bir tuple. Bir tuple döndürüldüğünde, ilk öğe üretilen görsellerin listesidir.
Üretim için pipeline çağrıldığında tetiklenen işlev.
Örnekler:
>>> import torch
>>> from diffusers import StableDiffusionXLPipeline

>>> pipe = StableDiffusionXLPipeline.from_pretrained(
...     "stabilityai/stable-diffusion-xl-base-1.0", torch_dtype=torch.float16
... )
>>> pipe = pipe.to("cuda")

>>> prompt = "a photo of an astronaut riding a horse on mars"
>>> image = pipe(prompt).images[0]
encode_prompt
< source >( prompt: strprompt_2: str | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = Truenegative_prompt: str | None = Nonenegative_prompt_2: str | None = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonepooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonelora_scale: float | None = Noneclip_skip: int | None = None )
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — kodlanacak prompt - prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'e gönderilecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıdapromptkullanılır - device — (
torch.device): torch cihazı - num_images_per_prompt (
int) — her prompt için oluşturulacak görsel sayısı - do_classifier_free_guidance (
bool) — classifier free guidance kullanılacak mı - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - negative_prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'ye gönderilecek, görsel üretimi yönlendirmeyecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıda danegative_promptkullanılır. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - lora_scale (
float, isteğe bağlı) — LoRA katmanları yüklendiyse, metin kodlayıcısının tüm LoRA katmanlarına uygulanacak bir LoRA ölçeği. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir.
İsteği metin kodlayıcı gizli durumlarına kodlar.
get_guidance_scale_embedding
< source >( w: Tensorembedding_dim: int = 512dtype: dtype = torch.float32 ) → torch.Tensor
Parametreler
- w (
torch.Tensor) — Belirtilen bir yönlendirme ölçeğiyle gömme vektörleri üretin ve ardından zaman adımları gömmelerini zenginleştirmek için kullanın. - embedding_dim (
int, isteğe bağlı, varsayılan 512) — Oluşturulacak gömme boyutu. - dtype (
torch.dtype, isteğe bağlı, varsayılantorch.float32) — Oluşturulan gömme vektörlerinin veri türü.
Dönüş değeri
torch.Tensor
(len(w), embedding_dim) biçiminde gömme vektörleri.
StableDiffusionXLImg2ImgPipeline
sınıf diffusers.StableDiffusionXLImg2ImgPipeline
< source >( vae: AutoencoderKLtext_encoder: CLIPTextModeltext_encoder_2: CLIPTextModelWithProjectiontokenizer: CLIPTokenizertokenizer_2: CLIPTokenizerunet: UNet2DConditionModelscheduler: KarrasDiffusionSchedulersimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = Nonerequires_aesthetics_score: bool = Falseforce_zeros_for_empty_prompt: bool = Trueadd_watermarker: bool | None = None )
Parametreler
- vae (AutoencoderKL) — Görselleri latent temsillere kodlamak ve bu temsillerden çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) Modeli.
- text_encoder (
CLIPTextModel) — Donmuş metin kodlayıcı. Stable Diffusion XL, CLIP'in metin bölümünü, özellikle clip-vit-large-patch14 varyantını kullanır. - text_encoder_2 (
CLIPTextModelWithProjection) — İkinci dondurulmuş metin kodlayıcı. Stable Diffusion XL, CLIP'in metin ve havuz (pool) bölümünü kullanır, özellikle laion/CLIP-ViT-bigG-14-laion2B-39B-b160k değişkenini. - tokenizer (
CLIPTokenizer) — CLIPTokenizer sınıfının tokenization aracı. - tokenizer_2 (
CLIPTokenizer) — CLIPTokenizer sınıfının ikinci Tokenizer'ı. - unet (UNet2DConditionModel) — Kodlanmış görüntü latentlerini gürültüden arındırmak için koşullu U-Net mimarisi.
- scheduler (SchedulerMixin) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için
unetile birlikte kullanılacak bir zamanlayıcı. DDIMScheduler, LMSDiscreteScheduler veya PNDMScheduler olabilir. - requires_aesthetics_score (
bool, isteğe bağlı, varsayılan"False") —unet'in çıkarım sırasındaaesthetic_scorekoşulunun geçirilmesini gerektirip gerektirmediğini belirtir. Ayrıcastabilityai/stable-diffusion-xl-refiner-1-0yapılandırmasına da bakın. - force_zeros_for_empty_prompt (
bool, isteğe bağlı, varsayılan"True") — Negatif istek gömme değerlerinin her zaman 0 olarak ayarlanıp ayarlanmayacağı. Ayrıcastabilityai/stable-diffusion-xl-base-1-0yapılandırmasına da bakın. - add_watermarker (
bool, isteğe bağlı) — Çıktı görsellerine filigran eklemek için invisible_watermark kütüphanesinin kullanılıp kullanılmayacağını belirtir. Tanımlanmamışsa, paket yüklüyse varsayılan olarak True olur, aksi halde filigran kullanılmaz.
Stable Diffusion XL kullanılarak metinden görüntüye üretim için Pipeline.
Bu model DiffusionPipeline sınıfından devralır. Kütüphanenin tüm pipeline'lar için uyguladığı genel yöntemler (indirme veya kaydetme, belirli bir cihazda çalıştırma vb.) için üst sınıf belgelendirmesine bakın.
Pipeline ayrıca aşağıdaki yükleme yöntemlerini devralır:
- Metinsel tersine çevirme gömme yüklemek için load_textual_inversion()
.ckptdosyalarını yüklemek için from_single_file()- LoRA ağırlıklarını yüklemek için load_lora_weights()
- LoRA ağırlıklarını kaydetmek için save_lora_weights()
- IP Adapter'ları yüklemek için load_ip_adapter()
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneimage: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonestrength: float = 0.3num_inference_steps: int = 50timesteps: list = Nonesigmas: list = Nonedenoising_start: float | None = Nonedenoising_end: float | None = Noneguidance_scale: float = 5.0negative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenum_images_per_prompt: int | None = 1eta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonepooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecross_attention_kwargs: dict[str, typing.Any] | None = Noneguidance_rescale: float = 0.0original_size: tuple = Nonecrops_coords_top_left: tuple = (0, 0)target_size: tuple = Nonenegative_original_size: tuple[int, int] | None = Nonenegative_crops_coords_top_left: tuple = (0, 0)negative_target_size: tuple[int, int] | None = Noneaesthetic_score: float = 6.0negative_aesthetic_score: float = 2.5clip_skip: int | None = Nonecallback_on_step_end: typing.Union[typing.Callable[[int, int], NoneType], diffusers.callbacks.PipelineCallback, diffusers.callbacks.MultiPipelineCallbacks, NoneType] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']**kwargs ) → ~pipelines.stable_diffusion.StableDiffusionXLPipelineOutput or tuple
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimi yönlendirmek için istem veya istemler. Tanımlanmadıysa bunun yerineprompt_embedsgeçirilmelidir. - prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'e gönderilecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıdapromptkullanılır - image (
torch.TensorveyaPIL.Image.Imageveyanp.ndarrayveyalist[torch.Tensor]veyalist[PIL.Image.Image]veyalist[np.ndarray]) — Hattın (pipeline) değiştireceği görsel(ler). - strength (
float, isteğe bağlı, varsayılan 0.3) — Kavramsal olarak, referansimage'in ne kadar dönüştürüleceğini belirtir. 0 ile 1 arasında olmalıdır.imagebir başlangıç noktası olarak kullanılacak vestrengthdeğeri arttıkça ona daha fazla gürültü eklenecektir. Gürültü azaltma adımlarının sayısı, başlangıçta eklenen gürültü miktarına bağlıdır.strength1 olduğunda, eklenen gürültü maksimum seviyeye ulaşacak ve gürültü azaltma süreci,num_inference_steps'te belirtilen tam yineleme sayısı kadar çalışacaktır. Dolayısıyla 1 değeri,image'i fiilen yok sayar.denoising_start'ın bir tamsayı olarak belirtilmesi durumunda,strengthdeğerinin yoksayılacağını unutmayın. - num_inference_steps (
int, isteğe bağlı, varsayılan 50) — Gürültü azaltma adım sayısı. Daha fazla gürültü azaltma adımı genellikle daha yavaş çıkarım pahasına daha yüksek kaliteli bir görüntüye yol açar. - timesteps (
list[int], isteğe bağlı) —timestepsargümanını destekleyen zamanlayıcılarla gürültü azaltma süreci için kullanılacak özel zaman adımları.set_timestepsyönteminde. Tanımlanmamışsa,num_inference_stepsgeçirildiğinde varsayılan davranış kullanılacaktır. Azalan sırada olmalıdır. - sigmas (
list[float], isteğe bağlı) —set_timestepsyöntemlerindesigmasargümanını destekleyen zamanlayıcılarla gürültü azaltma sürecinde kullanılacak özel sigmalar. Tanımlanmamışsa,num_inference_stepsgeçirildiğinde varsayılan davranış kullanılır. - denoising_start (
float, isteğe bağlı) — Belirtilirse, gürültü giderme sürecinin başlatılmadan önce atlanacak oranını (0.0 ile 1.0 arasında) gösterir. Sonuç olarak, gürültü giderme sürecinin ilk kısmı atlanır ve geçirilenimagekısmen gürültüsü giderilmiş bir görüntü olarak kabul edilir. Dikkat edin, bu parametre belirtildiğinde strength yok sayılır.denoising_startparametresi, bu hattın Görüntü Kalitesini İyileştirme bölümünde ayrıntılandırıldığı gibi bir “Mixture of Denoisers” çoklu hat kurulumuna entegre edildiğinde özellikle faydalıdır. - denoising_end (
float, isteğe bağlı) — Belirtilirse, gürültü azaltma sürecinin tamamının, kasıtlı olarak erken sonlandırılmadan önce tamamlanacak oranını (0.0 ile 1.0 arasında) belirler. Sonuç olarak, döndürülen örnek hâlâ önemli miktarda gürültü içerecektir (yaklaşık olarak son 20'lik zaman adımı hâlâ gerekli) vedenoising_startdeğeri 0.8 olarak ayarlanmış bir halef pipeline tarafından, zamanlayıcının yalnızca son %20'sini gürültüden arındırması için gürültüden arındırılmalıdır. Görsel Kalitesini İyileştirme'da ayrıntılı olarak açıklanan “Mixture of Denoisers” çoklu pipeline kurulumunun bir parçası olarak bu pipeline kullanıldığında, denoising_end parametresi ideal olarak kullanılmalıdır. - guidance_scale (
float, isteğe bağlı, varsayılan 7.5) — Classifier-Free Diffusion Guidance makalesinde tanımlandığı gibi yönlendirme ölçeği.guidance_scale, Imagen Paper makalesindeki 2. denklemindekiwolarak tanımlanır. Yönlendirme ölçeği,guidance_scale > 1olarak ayarlanarak etkinleştirilir. Daha yüksek yönlendirme ölçeği,promptmetniyle yakından ilişkili görsellerin üretilmesini teşvik eder, genellikle daha düşük görsel kalitesi pahasına. - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - negative_prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'ye gönderilecek, görsel üretimi yönlendirmeyecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıda danegative_promptkullanılır. - num_images_per_prompt (
int, isteğe bağlı, varsayılan 1) — Her istem için oluşturulacak görsel sayısı. - eta (
float, isteğe bağlı, varsayılan 0.0) — DDIM makalesindeki eta (η) parametresine karşılık gelir: https://huggingface.co/papers/2010.02502. Yalnızca schedulers.DDIMScheduler için geçerlidir, diğerlerinde yok sayılır. - generator (
torch.Generatorveyalist[torch.Generator], isteğe bağlı) — Üretimi deterministik hale getirmek için bir veya torch üreteci listesi. - latents (
torch.Tensor, isteğe bağlı) — Gaussian dağılımdan örneklenmiş, gürültülü ve önceden oluşturulmuş latents; görüntü üretimi için girdi olarak kullanılabilir. Farklı istemlerle aynı üretimi ayarlamak için kullanılabilir. Sağlanmazsa, sağlanan rastgelegeneratorkullanılarak örneklemeye dayalı bir latents tensörü oluşturulur. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - ip_adapter_image — (
PipelineImageInput, isteğe bağlı): IP Adapter'larla çalışmak için isteğe bağlı görüntü girdisi. - ip_adapter_image_embeds (
list[torch.Tensor], isteğe bağlı) — IP-Adapter için önceden oluşturulmuş gömme (embedding) değerleri. IP-adapter sayısı ile aynı uzunlukta bir liste olmalıdır. Her öğe,(batch_size, num_images, emb_dim)biçiminde bir tensör olmalıdır.do_classifier_free_guidanceTrueolarak ayarlandıysa, negatif gömme değerini içermelidir. Sağlanmazsa, gömme değerleriip_adapter_imagegirdi argümanından hesaplanır. - output_type (
str, isteğe bağlı, varsayılan"pil") — Görsel oluşturma çıktısının biçimi. Şunlardan birini seçin: PIL:PIL.Image.Imageveyanp.array. - return_dict (
bool, isteğe bağlı, varsayılanTrue) — Düz bir tuple yerine~pipelines.stable_diffusion.StableDiffusionXLPipelineOutputdöndürülüp döndürülmemesi. - cross_attention_kwargs (
dict, isteğe bağlı) — Belirtilirse, diffusers.models.attention_processor içindekiself.processoraltında tanımlananAttentionProcessor'a iletilen bir kwargs sözlüğü. - guidance_rescale (
float, isteğe bağlı, varsayılan 0.0) — Common Diffusion Noise Schedules and Sample Steps are Flawed makalesinde önerilen guidance rescale faktörü.guidance_scale, Common Diffusion Noise Schedules and Sample Steps are Flawed makalesindeki 16. denklemdeφolarak tanımlanmıştır. Guidance rescale faktörü, zero terminal SNR kullanılırken aşırı pozlamayı düzeltmelidir. - original_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) —original_size,target_sizeile aynı değilse görüntü küçültülmüş veya büyütülmüş gibi görünür. Belirtilmediyseoriginal_sizevarsayılan olarak(height, width)değerini alır. SDXL’in mikro-konumlama (micro-conditioning) bileşenidir; bunun açıklaması https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde yer alır. - crops_coords_top_left (
tuple[int], isteğe bağlı, varsayılan (0, 0)) —crops_coords_top_left,crops_coords_top_leftkonumundan aşağıya doğru “kırpılmış” gibi görünen bir görüntü oluşturmak için kullanılabilir. Genellikle iyi merkezlenmiş, uygun görüntülercrops_coords_top_leftparametresini (0, 0) olarak ayarlayarak elde edilir. https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - target_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Çoğu durumda,target_sizeüretilen görüntünün istenen yükseklik ve genişliğine ayarlanmalıdır. Belirtilmezse varsayılan olarak(height, width)olur. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - negative_original_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Belirli bir görüntü çözünürlüğüne dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklandığı üzere SDXL’in mikro-konşullandırmasının bir parçasıdır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - negative_crops_coords_top_left (
tuple[int], isteğe bağlı, varsayılan (0, 0)) — Belirli bir kırpma koordinatına dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. SDXL’in mikro-koşullandırmasının bir parçasıdır; https://huggingface.co/papers/2307.01952 makalesinin 2.2 bölümünde açıklanmıştır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - negative_target_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Hedef bir görüntü çözünürlüğüne dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. Çoğu durumdatarget_sizeile aynı olmalıdır. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklanan SDXL mikro-konşullandırmasının bir parçasıdır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - aesthetic_score (
float, isteğe bağlı, varsayılan 6.0) — Oluşturulan görüntünün estetik puanını, pozitif metin koşulunu etkileyerek simüle etmek için kullanılır. https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - negative_aesthetic_score (
float, isteğe bağlı, varsayılan 2.5) — https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklandığı üzere SDXL’in mikro-konumlama (micro-conditioning) bileşenlerinden biridir. Negatif metin koşulunu etkileyerek üretilen görüntünün estetik puanını simüle etmek için kullanılabilir. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir. - callback_on_step_end (
Callable,PipelineCallback,MultiPipelineCallbacks, isteğe bağlı) — Çıkarım sırasında her gürültü azaltma adımının sonunda çağrılan, aşağıdaki argümanlara sahip bir fonksiyon veyaPipelineCallback/MultiPipelineCallbacksalt sınıfı:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargs,callback_on_step_end_tensor_inputstarafından belirtilen tüm tensörlerin listesini içerecektir. - callback_on_step_end_tensor_inputs (
list, isteğe bağlı) —callback_on_step_endişlevi için girdi tensörlerinin listesi. Listede belirtilen tensörler,callback_kwargsargümanı olarak geçirilir. Yalnızca pipeline sınıfınızın._callback_tensor_inputsözniteliğinde listelenen değişkenleri dahil edebilirsiniz.
Dönüş değeri
~pipelines.stable_diffusion.StableDiffusionXLPipelineOutput veya tuple
return_dict True ise ~pipelines.stable_diffusion.StableDiffusionXLPipelineOutput, aksi halde bir `tuple döner. Tuple döndürüldüğünde, ilk öğe üretilen görsellerin listesidir.
Üretim için pipeline çağrıldığında tetiklenen işlev.
Örnekler:
>>> import torch
>>> from diffusers import StableDiffusionXLImg2ImgPipeline
>>> from diffusers.utils import load_image

>>> pipe = StableDiffusionXLImg2ImgPipeline.from_pretrained(
...     "stabilityai/stable-diffusion-xl-refiner-1.0", torch_dtype=torch.float16
... )
>>> pipe = pipe.to("cuda")
>>> url = "https://huggingface.co/datasets/patrickvonplaten/images/resolve/main/aa_xl/000000009.png"

>>> init_image = load_image(url).convert("RGB")
>>> prompt = "a photo of an astronaut riding a horse on mars"
>>> image = pipe(prompt, image=init_image).images[0]
encode_prompt
< source >( prompt: strprompt_2: str | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = Truenegative_prompt: str | None = Nonenegative_prompt_2: str | None = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonepooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonelora_scale: float | None = Noneclip_skip: int | None = None )
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — kodlanacak prompt - prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'e gönderilecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıdapromptkullanılır - device — (
torch.device): torch cihazı - num_images_per_prompt (
int) — her prompt için oluşturulacak görsel sayısı - do_classifier_free_guidance (
bool) — classifier free guidance kullanılacak mı - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - negative_prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'ye gönderilecek, görsel üretimi yönlendirmeyecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıda danegative_promptkullanılır. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - lora_scale (
float, isteğe bağlı) — LoRA katmanları yüklendiyse, metin kodlayıcısının tüm LoRA katmanlarına uygulanacak bir LoRA ölçeği. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir.
İsteği metin kodlayıcı gizli durumlarına kodlar.
get_guidance_scale_embedding
< source >( w: Tensorembedding_dim: int = 512dtype: dtype = torch.float32 ) → torch.Tensor
Parametreler
- w (
torch.Tensor) — Belirtilen bir yönlendirme ölçeğiyle gömme vektörleri üretin ve ardından zaman adımları gömmelerini zenginleştirmek için kullanın. - embedding_dim (
int, isteğe bağlı, varsayılan 512) — Oluşturulacak gömme boyutu. - dtype (
torch.dtype, isteğe bağlı, varsayılantorch.float32) — Oluşturulan gömme vektörlerinin veri türü.
Dönüş değeri
torch.Tensor
(len(w), embedding_dim) biçiminde gömme vektörleri.
StableDiffusionXLInpaintPipeline
sınıf diffusers.StableDiffusionXLInpaintPipeline
< source >( vae: AutoencoderKLtext_encoder: CLIPTextModeltext_encoder_2: CLIPTextModelWithProjectiontokenizer: CLIPTokenizertokenizer_2: CLIPTokenizerunet: UNet2DConditionModelscheduler: KarrasDiffusionSchedulersimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = Nonerequires_aesthetics_score: bool = Falseforce_zeros_for_empty_prompt: bool = Trueadd_watermarker: bool | None = None )
Parametreler
- vae (AutoencoderKL) — Görselleri latent temsillere kodlamak ve bu temsillerden çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) Modeli.
- text_encoder (
CLIPTextModel) — Donmuş metin kodlayıcı. Stable Diffusion XL, CLIP'in metin bölümünü, özellikle clip-vit-large-patch14 varyantını kullanır. - text_encoder_2 (
CLIPTextModelWithProjection) — İkinci dondurulmuş metin kodlayıcı. Stable Diffusion XL, CLIP'in metin ve havuz (pool) bölümünü kullanır, özellikle laion/CLIP-ViT-bigG-14-laion2B-39B-b160k değişkenini. - tokenizer (
CLIPTokenizer) — CLIPTokenizer sınıfının tokenization aracı. - tokenizer_2 (
CLIPTokenizer) — CLIPTokenizer sınıfının ikinci Tokenizer'ı. - unet (UNet2DConditionModel) — Kodlanmış görüntü latentlerini gürültüden arındırmak için koşullu U-Net mimarisi.
- scheduler (SchedulerMixin) —
Kodlanmış görüntü latentlerini gürültüden arındırmak için
unetile birlikte kullanılacak bir zamanlayıcı. DDIMScheduler, LMSDiscreteScheduler veya PNDMScheduler olabilir. - requires_aesthetics_score (
bool, isteğe bağlı, varsayılan"False") —unet'in çıkarım sırasında aesthetic_score koşulunun geçirilmesini gerektirip gerektirmediğini belirtir. Ayrıcastabilityai/stable-diffusion-xl-refiner-1-0yapılandırmasına da bakın. - force_zeros_for_empty_prompt (
bool, isteğe bağlı, varsayılan"True") — Negatif istek gömme değerlerinin her zaman 0 olarak ayarlanıp ayarlanmayacağı. Ayrıcastabilityai/stable-diffusion-xl-base-1-0yapılandırmasına da bakın. - add_watermarker (
bool, isteğe bağlı) — Çıktı görsellerine filigran eklemek için invisible_watermark kütüphanesinin kullanılıp kullanılmayacağını belirtir. Tanımlanmamışsa, paket yüklüyse varsayılan olarak True olur, aksi halde filigran kullanılmaz.
Stable Diffusion XL kullanılarak metinden görüntüye üretim için Pipeline.
Bu model DiffusionPipeline sınıfından devralır. Kütüphanenin tüm pipeline'lar için uyguladığı genel yöntemler (indirme veya kaydetme, belirli bir cihazda çalıştırma vb.) için üst sınıf belgelendirmesine bakın.
Pipeline ayrıca aşağıdaki yükleme yöntemlerini devralır:
- Metinsel tersine çevirme gömme yüklemek için load_textual_inversion()
.ckptdosyalarını yüklemek için from_single_file()- LoRA ağırlıklarını yüklemek için load_lora_weights()
- LoRA ağırlıklarını kaydetmek için save_lora_weights()
- IP Adapter'ları yüklemek için load_ip_adapter()
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneimage: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonemask_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonemasked_image_latents: Tensor = Noneheight: int | None = Nonewidth: int | None = Nonepadding_mask_crop: int | None = Nonestrength: float = 0.9999num_inference_steps: int = 50timesteps: list = Nonesigmas: list = Nonedenoising_start: float | None = Nonedenoising_end: float | None = Noneguidance_scale: float = 7.5negative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenum_images_per_prompt: int | None = 1eta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonepooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecross_attention_kwargs: dict[str, typing.Any] | None = Noneguidance_rescale: float = 0.0original_size: tuple = Nonecrops_coords_top_left: tuple = (0, 0)target_size: tuple = Nonenegative_original_size: tuple[int, int] | None = Nonenegative_crops_coords_top_left: tuple = (0, 0)negative_target_size: tuple[int, int] | None = Noneaesthetic_score: float = 6.0negative_aesthetic_score: float = 2.5clip_skip: int | None = Nonecallback_on_step_end: typing.Union[typing.Callable[[int, int], NoneType], diffusers.callbacks.PipelineCallback, diffusers.callbacks.MultiPipelineCallbacks, NoneType] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']**kwargs ) → ~pipelines.stable_diffusion.StableDiffusionXLPipelineOutput or tuple
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimi yönlendirmek için istem veya istemler. Tanımlanmadıysa bunun yerineprompt_embedsgeçirilmelidir. - prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'e gönderilecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıdapromptkullanılır - image (
PIL.Image.Image) — İnpainting işlemine tabi tutulacakImageveya bir görüntü partisini temsil eden tensör, yani görüntünün bazı kısımlarımask_imageile maskeleme yapılarakprompt’a göre yeniden boyanacaktır. - mask_image (
PIL.Image.Image) —Image, veyaimageüzerinde maskeleme yapılacak bir görüntü partisini temsil eden tensör. Maskedeki beyaz pikseller yeniden boyanırken, siyah pikseller korunur.mask_imagebir PIL görüntüsü ise, kullanılmadan önce tek kanala (parlaklık) dönüştürülür. Tensör ise, 3 kanal yerine tek bir renk kanalı (L) içermelidir; bu durumda beklenen şekil(B, H, W, 1)olur. - masked_image_latents (
torch.Tensor, isteğe bağlı) — Maskeleme uygulanmış görüntünün önceden kodlanmış latent değeri (inpainting için). - height (
int, isteğe bağlı, varsayılan: self.unet.config.sample_size * self.vae_scale_factor) — Oluşturulan görüntünün piksel cinsinden yüksekliği. En iyi sonuçlar için varsayılan olarak 1024 olarak ayarlanır. 512 pikselin altındaki değerler, düşük çözünürlükler üzerinde özellikle ince ayar yapılmamış stabilityai/stable-diffusion-xl-base-1.0 ve kontrol noktaları için iyi çalışmaz. - width (
int, isteğe bağlı, varsayılan: self.unet.config.sample_size * self.vae_scale_factor) — Oluşturulan görüntünün piksel cinsinden genişliği. En iyi sonuçlar için varsayılan olarak 1024 olarak ayarlanır. 512 pikselin altındaki değerler, düşük çözünürlükler üzerinde özellikle ince ayar yapılmamış stabilityai/stable-diffusion-xl-base-1.0 ve kontrol noktaları için iyi çalışmaz. - padding_mask_crop (
int, isteğe bağlı, varsayılanNone) — Görsel ve maskelemeye uygulanacak kırpma için kenar boşluğu boyutu.Noneise görsel ve mask_image üzerinde kırpma uygulanmaz.padding_mask_cropNonedeğilse, önce görselle aynı en-boy oranına sahip ve tüm maskelenmiş alanı içeren dikdörtgen bir bölge bulunur, ardından bu alanpadding_mask_cropdeğerine göre genişletilir. Ardından görsel ve mask_image, inpainting için orijinal görsel boyutuna yeniden boyutlandırılmadan önce genişletilen alana göre kırpılır. Bu, maskelenmiş alanın küçükken görselin büyük olması ve inpainting için alakasız bilgiler (örneğin arka plan) içermesi durumunda faydalıdır. - strength (
float, isteğe bağlı, varsayılan 0.9999) — Kavramsal olarak, referansimage'in maskelenmiş bölümünün ne kadar dönüştürüleceğini belirtir. 0 ile 1 arasında olmalıdır.imagebir başlangıç noktası olarak kullanılacak vestrengthdeğeri arttık ona daha fazla gürültü eklenecektir. Gürültü azaltma adımlarının sayısı, başlangıçta eklenen gürültü miktarına bağlıdır.strength1 olduğunda, eklenen gürültü maksimum olacak ve gürültü azaltma süreci,num_inference_stepsdeğerinde belirtilen tam tekrar sayısı kadar çalışacaktır. Dolayısıyla 1 değeri, referansimage'in maskelenmiş bölümünü fiilen yok sayar.denoising_start'ın bir tamsayı olarak tanımlandığı durumlarda,strengthdeğerinin yoksayılacağını unutmayın. - num_inference_steps (
int, isteğe bağlı, varsayılan 50) — Gürültü azaltma adım sayısı. Daha fazla gürültü azaltma adımı genellikle daha yavaş çıkarım pahasına daha yüksek kaliteli bir görüntüye yol açar. - timesteps (
list[int], isteğe bağlı) —timestepsargümanını destekleyen zamanlayıcılarla gürültü azaltma süreci için kullanılacak özel zaman adımları.set_timestepsyönteminde. Tanımlanmamışsa,num_inference_stepsgeçirildiğinde varsayılan davranış kullanılacaktır. Azalan sırada olmalıdır. - sigmas (
list[float], isteğe bağlı) —set_timestepsyöntemlerindesigmasargümanını destekleyen zamanlayıcılarla gürültü azaltma sürecinde kullanılacak özel sigmalar. Tanımlanmamışsa,num_inference_stepsgeçirildiğinde varsayılan davranış kullanılır. - denoising_start (
float, isteğe bağlı) — Belirtilirse, gürültü giderme sürecinin başlatılmadan önce atlanacak oranını (0.0 ile 1.0 arasında) gösterir. Sonuç olarak, gürültü giderme sürecinin ilk kısmı atlanır ve geçirilenimagekısmen gürültüsü giderilmiş bir görüntü olarak kabul edilir. Dikkat edin, bu parametre belirtildiğinde strength yok sayılır.denoising_startparametresi, bu hattın Görüntü Çıktısını İnce Ayarlama bölümünde ayrıntılandırıldığı gibi bir “Mixture of Denoisers” çoklu hat kurulumuna entegre edildiğinde özellikle faydalıdır. - denoising_end (
float, isteğe bağlı) — Belirtilirse, gürültü azaltma sürecinin tamamının, kasıtlı olarak erken sonlandırılmadan önce tamamlanacak oranını (0.0 ile 1.0 arasında) belirler. Sonuç olarak, döndürülen örnek hâlâ önemli miktarda gürültü içerecektir (yaklaşık olarak son 20'lik zaman adımları hâlâ gerekli) vedenoising_startdeğeri 0.8 olarak ayarlanmış bir halef pipeline tarafından, zamanlayıcının yalnızca son %20'sini gürültüden arındırması için gürültüden arındırılmalıdır. Görüntü Çıktısını İnce Ayarlama bölümünde ayrıntılı olarak açıklanan “Mixture of Denoisers” çoklu pipeline kurulumunun bir parçası olarak bu pipeline kullanıldığında, denoising_end parametresi ideal olarak kullanılmalıdır. - guidance_scale (
float, isteğe bağlı, varsayılan 7.5) — Classifier-Free Diffusion Guidance makalesinde tanımlandığı gibi yönlendirme ölçeği.guidance_scale, Imagen Paper makalesindeki 2. denklemindekiwolarak tanımlanır. Yönlendirme ölçeği,guidance_scale > 1olarak ayarlanarak etkinleştirilir. Daha yüksek yönlendirme ölçeği,promptmetniyle yakından ilişkili görsellerin üretilmesini teşvik eder, genellikle daha düşük görsel kalitesi pahasına. - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - negative_prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'ye gönderilecek, görsel üretimi yönlendirmeyecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıda danegative_promptkullanılır. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - ip_adapter_image — (
PipelineImageInput, isteğe bağlı): IP Adapter'larla çalışmak için isteğe bağlı görüntü girdisi. - ip_adapter_image_embeds (
list[torch.Tensor], isteğe bağlı) — IP-Adapter için önceden oluşturulmuş gömme (embedding) değerleri. IP-adapter sayısı ile aynı uzunlukta bir liste olmalıdır. Her öğe,(batch_size, num_images, emb_dim)biçiminde bir tensör olmalıdır.do_classifier_free_guidanceTrueolarak ayarlandıysa, negatif gömme değerini içermelidir. Sağlanmazsa, gömme değerleriip_adapter_imagegirdi argümanından hesaplanır. - num_images_per_prompt (
int, isteğe bağlı, varsayılan 1) — Her istem için oluşturulacak görsel sayısı. - eta (
float, isteğe bağlı, varsayılan 0.0) — DDIM makalesindeki eta (η) parametresine karşılık gelir: https://huggingface.co/papers/2010.02502. Yalnızca schedulers.DDIMScheduler için geçerlidir, diğerlerinde yok sayılır. - generator (
torch.Generator, isteğe bağlı) — Üretimi deterministik hale getirmek için bir veya torch üreteci listesi. - latents (
torch.Tensor, isteğe bağlı) — Gaussian dağılımdan örneklenmiş, gürültülü ve önceden oluşturulmuş latents; görüntü üretimi için girdi olarak kullanılabilir. Farklı istemlerle aynı üretimi ayarlamak için kullanılabilir. Sağlanmazsa, sağlanan rastgelegeneratorkullanılarak örneklemeye dayalı bir latents tensörü oluşturulur. - output_type (
str, isteğe bağlı, varsayılan"pil") — Görsel oluşturma çıktısının biçimi. Şunlardan birini seçin: PIL:PIL.Image.Imageveyanp.array. - return_dict (
bool, isteğe bağlı, varsayılanTrue) — Düz bir tuple yerine StableDiffusionPipelineOutput döndürülüp döndürülmemesi. - cross_attention_kwargs (
dict, isteğe bağlı) — Belirtilirse, diffusers.models.attention_processor içindekiself.processoraltında tanımlananAttentionProcessor'a iletilen bir kwargs sözlüğü. - original_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) —original_size,target_sizeile aynı değilse görüntü küçültülmüş veya büyütülmüş gibi görünür. Belirtilmediyseoriginal_sizevarsayılan olarak(height, width)değerini alır. SDXL’in mikro-konumlama (micro-conditioning) bileşenidir; bunun açıklaması https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde yer alır. - crops_coords_top_left (
tuple[int], isteğe bağlı, varsayılan (0, 0)) —crops_coords_top_left,crops_coords_top_leftkonumundan aşağıya doğru “kırpılmış” gibi görünen bir görüntü oluşturmak için kullanılabilir. Genellikle iyi merkezlenmiş, uygun görüntülercrops_coords_top_leftparametresini (0, 0) olarak ayarlayarak elde edilir. https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - target_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Çoğu durumda,target_sizeüretilen görüntünün istenen yükseklik ve genişliğine ayarlanmalıdır. Belirtilmezse varsayılan olarak(height, width)olur. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - negative_original_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Belirli bir görüntü çözünürlüğüne dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklandığı üzere SDXL’in mikro-konşullandırmasının bir parçasıdır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - negative_crops_coords_top_left (
tuple[int], isteğe bağlı, varsayılan (0, 0)) — Belirli bir kırpma koordinatına dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. SDXL’in mikro-koşullandırmasının bir parçasıdır; https://huggingface.co/papers/2307.01952 makalesinin 2.2 bölümünde açıklanmıştır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - negative_target_size (
tuple[int], isteğe bağlı, varsayılan (1024, 1024)) — Hedef bir görüntü çözünürlüğüne dayalı olarak üretim sürecini negatif olarak koşullandırmak için kullanılır. Çoğu durumdatarget_sizeile aynı olmalıdır. https://huggingface.co/papers/2307.01952 adresindeki makalenin 2.2 bölümünde açıklanan SDXL mikro-konşullandırmasının bir parçasıdır. Daha fazla bilgi için bu sorun başlığına bakın: https://github.com/huggingface/diffusers/issues/4208. - aesthetic_score (
float, isteğe bağlı, varsayılan 6.0) — Oluşturulan görüntünün estetik puanını, pozitif metin koşulunu etkileyerek simüle etmek için kullanılır. https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklanan SDXL mikro-konumlama (micro-conditioning) bileşenidir. - negative_aesthetic_score (
float, isteğe bağlı, varsayılan 2.5) — https://huggingface.co/papers/2307.01952 adresindeki 2.2 bölümünde açıklandığı üzere SDXL’in mikro-konumlama (micro-conditioning) bileşenlerinden biridir. Negatif metin koşulunu etkileyerek üretilen görüntünün estetik puanını simüle etmek için kullanılabilir. - guidance_rescale (
float, isteğe bağlı, varsayılan 0.0) — Common Diffusion Noise Schedules and Sample Steps are Flawed makalesindeki guidance rescale faktörü. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir. - callback_on_step_end (
Callable,PipelineCallback,MultiPipelineCallbacks, isteğe bağlı) — Çıkarım sırasında her gürültü azaltma adımının sonunda çağrılan, aşağıdaki argümanlara sahip bir fonksiyon veyaPipelineCallback/MultiPipelineCallbacksalt sınıfı:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargs,callback_on_step_end_tensor_inputstarafından belirtilen tüm tensörlerin listesini içerecektir. - callback_on_step_end_tensor_inputs (
list, isteğe bağlı) —callback_on_step_endişlevi için girdi tensörlerinin listesi. Listede belirtilen tensörler,callback_kwargsargümanı olarak geçirilir. Yalnızca pipeline sınıfınızın._callback_tensor_inputsözniteliğinde listelenen değişkenleri dahil edebilirsiniz.
Dönüş değeri
~pipelines.stable_diffusion.StableDiffusionXLPipelineOutput veya tuple
return_dict True ise ~pipelines.stable_diffusion.StableDiffusionXLPipelineOutput, aksi halde bir tuple. tuple. Tuple döndürüldüğünde, ilk öğe üretilen görsellerin listesidir.
Üretim için pipeline çağrıldığında tetiklenen işlev.
Örnekler:
>>> import torch
>>> from diffusers import StableDiffusionXLInpaintPipeline
>>> from diffusers.utils import load_image

>>> pipe = StableDiffusionXLInpaintPipeline.from_pretrained(
...     "stabilityai/stable-diffusion-xl-base-1.0",
...     torch_dtype=torch.float16,
...     variant="fp16",
...     use_safetensors=True,
... )
>>> pipe.to("cuda")

>>> img_url = "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo.png"
>>> mask_url = "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo_mask.png"

>>> init_image = load_image(img_url).convert("RGB")
>>> mask_image = load_image(mask_url).convert("RGB")

>>> prompt = "A majestic tiger sitting on a bench"
>>> image = pipe(
...     prompt=prompt, image=init_image, mask_image=mask_image, num_inference_steps=50, strength=0.80
... ).images[0]
encode_prompt
< source >( prompt: strprompt_2: str | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = Truenegative_prompt: str | None = Nonenegative_prompt_2: str | None = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonepooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = Nonelora_scale: float | None = Noneclip_skip: int | None = None )
Parametreler
- prompt (
strveyalist[str], isteğe bağlı) — kodlanacak prompt - prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'e gönderilecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıdapromptkullanılır - device — (
torch.device): torch cihazı - num_images_per_prompt (
int) — her prompt için oluşturulacak görsel sayısı - do_classifier_free_guidance (
bool) — classifier free guidance kullanılacak mı - negative_prompt (
strveyalist[str], isteğe bağlı) — Görsel üretimini yönlendirmemek için kullanılan istem veya istemler. Tanımlanmamışsa, bunun yerinenegative_prompt_embedsparametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yaniguidance_scaledeğeri1'den küçükse) yok sayılır. - negative_prompt_2 (
strveyalist[str], isteğe bağlı) —tokenizer_2vetext_encoder_2'ye gönderilecek, görsel üretimi yönlendirmeyecek istem veya istemler. Tanımlanmamışsa, her iki metin kodlayıcıda danegative_promptkullanılır. - prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. prompt ağırlıklandırma. Sağlanmazsa, metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış metin gömme değerleripromptgirdi argümanından oluşturulur. - negative_pooled_prompt_embeds (
torch.Tensor, isteğe bağlı) — Önceden oluşturulmuş negatif havuzlanmış metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, havuzlanmış negative_prompt_embeds,negative_promptgirdi argümanından oluşturulur. - lora_scale (
float, isteğe bağlı) — LoRA katmanları yüklendiyse, metin kodlayıcısının tüm LoRA katmanlarına uygulanacak bir LoRA ölçeği. - clip_skip (
int, isteğe bağlı) — İstem gömmelemelerini hesaplanırken CLIP'ten atlanacak katman sayısı. 1 değeri, istem gömmelemelerini hesaplamak için son öncesi katmanın çıktısının kullanılacağı anlamına gelir.
İsteği metin kodlayıcı gizli durumlarına kodlar.
get_guidance_scale_embedding
< source >( w: Tensorembedding_dim: int = 512dtype: dtype = torch.float32 ) → torch.Tensor
Parametreler
- w (
torch.Tensor) — Belirtilen bir yönlendirme ölçeğiyle gömme vektörleri üretin ve ardından zaman adımları gömmelerini zenginleştirmek için kullanın. - embedding_dim (
int, isteğe bağlı, varsayılan 512) — Oluşturulacak gömme boyutu. - dtype (
torch.dtype, isteğe bağlı, varsayılantorch.float32) — Oluşturulan gömme vektörlerinin veri türü.
Dönüş değeri
torch.Tensor
(len(w), embedding_dim) biçiminde gömme vektörleri.