
Transformers documentation
GLM-4.5، GLM-4.6، GLM-4.7
نُشر هذا النموذج في أوراق HF في 2025-08-08 وسُهم به في Hugging Face Transformers في 2025-07-21.
GLM-4.5، GLM-4.6، GLM-4.7
نظرة عامة
تستخدم نماذج اللغة GLM-4.7 وGLM-4.6 وGLM-4.5 هذه الفئة. ولا تتضمن النسخة المطبقة في transformers طبقة MTP.
GLM-4.7
GLM-4.7، شريكك الجديد في البرمجة، قادم مع الميزات التالية:
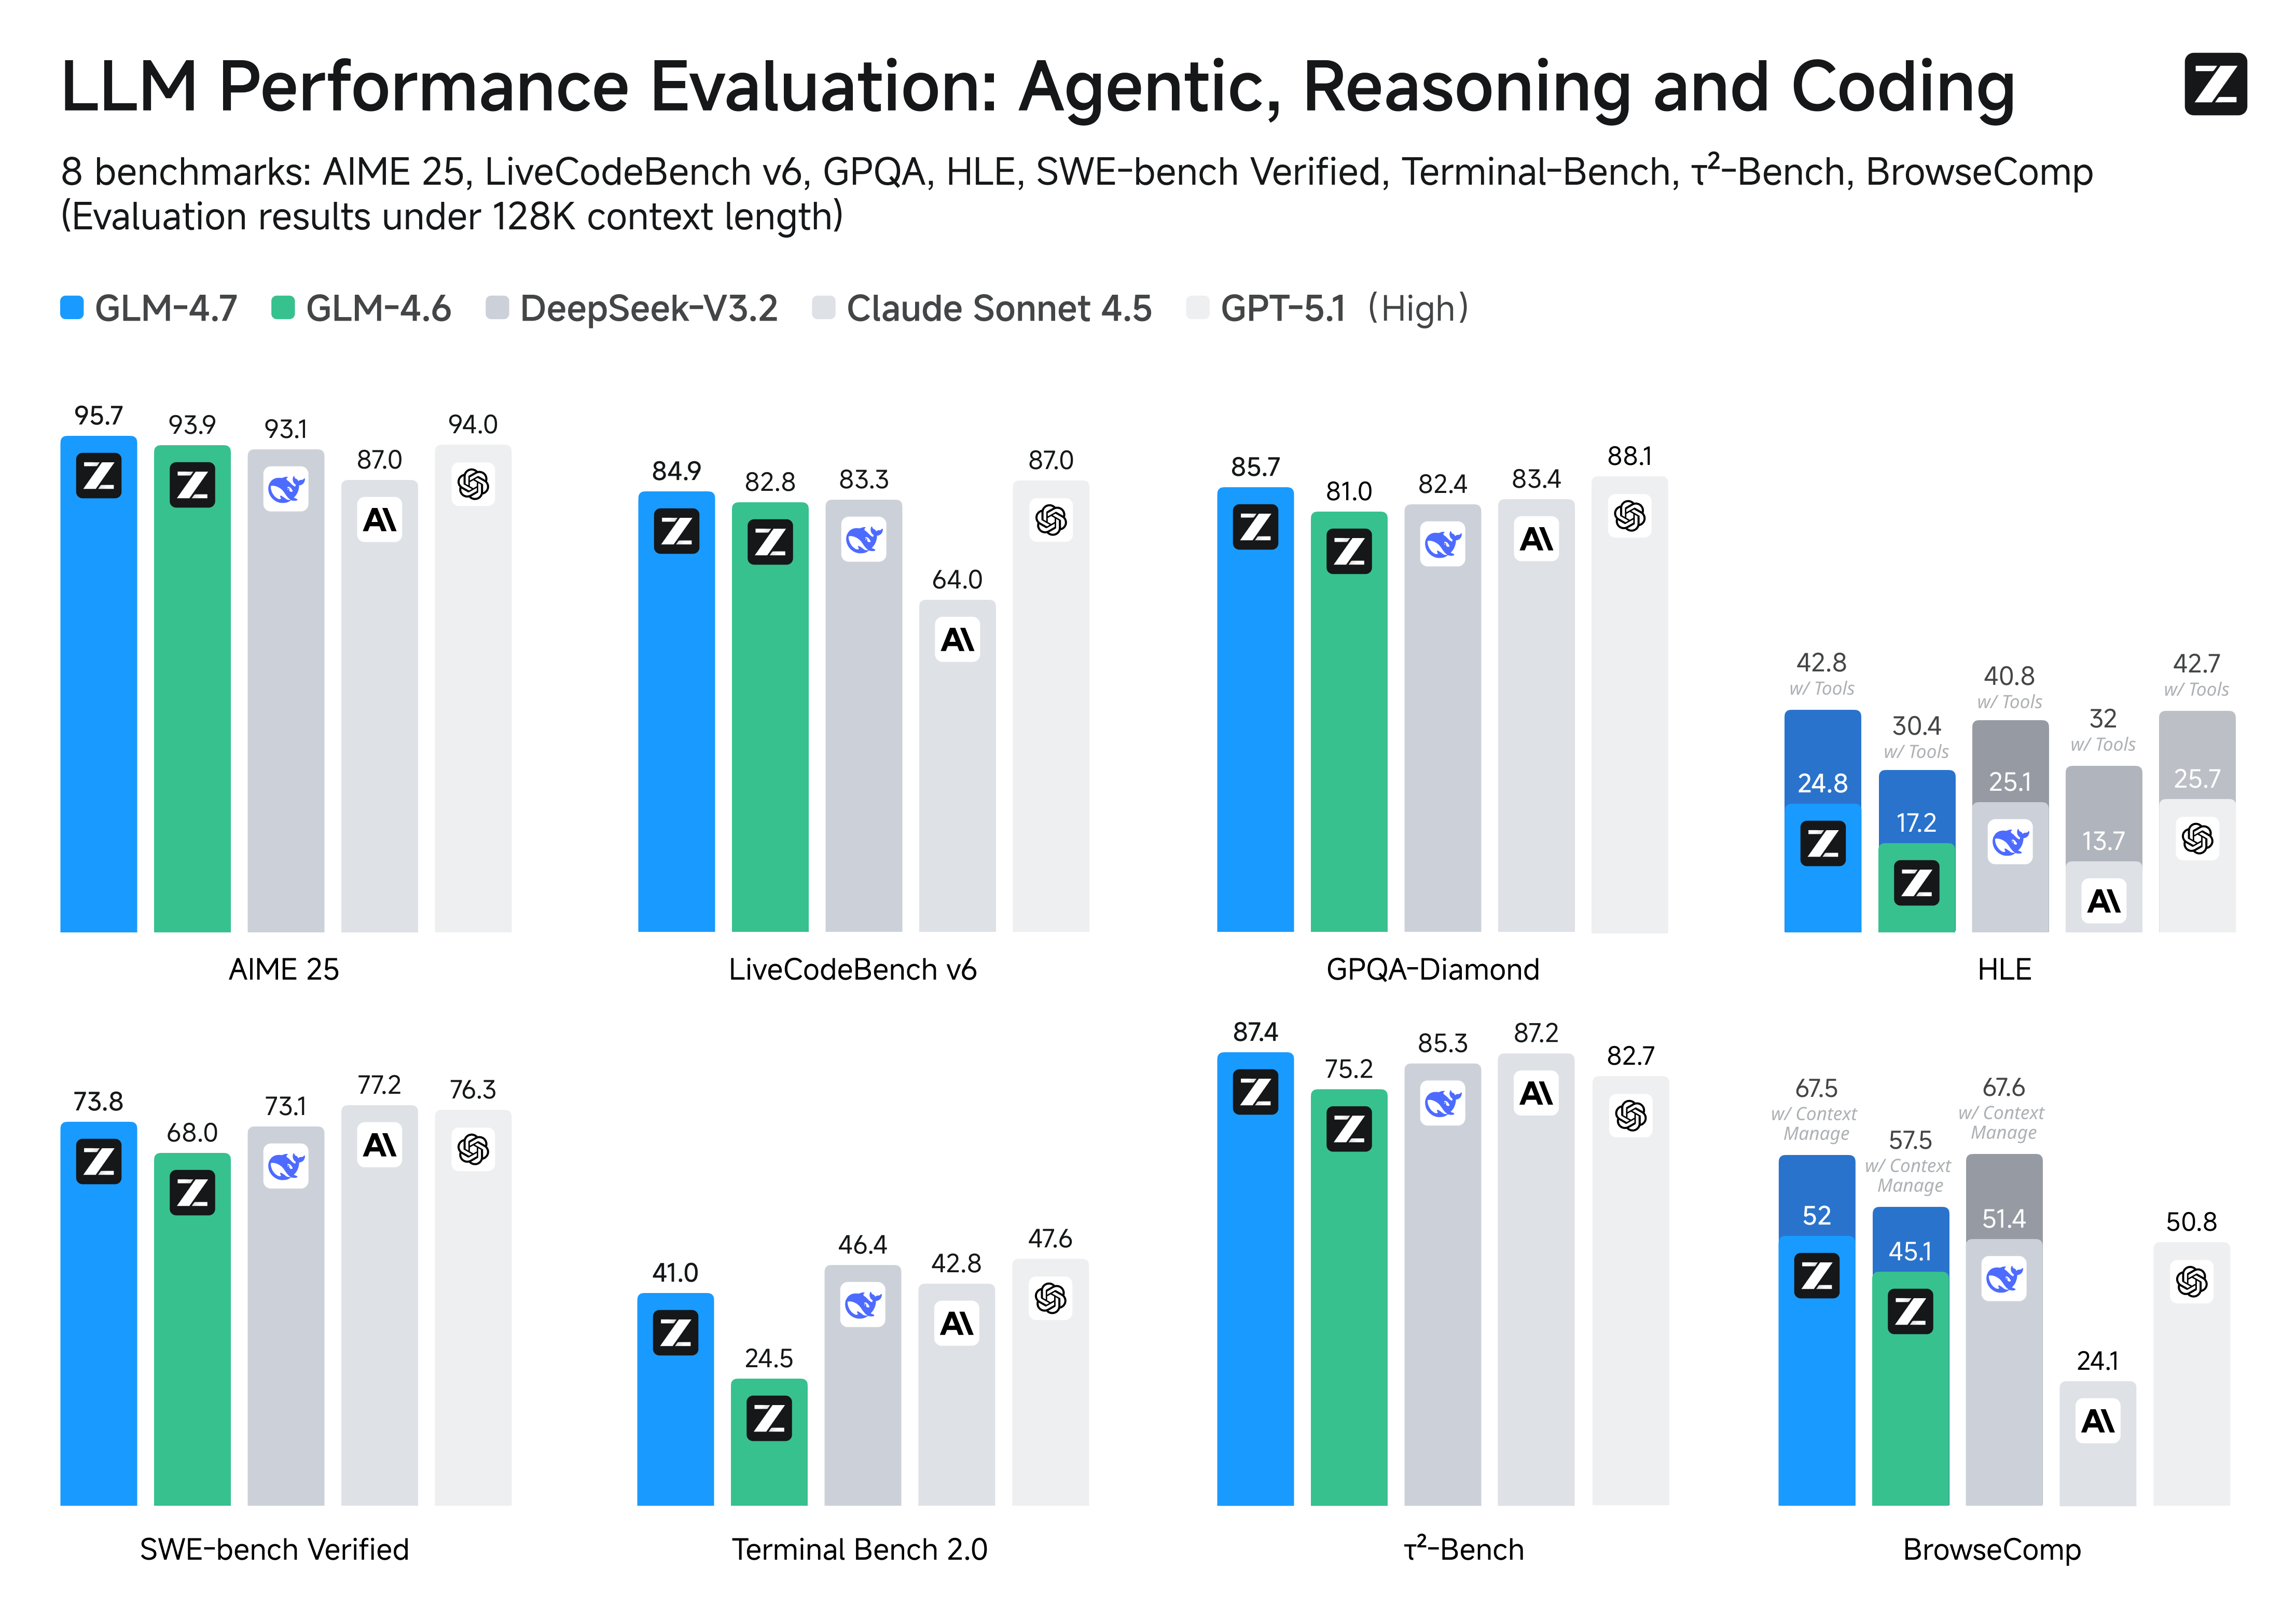
- البرمجة الأساسية: يُحقق GLM-4.7 مكاسب واضحة، مقارنةً بسلفه GLM-4.6، في البرمجة الوكيلية متعددة اللغات والمهام القائمة على الطرفية، حيث بلغ (73.8%، +5.8%) على SWE-bench، و(66.7%، +12.9%) على SWE-bench Multilingual، و(41%، +16.5%) على Terminal Bench 2.0. كما يدعم GLM-4.7 التفكير قبل الإجراء، مع تحسينات كبيرة في المهام المعقدة ضمن أطر الوكلاء الرئيسية مثل Claude Code وKilo Code وCline وRoo Code.
- البرمجة بالإحساس: يخطو GLM-4.7 خطوة كبيرة إلى الأمام في تحسين جودة واجهات المستخدم. فهو ينتج صفحات ويب أنظح وأكثر حداثة، ويولّد شرائح تبدو أفضل مع تخطيط وحجم أكثر دقة.
- استخدام الأدوات: حقّق نموذج GLM-4.7 تحسينات ملحوظة في استخدام الأدوات. ويمكن ملاحظة أداء أفضل بشكل كبير في اختبارات مثل τ^2-Bench وفي التصفح عبر BrowseComp.
- الاستدلال المعقّد: يقدّم GLM-4.7 دفعة كبيرة في القدرات الرياضية والاستدلالية، محققًا (42.8%، +12.4%) على معيار HLE (الاختبار الأخير للبشرية) مقارنةً بـ GLM-4.6.
بشكلٍ أعمّ، من المتوقع أيضاً ملاحظة تحسينات كبيرة في العديد من السيناريوهات الأخرى مثل الدردشة، والكتابة الإبداعية، وسيناريوهات لعب الأدوار.
التفكير المتناوب والحفاظ على التفكير
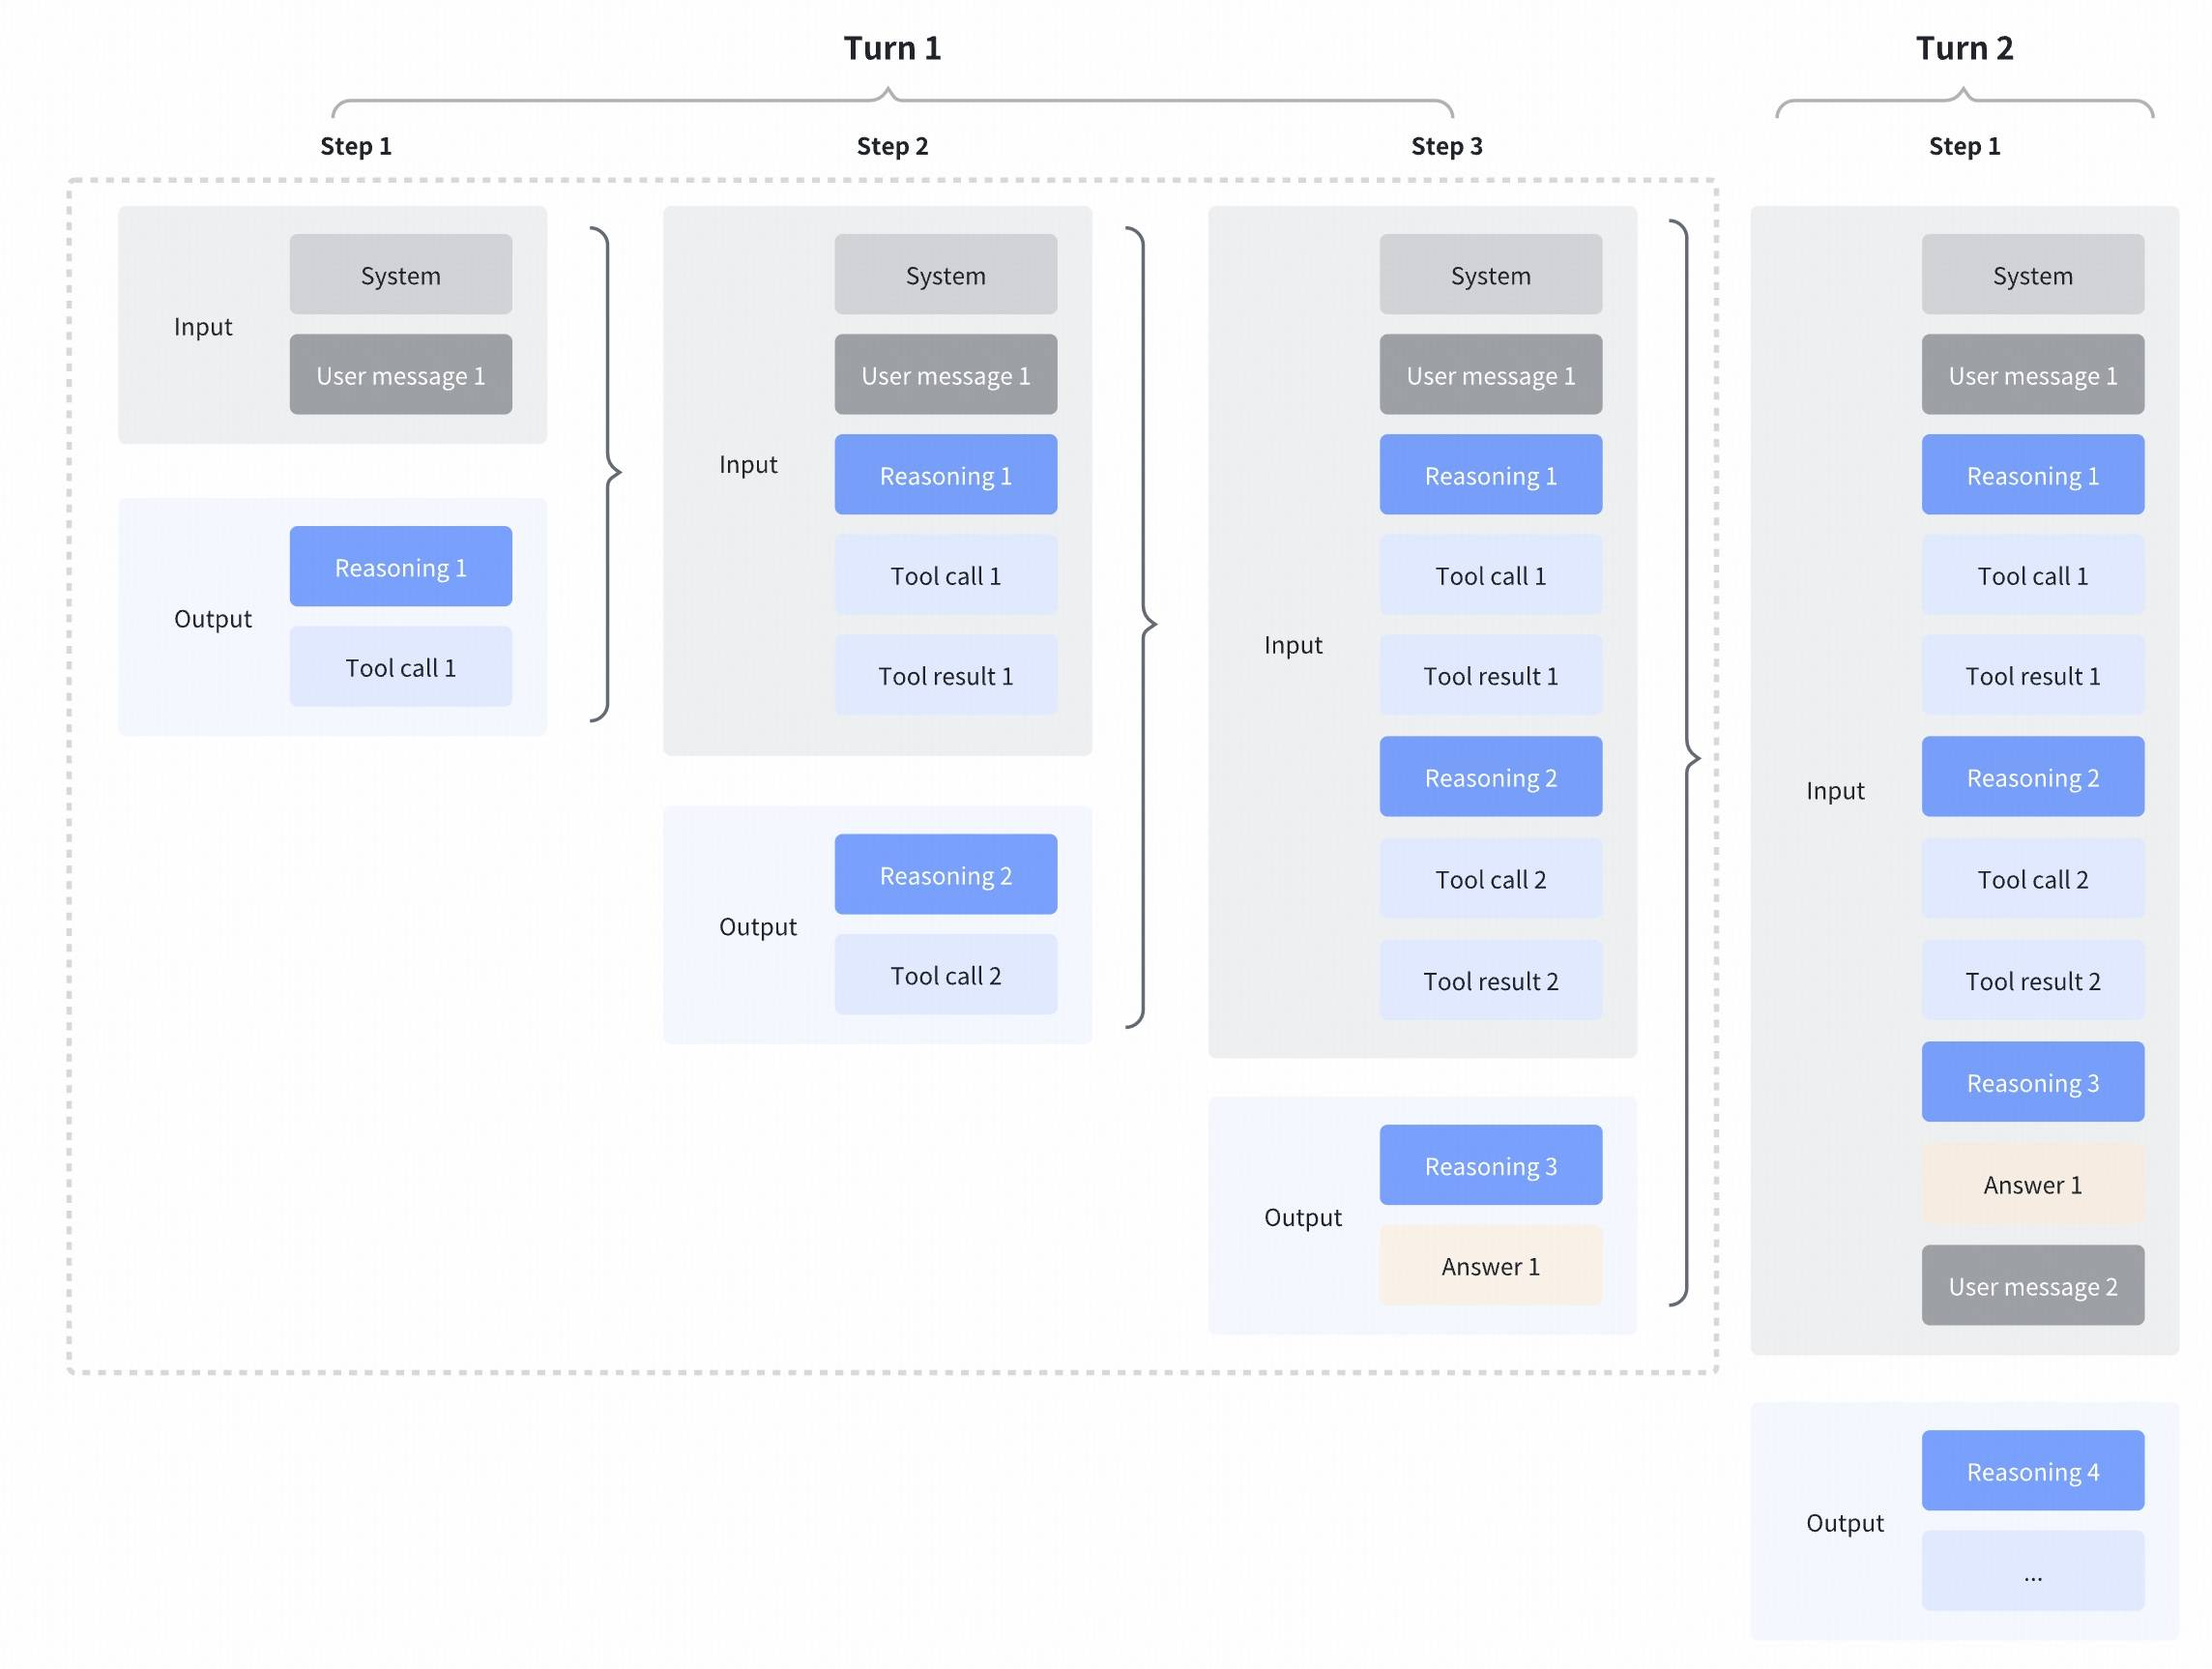
يعزّز GLM-4.7 بشكل أكبر ميزة التفكير المتناوب (المُقدَّمة منذ GLM-4.5)، ويقدّم التفكير المحفوظ والتفكير على مستوى الجولة. ومن خلال التفكير بين الإجراءات والحفاظ على الاتساق عبر الجولات، يجعل المهام المعقّدة أكثر استقراراً وقابلية للتحكم:
- التفكير المتناوب: يفكر النموذج قبل كل رد واستدعاء للأدوات، مما يحسّن من اتباع التعليمات وجودة التوليد.
- التفكير المحفوظ: في سيناريوهات وكلاء البرمجة، يحتفظ النموذج تلقائيًا بجميع كتل التفكير عبر المحادثات متعددة الأدوار، ويعيد استخدام الاستدلال الموجود بدلاً من إعادة الاشتقاق من الصفر. يقلل هذا من فقدان المعلومات وعدم الاتساق، وهو مناسب بشكل جيد للمهام المعقدة طويلة المدى.
- التفكير على مستوى الجولة: يدعم النموذج التحكم في الاستدلال لكل جولة ضمن الجلسة — يمكنك تعطيل التفكير للطلبات الخفيفة لتقليل زمن الاستجابة والتكلفة، وتفعيله للمهام المعقدة لتحسين الدقة والاستقرار.
المزيد من التفاصيل: https://docs.z.ai/guides/capabilities/thinking-mode
لمزيد من نتائج التقييم، والأمثلة التطبيقية، والتفاصيل التقنية، يرجى زيارة المدونة التقنية لـ GLM-4.7.
GLM-4.6
مقارنةً بـ GLM-4.5، يجلب GLM-4.6 عدة تحسينات رئيسية:
- نافذة سياق أطول: تم توسيع نافذة السياق من 128 ألف رمز إلى 200 ألف رمز، مما يتيح للنموذج التعامل مع مهام وظيفية أكثر تعقيدًا.
- أداء برمجي متفوق: يحقق النموذج درجات أعلى في اختبارات البرمجة المعيارية، ويظهر أداءً أفضل في التطبيقات الواقعية مثل Claude Code وCline وRoo Code وKilo Code، بما في ذلك تحسينات في توليد صفحات الواجهة الأمامية ذات المظهر البصري المتقن.
- الاستدلال المتقدم: يُظهر نموذج GLM-4.6 تحسناً واضحاً في أداء الاستدلال، ويدعم استخدام الأدوات أثناء الاستدلال، مما يؤدي إلى تعزيز القدرات الإجمالية.
- وكلاء أكثر كفاءة: يُظهر نموذج GLM-4.6 أداءً أقوى في الوكلاء الذين يستخدمون الأدوات والوكلاء المعتمدين على البحث، كما يتكامل بشكل أكثر فعالية داخل أطر عمل الوكلاء.
- كتابة مُصقّلة: تتوافق بشكل أفضل مع تفضيلات البشر من حيث الأسلوب وسهولة القراءة، وتعمل بشكل أكثر طبيعية في سيناريوهات لعب الأدوار.
قمنا بتقييم GLM-4.6 عبر ثمانية معايير عامة تغطي الوكلاء والاستدلال والبرمجة. تُظهر النتائج مكاسب واضحة مقارنةً بـ GLM-4.5، كما يحافظ GLM-4.6 على مزايا تنافسية مقارنةً بنماذج محلية ودولية رائدة مثل DeepSeek-V3.1-Terminus وClaude Sonnet 4.
لمزيد من نتائج التقييم، والأمثلة التطبيقية، والتفاصيل التقنية، يرجى زيارة المدونة التقنية لـ GLM-4.6.
GLM-4.5
نماذج سلسلة GLM-4.5 هي نماذج أساسية مصممة للوكلاء الأذكياء، وتُوثَّق متغيرات MoE هنا باسم Glm4Moe.
يحتوي GLM-4.5 على 355 مليار معامل إجمالي، منها 32 مليار معامل نشط، بينما يتبنى GLM-4.5-Air تصميمًا أكثر إحكامًا يضم 106 مليار معامل إجمالي و12 مليار معامل نشط. توحّد نماذج GLM-4.5 قدرات الاستدلال والبرمجة والوكلاء الذكيين لتلبية المتطلبات المعقدة لتطبيقات الوكلاء الذكيين.
يُعدّ كلٌّ من GLM-4.5 وGLM-4.5-Air نموذجين هجينين للاستدلال، ويوفّران وضعين: وضع التفكير للاستدلال المعقّد واستخدام الأدوات، ووضع عدم التفكير للاستجابات الفورية.
لقد قمنا بنشر النماذج الأساسية، ونماذج الاستدلال الهجينة، وإصدارات FP8 من نماذج الاستدلال الهجينة، لكلٍّ من GLM-4.5 وGLM-4.5-Air. وهي متاحة بموجب ترخيص MIT مفتوح المصدر، ويمكن استخدامها تجارياً ولأغراض التطوير الثانوي.
كما هو مبيّن في تقييمنا الشامل عبر 12 معياراً قياسياً معتمداً في الصناعة، يحقق نموذج GLM-4.5 أداءً استثنائياً بحصوله على درجة 63.2، ليحتل المركز الثالث بين جميع النماذج الخاصة والمفتوحة المصدر. ومن الجدير بالذكر أن نموذج GLM-4.5-Air يقدم نتائج تنافسية بدرجة 59.8 مع الحفاظ على كفاءة أعلى.
لمزيد من نتائج التقييم، والأمثلة التطبيقية، والتفاصيل التقنية، يرجى زيارة التقرير التقني أو المدونة التقنية.
يمكن العثور على كود النموذج ومحلل الأدوات ومحلل الاستدلال في تنفيذ transformers وvLLM وSGLang.
Glm4MoeConfig
فئة transformers.Glm4MoeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 151552hidden_size: int = 4096intermediate_size: int = 10944num_hidden_layers: int = 46num_attention_heads: int = 96num_key_value_heads: int = 8hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truetie_word_embeddings: bool = Falserope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0moe_intermediate_size: int = 1408num_experts_per_tok: int = 8output_router_logits: bool = Falsen_shared_experts: int = 1n_routed_experts: int = 128routed_scaling_factor: float = 1.0n_group: int = 1topk_group: int = 1first_k_dense_replace: int = 1norm_topk_prob: bool = Trueuse_qk_norm: bool = Falsebos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepad_token_id: int | None = Nonenum_mtp_layers: int = 1 )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية151552) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية4096) — أبعاد التمثيلات المخفية. - intermediate_size (
int، اختياري، القيمة الافتراضية10944) — أبعاد تمثيلات MLP. - num_hidden_layers (
int، اختياري، القيمة الافتراضية46) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية96) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - num_key_value_heads (
int، اختياري، القيمة الافتراضية8) — هذا هو عدد رؤوس key_value التي يجب استخدامها لتنفيذ Grouped Query Attention. إذا كانnum_key_value_heads=num_attention_heads، فسيستخدم النموذج Multi Head Attention (MHA)، وإذا كانnum_key_value_heads=1فسيستخدم النموذج Multi Query Attention (MQA)، وإلا فسيتم استخدام GQA. عند تحويل نقطة تفتيش متعددة الرؤوس إلى نقطة تفتيش GQA، يجب بناء كل مجموعة من رؤوس key و value عن طريق تجميع المتوسط لجميع الرؤوس الأصلية داخل تلك المجموعة. لمزيد من التفاصيل، راجع هذا الورقة. إذا لم يتم تحديد القيمة، فستكون القيمة الافتراضية هيnum_attention_heads. - hidden_act (
str، اختياري، القيمة الافتراضيةsilu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - max_position_embeddings (
int، اختياري، القيمة الافتراضية131072) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج على الإطلاق. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - rms_norm_eps (
float، اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع rms. - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم ربط ترميزات الأوزان وفقاً لخريطةtied_weights_keysالخاصة بالنموذج. - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], اختياري) — قائمة تحتوي على معاملات التهيئة الخاصة بتضمينات RoPE. يجب أن تحتوي القائمة على قيمة لـrope_theta، ومعاملات اختيارية تُستخدم للتوسيع في حال رغبتَ في استخدام RoPE معmax_position_embeddingsأطول. - attention_bias (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام انحياز في طبقات الإسقاط للاستعلام والمفتاح والقيمة والمخرجات أثناء الانتباه الذاتي. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - moe_intermediate_size (
int، اختياري، القيمة الافتراضية1408) — الحجم الوسيط لشبكات MLP الخاصة بالخبراء الموجَّهين. - num_experts_per_tok (
int، اختياري، القيمة الافتراضية8) — عدد الخبراء الذين يُوجَّه إليهم كل رمز. هذه هي قيمة top-k الخاصة بتوجيه اختيار الرموز. - output_router_logits (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب على النموذج إرجاع قيم اللوجيتس الخاصة بالموجِّه (router). تمكين هذا الخيار سيتيح أيضًا للنموذج إخراج الخسارة المساعدة، بما في ذلك خسارة موازنة الحمل وخسارة z الخاصة بالموجِّه. - n_shared_experts (
int، اختياري، القيمة الافتراضية1) — عدد الخبراء المشتركين. - n_routed_experts (
int، اختياري، القيمة الافتراضية128) — عدد الخبراء الموجَّهين. - routed_scaling_factor (
float، اختياري، القيمة الافتراضية1.0) — معامل التوسعة للخبراء الموجَّهين. - n_group (
int، اختياري، القيمة الافتراضية 1) — عدد المجموعات للخبراء الموجَّهين. - topk_group (
int، اختياري، القيمة الافتراضية1) — عدد المجموعات المختارة لكل رمز (لكل رمز، مع ضمان أن الخبراء المختارين يكونون ضمنtopk_groupمجموعات فقط). - first_k_dense_replace (
int، اختياري، القيمة الافتراضية 1) — عدد طبقات الكثافة في الطبقات الضحلة (embed->dense->dense->…->dense->moe->moe…->lm_head). --k طبقات كثافة—/ - norm_topk_prob (
bool، اختياري، القيمة الافتراضيةTrue) — هل يتم تطبيع أوزان الخبراء الموجَّهين. - use_qk_norm (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام تطبيع الاستعلام-المفتاح في الانتباه. - bos_token_id (
int, اختياري) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]], اختياري) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - pad_token_id (
int, اختياري) — معرّف الرمز المستخدم للتعبئة في المفردات. - num_mtp_layers (
int, اختياري، القيمة الافتراضية 1) — عدد وحدات التنبؤ متعدد الرموز (MTP) المتاحة للإضافة بعد نموذج التحويلي الأساسي. عند تعيين0، يتصرف النموذج كمفكك قياسي. عند تعيين>0، يمكن لكل وحدة إضافية التنبؤ برمز مستقبلي إضافي واحد في وقت الاستدلال (فك تشفير استباقي عبرgenerate(..., use_mtp=True)).
هذه فئة الإعدادات المخزنة لإعدادات نموذج Glm4MoeModel. تُستخدم لاستحداث نموذج Glm4 Moe وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ zai-org/GLM-4.5
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import Glm4MoeModel, Glm4MoeConfig

>>> # Initializing a Glm4Moe style configuration
>>> configuration = Glm4MoeConfig()

>>> # Initializing a model from the GLM-4-MOE-100B-A10B style configuration
>>> model = Glm4MoeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Glm4MoeModel
فئة transformers.Glm4MoeModel
< source >( config: Glm4MoeConfig )
المعاملات
- config (Glm4MoeConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Glm4 Moe الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values).
يعيد
MoeModelOutputWithPast أو tuple(torch.Tensor)
MoeModelOutputWithPast أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Glm4MoeConfig) والمدخلات.
تتجاوز طريقة Glm4MoeModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
router_logits (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_router_probs=Trueوconfig.add_router_probs=Trueأو عندconfig.output_router_probs=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, sequence_length, num_experts).قيمات logits الخام (بعد تطبيق دالة softmax) التي يحسبها موجّهو MoE، وتُستخدم هذه القيم لحساب الخسارة المساعدة في نماذج مزيج الخبراء.
Glm4MoeForCausalLM
فئة transformers.Glm4MoeForCausalLM
< source >( config: Glm4MoeConfig )
المعاملات
- config (Glm4MoeConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Glm4 Moe لنمذجة اللغة السببية.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - logits_to_keep (
Union[int, torch.Tensor]، اختياري، القيمة الافتراضية0) — إذا كانint، يتم حساب logits لآخرlogits_to_keepرموز. إذا كانت القيمة0، يتم حساب logits لجميعinput_ids(حالة خاصة). لا يُحتاج إلى logits إلا للرمز الأخير في عملية التوليد، ويمكن أن يوفر حسابها لذلك الرمز وحده ذاكرة كبيرة، وهو أمر مهم بشكل ملحوظ للتسلسلات الطويلة أو حجم المفردات الكبير. إذا كانtorch.Tensor، يجب أن يكون بعدًا واحدًا (1D) ويتوافق مع الفهارس التي يجب الاحتفاظ بها في بُعد طول التسلسل. يكون هذا مفيدًا عند استخدام تنسيق المصفوفات المعبأة (packed tensor format) (بعد واحد لكل من الدفعة وطول التسلسل).
يعيد
MoeCausalLMOutputWithPast أو tuple(torch.Tensor)
MoeCausalLMOutputWithPast أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (Glm4MoeConfig) والمدخلات.
تتجاوز طريقة Glm4MoeForCausalLM الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).aux_loss (
torch.Tensor، اختياري، يُعاد عند تمريرoutput_router_logits=Trueأو عندconfig.output_router_logits=True، ويتدرب النموذج على مساره باستخدام خسارة توازن الأحمال) — خسارة مساعدة لتوازن الأحمال للوحدات المتناثرة. النماذج التي توازن خبرائها باستخدام انحياز المسار بدلاً من ذلك (DeepSeek-V3 والهندسات المشتقة منه) تعيدNoneهنا مع الاستمرار في إعادةrouter_logits.router_logits (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_router_logits=Trueأو عند تعيينconfig.output_router_logits=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة متناثرة) ذات الشكل(batch_size * sequence_length, num_experts).قيمات التوجيه الخام (logits) التي تحسبها وحدات التوجيه في نماذج MoE. يمكن استخدامها لحساب خسارة موازنة الحمل أو لفحص كيفية توزيع الرموز على الخبراء.
past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoTokenizer, Glm4MoeForCausalLM

>>> model = Glm4MoeForCausalLM.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."