
Transformers documentation
M2M100
نُشر هذا النموذج في أوراق HF في 21 أكتوبر 2020، وأُضيف إلى مكتبة Hugging Face Transformers في 6 مارس 2021.
M2M100


نظرة عامة
قُدِّم نموذج M2M100 في Beyond English-Centric Multilingual Machine Translation من قِبل Angela Fan وShruti Bhosale وHolger Schwenk وZhiyi Ma وAhmed El-Kishky وSiddharth Goyal وMandeep Baines وOnur Celebi وGuillaume Wenzek وVishrav Chaudhary وNaman Goyal وTom Birch وVitaliy Liptchinsky وSergey Edunov وEdouard Grave وMichael Auli وArmand Joulin.
المستخلص من الورقة البحثية هو كالتالي:
أظهرت الأعمال القائمة في مجال الترجمة إمكانات الترجمة الآلية متعددة اللغات على نطاق واسع من خلال تدريب نموذج واحد قادر على الترجمة بين أي زوج من اللغات. ومع ذلك، فإن جزءًا كبيرًا من هذا العمل يركّز على اللغة الإنجليزية من خلال التدريب فقط على بيانات تم ترجمتها من الإنجليزية أو إليها. وعلى الرغم من أن هذا النهج مدعوم بمصادر كبيرة من بيانات التدريب، إلا أنه لا يعكس احتياجات الترجمة حول العالم. في هذا العمل، أنشأنا نموذج ترجمة متعدد اللغات من متعدد إلى متعدد (Many-to-Many) حقيقيًا قادرًا على الترجمة مباشرة بين أي زوج من 100 لغة. قمنا ببناء مجموعة بيانات تدريبية مفتوحة المصدر تغطي آلاف اتجاهات اللغات ببيانات مُشرفة، تم إنشاؤها من خلال التنقيب على نطاق واسع. ثم استكشفنا كيفية زيادة سعة النموذج بفعالية من خلال الجمع بين التوسع الكثيف (dense scaling) والمعاملات المتناثرة (sparse parameters) المحددة لكل لغة، لإنشاء نماذج عالية الجودة. يركز عملنا على النماذج غير المركزة على اللغة الإنجليزية، مما يحقق مكاسب تتجاوز 10 نقاط BLEU عند الترجمة المباشرة بين اتجاهات غير إنجليزية، مع أداء تنافسي مقارنة بأفضل الأنظمة الفردية في WMT. نوفر سكربتاتنا كمصدر مفتوح حتى يتمكن الآخرون من إعادة إنتاج البيانات والتقييم ونموذج M2M-100 النهائي.
تمت مساهمة هذا النموذج من قِبل valhalla.
نصائح وأمثلة للاستخدام
M2M100 هو نموذج مُشفِّر-مُفكِّك (seq-to-seq) متعدد اللغات، يُستخدم بشكل أساسي لمهام الترجمة. وبما أن النموذج متعدد اللغات، فإنه يتوقع أن تكون التسلسلات بصيغة معينة: يتم استخدام رمز معرّف لغة خاص كبادئة في كل من النص المصدر والنص الهدف. صيغة النص المصدر هي [lang_code] X [eos]، حيث lang_code هو معرّف لغة المصدر للنص المصدر ومعرّف لغة الهدف للنص الهدف، بينما X هو النص المصدر أو النص الهدف.
يعتمد M2M100Tokenizer على sentencepiece لذا تأكد من تثبيته قبل تشغيل الأمثلة. لتثبيت sentencepiece شغّل pip install sentencepiece.
التدريب المُشرف
from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer


model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", device_map="auto")
tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M", src_lang="en", tgt_lang="fr")

src_text = "Life is like a box of chocolates."
tgt_text = "La vie est comme une boîte de chocolat."

model_inputs = tokenizer(src_text, text_target=tgt_text, return_tensors="pt").to(model.device)

loss = model(**model_inputs).loss  # forward pass
التوليد
M2M100 uses the eos_token_id as the decoder_start_token_id for generation with the target language id
being forced as the first generated token. To force the target language id as the first generated token, pass the forced_bos_token_id parameter to the generate method. The following example shows how to translate between
Hindi to French and Chinese to English using the facebook/m2m100_418M checkpoint.
from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer


hi_text = "जीवन एक चॉकलेट बॉक्स की तरह है।"
chinese_text = "生活就像一盒巧克力。"

model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", device_map="auto")
tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M")

# translate Hindi to French
tokenizer.src_lang = "hi"
encoded_hi = tokenizer(hi_text, return_tensors="pt").to(model.device)
generated_tokens = model.generate(**encoded_hi, forced_bos_token_id=tokenizer.get_lang_id("fr"))
tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)
"La vie est comme une boîte de chocolat."

# translate Chinese to English
tokenizer.src_lang = "zh"
encoded_zh = tokenizer(chinese_text, return_tensors="pt").to(model.device)
generated_tokens = model.generate(**encoded_zh, forced_bos_token_id=tokenizer.get_lang_id("en"))
tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)
"Life is like a box of chocolate."
الموارد
M2M100Config
فئة transformers.M2M100Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truevocab_size: int = 128112max_position_embeddings: int = 1024encoder_layers: int = 12encoder_ffn_dim: int = 4096encoder_attention_heads: int = 16decoder_layers: int = 12decoder_ffn_dim: int = 4096decoder_attention_heads: int = 16encoder_layerdrop: float | int = 0.05decoder_layerdrop: float | int = 0.05use_cache: bool = Trueactivation_function: str = 'relu'd_model: int = 1024dropout: float | int = 0.1attention_dropout: float | int = 0.1activation_dropout: float | int = 0.0init_std: float = 0.02decoder_start_token_id: int | None = 2scale_embedding: bool = Truepad_token_id: int | None = 1bos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2tie_word_embeddings: bool = True )
المعاملات
- is_encoder_decoder (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا. - vocab_size (
int، اختياري، القيمة الافتراضية128112) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - max_position_embeddings (
int، اختياري، القيمة الافتراضية1024) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج على الإطلاق. - encoder_layers (
int, اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُشفِّر Transformer. سيستخدم نفس قيمةnum_layersإذا لم يتم ضبطه. - encoder_ffn_dim (
int، اختياري، القيمة الافتراضية4096) — أبعاد طبقة "الوسط" (التي تُسمّى غالباً بطبقة التغذية الأمامية) في المُشفِّر. - encoder_attention_heads (
int, اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُشفِّر Transformer. - decoder_layers (
int, اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمةnum_layersإذا لم يتم تعيينه. - decoder_ffn_dim (
int, اختياري، القيمة الافتراضية4096) — أبعاد طبقة "الوسط" (التي تُسمّى غالباً بطبقة التغذية الأمامية) في المُفكِّك. - decoder_attention_heads (
int، اختياري، القيمة الافتراضية16) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - encoder_layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.05) — احتمال LayerDrop للمُشفِّر. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - decoder_layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.05) — احتمال LayerDrop الخاص بفك الترميز. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط. - activation_function (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - d_model (
int، اختياري، القيمة الافتراضية1024) — حجم طبقات المُشفِّر وطبقة المُجمِّع. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — النسبة لجميع طبقات dropout. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة الإسقاط (dropout) لاحتمالات الانتباه. - activation_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة dropout للتفعيلات داخل الطبقة المتصلة بالكامل. - init_std (
float، اختياري، القيمة الافتراضية0.02) — انحراف معياري لمُهيّئ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - decoder_start_token_id (
int, اختياري، القيمة الافتراضية2) — إذا بدأ نموذج المُشفِّر-المُفكِّك عملية فك التشفير برمز مختلف عنbos، فإن هذا هو المعرّف الخاص بذلك الرمز. - scale_embedding (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم توسيع التضمينات (embeddings) من خلال القسمة على sqrt(d_model). - pad_token_id (
int، اختياري، القيمة الافتراضية1) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int, اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]]، اختياري، القيمة الافتراضية2) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج M2M100Model. تُستخدم لتوليد نموذج M2M 100 وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ facebook/m2m100_418M
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import M2M100Config, M2M100Model

>>> # Initializing a M2M100 facebook/m2m100_418M style configuration
>>> configuration = M2M100Config()

>>> # Initializing a model (with random weights) from the facebook/m2m100_418M style configuration
>>> model = M2M100Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
M2M100Tokenizer
فئة transformers.M2M100Tokenizer
< source >( vocab_filespm_filesrc_lang = Nonetgt_lang = Nonebos_token = '<s>'eos_token = '</s>'sep_token = '</s>'pad_token = '<pad>'unk_token = '<unk>'language_codes = 'm2m100'sp_model_kwargs: dict[str, typing.Any] | None = Nonenum_madeup_words = 8**kwargs )
المعاملات
- vocab_file (
str) — مسار ملف المفردات. - spm_file (
str) — مسار ملف SentencePiece (عادةً ما يكون امتداده .spm) الذي يحتوي على المفردات. - src_lang (
str، اختياري) — نص يمثل اللغة المصدر. - tgt_lang (
str، اختياري) — نص يمثل اللغة المستهدفة. - eos_token (
str، اختياري، القيمة الافتراضية"</s>") — رمز نهاية التسلسل. - sep_token (
str، اختياري، القيمة الافتراضية"</s>") — رمز الفاصل، الذي يُستخدم عند بناء تسلسل من عدة تسلسلات، على سبيل المثال تسلسلان لتصنيف التسلسل أو نص وسؤال للإجابة على الأسئلة. كما يُستخدم كآخر رمز في تسلسل مبني باستخدام الرموز الخاصة. - unk_token (
str، اختياري، القيمة الافتراضية"<unk>") — رمز المجهول. لا يمكن تحويل الرمز غير الموجود في المفردات إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه. - pad_token (
str، اختياري، القيمة الافتراضية"<pad>") — الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة. - language_codes (
str، اختياري، القيمة الافتراضية"m2m100") — رموز اللغات المستخدمة. يجب أن تكون إما"m2m100"أو"wmt21". - sp_model_kwargs (
dict, اختياري) — سيتم تمريره إلىSentencePieceProcessor.__init__()طريقة. يمكن استخدام الغلاف البرمجي بلغة بايثون لـ SentencePiece لأغراض أخرى، بما في ذلك ضبط:-
enable_sampling: تفعيل تنعيم الوحدات الفرعية. -
nbest_size: معلمات العينة أحادية الكلمة. غير صالحة لـ BPE-Dropout.nbest_size = {0,1}: لا يتم إجراء أي أخذ عينات.nbest_size > 1: يُجري أخذ عينات من نتائج nbest_size.nbest_size < 0: يُفترض أن nbest_size لا نهائية، ويتم أخذ العينات من جميع الفرضيات (الشبكة) باستخدام خوارزمية التصفية الأمامية والعينة الخلفية.
-
alpha: معامل التنعيم لعينة الأحادية، واحتمال إسقاط عمليات الدمج في BPE-dropout.
-
أنشئ مُرمِّز M2M100. مبني على SentencePiece.
يرث هذا المُجزِّئ من PreTrainedTokenizer الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
أمثلة:
>>> from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer

>>> model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M")
>>> tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M", src_lang="en", tgt_lang="ro")
>>> src_text = " UN Chief Says There Is No Military Solution in Syria"
>>> tgt_text = "Şeful ONU declară că nu există o soluţie militară în Siria"
>>> model_inputs = tokenizer(src_text, text_target=tgt_text, return_tensors="pt")
>>> outputs = model(**model_inputs)  # should work
build_inputs_with_special_tokens
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
المعاملات
- token_ids_0 (
list[int]) — قائمة بالمعرّفات التي ستُضاف إليها الرموز الخاصة. - token_ids_1 (
list[int]، اختياري) — قائمة اختيارية ثانية من المعرّفات لأزواج التسلسلات.
يعيد
list[int]
قائمة معرفات الإدخال مع الرموز الخاصة المناسبة.
أنشئ مدخلات النموذج من تسلسل أو زوج من التسلسلات لمهام تصنيف التسلسل عن طريق الربط وإضافة الرموز الخاصة. يتبع تسلسل MBART التنسيق التالي، حيث يمثل X التسلسل:
input_ids(للمُشفِّر)X [eos, src_lang_code]decoder_input_ids: (للمفكّك)X [eos, tgt_lang_code]
لا يُستخدم BOS أبداً. أزواج التسلسلات ليست حالة الاستخدام المتوقعة، لكنها ستُعالج دون فاصل.
get_special_tokens_mask
< source >( token_ids_0: listtoken_ids_1: list[int] | None = Nonealready_has_special_tokens: bool = False ) → list[int]
المعاملات
- token_ids_0 (
list[int]) — قائمة من المعرّفات. - token_ids_1 (
list[int]، اختياري) — قائمة اختيارية ثانية من المعرّفات لأزواج التسلسلات. - already_has_special_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كانت قائمة الرموز (tokens) منسّقة مسبقًا برموز خاصة للنموذج أم لا.
يعيد
list[int]
قائمة من الأعداد الصحيحة في المدى [0, 1]: 1 للرمز الخاص، و0 لرمز التسلسل.
استرجاع معرّفات التسلسل من قائمة الرموز التي لم تُضف إليها رموز خاصة. يُستدعى هذا الأسلوب عند إضافة الرموز الخاصة باستخدام أسلوب prepare_for_model في مُجزّئ النص.
create_token_type_ids_from_sequences
< source >( token_ids_0: listtoken_ids_1: list[int] | None = None ) → list[int]
أنشئ قناعًا من التسلسلين المُمرَّرين لاستخدامه في مهمة تصنيف أزواج التسلسلات.
تُبنى معرّفات أنواع الرموز ديناميكيًا بواسطة هذه الطريقة بناءً على سمات إعدادات مُجزّئ الرموز:
token_type_ids_pattern: النمط المستخدم (“all_zeros” أو “bert_style”)token_type_ids_include_special_tokens: ما إذا كان يجب أخذ الرموز الخاصة في الاعتبار عند حساب الطول
أمثلة:
# All zeros pattern (default, used by RoBERTa, BART, etc.)
tokenizer.token_type_ids_pattern = "all_zeros"
# Returns: [0, 0, 0, ...] for both sequences

# BERT-style pattern (first sequence gets 0s, second gets 1s)
tokenizer.token_type_ids_pattern = "bert_style"
# Returns: [0, 0, 0, ..., 1, 1, 1, ...] for sequence pairsM2M100Model
فئة transformers.M2M100Model
< source >( config: M2M100Config )
المعاملات
- config (M2M100Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج M2M 100 الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneencoder_outputs: tuple[tuple[torch.Tensor]] | None = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات مدخلات المُفكِّك؟ يستخدم M2M100 رمز eos_token_id كرمز بدء لتوليد decoder_input_ids. إذا تم استخدام past_key_values، فيجب إدخال آخر decoder_input_ids فقط بشكل اختياري (راجع past_key_values).يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
ما هي معرّفات مدخلات المُفكِّك؟
يستخدم
eos_token_idفي M2M100 كرمز البداية لتوليدdecoder_input_ids. إذا تم استخدامpast_key_values، فبشكل اختياري لا يتعين إدخال سوى آخرdecoder_input_ids(انظرpast_key_values). - decoder_attention_mask (
torch.LongTensorمن الشكل(batch_size, target_sequence_length)، اختياري) — السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو فيdecoder_input_ids. كما سيتم استخدام قناع سببي (Causal mask) افتراضيًا. - encoder_outputs (
tuple[tuple[torch.Tensor]]، اختياري) — مجموعة (توبل) تتكون من (last_hidden_state، اختياري:hidden_states، اختياري:attentions)last_hidden_stateذو الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من حالات المخفية (hidden-states) عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) داخل المُفكِّك (decoder). - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - decoder_inputs_embeds (
torch.Tensorمن الشكل(batch_size, target_sequence_length, hidden_size), اختياري) — اختياريًا، بدلاً من تمريرdecoder_input_idsيمكنك اختيار تمرير تمثيل مضمّن مباشرة. إذاpast_key_valuesمستخدم، فاختياريًا يكفي إدخال آخرdecoder_inputs_embedsفقط (انظرpast_key_values). هذا مفيد إذا كنت تريد مزيدًا من التحكم في كيفية تحويلdecoder_input_idsفهارس إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج.إذا لم يتم تعيين كلٍّ من
decoder_input_idsوdecoder_inputs_embeds، فإنdecoder_inputs_embedsيأخذ قيمةinputs_embeds. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values).
يعيد
Seq2SeqModelOutput أو tuple(torch.Tensor)
Seq2SeqModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (M2M100Config) والمدخلات.
تتجاوز طريقة M2M100Model الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من فاحم النموذج.إذا تم استخدام
past_key_values، فإن الحالة المخفية الأخيرة فقط من التسلسلات ذات الشكل(batch_size, 1, hidden_size)هي التي تُخرج.past_key_values (
EncoderDecoderCache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع EncoderDecoderCache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden-states) للوحدة الترميزية (decoder) عند مخرج كل طبقة، بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
decoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
encoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
M2M100ForConditionalGeneration
فئة transformers.M2M100ForConditionalGeneration
< source >( config: M2M100Config )
المعاملات
- config (M2M100Config) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج M2M100 مع رأس نمذجة اللغة. يمكن استخدامه للتلخيص.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonedecoder_input_ids: typing.Optional[torch.LongTensor] = Nonedecoder_attention_mask: typing.Optional[torch.LongTensor] = Noneencoder_outputs: tuple[tuple[torch.Tensor]] | None = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Seq2SeqLMOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- decoder_input_ids (
torch.LongTensorبشكل(batch_size, target_sequence_length), اختياري) — مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات مدخلات المُفكِّك؟ يستخدم M2M100 رمز eos_token_id كرمز بدء لتوليد decoder_input_ids. إذا تم استخدام past_key_values، فيجب إدخال آخر decoder_input_ids فقط بشكل اختياري (راجع past_key_values).يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
ما هي معرّفات مدخلات المُفكِّك؟
يستخدم
eos_token_idفي M2M100 كرمز البداية لتوليدdecoder_input_ids. إذا تم استخدامpast_key_values، فبشكل اختياري لا يتعين إدخال سوى آخرdecoder_input_ids(انظرpast_key_values). - decoder_attention_mask (
torch.LongTensorمن الشكل(batch_size, target_sequence_length)، اختياري) — السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو فيdecoder_input_ids. كما سيتم استخدام قناع سببي (Causal mask) افتراضيًا. - encoder_outputs (
tuple[tuple[torch.Tensor]]، اختياري) — مجموعة (توبل) تتكون من (last_hidden_state، اختياري:hidden_states، اختياري:attentions)last_hidden_stateذو الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من حالات المخفية (hidden-states) عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) داخل المُفكِّك (decoder). - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - decoder_inputs_embeds (
torch.Tensorمن الشكل(batch_size, target_sequence_length, hidden_size), اختياري) — اختياريًا، بدلاً من تمريرdecoder_input_idsيمكنك اختيار تمرير تمثيل مضمّن مباشرة. إذاpast_key_valuesمستخدم، فاختياريًا يكفي إدخال آخرdecoder_inputs_embedsفقط (انظرpast_key_values). هذا مفيد إذا كنت تريد مزيدًا من التحكم في كيفية تحويلdecoder_input_idsفهارس إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج.إذا لم يتم تعيين كلٍّ من
decoder_input_idsوdecoder_inputs_embeds، فإنdecoder_inputs_embedsيأخذ قيمةinputs_embeds. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values).
يعيد
Seq2SeqLMOutput أو tuple(torch.Tensor)
Seq2SeqLMOutput أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (M2M100Config) والمدخلات.
تتجاوز طريقة M2M100ForConditionalGeneration الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة.logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).past_key_values (
EncoderDecoderCache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع EncoderDecoderCache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
decoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
encoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
ترجمة مثال:
>>> from transformers import AutoTokenizer, M2M100ForConditionalGeneration

>>> model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M")
>>> tokenizer = AutoTokenizer.from_pretrained("facebook/m2m100_418M")

>>> text_to_translate = "Life is like a box of chocolates"
>>> model_inputs = tokenizer(text_to_translate, return_tensors="pt")

>>> # translate to French
>>> gen_tokens = model.generate(**model_inputs, forced_bos_token_id=tokenizer.get_lang_id("fr"))
>>> print(tokenizer.batch_decode(gen_tokens, skip_special_tokens=True))
استخدام Flash Attention 2
Flash Attention 2 هي نسخة أسرع ومحسّنة من حساب درجات الانتباه، وتعتمد على نوى cuda.
التثبيت
أولاً، تحقق من توافق عتادك مع Flash Attention 2. يمكن العثور على أحدث قائمة بالعتاد المتوافق في التوثيق الرسمي.
بعد ذلك، ثبّت أحدث إصدار من Flash Attention 2:
pip install -U flash-attn --no-build-isolation
الاستخدام
لتحميل نموذج باستخدام Flash Attention 2، يمكننا تمرير الحجة attn_implementation="flash_attention_2" إلى from_pretrained(). يمكنك استخدام دقة torch.float16 أو torch.bfloat16.
from transformers import M2M100ForConditionalGeneration, M2M100Tokenizer


model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", attn_implementation="flash_attention_2", device_map="auto").eval()
tokenizer = M2M100Tokenizer.from_pretrained("facebook/m2m100_418M")

# translate Hindi to French
hi_text = "जीवन एक चॉकलेट बॉक्स की तरह है।"
tokenizer.src_lang = "hi"
encoded_hi = tokenizer(hi_text, return_tensors="pt").to(model.device)
generated_tokens = model.generate(**encoded_hi, forced_bos_token_id=tokenizer.get_lang_id("fr"))
tokenizer.batch_decode(generated_tokens, skip_special_tokens=True)
"La vie est comme une boîte de chocolat."
التسارعات المتوقعة
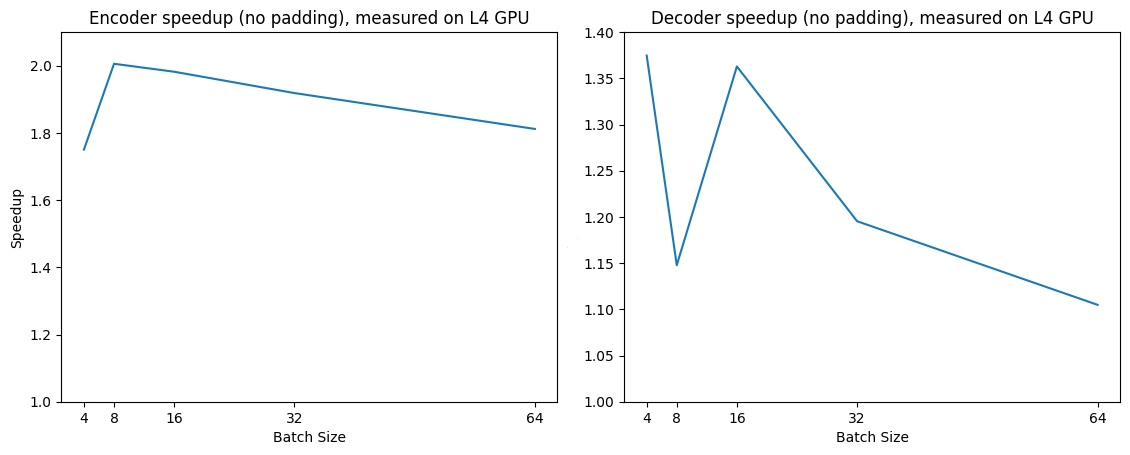
فيما يلي مخطط تسريع متوقع يقارن زمن الاستدلال النقي بين التنفيذ الأصلي وتنفيذ Flash Attention 2.
استخدام الانتباه القياسي بنقطة منتج
يتضمن PyTorch مُشغّلًا أصليًا للانتباه بنقطة جدولية مُقيّمة (SDPA) كجزء من torch.nn.functional. تشمل هذه الدالة عدة تطبيقات يمكن تطبيقها اعتمادًا على المدخلات والعتاد المستخدم. راجع التوثيق الرسمي أو صفحة GPU Inference لمزيد من المعلومات.
يُستخدم SDPA افتراضيًا لـ torch>=2.1.1 عندما تكون هناك نسخة تنفيذية متاحة، لكن يمكنك أيضًا تعيين attn_implementation="sdpa" في from_pretrained() لطلب استخدام SDPA بشكل صريح.
from transformers import M2M100ForConditionalGeneration


model = M2M100ForConditionalGeneration.from_pretrained("facebook/m2m100_418M", attn_implementation="sdpa", device_map="auto")
...
للحصول على أفضل تسارعات، ننصح بتحميل النموذج بدقة نصفية (مثل torch.float16 أو torch.bfloat16).