
Transformers documentation
YOSO
نُشر هذا النموذج في أوراق HF في 18-11-2021، وأُضيف إلى مكتبة Hugging Face Transformers في 26-01-2022.
YOSO
نظرة عامة
قُدِّم نموذج YOSO في You Only Sample (Almost) Once: Linear Cost Self-Attention Via Bernoulli Sampling
بواسطة Zhanpeng Zeng وYunyang Xiong وSathya N. Ravi وShailesh Acharya وGlenn Fung وVikas Singh. يقدِّم YOSO تقريباً للانتباه الذاتي القياسي softmax عبر مخطط أخذ عينات من نوع Bernoulli يعتمد على تجزئة الحساسية للموقع (LSH). من حيث المبدأ، يمكن أخذ عينات جميع متغيرات Bernoulli العشوائية باستخدام تجزئة واحدة.
المستخلص من الورقة البحثية هو كالتالي:
تُستخدم النماذج القائمة على Transformer على نطاق واسع في معالجة اللغة الطبيعية (NLP). وتتمحور بنية نموذج Transformer حول آلية الانتباه الذاتي (self-attention)، التي تلتقط تفاعلات أزواج الرموز (tokens) في التسلسلات المدخلة وتعتمد تربيعيًا على طول التسلسل. وتُعدّ تدريب هذه النماذج على تسلسلات أطول مكلفًا. في هذه الورقة، نُظهر أن آلية انتباه ذاتي تعتمد على أخذ عينات برنولي (Bernoulli sampling) مبنية على تجزئة الحساسية للموقع (Locality Sensitive Hashing - LSH)، تُقلّل التعقيد التربيعي لهذه النماذج إلى خطي. نتجاوز التكلفة التربيعية عن طريق اعتبار الانتباه الذاتي مجموعًا لرموز فردية مرتبطة بمتغيرات عشوائية برنولي، يمكن مبدئيًا أخذ عينات منها دفعة واحدة عبر تجزئة واحدة (رغم أن هذا العدد قد يكون ثابتًا صغيرًا في الممارسة العملية). يؤدي هذا إلى مخطط أخذ عينات فعّال لتقدير الانتباه الذاتي يعتمد على تعديلات محددة في LSH (لتسهيل النشر على بنية معالجات الرسوميات GPU). قمنا بتقييم خوارزميتنا على معيار GLUE باستخدام طول تسلسل قياسي يبلغ 512، حيث لاحظنا أداءً مواتيًا مقارنةً بنموذج Transformer مُدرَّب مسبقًا قياسي. وعلى معيار Long Range Arena (LRA)، المخصص لتقييم الأداء على التسلسلات الطويلة، حققت طريقتنا نتائج متسقة مع الانتباه الذاتي softmax، لكن مع تسارعات كبيرة وتوفير في الذاكرة، وغالبًا ما تفوقت على طرق الانتباه الذاتي الفعّالة الأخرى. الكود متاح في هذا الرابط: https URL
تمت مساهمة هذا النموذج من قِبل novice03. يمكن العثور على الكود الأصلي هنا.
نصائح للاستخدام
- يُنفَّذ خوارزمية الانتباه YOSO عبر نوى CUDA مخصصة، وهي دوال مكتوبة بلغة CUDA C++ يمكن تنفيذها عدة مرات بالتوازي على وحدة معالجة الرسوميات (GPU).
- توفّر النوى دالة
fast_hash، والتي تقرب الإسقاطات العشوائية للاستعلامات والمفاتيح باستخدام تحويل هادامارد السريع. وباستخدام رموز التجزئة هذه، تقرب دالةlsh_cumulationالانتباه الذاتي عبر أخذ عينات برنولي القائم على LSH. - لاستخدام النوى المخصصة، يجب على المستخدم تعيين
config.use_expectation = False. ولضمان نجاح تجميع النوى، يجب على المستخدم تثبيت الإصدار الصحيح من PyTorch وcudatoolkit. افتراضياً، يكونconfig.use_expectation = True، مما يستخدم YOSO-E ولا يتطلب تجميع نوى CUDA.
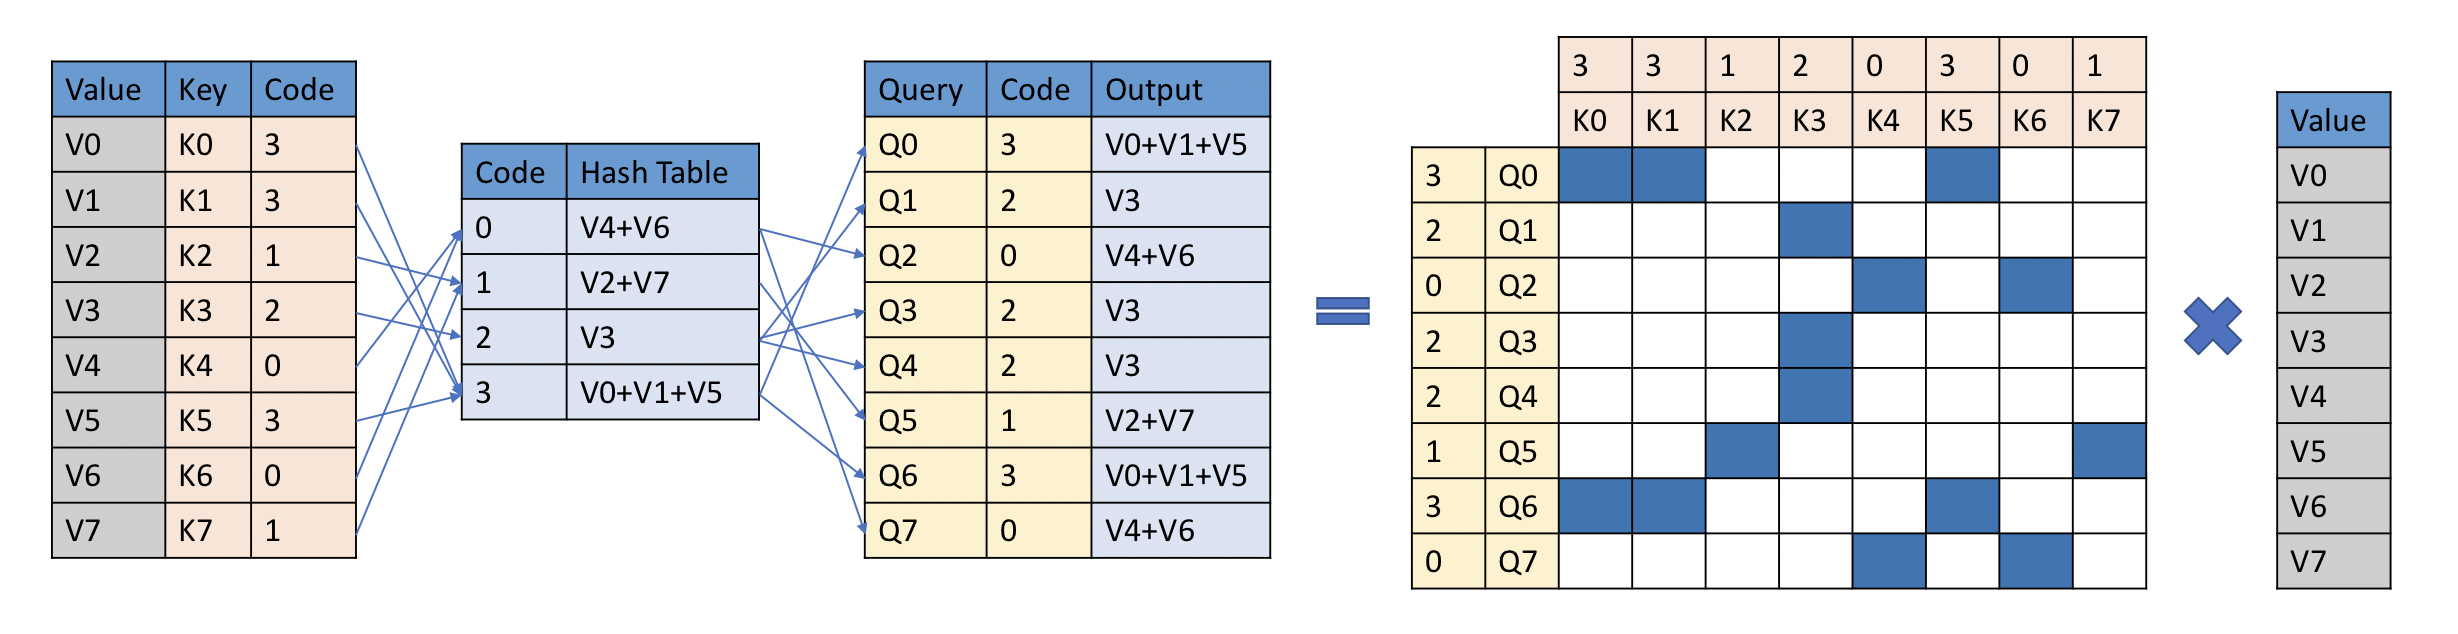 YOSO Attention Algorithm. Taken from the original paper.
الموارد
- دليل مهمة تصنيف النصوص
- دليل مهمة تصنيف الرموز
- دليل مهمة الإجابة عن الأسئلة
- دليل مهمة نمذجة اللغة المقنّعة
- دليل مهمة الاختيار من متعدد
YosoConfig
فئة transformers.YosoConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 50265hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.1attention_probs_dropout_prob: float | int = 0.1max_position_embeddings: int = 4096type_vocab_size: int = 1initializer_range: float = 0.02layer_norm_eps: float = 1e-12use_expectation: bool = Truehash_code_len: int = 9num_hash: int = 64conv_window: int | None = Noneuse_fast_hash: bool = Truelsh_backward: bool = Truepad_token_id: int | None = 1bos_token_id: int | None = 0eos_token_id: int | list[int] | None = 2add_cross_attention: bool = Falsetie_word_embeddings: bool = True )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية50265) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية768) — أبعاد التمثيلات المخفية. - num_hidden_layers (
int، اختياري، القيمة الافتراضية12) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية12) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - intermediate_size (
int، اختياري، القيمة الافتراضية3072) — أبعاد تمثيلات MLP. - hidden_act (
str، اختياري، القيمة الافتراضيةgelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وما إلى ذلك. - hidden_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات، والمُشفِّر، والمُجمِّع. - attention_probs_dropout_prob (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — نسبة إسقاط الاحتمالات الانتباهية. - max_position_embeddings (
int، اختياري، القيمة الافتراضية4096) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج. - type_vocab_size (
int، اختياري، القيمة الافتراضية1) — حجم مفرداتtoken_type_ids. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - layer_norm_eps (
float, اختياري، القيمة الافتراضية1e-12) — قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة. - use_expectation (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام YOSO Expectation أم لا. يتجاوز أي تأثير لـ num_hash. - hash_code_len (
int، اختياري، القيمة الافتراضية 9) — طول الرموز التجزئة التي تولدها دوال التجزئة. - num_hash (
int، اختياري، القيمة الافتراضية 64) — عدد دوال التجزئة المستخدمة فيYosoSelfAttention. - conv_window (
int, اختياري) — حجم النواة للتمويه العميق. - use_fast_hash (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام نواة cuda مخصصة تنفذ إسقاطاً عشوائياً سريعاً عبر تحويل هادامارد. - lsh_backward (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تنفيذ الانتشار العكسي باستخدام تجزئة الحساسية المحلية. - pad_token_id (
int، اختياري، القيمة الافتراضية1) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int, اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]]، اختياري، القيمة الافتراضية2) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - add_cross_attention (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إضافة طبقات الانتباه المتقاطع إلى النموذج. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب ربط ترميزات الأوزان (weight embeddings) وفقاً لخريطةtied_weights_keysالخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج YosoModel. تُستخدم لاستحداث نموذج Yoso وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ uw-madison/yoso-4096
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import YosoConfig, YosoModel

>>> # Initializing a YOSO uw-madison/yoso-4096 style configuration
>>> configuration = YosoConfig()

>>> # Initializing a model (with random weights) from the uw-madison/yoso-4096 style configuration
>>> model = YosoModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
YosoModel
فئة transformers.YosoModel
< source >( config: YosoConfig )
المعاملات
- config (YosoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Yoso الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithCrossAttentions or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
BaseModelOutputWithCrossAttentions أو tuple(torch.Tensor)
BaseModelOutputWithCrossAttentions أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (YosoConfig) والمدخلات.
تتجاوز طريقة YosoModel الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueوconfig.add_cross_attention=Trueأو عندconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
YosoForMaskedLM
فئة transformers.YosoForMaskedLM
< source >( config: YosoConfig )
المعاملات
- config (YosoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Yoso مع رأس language modeling في الأعلى.”
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MaskedLMOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[-100, 0, ..., config.vocab_size](انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MaskedLMOutput أو tuple(torch.Tensor)
MaskedLMOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (YosoConfig) والمدخلات.
تتجاوز طريقة YosoForMaskedLM الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة المقنّعة (MLM).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoTokenizer, YosoForMaskedLM
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMaskedLM.from_pretrained("uw-madison/yoso-4096")

>>> inputs = tokenizer("The capital of France is <mask>.", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # retrieve index of <mask>
>>> mask_token_index = (inputs.input_ids == tokenizer.mask_token_id)[0].nonzero(as_tuple=True)[0]

>>> predicted_token_id = logits[0, mask_token_index].argmax(axis=-1)
>>> tokenizer.decode(predicted_token_id)
...

>>> labels = tokenizer("The capital of France is Paris.", return_tensors="pt")["input_ids"]
>>> # mask labels of non-<mask> tokens
>>> labels = torch.where(inputs.input_ids == tokenizer.mask_token_id, labels, -100)

>>> outputs = model(**inputs, labels=labels)
>>> round(outputs.loss.item(), 2)
...
YosoForSequenceClassification
فئة transformers.YosoForSequenceClassification
< source >( config: YosoConfig )
المعاملات
- config (YosoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج YOSO مُحوِّل (Transformer) مع رأس تصنيف/انحدار تسلسلي في الأعلى (طبقة خطية فوق المخرجات المجمّعة)، على سبيل المثال لمهام GLUE.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → SequenceClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف/الانحدار التسلسلي. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels == 1يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كانconfig.num_labels > 1يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
SequenceClassifierOutput أو tuple(torch.Tensor)
SequenceClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (YosoConfig) والمدخلات.
تتجاوز طريقة YosoForSequenceClassification الخاصة بـ forward الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels)) — درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال على تصنيف بوسم واحد:
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", num_labels=num_labels)

>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
مثال على تصنيف متعدد التسميات:
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", problem_type="multi_label_classification")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained(
...     "uw-madison/yoso-4096", num_labels=num_labels, problem_type="multi_label_classification"
... )

>>> labels = torch.sum(
...     torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
YosoForMultipleChoice
فئة transformers.YosoForMultipleChoice
< source >( config: YosoConfig )
المعاملات
- config (YosoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Yoso مع رأس تصنيف متعدد الخيارات في الأعلى (طبقة خطية فوق المخرجات المجمعة وsoftmax) على سبيل المثال لمهام RocStories/SWAG.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → MultipleChoiceModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, num_choices, sequence_length)) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.LongTensorبشكل(batch_size, num_choices, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.LongTensorبشكل(batch_size, num_choices, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.max_position_embeddings - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, num_choices, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_idsيمكنك اختيار تمرير تمثيل مضمّن مباشرة. هذا مفيد إذا كنت تريد مزيدًا من التحكم في كيفية تحويل فهارس input_ids إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size,)، اختياري) — التسميات لحساب خسارة تصنيف الاختيار المتعدد. يجب أن تكون الفهارس ضمن[0, ..., num_choices-1]حيثnum_choicesهو حجم البُعد الثاني من المصفوفات المدخلة. (انظرinput_idsأعلاه) - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
MultipleChoiceModelOutput أو tuple(torch.Tensor)
MultipleChoiceModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعدادات (YosoConfig) والمدخلات.
تتجاوز طريقة YosoForMultipleChoice الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل (1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف.logits (
torch.Tensorمن الشكل(batch_size, num_choices)) — num_choices هو البُعد الثاني للمصفوفات المدخلة. (انظر input_ids أعلاه).درجات التصنيف (قبل SoftMax).
hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoTokenizer, YosoForMultipleChoice
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMultipleChoice.from_pretrained("uw-madison/yoso-4096")

>>> prompt = "In Italy, pizza served in formal settings, such as at a restaurant, is presented unsliced."
>>> choice0 = "It is eaten with a fork and a knife."
>>> choice1 = "It is eaten while held in the hand."
>>> labels = torch.tensor(0).unsqueeze(0)  # choice0 is correct (according to Wikipedia ;)), batch size 1

>>> encoding = tokenizer([prompt, prompt], [choice0, choice1], return_tensors="pt", padding=True)
>>> outputs = model(**{k: v.unsqueeze(0) for k, v in encoding.items()}, labels=labels)  # batch size is 1

>>> # the linear classifier still needs to be trained
>>> loss = outputs.loss
>>> logits = outputs.logits
YosoForTokenClassification
فئة transformers.YosoForTokenClassification
< source >( config: YosoConfig )
المعاملات
- config (YosoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Yoso transformer مع رأس تصنيف الرموز في الأعلى (طبقة خطية فوق مخرجات الحالات المخفية) على سبيل المثال لمهام التعرف على الكيانات المسمّاة (NER).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TokenClassifierOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة تصنيف الرموز. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
TokenClassifierOutput أو tuple(torch.Tensor)
TokenClassifierOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (YosoConfig) والمدخلات.
تتجاوز طريقة YosoForTokenClassification الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة التصنيف.logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.num_labels)) — درجات التصنيف (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoTokenizer, YosoForTokenClassification
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForTokenClassification.from_pretrained("uw-madison/yoso-4096")

>>> inputs = tokenizer(
...     "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_token_class_ids = logits.argmax(-1)

>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...

>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
YosoForQuestionAnswering
فئة transformers.YosoForQuestionAnswering
< source >( config: YosoConfig )
المعاملات
- config (YosoConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Yoso transformer مع رأس تصنيف مقاطع (span classification head) في الأعلى لمهام الإجابة الاستخراجية على الأسئلة مثل SQuAD (طبقة خطية فوق مخرجات الحالات المخفية لحساب span start logits وspan end logits).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonestart_positions: typing.Optional[torch.Tensor] = Noneend_positions: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → QuestionAnsweringModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل. ما هي معرّفات الإدخال؟يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- token_type_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار المؤشرات من[0, 1]:- 0 يتوافق مع رمز sentence A،
- 1 يتوافق مع رمز sentence B.
- position_ids (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - start_positions (
torch.Tensorمن الشكل(batch_size,)، اختياري) — تسميات لموضع (فهرس) بداية المقطع المُسمّى لحساب خسارة تصنيف الرموز. تُثبَّت المواضع على طول التسلسل (sequence_length). لا تُؤخذ المواضع خارج التسلسل في الاعتبار عند حساب الخسارة. - end_positions (
torch.Tensorمن الشكل(batch_size,)، اختياري) — تسميات لموضع (فهرس) نهاية المقطع المُسمّى لحساب خسارة تصنيف الرموز. تُثبَّت المواضع على طول التسلسل (sequence_length). لا تُؤخذ المواضع خارج التسلسل في الاعتبار عند حساب الخسارة. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
QuestionAnsweringModelOutput أو tuple(torch.Tensor)
QuestionAnsweringModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (YosoConfig) والمدخلات.
تتجاوز طريقة YosoForQuestionAnswering الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — إجمالي خسارة استخراج المقاطع هو مجموع دالة Cross-Entropy لموقعي البداية والنهاية.start_logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — درجات بداية النطاق (قبل SoftMax).end_logits (
torch.Tensorمن الشكل(batch_size, sequence_length)) — درجات نهاية المدى (قبل SoftMax).hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoTokenizer, YosoForQuestionAnswering
>>> import torch

>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForQuestionAnswering.from_pretrained("uw-madison/yoso-4096")

>>> question, text = "Who was Jim Henson?", "Jim Henson was a nice puppet"

>>> inputs = tokenizer(question, text, return_tensors="pt")
>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()

>>> predict_answer_tokens = inputs.input_ids[0, answer_start_index : answer_end_index + 1]
>>> tokenizer.decode(predict_answer_tokens, skip_special_tokens=True)
...

>>> # target is "nice puppet"
>>> target_start_index = torch.tensor([14])
>>> target_end_index = torch.tensor([15])

>>> outputs = model(**inputs, start_positions=target_start_index, end_positions=target_end_index)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
...