
Transformers documentation
GLM-5, GLM-5.1, GLM-5.2, GLM-5.3
نُشر هذا النموذج في أوراق HF في 17 فبراير 2026، وأُضيف إلى مكتبة Hugging Face Transformers في 9 فبراير 2026.


GLM-5, GLM-5.1, GLM-5.2, GLM-5.3
نظرة عامة
تستخدم نماذج اللغة GLM-5 وGLM-5.1 وGLM-5.2 وGLM-5.3 هذه الفئة. ولا تتضمن التنفيذ في transformers طبقة MTP.
GLM-5.3
يستخدم GLM-5.3 نفس النموذج الأساسي الذي يستخدمه GLM-5.2 — وكل التحسينات تأتي من التدريب اللاحق. مقارنةً بـ GLM-5.2، يتفوق بشكل كبير في البرمجة المعقدة والمهام طويلة المدى:
- برمجة أقوى: يُعدّ GLM-5.3 نموذج الأوزان المفتوحة الأكثر قدرة في مجال البرمجة، إذ يحقق تحسّناً بنسبة 50% مقارنةً بـ GLM-5.2 على معيار Z.ai Code Bench الداخلي لدينا. كما يحقق أيضاً أفضل أداء مفتوح المصدر على المعايير العامة، بما في ذلك Terminal Bench 3.0 وAgents’ Last Exam.
- القدرات السيبرانية الناشئة: مع توسيع نطاق التدريب اللاحق، تطورت القدرات السيبرانية بوتيرة أسرع مما توقعنا. يُعدّ GLM-5.3 من أحدث التقنيات في CyberGym لاكتشاف الثغرات الأمنية، وتكون مكاسبه أكبر كلما تقدمنا في سلسلة الاستغلال، حيث يتضاعف أداؤه أكثر من ضعف مقارنة بـ GLM-5.2 في معايير الاستغلال.
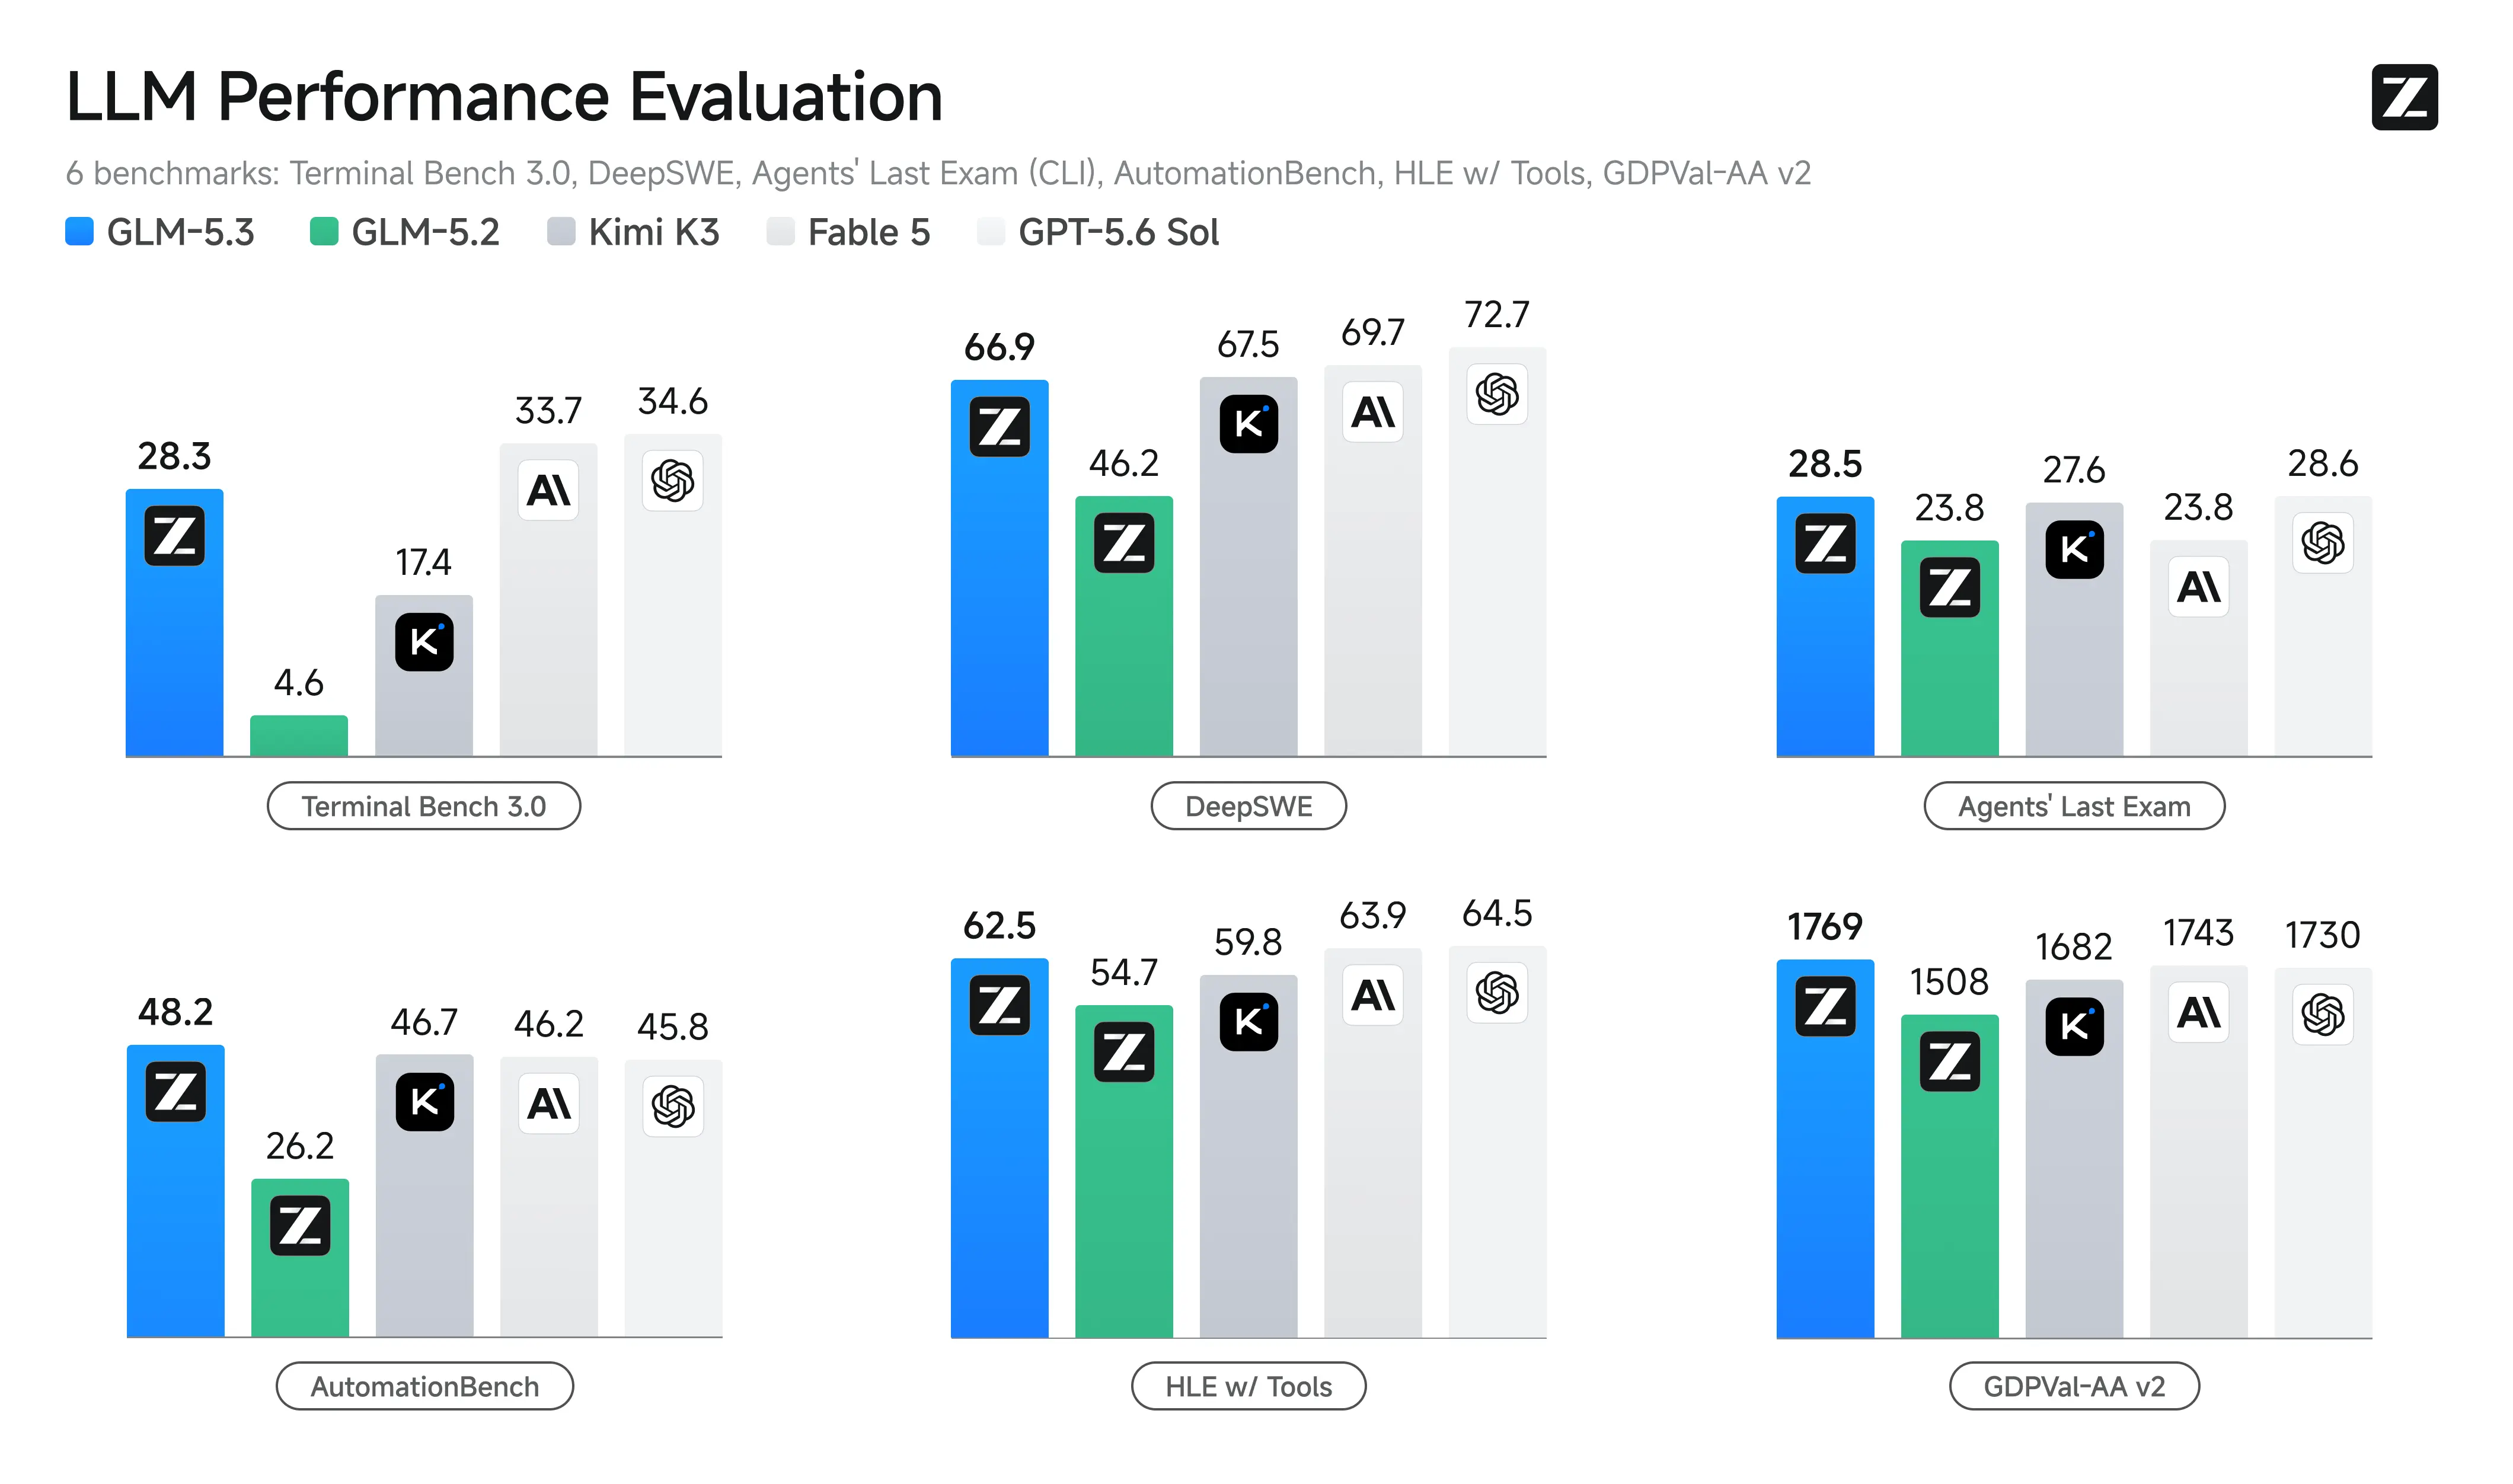
GLM-5.2
GLM-5.2، أحدث نموذج رئيسي لدينا للمهام طويلة المدى. يشكّل هذا النموذج قفزة نوعية كبيرة في القدرة على أداء المهام طويلة المدى مقارنةً بسلفه GLM-5.1، ويقدّم هذه القدرة للمرة الأولى على سياق ثابت يبلغ طوله مليون رمز.
تشمل القدرات الجديدة في GLM-5.2 ما يلي:
- سياق ثابت بمليون رمز: سياق ثابت بمليون رمز يحافظ على استقرار العمل طويل الأمد
- البرمجة المتقدمة بمرونة في الجهد: قدرات برمجة أقوى مع مستويات متعددة لجهد التفكير لموازنة الأداء وزمن الاستجابة
- تحسين البنية المعمارية: نقترح IndexShare، الذي يعيد استخدام نفس الفهرس عبر كل أربع طبقات من الانتباه المتناثر، مما يقلل من عمليات FLOPs لكل رمز بنسبة 2.9× عند طول سياق يبلغ 1M. كما نعمل على تحسين طبقة MTP في GLM-5.2 للترميز التخميني، مما يزيد طول القبول بنسبة تصل إلى 20%
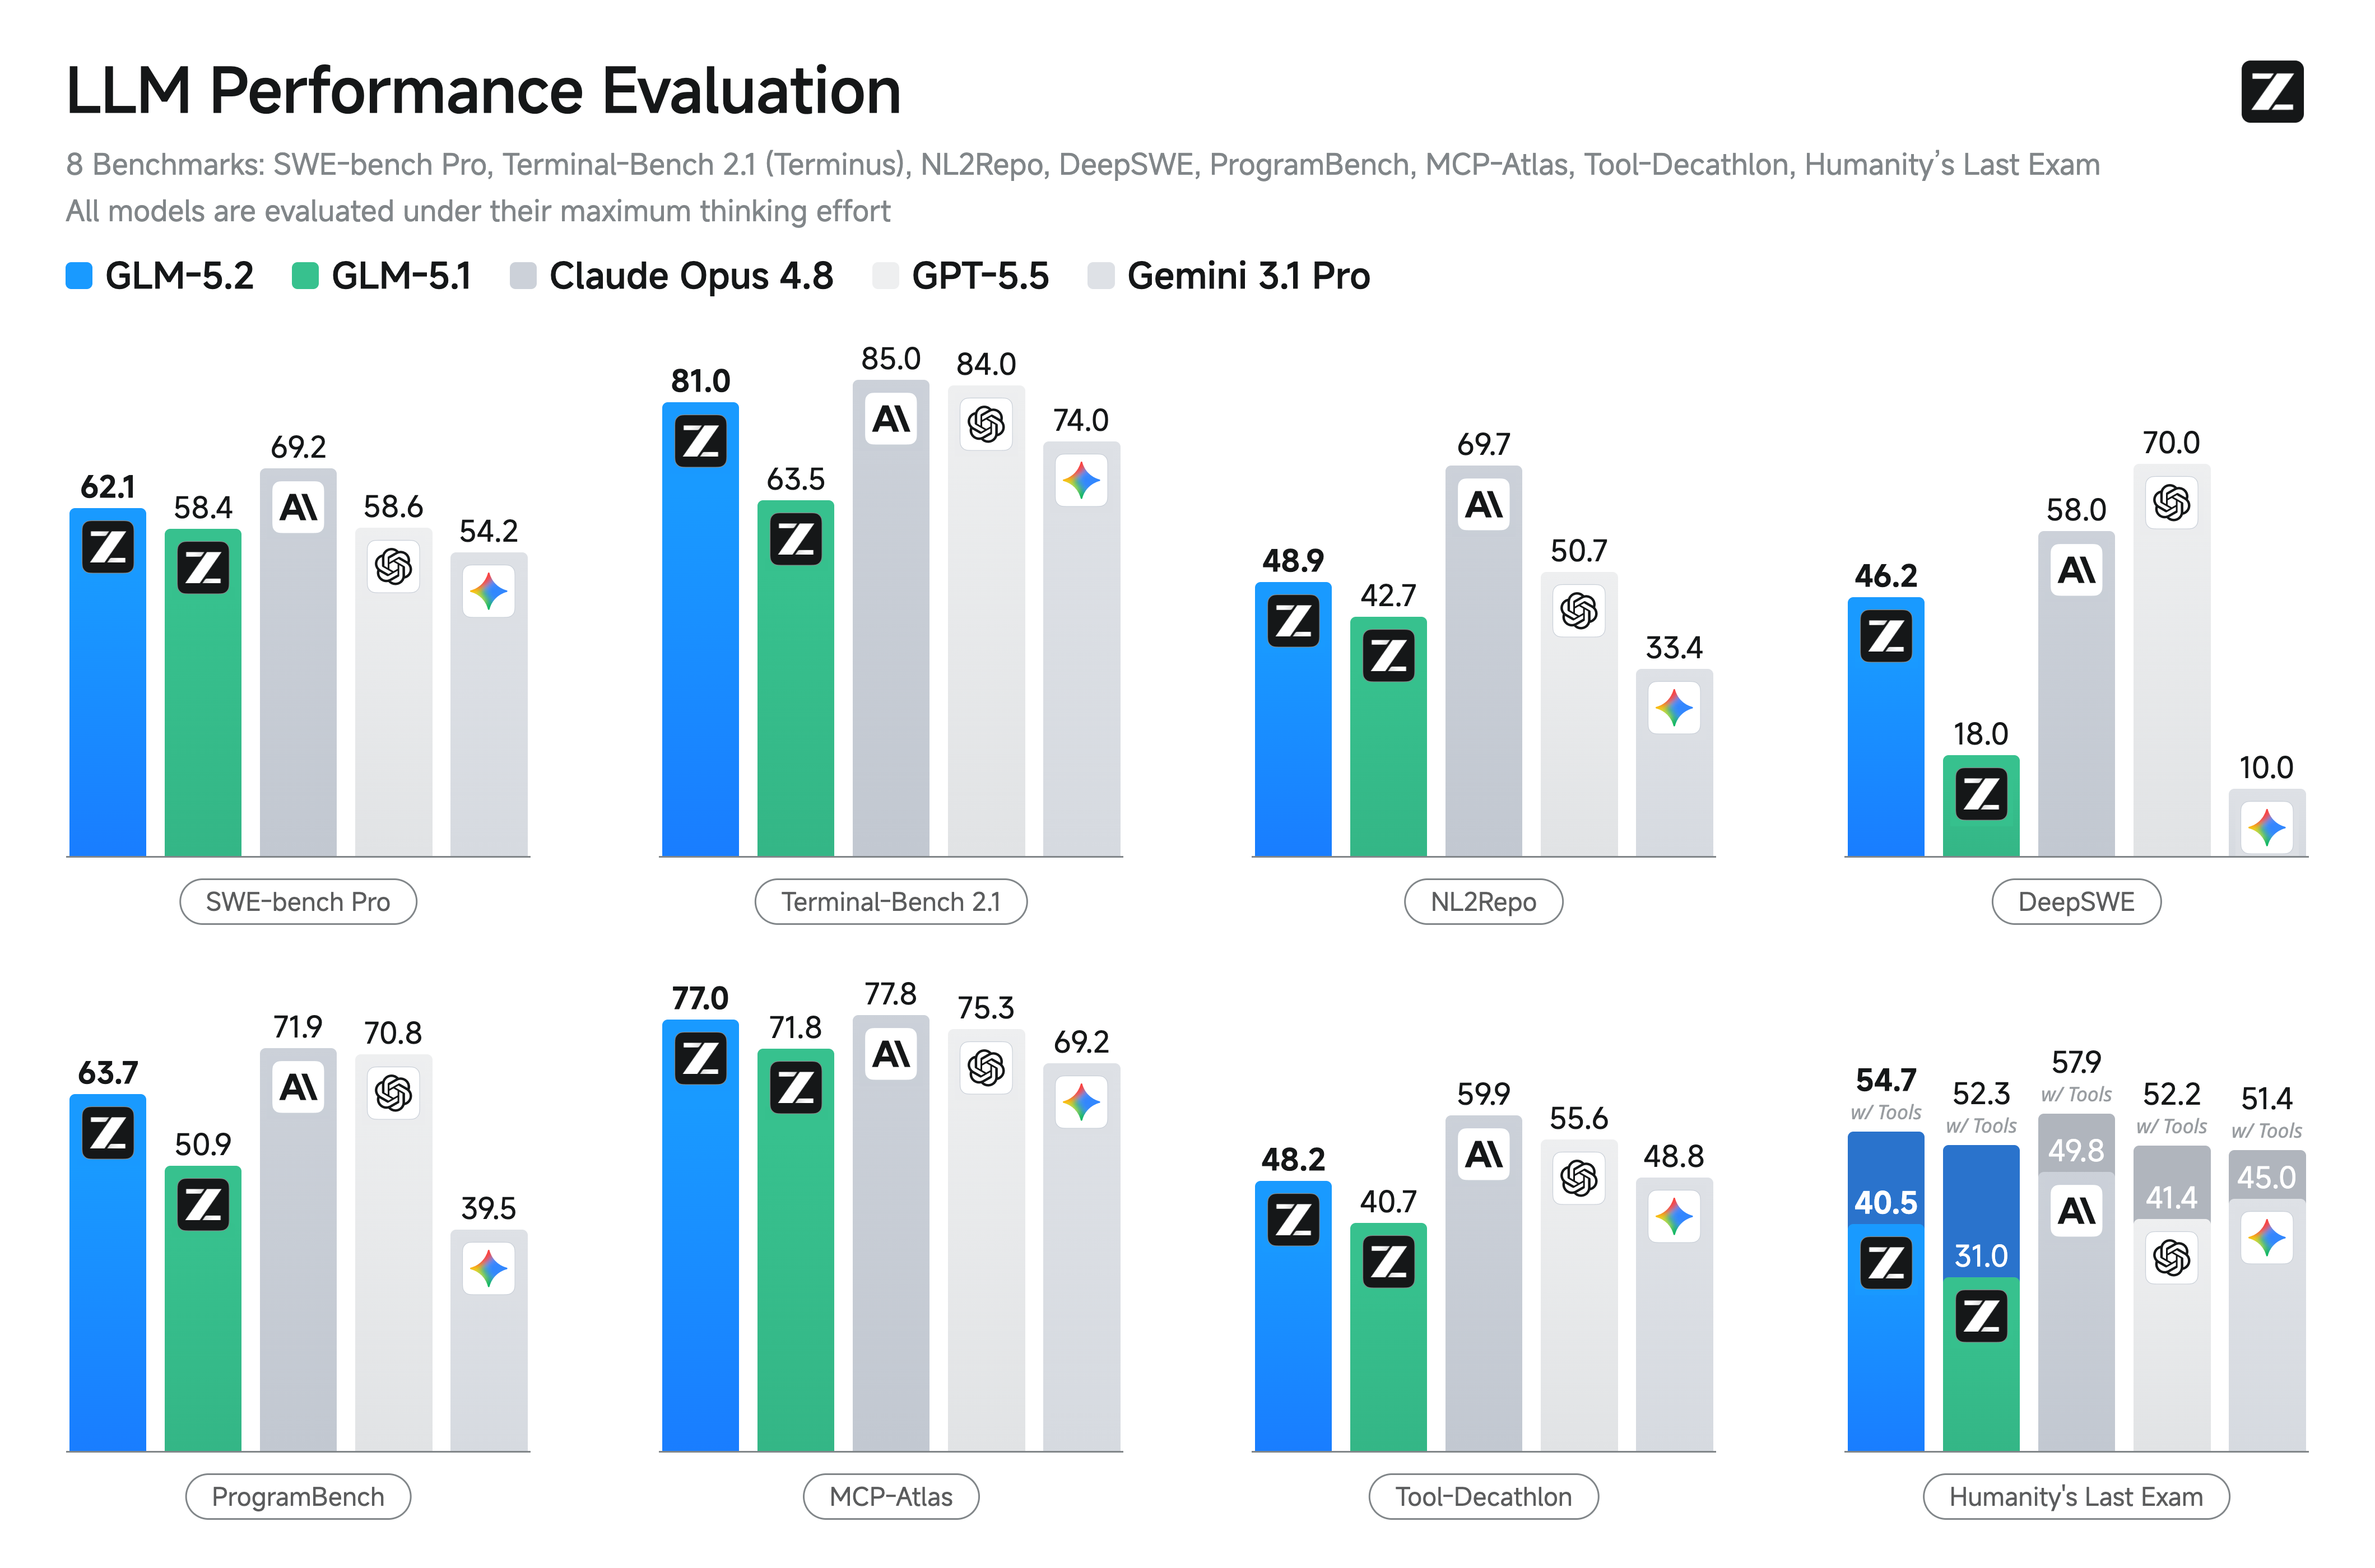
في معايير البرمجة القياسية، يُعدّ GLM-5.2 أقوى نموذج مفتوح المصدر، محققاً تقدماً كبيراً على GLM-5.1 بفارق واسع: 81.0 مقابل 62.0 في Terminal-Bench 2.1، و62.1 مقابل 58.4 في SWE-bench Pro. كما يُقلّص الفجوة مع النماذج المغلقة المصدر المتقدمة بشكل كبير؛ ففي Terminal-Bench 2.1 (81.0) يقترب من Claude Opus 4.8 (85.0) بضع نقاط فقط، مع بقاءه في صدارة Gemini 3.1 Pro.
لمزيد من التفاصيل، راجع مدونتنا.
GLM-5.1
GLM-5.1 هو نموذجنا الرائد من الجيل التالي للمهندسة الوكيلية، ويتميز بقدرات برمجية أقوى بكثير من سلفه. يحقق أداءً متقدماً على SWE-Bench Pro ويتفوق على GLM-5 بفارق كبير على NL2Repo (توليد المستودعات) وTerminal-Bench 2.0 (مهام الطرفية الواقعية).
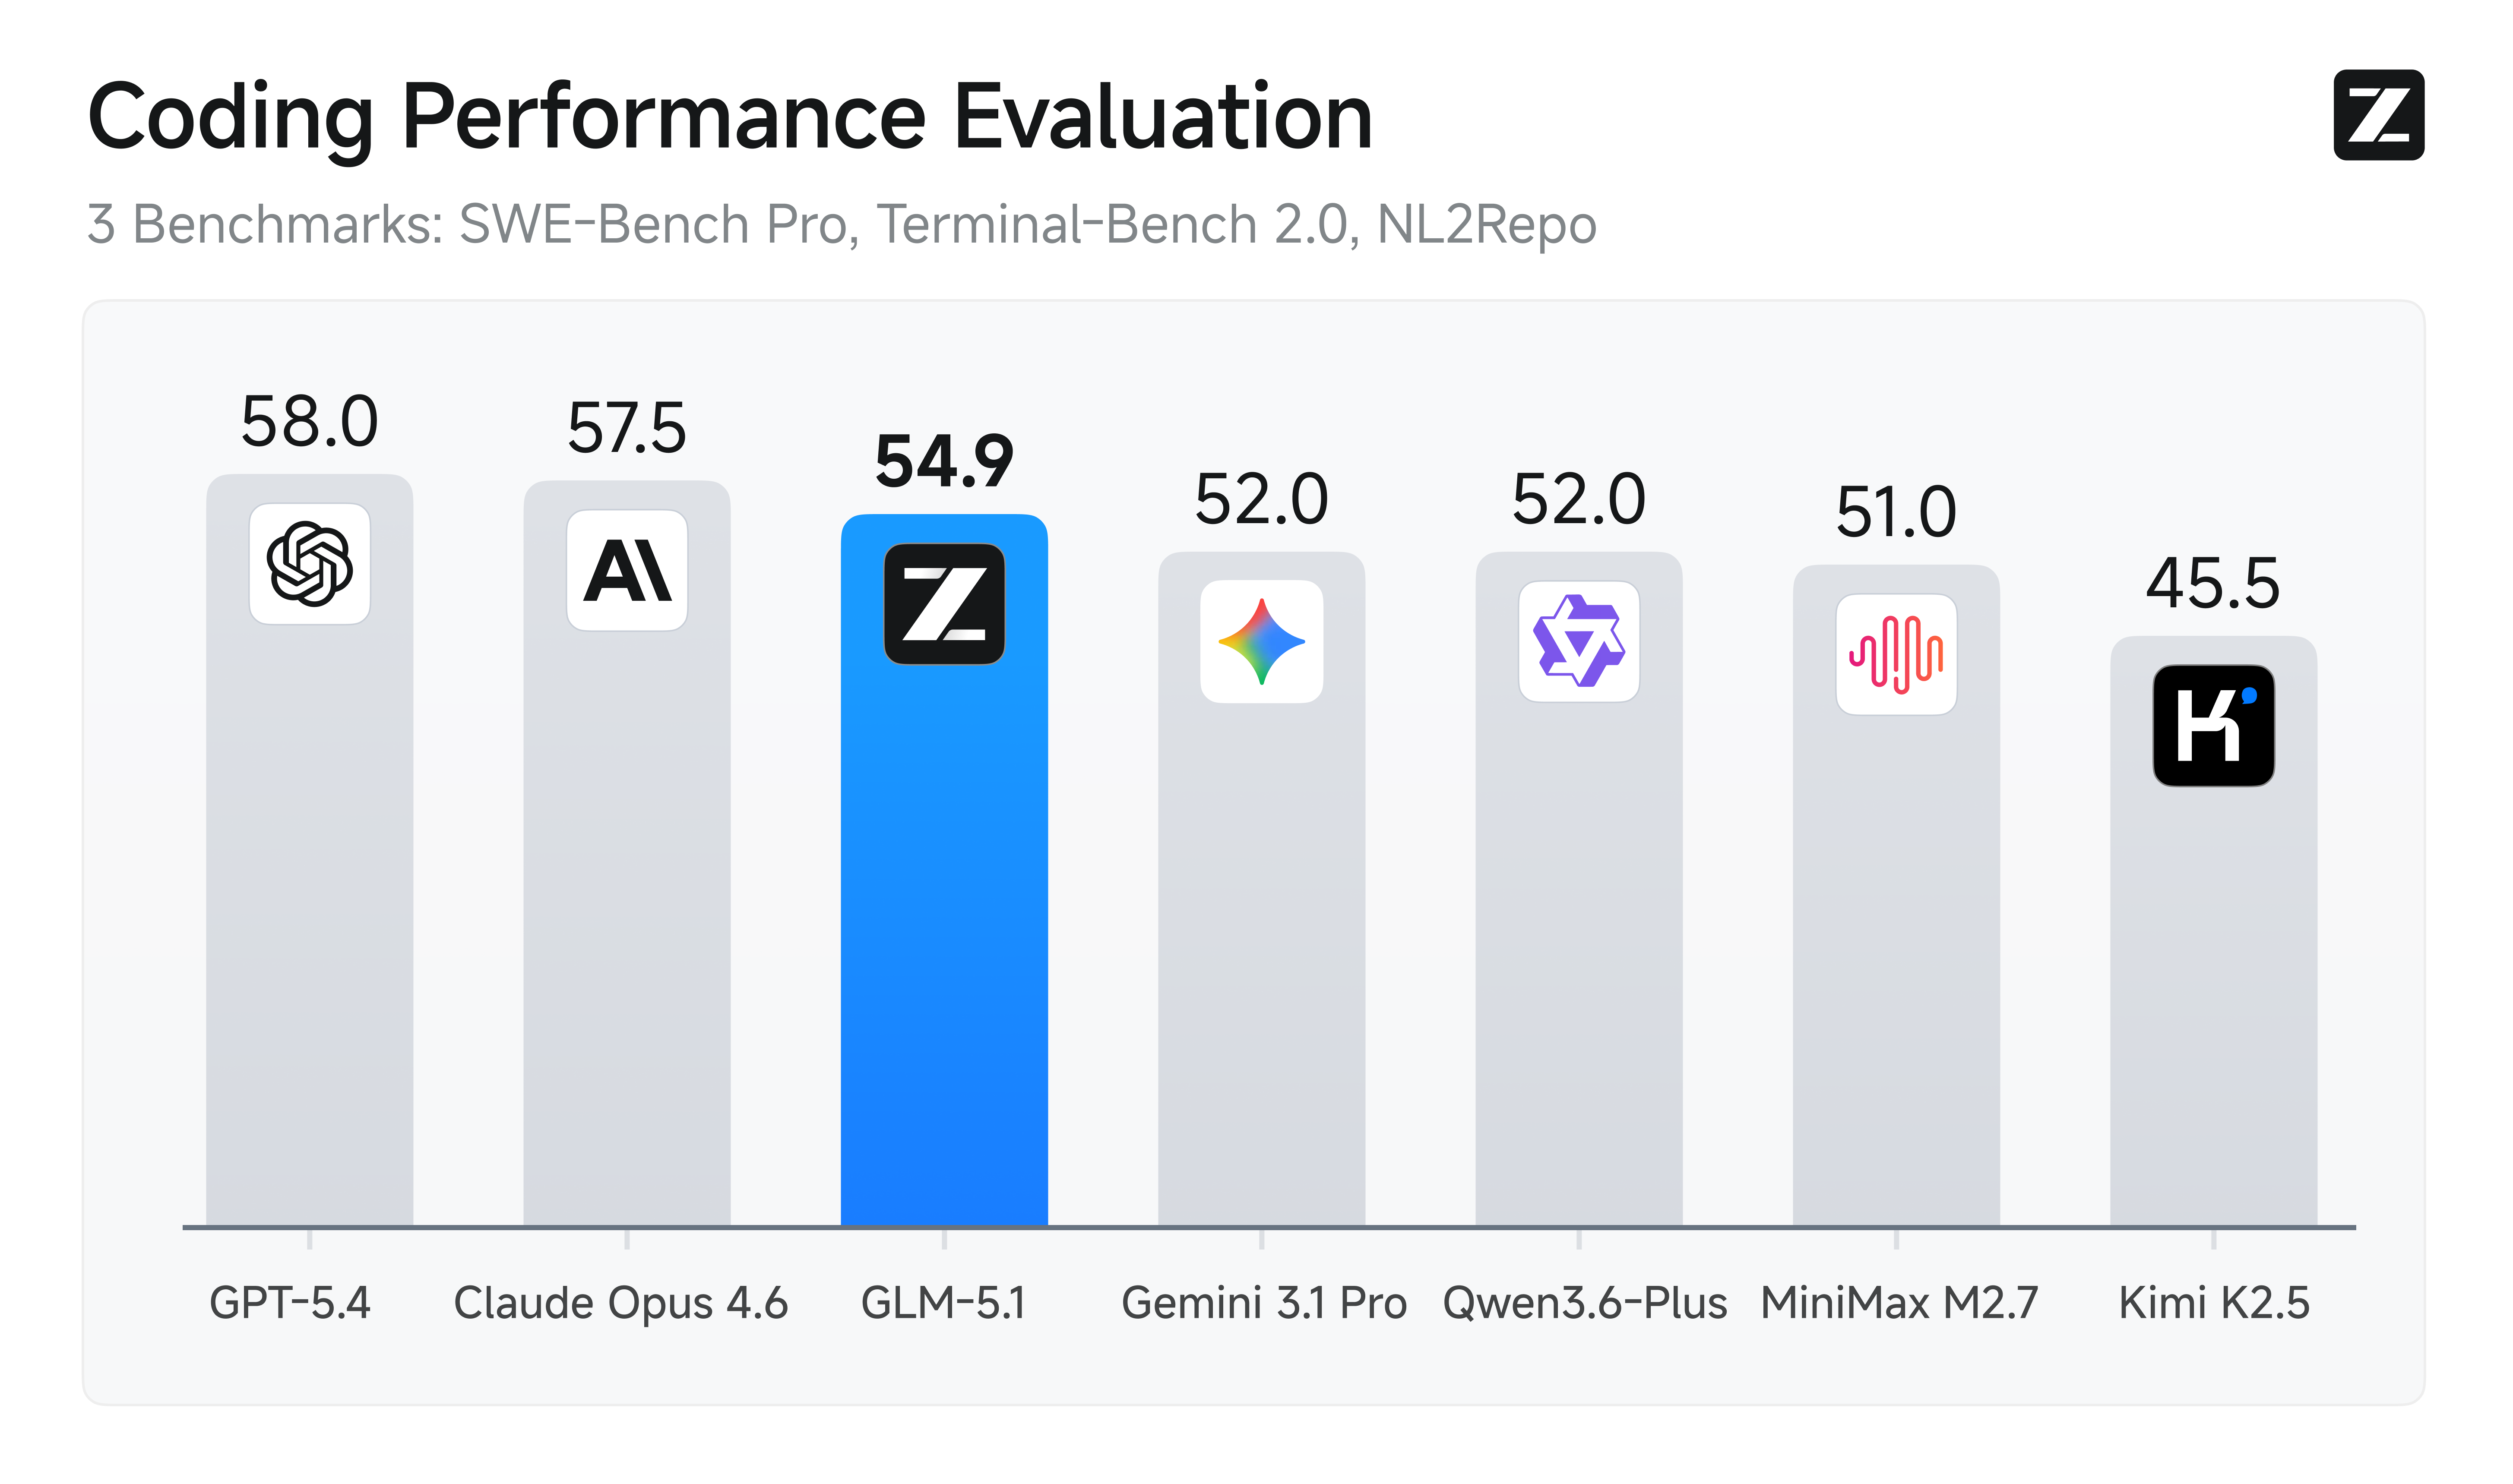
لكن القفزة الأكثر دلالة تتجاوز أداء المحاولة الأولى. فالنماذج السابقة — بما في ذلك GLM-5 — تميل إلى استنفاد ترسانتها من الأساليب مبكراً: فهي تطبّق تقنيات مألوفة لتحقيق مكاسب أولية سريعة، ثم تصل إلى مرحلة من الثبات. ومنحها مزيداً من الوقت لا يُجدي نفعاً.
في المقابل، صُمِّم GLM-5.1 ليظل فعّالاً في المهام الوكيلية عبر فترات زمنية أطول بكثير. وقد وجدنا أن النموذج يتعامل مع المشكلات الغامضة بحكم أدق، ويبقى منتجاً عبر جلسات أطول. إنه يفكك المشكلات المعقدة، ويجري تجارب، ويقرأ النتائج، ويحدد العوائق بدقة حقيقية. ومن خلال إعادة النظر في منطقه وتعديل استراتيجيته عبر التكرار المتكرر، يحافظ GLM-5.1 على التحسين عبر مئات الجولات وآلاف استدعاءات الأدوات. فكلما طال تشغيله، تحسّنت النتيجة.
GLM-5
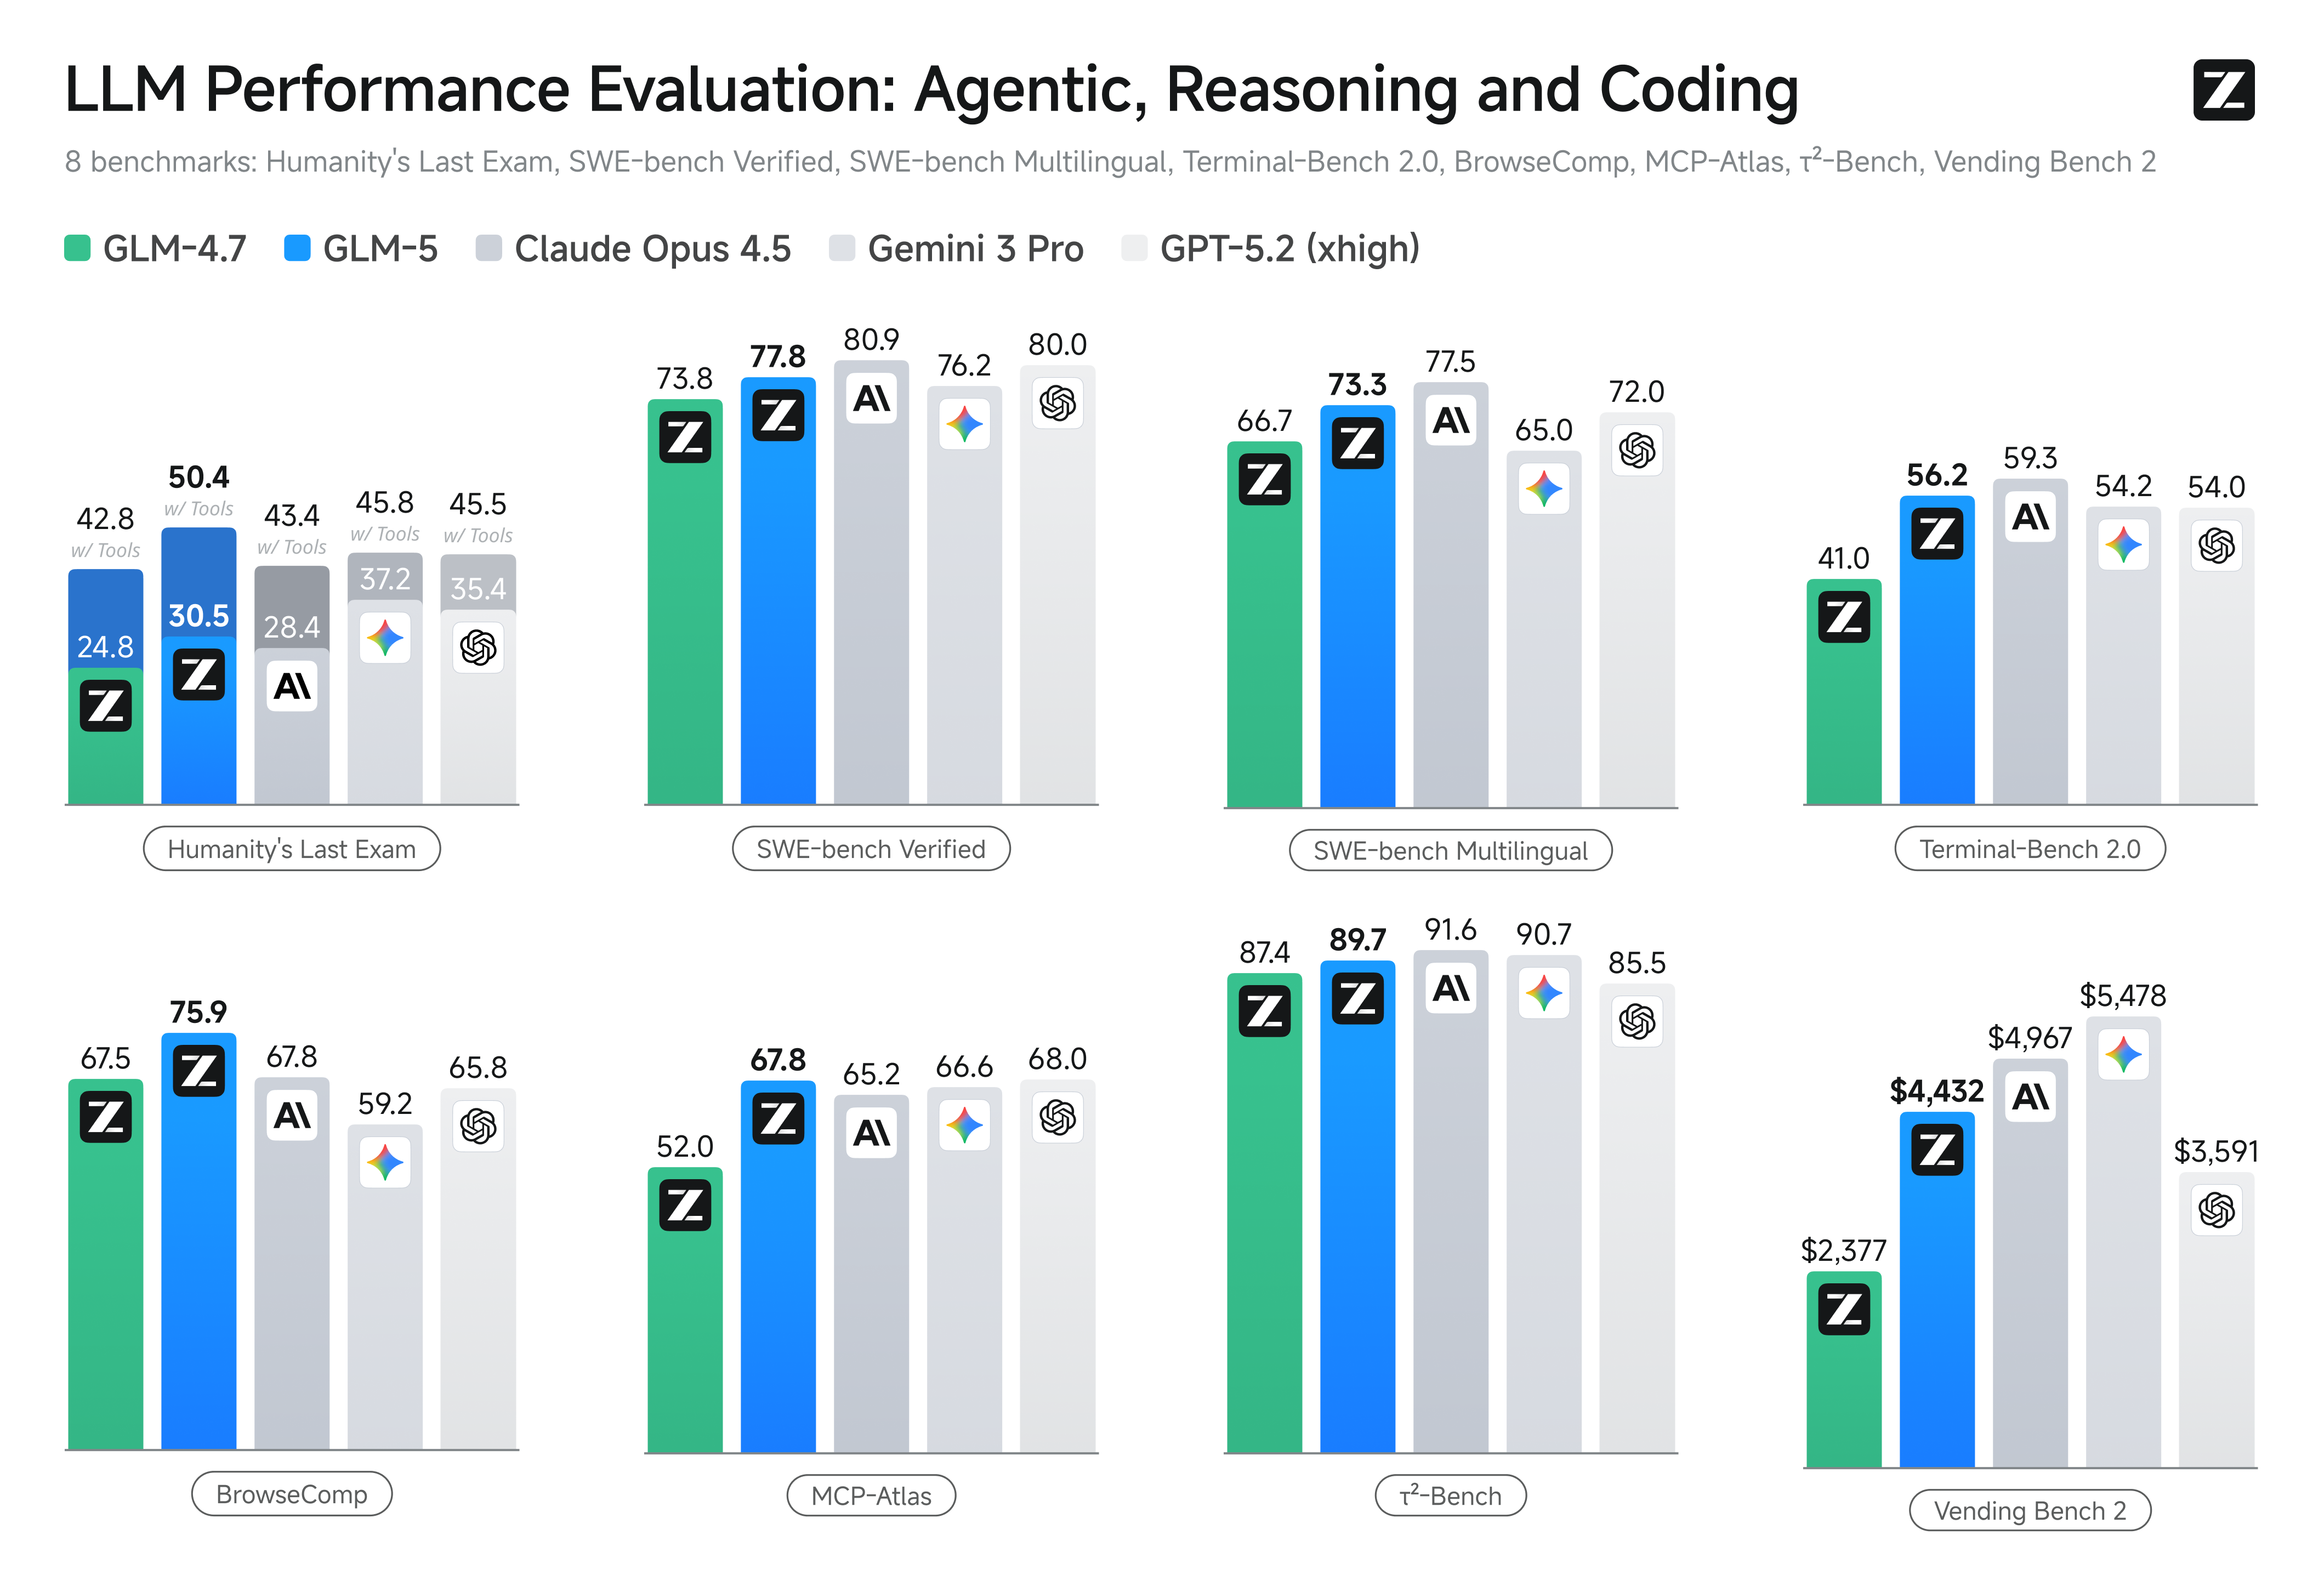
نموذج GLM-5 (GlmMoeDsa) هو نموذج من نوع مزيج الخبراء (Mixture-of-Experts) يحتوي على 744 مليار معامل، مع 40 مليار معامل نشط لكل رمز، ويعتمد على تقنية DeepSeek Sparse Attention (DSA) للتعامل بكفاءة مع سياق يصل طوله إلى 200 ألف رمز. وقد تم تدريبه بالكامل على شرائح Huawei Ascend، ويتطابق أداءه مع مستوى الأداء الرائد في اختبارات الاستدلال والسياقات الطويلة.
مع التقدم المحرز في كلٍّ من التدريب المسبق والتدريب اللاحق، يقدّم GLM-5 تحسينًا كبيرًا مقارنةً بـ GLM-4.7 عبر مجموعة واسعة من المعايير الأكاديمية، ويحقق أداءً من الطراز الأول بين جميع النماذج مفتوحة المصدر في العالم في مهام الاستدلال والبرمجة والوكلاء، مما يُضيّق الفجوة مع النماذج الرائدة.
GlmMoeDsaConfig
فئة transformers.GlmMoeDsaConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 154880hidden_size: int = 6144intermediate_size: int = 12288moe_intermediate_size: int = 2048num_hidden_layers: int = 78num_attention_heads: int = 64num_key_value_heads: int = 64n_shared_experts: int = 1n_routed_experts: int = 256output_router_logits: bool = Falserouted_scaling_factor: float = 2.5kv_lora_rank: int = 512q_lora_rank: int = 2048qk_rope_head_dim: int = 64v_head_dim: int = 256qk_nope_head_dim: int = 192n_group: int = 1topk_group: int = 1num_experts_per_tok: int = 8norm_topk_prob: bool = Truehidden_act: str = 'silu'max_position_embeddings: int = 202752initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truepad_token_id: int | None = Nonebos_token_id: int | None = 0eos_token_id: int | list[int] | None = 1tie_word_embeddings: bool = Falserope_parameters: dict | None = Nonemlp_layer_types: list[str] | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0index_topk: int = 2048index_head_dim: int = 128index_n_heads: int = 32mlp_bias: bool = Falsehead_dim: int = 64first_k_dense_replace: int = 3layer_types: list[str] | None = Noneindexer_types: list[str] | None = None )
المعاملات
- vocab_size (
int، اختياري، القيمة الافتراضية154880) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - hidden_size (
int، اختياري، القيمة الافتراضية6144) — أبعاد التمثيلات المخفية. - intermediate_size (
int، اختياري، القيمة الافتراضية12288) — أبعاد تمثيلات MLP. - moe_intermediate_size (
int، اختياري، القيمة الافتراضية2048) — الحجم الوسيط لشبكات MLP للخبراء الموجَّهين. - num_hidden_layers (
int، اختياري، القيمة الافتراضية78) — عدد الطبقات المخفية في مُفكِّك Transformer. - num_attention_heads (
int، اختياري، القيمة الافتراضية64) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - num_key_value_heads (
int, اختياري، القيمة الافتراضية64) — هذا هو عدد رؤوس key_value التي يجب استخدامها لتنفيذ Grouped Query Attention. إذا كانnum_key_value_heads=num_attention_heads، فسيستخدم النموذج Multi Head Attention (MHA)، وإذا كانnum_key_value_heads=1فسيستخدم النموذج Multi Query Attention (MQA)، وإلا فسيتم استخدام GQA. عند تحويل نقطة تفتيش متعددة الرؤوس إلى نقطة تفتيش GQA، يجب بناء كل رأس key و value للمجموعة عن طريق meanpooling جميع الرؤوس الأصلية داخل تلك المجموعة. لمزيد من التفاصيل، راجع هذا الورقة. إذا لم يتم تحديد القيمة، فستكون القيمة الافتراضية هيnum_attention_heads. - n_shared_experts (
int، اختياري، القيمة الافتراضية1) — عدد الخبراء المشتركين. - n_routed_experts (
int، اختياري، القيمة الافتراضية256) — عدد الخبراء الموجَّهين. - output_router_logits (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب على النموذج إرجاع قيم اللوجيتس الخاصة بالموجِّه (router). تمكين هذا الخيار سيتيح أيضًا للنموذج إخراج الخسارة المساعدة، بما في ذلك خسارة موازنة الحمل وخسارة z الخاصة بالموجِّه. - routed_scaling_factor (
float، اختياري، القيمة الافتراضية2.5) — معامل التوسعة للخبراء الموجَّهين. - kv_lora_rank (
int، اختياري، القيمة الافتراضية512) — رتبة مصفوفات LoRA الخاصة بتحويلات المفتاح والقيمة. - q_lora_rank (
int، اختياري، القيمة الافتراضية2048) — رتبة مصفوفات LoRA الخاصة بإسقاطات الاستعلام. - qk_rope_head_dim (
int، اختياري، القيمة الافتراضية64) — بعد رؤوس الاستعلام/المفتاح التي تستخدم تضمينات الموضع الدورانية. - v_head_dim (
int، اختياري، القيمة الافتراضية256) — بعد رؤوس القيم. - qk_nope_head_dim (
int، اختياري، القيمة الافتراضية192) — بعد رؤوس الاستعلام/المفتاح التي لا تستخدم تضمينات الموضع الدورانية. - n_group (
int، اختياري، القيمة الافتراضية 1) — عدد المجموعات للخبراء الموجَّهين. - topk_group (
int، اختياري، القيمة الافتراضية1) — عدد المجموعات المختارة لكل رمز (لكل رمز، مع ضمان أن الخبراء المختارين يكونون ضمنtopk_groupمجموعات فقط). - num_experts_per_tok (
int، اختياري، القيمة الافتراضية8) — عدد الخبراء الذين يُوجَّه إليهم كل رمز. هذه هي قيمة top-k الخاصة بتوجيه اختيار الرموز. - norm_topk_prob (
bool، اختياري، القيمة الافتراضيةTrue) — هل يتم تطبيع أوزان الخبراء الموجَّهين. - hidden_act (
str، اختياري، القيمة الافتراضيةsilu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - max_position_embeddings (
int، اختياري، القيمة الافتراضية202752) — أقصى طول تسلسل قد يُستخدم معه هذا النموذج على الإطلاق. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - rms_norm_eps (
float، اختياري، القيمة الافتراضية1e-05) — قيمة الإيبسلون المستخدمة في طبقات تطبيع rms. - use_cache (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كانconfig.is_decoder=Trueأو إذا كان النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط. - pad_token_id (
int, اختياري) — معرّف الرمز المستخدم للتعبئة في المفردات. - bos_token_id (
int, اختياري، القيمة الافتراضية0) — معرّف الرمز المستخدم لبدء البث في المفردات. - eos_token_id (
Union[int, list[int]]، اختياري، القيمة الافتراضية1) — معرّف الرمز المستخدم لنهاية التدفق في المفردات. - tie_word_embeddings (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم ربط ترميزات الأوزان وفقاً لخريطةtied_weights_keysالخاصة بالنموذج. - rope_parameters (
dict, اختياري) — قاموس يحتوي على معاملات التهيئة الخاصة بتضمينات RoPE. يجب أن يحتوي القاموس على قيمة لـrope_theta، ومعاملات اختيارية تُستخدم للتصحيح (scaling) في حال رغبتَ في استخدام RoPE معmax_position_embeddingsأطول. - mlp_layer_types (
list، اختياري) — نمط نوع MLP لكل طبقة ("dense"أو"sparse"). القيمة الافتراضية هي 3 طبقات dense والباقي sparse. - attention_bias (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام انحياز في طبقات الإسقاط للاستعلام والمفتاح والقيمة والمخرجات أثناء الانتباه الذاتي. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - index_topk (
int، اختياري، القيمة الافتراضية 2048) — عدد الرموز العليا التي يختارها الفهرس للانتباه المتناثر. - index_head_dim (
int، اختياري، القيمة الافتراضية 128) — أبعاد الرأس (Head dimension) لإسقاطات الفهرس (DSA). - index_n_heads (
int، اختياري، القيمة الافتراضية 32) — عدد الرؤوس الخاصة بتحويلات الفهرسة (DSA). - mlp_bias (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام انحياز في طبقات up_proj وdown_proj وgate_proj ضمن طبقات MLP. - head_dim (
int، اختياري، القيمة الافتراضية64) — بعد رأس الانتباه. إذا كانت القيمة None، فستكون القيمة الافتراضية هي hidden_size // num_attention_heads - first_k_dense_replace (
int، اختياري، القيمة الافتراضية 3) — عدد الطبقات الأولى التي تستخدم MLP كثيف؛ بينما تستخدم الطبقات المتبقية كتلة MoE. - layer_types (
list[str], اختياري) — قائمة تُقرن بشكل صريح كل فهرس طبقة بنوعها. إذا لم تُقدَّم، فسيتم توليدها تلقائيًا بناءً على قيم الإعداد. - indexer_types (
list[str]، اختياري) — وضع المُفهرِس لكل طبقة ("full"يشغّل المُفهرِس، و"shared"يعيد استخدام أعلى k من الطبقة الكاملة السابقة). القيمة الافتراضية هي النمط المستنتج منindex_topk_freq/index_skip_topk_offset(أوindex_topk_pattern).
هذه فئة الإعدادات المخزنة لإعدادات نموذج GlmMoeDsaModel. تُستخدم لاستحداث نموذج Glm Moe Dsa وفقًا للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ zai-org/GLM-5
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
>>> from transformers import GlmMoeDsaConfig, GlmMoeDsaModel

>>> # Initializing a GLM-MoE-DSA configuration
>>> configuration = GlmMoeDsaConfig()

>>> # Initializing a model from the configuration
>>> model = GlmMoeDsaModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
GlmMoeDsaModel
فئة transformers.GlmMoeDsaModel
< source >( config: GlmMoeDsaConfig )
المعاملات
- config (GlmMoeDsaConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Glm Moe Dsa الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values).
يعيد
MoeModelOutputWithPast أو tuple(torch.Tensor)
MoeModelOutputWithPast أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (GlmMoeDsaConfig) والمدخلات.
تتجاوز طريقة GlmMoeDsaModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من النموذج.past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان
config.is_encoder_decoder=True) يمكن استخدامها (انظر مدخلpast_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
router_logits (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_router_probs=Trueوconfig.add_router_probs=Trueأو عندconfig.output_router_probs=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, sequence_length, num_experts).قيمات logits الخام (بعد تطبيق دالة softmax) التي يحسبها موجّهو MoE، وتُستخدم هذه القيم لحساب الخسارة المساعدة في نماذج مزيج الخبراء.
GlmMoeDsaForCausalLM
فئة transformers.GlmMoeDsaForCausalLM
< source >( config: GlmMoeDsaConfig )
المعاملات
- config (GlmMoeDsaConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Glm Moe Dsa لنمذجة اللغة السببية.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا.يمكن الحصول على الفهارس باستخدام AutoTokenizer. راجع PreTrainedTokenizer.encode() و PreTrainedTokenizer.call() للتفاصيل.
- attention_mask (
torch.Tensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع هي[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- position_ids (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — مؤشرات مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها ضمن النطاق[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, اختياري) — حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكون هذا عادةً منpast_key_valuesالذي يعيده النموذج في مرحلة سابقة من فك الترميز، عندماuse_cache=Trueأوconfig.use_cache=True.يُسمح فقط بمرجع Cache كمدخل، راجع دليل ذاكرة kv لدينا. إذا لم يتم تمرير
past_key_values، فسيتم تهيئة DynamicCache افتراضياً.سيُخرج النموذج نفس صيغة الكاش التي تُمرَّر كمدخل.
عند استخدام
past_key_values، يُتوقَّع من المستخدم إدخالinput_idsغير المعالجة فقط (تلك التي لم تُقدَّم حالات مفاتيحها وقيمها السابقة إلى هذا النموذج) بأبعاد(batch_size, unprocessed_length)بدلاً من جميعinput_idsبأبعاد(batch_size, sequence_length). - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمريرinput_ids، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. وهذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارسinput_idsإلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج. - labels (
torch.LongTensorمن الشكل(batch_size, sequence_length)، اختياري) — التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن[0, ..., config.vocab_size]أو -100 (انظرinput_idsdocstring). يتم تجاهل الرموز التي فهارسها مضبوطة على-100(مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن[0, ..., config.vocab_size]. - use_cache (
bool، اختياري) — إذا تم تعيينه إلىTrue، تُعاد حالات المفاتيح والقيمpast_key_valuesويمكن استخدامها لتسريع فك الترميز (انظرpast_key_values). - logits_to_keep (
Union[int, torch.Tensor]، اختياري، القيمة الافتراضية0) — إذا كانint، يتم حساب logits لآخرlogits_to_keepرموز. إذا كانت القيمة0، يتم حساب logits لجميعinput_ids(حالة خاصة). لا يُحتاج إلى logits إلا للرمز الأخير في عملية التوليد، ويمكن أن يوفر حسابها لذلك الرمز وحده ذاكرة كبيرة، وهو أمر مهم بشكل ملحوظ للتسلسلات الطويلة أو حجم المفردات الكبير. إذا كانtorch.Tensor، يجب أن يكون بعدًا واحدًا (1D) ويتوافق مع الفهارس التي يجب الاحتفاظ بها في بُعد طول التسلسل. يكون هذا مفيدًا عند استخدام تنسيق المصفوفات المعبأة (packed tensor format) (بعد واحد لكل من الدفعة وطول التسلسل).
يعيد
MoeCausalLMOutputWithPast أو tuple(torch.Tensor)
MoeCausalLMOutputWithPast أو مجموعة (tuple) من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (GlmMoeDsaConfig) والمدخلات.
تتجاوز طريقة GlmMoeDsaForCausalLM الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة نمذجة اللغة (لتوقع الرمز التالي).logits (
torch.Tensorمن الشكل(batch_size, sequence_length, config.vocab_size)) — درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).aux_loss (
torch.Tensor، اختياري، يُعاد عند تمريرoutput_router_logits=Trueأو عندconfig.output_router_logits=True، ويتدرب النموذج على مساره باستخدام خسارة توازن الأحمال) — خسارة مساعدة لتوازن الأحمال للوحدات المتناثرة. النماذج التي توازن خبرائها باستخدام انحياز المسار بدلاً من ذلك (DeepSeek-V3 والهندسات المشتقة منه) تعيدNoneهنا مع الاستمرار في إعادةrouter_logits.router_logits (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_router_logits=Trueأو عند تعيينconfig.output_router_logits=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة متناثرة) ذات الشكل(batch_size * sequence_length, num_experts).قيمات التوجيه الخام (logits) التي تحسبها وحدات التوجيه في نماذج MoE. يمكن استخدامها لحساب خسارة موازنة الحمل أو لفحص كيفية توزيع الرموز على الخبراء.
past_key_values (
Cache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع Cache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
>>> from transformers import AutoTokenizer, GlmMoeDsaForCausalLM

>>> model = GlmMoeDsaForCausalLM.from_pretrained("meta-glm_moe_dsa/GlmMoeDsa-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm_moe_dsa/GlmMoeDsa-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."